


 家
バイトダンスがSeed-Thinking-v1.5 AIモデルを公開し、推論能力を向上
高度な推論AIの競争は、2024年9月にOpenAIのo1モデルで始まり、2025年1月のDeepSeekのR1ローンチで勢いを増しました。
主要なAI開発企業は現在、より高速でコスト効率の高い推論AIモデルを開発するために競争しており、チェーン・オブ・ソートプロセスを通じて正確でよく考え抜かれた応答を提供し、回答前に正確性を確保しています。
TikTokの親会社であるバイトダンスは、技術論文で概要が示された新しい大規模言語モデル(LLM)であるSeed-Thinking-v1.5を発表し、STEMおよび一般的な領域での推論を強化することを目指しています。
このモデルはまだ利用可能ではなく、ライセンスが独自仕様、オープンソース、またはハイブリッドのいずれであるかは未公開です。ただし、論文にはリリース前に探る価値のある重要な洞察が含まれています。
Mixture-of-Experts(MoE)フレームワークの活用
MetaのLlama 4やMistralのMixtralに続き、Seed-Thinking-v1.5はMixture-of-Experts(MoE)アーキテクチャを採用しています。
このアプローチは、複数の専門モデルを1つに統合し、それぞれが異なる領域に焦点を当てることで効率を高めます。
Seed-Thinking-v1.5は、2000億のパラメータのうち200億のみを一度に使用し、パフォーマンスを最適化しています。
バイトダンスのGitHubで公開された論文は、モデルの構造化された推論と意図的な応答生成への焦点を強調しています。
これはDeepSeek R1を超え、GoogleのGemini 2.5 ProやOpenAIのo3-mini-highと第三者ベンチマークで競合し、ARC-AGIベンチマークではそれらを上回り、OpenAIの基準に従って経済的に価値のあるタスクで人間のパフォーマンスを超える、人工知能の進歩の重要な指標です。
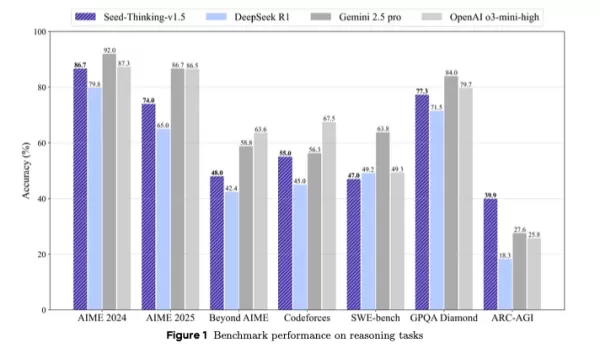
コンパクトでありながら強力な代替として位置付けられたSeed-Thinking-v1.5は、革新的な強化学習、厳選されたトレーニングデータ、先進的なAIインフラストラクチャを通じて優れたベンチマーク結果を提供します。
ベンチマーク性能とコアの強み
Seed-Thinking-v1.5は困難なタスクで優れており、AIME 2024で86.7%、Codeforcesでpass@8で55.0%、GPQA科学ベンチマークで77.3%を記録し、OpenAIのo3-mini-highやGoogleのGemini 2.5 Proと推論指標でほぼ同等またはそれらを上回っています。
非推論タスクでは、DeepSeek R1に対して8.0%高い人間の好み勝率を達成し、論理や数学を超えた汎用性を示しています。
ベンチマークの飽和に対抗するため、バイトダンスは記憶に頼らないより厳しい数学ベンチマークであるBeyondAIMEを作成し、モデル性能をより良く評価します。このベンチマークは、Codeforcesセットと共に、将来の研究を支援するために公開されます。
トレーニングデータのアプローチ
Seed-Thinking-v1.5の開発ではデータ品質が重要でした。教師あり微調整のために、40万のサンプルが厳選されました:30万の検証可能なSTEM、論理、コーディングタスクと、10万のクリエイティブライティングのような検証不可能なタスクです。
強化学習のために、データは以下に分けられました:
- 検証可能な問題:エリート競技から慎重に選ばれた10万のSTEM質問と論理パズル、専門家によって検証されました。
- 検証不可能なタスク:オープンエンドのプロンプトに対する人間の好みデータセット、ペアワイズ報酬モデルで評価されました。
STEMデータの80%以上は高度な数学に焦点を当て、Sudokuや24ポイントパズルなどの論理タスクはモデル進捗に合わせてスケールされました。
強化学習の革新
Seed-Thinking-v1.5は、カスタムのアクター-クリティック(VAPO)およびポリシー勾配(DAPO)フレームワークを使用して、長いチェーン・オブ・ソートシナリオでの問題に対処し、強化学習を安定化します。
2つの報酬モデルがRL監督を強化します:
- Seed-Verifier:生成された回答と参照回答の数学的同等性を保証するルールベースのLLM。
- Seed-Thinking-Verifier:報酬操作に耐性のある一貫した評価のための推論ベースのジャッジ。
このデュアルシステムは、単純および複雑なタスクでの正確な評価をサポートします。
スケーラブルなインフラストラクチャ設計
バイトダンスのHybridFlowフレームワークは、Rayクラスタによって支えられ、GPUのアイドル時間を最小化する共同配置されたトレーニングと推論で効率的な大規模トレーニングをサポートします。
ストリーミングロールアウトシステム(SRS)は、モデル進化とランタイムを分離し、部分生成の非同期管理により反復を最大3倍高速化します。
追加の技術には以下が含まれます:
- メモリ効率のための混合精度(FP8)
- MoE最適化のためのエキスパート並列処理とカーネル自動チューニング
- 堅牢なチェックポインティングのためのByteCheckpoint
- 最適化された並列処理とメモリ設定のためのAutoTuner
人間中心の評価と応用
クリエイティブライティング、人文科学、一般会話での人間のテストでは、Seed-Thinking-v1.5がDeepSeek R1を上回り、現実世界での関連性を証明しました。
チームは、検証可能なタスクでのトレーニングが、厳格な数学的ワークフローに駆動されて、クリエイティブな領域への一般化を強化したと述べています。
技術チームと企業への影響
LLMライフサイクルを監督する技術リーダーにとって、Seed-Thinking-v1.5は高度な推論を企業AIシステムに統合するモデルを提供します。
検証可能なデータセットと多段階の強化学習によるモジュラートレーニングは、LLM開発を正確に制御しながらスケールするチームに適しています。
Seed-VerifierとSeed-Thinking-Verifierは、顧客向けまたは規制された環境で重要な信頼性の高い報酬モデリングを強化します。
タイトなスケジュールのチームにとって、VAPOと動的サンプリングは反復サイクルを短縮し、タスク固有の微調整を効率化します。
ハイブリッドインフラストラクチャ(SRSやFP8最適化を含む)は、トレーニングスループットとハードウェア効率を高め、クラウドおよびオンプレミスシステムに最適です。
モデルの適応型報酬フィードバックは、多様なデータパイプラインの管理における課題に対処し、ドメイン間で一貫性を確保します。
データエンジニアにとって、厳格なデータフィルタリングと専門家検証への焦点は、モデル性能向上における高品質データセットの価値を強調します。
今後の展望
バイトダンスのSeed LLM Systemsチームによって開発され、Yonghui Wuが率い、Haibin Linが公開代表を務めるSeed-Thinking-v1.5は、Doubao 1.5 Proなどの取り組みを基盤とし、共有されたRLHFとデータキュレーション技術を使用しています。
チームは、トレーニング効率と検証不可能なタスクの報酬モデリングに焦点を当て、強化学習を改良することを目指しています。BeyondAIMEのようなベンチマークの公開は、推論に焦点を当てたAI研究のさらなる進展を促進します。
関連記事
 PHPのアルマゲドン:OpenAIとGoogleのWizが古くからの脆弱性を発見、ネット上でパニックを引き起こす
米国国家安全保障局(NSA)は水曜日、PHPに存在する2つの深刻な脆弱性について重大な警告を発しました。これに対し、PHP財団はすでにパッチを公開しています。サーバーサイドスクリプト言語であるPHPは、世界のウェブサイトの約70%(3,300万サイト以上)を支えており、WordPressなどの主要なコンテンツ管理プラットフォームに不可欠な存在です。NSAは、これらの脆弱性が極めて深刻であるため、パ
GoogleのAI概要記事が検索結果で存在感を増している
Similarwebの「2026年生成AIの現状」レポートによると、米国の検索の43%でGoogleのAI生成要約が表示されており、これは前年の15%から大幅に増加した。「AI Overviews」は通常の検索結果内に生成された要約を表示するのに対し、「AI Mode」は複雑なクエリや追問に対応する対話型インターフェースを提供する。ユーザーは、最初の検索の文脈を失うことなく、「AI Overvie
OpenAIは、ChatGPTの新しいデフォルトモデルとして「GPT-5.5 Instant」をリリースしました。
OpenAIは月曜日、GPT-5.5 Instantをリリースし、ChatGPTのデフォルトモデルとしてGPT-5.3 Instantを置き換えた。同社は、このアップデートにより、法務、医療、金融といった高リスクな分野におけるハルシネーション(幻覚)を最小限に抑えながら、以前のバージョンの高速な応答時間を維持していると述べている。先月、コーディングや知識作業の強化を強調した幅広いGPT-5.5シリーズがリリースされた後、OpenAIはこれらの改善をインスタンモデルに統合した。パフォーマンス面
関連特集おすすめ
デザインとアート
 おすすめのAIイラスト作成ツール:編集用シーンや表紙アートを素早く作成
2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
 10 ツール
 xix.ai
教育と学習
試験対策に最適なAIチューター:数学、理科、英語の練習
2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai
ファイナンス
個人のお金管理のためのAI予算計画ツール
2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai
健康とウェルネス
AI睡眠追跡アシスタント:より良い就寝習慣で回復力を高める
2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai
データ分析
製品および収益分析のためのAI SQLコパイロット
2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai
教育と学習
学びを促進する最高のAI宿題支援ツール:答えだけでなく、概念を学べる
2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

 コメント (1)
0/500
![ChristopherDavis]()
Cette accélération dans la course au raisonnement avancé me donne un peu le vertige 😅. D'un côté c'est fascinant de voir comment les modèles deviennent de plus en plus 'intelligents', mais d'un autre... on est certains que tout ce développement est sous contrôle ? Pas sûr que les entreprises pensent beaucoup aux implications éthiques quand elles sont lancées dans cette bataille commerciale ultra-compétitive.
高度な推論AIの競争は、2024年9月にOpenAIのo1モデルで始まり、2025年1月のDeepSeekのR1ローンチで勢いを増しました。
主要なAI開発企業は現在、より高速でコスト効率の高い推論AIモデルを開発するために競争しており、チェーン・オブ・ソートプロセスを通じて正確でよく考え抜かれた応答を提供し、回答前に正確性を確保しています。
TikTokの親会社であるバイトダンスは、技術論文で概要が示された新しい大規模言語モデル(LLM)であるSeed-Thinking-v1.5を発表し、STEMおよび一般的な領域での推論を強化することを目指しています。
このモデルはまだ利用可能ではなく、ライセンスが独自仕様、オープンソース、またはハイブリッドのいずれであるかは未公開です。ただし、論文にはリリース前に探る価値のある重要な洞察が含まれています。
Mixture-of-Experts(MoE)フレームワークの活用
MetaのLlama 4やMistralのMixtralに続き、Seed-Thinking-v1.5はMixture-of-Experts(MoE)アーキテクチャを採用しています。
このアプローチは、複数の専門モデルを1つに統合し、それぞれが異なる領域に焦点を当てることで効率を高めます。
Seed-Thinking-v1.5は、2000億のパラメータのうち200億のみを一度に使用し、パフォーマンスを最適化しています。
バイトダンスのGitHubで公開された論文は、モデルの構造化された推論と意図的な応答生成への焦点を強調しています。
これはDeepSeek R1を超え、GoogleのGemini 2.5 ProやOpenAIのo3-mini-highと第三者ベンチマークで競合し、ARC-AGIベンチマークではそれらを上回り、OpenAIの基準に従って経済的に価値のあるタスクで人間のパフォーマンスを超える、人工知能の進歩の重要な指標です。
コンパクトでありながら強力な代替として位置付けられたSeed-Thinking-v1.5は、革新的な強化学習、厳選されたトレーニングデータ、先進的なAIインフラストラクチャを通じて優れたベンチマーク結果を提供します。
ベンチマーク性能とコアの強み
Seed-Thinking-v1.5は困難なタスクで優れており、AIME 2024で86.7%、Codeforcesでpass@8で55.0%、GPQA科学ベンチマークで77.3%を記録し、OpenAIのo3-mini-highやGoogleのGemini 2.5 Proと推論指標でほぼ同等またはそれらを上回っています。
非推論タスクでは、DeepSeek R1に対して8.0%高い人間の好み勝率を達成し、論理や数学を超えた汎用性を示しています。
ベンチマークの飽和に対抗するため、バイトダンスは記憶に頼らないより厳しい数学ベンチマークであるBeyondAIMEを作成し、モデル性能をより良く評価します。このベンチマークは、Codeforcesセットと共に、将来の研究を支援するために公開されます。
トレーニングデータのアプローチ
Seed-Thinking-v1.5の開発ではデータ品質が重要でした。教師あり微調整のために、40万のサンプルが厳選されました:30万の検証可能なSTEM、論理、コーディングタスクと、10万のクリエイティブライティングのような検証不可能なタスクです。
強化学習のために、データは以下に分けられました:
- 検証可能な問題:エリート競技から慎重に選ばれた10万のSTEM質問と論理パズル、専門家によって検証されました。
- 検証不可能なタスク:オープンエンドのプロンプトに対する人間の好みデータセット、ペアワイズ報酬モデルで評価されました。
STEMデータの80%以上は高度な数学に焦点を当て、Sudokuや24ポイントパズルなどの論理タスクはモデル進捗に合わせてスケールされました。
強化学習の革新
Seed-Thinking-v1.5は、カスタムのアクター-クリティック(VAPO)およびポリシー勾配(DAPO)フレームワークを使用して、長いチェーン・オブ・ソートシナリオでの問題に対処し、強化学習を安定化します。
2つの報酬モデルがRL監督を強化します:
- Seed-Verifier:生成された回答と参照回答の数学的同等性を保証するルールベースのLLM。
- Seed-Thinking-Verifier:報酬操作に耐性のある一貫した評価のための推論ベースのジャッジ。
このデュアルシステムは、単純および複雑なタスクでの正確な評価をサポートします。
スケーラブルなインフラストラクチャ設計
バイトダンスのHybridFlowフレームワークは、Rayクラスタによって支えられ、GPUのアイドル時間を最小化する共同配置されたトレーニングと推論で効率的な大規模トレーニングをサポートします。
ストリーミングロールアウトシステム(SRS)は、モデル進化とランタイムを分離し、部分生成の非同期管理により反復を最大3倍高速化します。
追加の技術には以下が含まれます:
- メモリ効率のための混合精度(FP8)
- MoE最適化のためのエキスパート並列処理とカーネル自動チューニング
- 堅牢なチェックポインティングのためのByteCheckpoint
- 最適化された並列処理とメモリ設定のためのAutoTuner
人間中心の評価と応用
クリエイティブライティング、人文科学、一般会話での人間のテストでは、Seed-Thinking-v1.5がDeepSeek R1を上回り、現実世界での関連性を証明しました。
チームは、検証可能なタスクでのトレーニングが、厳格な数学的ワークフローに駆動されて、クリエイティブな領域への一般化を強化したと述べています。
技術チームと企業への影響
LLMライフサイクルを監督する技術リーダーにとって、Seed-Thinking-v1.5は高度な推論を企業AIシステムに統合するモデルを提供します。
検証可能なデータセットと多段階の強化学習によるモジュラートレーニングは、LLM開発を正確に制御しながらスケールするチームに適しています。
Seed-VerifierとSeed-Thinking-Verifierは、顧客向けまたは規制された環境で重要な信頼性の高い報酬モデリングを強化します。
タイトなスケジュールのチームにとって、VAPOと動的サンプリングは反復サイクルを短縮し、タスク固有の微調整を効率化します。
ハイブリッドインフラストラクチャ(SRSやFP8最適化を含む)は、トレーニングスループットとハードウェア効率を高め、クラウドおよびオンプレミスシステムに最適です。
モデルの適応型報酬フィードバックは、多様なデータパイプラインの管理における課題に対処し、ドメイン間で一貫性を確保します。
データエンジニアにとって、厳格なデータフィルタリングと専門家検証への焦点は、モデル性能向上における高品質データセットの価値を強調します。
今後の展望
バイトダンスのSeed LLM Systemsチームによって開発され、Yonghui Wuが率い、Haibin Linが公開代表を務めるSeed-Thinking-v1.5は、Doubao 1.5 Proなどの取り組みを基盤とし、共有されたRLHFとデータキュレーション技術を使用しています。
チームは、トレーニング効率と検証不可能なタスクの報酬モデリングに焦点を当て、強化学習を改良することを目指しています。BeyondAIMEのようなベンチマークの公開は、推論に焦点を当てたAI研究のさらなる進展を促進します。








 PHPのアルマゲドン:OpenAIとGoogleのWizが古くからの脆弱性を発見、ネット上でパニックを引き起こす
米国国家安全保障局(NSA)は水曜日、PHPに存在する2つの深刻な脆弱性について重大な警告を発しました。これに対し、PHP財団はすでにパッチを公開しています。サーバーサイドスクリプト言語であるPHPは、世界のウェブサイトの約70%(3,300万サイト以上)を支えており、WordPressなどの主要なコンテンツ管理プラットフォームに不可欠な存在です。NSAは、これらの脆弱性が極めて深刻であるため、パ
 GoogleのAI概要記事が検索結果で存在感を増している
Similarwebの「2026年生成AIの現状」レポートによると、米国の検索の43%でGoogleのAI生成要約が表示されており、これは前年の15%から大幅に増加した。「AI Overviews」は通常の検索結果内に生成された要約を表示するのに対し、「AI Mode」は複雑なクエリや追問に対応する対話型インターフェースを提供する。ユーザーは、最初の検索の文脈を失うことなく、「AI Overvie
 OpenAIは、ChatGPTの新しいデフォルトモデルとして「GPT-5.5 Instant」をリリースしました。
OpenAIは月曜日、GPT-5.5 Instantをリリースし、ChatGPTのデフォルトモデルとしてGPT-5.3 Instantを置き換えた。同社は、このアップデートにより、法務、医療、金融といった高リスクな分野におけるハルシネーション(幻覚)を最小限に抑えながら、以前のバージョンの高速な応答時間を維持していると述べている。先月、コーディングや知識作業の強化を強調した幅広いGPT-5.5シリーズがリリースされた後、OpenAIはこれらの改善をインスタンモデルに統合した。パフォーマンス面

2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
10 ツール
xix.ai

2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai

2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai

2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai

2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

Cette accélération dans la course au raisonnement avancé me donne un peu le vertige 😅. D'un côté c'est fascinant de voir comment les modèles deviennent de plus en plus 'intelligents', mais d'un autre... on est certains que tout ce développement est sous contrôle ? Pas sûr que les entreprises pensent beaucoup aux implications éthiques quand elles sont lancées dans cette bataille commerciale ultra-compétitive.












