


 首頁
字節跳動推出Seed-Thinking-v1.5 AI模型以提升推理能力
先進推理AI的競賽始於2024年9月OpenAI的o1模型,隨著2025年1月DeepSeek的R1推出而加速。
主要AI開發商現正競相打造更快、更具成本效益的推理AI模型,通過思維鏈過程提供精確、深思熟慮的回應,確保回答前的準確性。
字節跳動,TikTok的母公司,推出Seed-Thinking-v1.5,一款在技術論文中概述的新大型語言模型(LLM),旨在增強STEM及一般領域的推理能力。
該模型尚未公開,且其授權方式—無論是專有、開源或混合—仍未透露。然而,該論文提供了值得在發布前探索的關鍵見解。
利用專家混合(MoE)框架
繼Meta的Llama 4和Mistral的Mixtral之後,Seed-Thinking-v1.5採用了專家混合(MoE)架構。
這種方法通過將多個專精模型整合為一體來提升效率,每個模型專注於不同領域。
Seed-Thinking-v1.5僅使用其2000億參數中的200億,優化性能。
字節跳動在GitHub發布的論文強調該模型專注於結構化推理和審慎回應生成。
它超越DeepSeek R1,並在第三方基準測試中與Google的Gemini 2.5 Pro和OpenAI的o3-mini-high競爭,甚至在ARC-AGI基準測試中表現優於它們,該基準是衡量人工通用智能進展的關鍵指標,根據OpenAI的標準,超越了人類在經濟上有價值的任務中的表現。
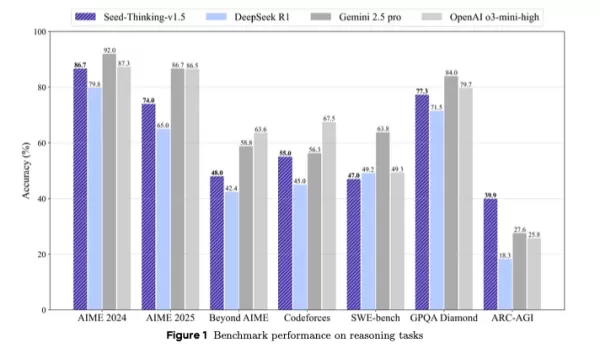
作為比大型模型更緊湊但強大的替代方案,Seed-Thinking-v1.5通過創新的強化學習、精選訓練數據和先進的AI基礎設施,提供了出色的基準測試結果。
基準測試表現與核心優勢
Seed-Thinking-v1.5在艱難任務中表現出色,在AIME 2024獲得86.7%的分數,在Codeforces上獲得55.0%的pass@8,在GPQA科學基準測試中獲得77.3%,與OpenAI的o3-mini-high和Google的Gemini 2.5 Pro在推理指標上接近或超越。
在非推理任務中,它的人類偏好勝率比DeepSeek R1高出8.0%,顯示出超越邏輯和數學的靈活性。
為應對基準測試飽和問題,字節跳動創建了BeyondAIME,一個更嚴格的數學基準測試,以抵制記憶並更好地評估模型表現。該基準與Codeforces集合將公開發布,以促進未來研究。
訓練數據策略
數據質量在開發Seed-Thinking-v1.5中至關重要。為進行監督微調,精選了40萬個樣本:30萬個可驗證的STEM、邏輯和編碼任務,以及10萬個不可驗證的任務,如創意寫作。
對於強化學習,數據分為:
- 可驗證問題:從頂尖比賽中精心挑選的10萬個STEM問題和邏輯謎題,由專家驗證。
- 不可驗證任務:針對開放式提示的人類偏好數據集,通過成對獎勵模型評估。
超過80%的STEM數據專注於高級數學,邏輯任務如數獨和24點謎題根據模型進展進行縮放。
強化學習創新
Seed-Thinking-v1.5使用自定義的actor-critic(VAPO)和策略梯度(DAPO)框架來穩定強化學習,解決長思維鏈場景中的問題。
兩個獎勵模型增強了強化學習監督:
- Seed-Verifier:基於規則的LLM,確保生成答案與參考答案的數學等價性。
- Seed-Thinking-Verifier:基於推理的評估器,確保一致性評估,抵禦獎勵操縱。
此雙重系統支持簡單和複雜任務的精確評估。
可擴展基礎設施設計
字節跳動的HybridFlow框架,由Ray集群提供支持,支持高效的大規模訓練,通過訓練與推理共置減少GPU閒置時間。
流式推出系統(SRS)將模型進化與運行時分離,通過異步管理部分生成,將迭代速度提升至三倍。
其他技術包括:
- 混合精度(FP8)以提升記憶體效率
- 專家並行和內核自動調整以優化MoE
- ByteCheckpoint以實現穩健的檢查點
- AutoTuner以優化並行和記憶體設置
以人為本的評估與應用
在創意寫作、人文學科和一般對話中的人類測試顯示,Seed-Thinking-v1.5超越DeepSeek R1,證明其現實世界的相關性。
團隊指出,在可驗證任務上的訓練增強了對創意領域的泛化能力,這得益於嚴格的數學工作流程。
對技術團隊和企業的影響
對於監督LLM生命週期的技術領導者,Seed-Thinking-v1.5提供了一個將高級推理整合到企業AI系統中的模型。
其模組化訓練,包含可驗證數據集和多階段強化學習,適合需要精確控制的LLM開發團隊。
Seed-Verifier和Seed-Thinking-Verifier增強了可信的獎勵建模,這對面向客戶或受監管的環境至關重要。
對於時間緊迫的團隊,VAPO和動態採樣縮短了迭代週期,簡化了特定任務的微調。
混合基礎設施,包括SRS和FP8優化,提升了訓練吞吐量和硬體效率,適合雲端和本地系統。
該模型的自適應獎勵反饋解決了管理多樣化數據管道的挑戰,確保跨領域的一致性。
對於數據工程師,嚴格的數據過濾和專家驗證的重視凸顯了高質量數據集在提升模型性能方面的價值。
未來展望
由字節跳動的Seed LLM Systems團隊開發,由吳永輝領導並由林海濱公開代表,Seed-Thinking-v1.5在Doubao 1.5 Pro的基礎上,採用共享的RLHF和數據精選技術。
團隊旨在精進強化學習,專注於訓練效率和不可驗證任務的獎勵建模。發布BeyondAIME等基準將推動專注於推理的AI研究的進一步進展。
相關文章
 OpenAI 在青少年開始使用 ChatGPT 數年後,推出了一款更安全的 ChatGPT 版本
在因人工智慧聊天機器人缺乏安全機制——此問題曾導致青少年自殺及其他心理健康危機——而引發一系列訴訟後,OpenAI 於週一正式推出「ChatGPT for Teens」。這項新服務整合了強化版的安全功能,並針對校園中因人工智慧工具而日益嚴重的學術不誠實問題提出解決方案。從教育角度來看,「ChatGPT for Teens」除了推出「學習模式」外,還整合了其他旨在培養好奇心與問題解決能力的工具,鼓勵
Google 推出虛假來電偵測功能,以防範人工智慧深度偽造(deepfake)冒充詐騙
Google 週二宣布,Android 將推出「虛假來電偵測」功能,以防範利用人工智慧深度偽造技術進行的冒充詐騙。此功能將於本月透過「Phone by Google」在全球範圍內逐步推送至 Android 12 及以上版本的裝置,首先從 Pixel 裝置開始。隨著人們越來越不願接聽未知號碼的來電,詐騙者正改變策略,透過偽造可信賴的電話號碼,並利用 AI 深度偽造技術,讓聲音聽起來像是權威人士、家人
小鵬汽車旗下的 Dogotix 成功募得 9 億美元資金
小鵬汽車旗下的 Dogotix 部門正在研發「IRON」人形機器人。來源:小鵬汽車效法其他全球主要汽車製造商的做法,小鵬汽車正將業務拓展至人形機器人領域。 這家電動車製造商今日宣布,其機器人子公司 Dogotix 已在首輪融資中籌得逾 9 億美元,融資前估值達 50 億美元,交易後估值更超過 63 億美元。據小鵬汽車表示,這筆資金將用於推進硬體與軟體開發、蒐集營運數據、訓練物理人工智慧模型、建立量
相關專題推薦
聊天機器人
 用於語言練習、面試準備和日常流利度的最佳 AI 角色扮演聊天應用
2026 年最新最佳頂級評分 AI 角色扮演聊天應用,用於語言練習、面試準備和日常流利度!XIX.AI 精心策劃了一個強大的變革性合集,提供免費與付費對比、真實世界測試以及每週更新的排名。這些必試工具可幫助您提升寫作技能,克服流利度挑戰,並提高所有日常場景下的溝通效率。立即探索,發現您語言成長的完美工具!
 10 個工具
 xix.ai
音樂創作
用於混音製作、取樣準備及卡拉OK母帶處理的 AI 聲部分離工具
2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
8 個工具
xix.ai
數據分析
用於收入看板、轉化漏斗分析及產品指標分析的 AI SQL 助手
2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai
音樂創作
最佳用於歌曲草稿的 AI 旋律創作工具
2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai
聊天機器人
最適合面試練習的 AI 對話訓練工具
2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai
設計與藝術
最適合進行創意實驗的 AI 風格轉移工具
2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai

 評論 (1)
0/500
![ChristopherDavis]()
Cette accélération dans la course au raisonnement avancé me donne un peu le vertige 😅. D'un côté c'est fascinant de voir comment les modèles deviennent de plus en plus 'intelligents', mais d'un autre... on est certains que tout ce développement est sous contrôle ? Pas sûr que les entreprises pensent beaucoup aux implications éthiques quand elles sont lancées dans cette bataille commerciale ultra-compétitive.
先進推理AI的競賽始於2024年9月OpenAI的o1模型,隨著2025年1月DeepSeek的R1推出而加速。
主要AI開發商現正競相打造更快、更具成本效益的推理AI模型,通過思維鏈過程提供精確、深思熟慮的回應,確保回答前的準確性。
字節跳動,TikTok的母公司,推出Seed-Thinking-v1.5,一款在技術論文中概述的新大型語言模型(LLM),旨在增強STEM及一般領域的推理能力。
該模型尚未公開,且其授權方式—無論是專有、開源或混合—仍未透露。然而,該論文提供了值得在發布前探索的關鍵見解。
利用專家混合(MoE)框架
繼Meta的Llama 4和Mistral的Mixtral之後,Seed-Thinking-v1.5採用了專家混合(MoE)架構。
這種方法通過將多個專精模型整合為一體來提升效率,每個模型專注於不同領域。
Seed-Thinking-v1.5僅使用其2000億參數中的200億,優化性能。
字節跳動在GitHub發布的論文強調該模型專注於結構化推理和審慎回應生成。
它超越DeepSeek R1,並在第三方基準測試中與Google的Gemini 2.5 Pro和OpenAI的o3-mini-high競爭,甚至在ARC-AGI基準測試中表現優於它們,該基準是衡量人工通用智能進展的關鍵指標,根據OpenAI的標準,超越了人類在經濟上有價值的任務中的表現。
作為比大型模型更緊湊但強大的替代方案,Seed-Thinking-v1.5通過創新的強化學習、精選訓練數據和先進的AI基礎設施,提供了出色的基準測試結果。
基準測試表現與核心優勢
Seed-Thinking-v1.5在艱難任務中表現出色,在AIME 2024獲得86.7%的分數,在Codeforces上獲得55.0%的pass@8,在GPQA科學基準測試中獲得77.3%,與OpenAI的o3-mini-high和Google的Gemini 2.5 Pro在推理指標上接近或超越。
在非推理任務中,它的人類偏好勝率比DeepSeek R1高出8.0%,顯示出超越邏輯和數學的靈活性。
為應對基準測試飽和問題,字節跳動創建了BeyondAIME,一個更嚴格的數學基準測試,以抵制記憶並更好地評估模型表現。該基準與Codeforces集合將公開發布,以促進未來研究。
訓練數據策略
數據質量在開發Seed-Thinking-v1.5中至關重要。為進行監督微調,精選了40萬個樣本:30萬個可驗證的STEM、邏輯和編碼任務,以及10萬個不可驗證的任務,如創意寫作。
對於強化學習,數據分為:
- 可驗證問題:從頂尖比賽中精心挑選的10萬個STEM問題和邏輯謎題,由專家驗證。
- 不可驗證任務:針對開放式提示的人類偏好數據集,通過成對獎勵模型評估。
超過80%的STEM數據專注於高級數學,邏輯任務如數獨和24點謎題根據模型進展進行縮放。
強化學習創新
Seed-Thinking-v1.5使用自定義的actor-critic(VAPO)和策略梯度(DAPO)框架來穩定強化學習,解決長思維鏈場景中的問題。
兩個獎勵模型增強了強化學習監督:
- Seed-Verifier:基於規則的LLM,確保生成答案與參考答案的數學等價性。
- Seed-Thinking-Verifier:基於推理的評估器,確保一致性評估,抵禦獎勵操縱。
此雙重系統支持簡單和複雜任務的精確評估。
可擴展基礎設施設計
字節跳動的HybridFlow框架,由Ray集群提供支持,支持高效的大規模訓練,通過訓練與推理共置減少GPU閒置時間。
流式推出系統(SRS)將模型進化與運行時分離,通過異步管理部分生成,將迭代速度提升至三倍。
其他技術包括:
- 混合精度(FP8)以提升記憶體效率
- 專家並行和內核自動調整以優化MoE
- ByteCheckpoint以實現穩健的檢查點
- AutoTuner以優化並行和記憶體設置
以人為本的評估與應用
在創意寫作、人文學科和一般對話中的人類測試顯示,Seed-Thinking-v1.5超越DeepSeek R1,證明其現實世界的相關性。
團隊指出,在可驗證任務上的訓練增強了對創意領域的泛化能力,這得益於嚴格的數學工作流程。
對技術團隊和企業的影響
對於監督LLM生命週期的技術領導者,Seed-Thinking-v1.5提供了一個將高級推理整合到企業AI系統中的模型。
其模組化訓練,包含可驗證數據集和多階段強化學習,適合需要精確控制的LLM開發團隊。
Seed-Verifier和Seed-Thinking-Verifier增強了可信的獎勵建模,這對面向客戶或受監管的環境至關重要。
對於時間緊迫的團隊,VAPO和動態採樣縮短了迭代週期,簡化了特定任務的微調。
混合基礎設施,包括SRS和FP8優化,提升了訓練吞吐量和硬體效率,適合雲端和本地系統。
該模型的自適應獎勵反饋解決了管理多樣化數據管道的挑戰,確保跨領域的一致性。
對於數據工程師,嚴格的數據過濾和專家驗證的重視凸顯了高質量數據集在提升模型性能方面的價值。
未來展望
由字節跳動的Seed LLM Systems團隊開發,由吳永輝領導並由林海濱公開代表,Seed-Thinking-v1.5在Doubao 1.5 Pro的基礎上,採用共享的RLHF和數據精選技術。
團隊旨在精進強化學習,專注於訓練效率和不可驗證任務的獎勵建模。發布BeyondAIME等基準將推動專注於推理的AI研究的進一步進展。








 OpenAI 在青少年開始使用 ChatGPT 數年後,推出了一款更安全的 ChatGPT 版本
在因人工智慧聊天機器人缺乏安全機制——此問題曾導致青少年自殺及其他心理健康危機——而引發一系列訴訟後,OpenAI 於週一正式推出「ChatGPT for Teens」。這項新服務整合了強化版的安全功能,並針對校園中因人工智慧工具而日益嚴重的學術不誠實問題提出解決方案。從教育角度來看,「ChatGPT for Teens」除了推出「學習模式」外,還整合了其他旨在培養好奇心與問題解決能力的工具,鼓勵
 Google 推出虛假來電偵測功能,以防範人工智慧深度偽造(deepfake)冒充詐騙
Google 週二宣布,Android 將推出「虛假來電偵測」功能,以防範利用人工智慧深度偽造技術進行的冒充詐騙。此功能將於本月透過「Phone by Google」在全球範圍內逐步推送至 Android 12 及以上版本的裝置,首先從 Pixel 裝置開始。隨著人們越來越不願接聽未知號碼的來電,詐騙者正改變策略,透過偽造可信賴的電話號碼,並利用 AI 深度偽造技術,讓聲音聽起來像是權威人士、家人
 小鵬汽車旗下的 Dogotix 成功募得 9 億美元資金
小鵬汽車旗下的 Dogotix 部門正在研發「IRON」人形機器人。來源:小鵬汽車效法其他全球主要汽車製造商的做法,小鵬汽車正將業務拓展至人形機器人領域。 這家電動車製造商今日宣布,其機器人子公司 Dogotix 已在首輪融資中籌得逾 9 億美元,融資前估值達 50 億美元,交易後估值更超過 63 億美元。據小鵬汽車表示,這筆資金將用於推進硬體與軟體開發、蒐集營運數據、訓練物理人工智慧模型、建立量

2026 年最新最佳頂級評分 AI 角色扮演聊天應用,用於語言練習、面試準備和日常流利度!XIX.AI 精心策劃了一個強大的變革性合集,提供免費與付費對比、真實世界測試以及每週更新的排名。這些必試工具可幫助您提升寫作技能,克服流利度挑戰,並提高所有日常場景下的溝通效率。立即探索,發現您語言成長的完美工具!
10 個工具
xix.ai

2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
8 個工具
xix.ai

2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai

2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai

2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai

2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai

Cette accélération dans la course au raisonnement avancé me donne un peu le vertige 😅. D'un côté c'est fascinant de voir comment les modèles deviennent de plus en plus 'intelligents', mais d'un autre... on est certains que tout ce développement est sous contrôle ? Pas sûr que les entreprises pensent beaucoup aux implications éthiques quand elles sont lancées dans cette bataille commerciale ultra-compétitive.












