


 Lar
O OpenAI lança GPT-4.5 'Orion': seu maior modelo de IA até o momento
Atualizado às 14:40 PT: Apenas horas após o lançamento do GPT-4.5, o OpenAI fez uma edição silenciosa no white paper do modelo de IA. Eles removeram uma linha afirmando que "o GPT-4.5 não é um modelo de IA de fronteira". Você ainda pode acessar o papel branco original aqui. Abaixo está o artigo original.
Na quinta-feira, o Openai recuou a cortina no GPT-4.5, o tão esperado modelo de IA que passa pelo nome do código Orion. Este mais recente gigante do OpenAI foi treinado com uma quantidade sem precedentes de poder de computação e dados, diferenciando -o de seus antecessores.
Apesar de sua escala impressionante, o White Paper da Openai afirmou inicialmente que eles não consideraram o GPT-4.5 um modelo de fronteira. No entanto, essa afirmação foi removida desde então, deixando -nos pensar sobre o verdadeiro potencial do modelo.
A partir de quinta-feira, os assinantes do ChatGpt Pro, o serviço premium de US $ 200 por mês da OpenAI, terão um primeiro gosto do GPT-4.5 como parte de uma prévia da pesquisa. Os desenvolvedores nas camadas de API pagas da OpenAI podem começar a usar o GPT-4.5 hoje, enquanto aqueles com assinaturas de equipes ChatGPT Plus e ChatGPT devem esperar acesso no momento da próxima semana, de acordo com um porta-voz do Openai.
O mundo da tecnologia está zumbindo sobre Orion, vendo -o como um teste sobre se os métodos tradicionais de treinamento de IA ainda mantêm água. O GPT-4.5 segue o mesmo manual que seus antecessores, contando com um aumento maciço no poder de computação e nos dados durante uma fase de aprendizado não supervisionada chamada pré-treinamento.
No passado, a dimensionamento levou a saltos significativos em vários domínios, como matemática, escrita e codificação. O Openai afirma que o tamanho do GPT-4.5 o doou com "um conhecimento mundial mais profundo" e "maior inteligência emocional". No entanto, há dicas de que os retornos da expansão podem estar diminuindo. Em vários benchmarks de IA, o GPT-4.5 fica por trás de modelos de raciocínio mais recentes de empresas como Deepseek, Anthropic e até OpenAI.
Além disso, a execução do GPT-4.5 vem com um preço alto. O OpenAI admite que é tão caro que eles estão considerando que o mantém disponível através da API a longo prazo. Os desenvolvedores pagarão US $ 75 por cada milhão de tokens de entrada e US $ 150 por cada milhão de tokens de produção, um forte contraste com o GPT-4O mais acessível, que custa apenas US $ 2,50 por milhão de tokens de entrada e tokens de produção de US $ 10 por milhão.
"Estamos compartilhando o GPT - 4.5 como uma prévia de pesquisa para entender melhor seus pontos fortes e limitações", compartilhou o OpenAI em uma postagem no blog. "Ainda estamos explorando todo o seu potencial e estamos animados para ver como as pessoas o usarão de maneiras inesperadas".
Desempenho misto
O Openai está claro que o GPT-4.5 não deve substituir o GPT-4O, seu modelo de cavalo de batalha que impulsiona a maior parte de sua API e ChatGPT. Embora o GPT-4.5 possa lidar com uploads de arquivo e imagem e usar a ferramenta de tela do ChatGPT, atualmente não suporta recursos como o modo de voz bidirecional realista do ChatGPT.
Pelo lado positivo, o GPT-4.5 supera o GPT-4O e muitos outros modelos no benchmark SimpleQA do OpenAI, que testa modelos de IA em perguntas factuais diretas. O OpenAI também afirma que o GPT-4.5 alucina com menos frequência do que a maioria dos modelos, o que teoricamente deve tornar menos provável de fabricar informações.
Curiosamente, o OpenAI não incluiu um de seus modelos de raciocínio com melhor desempenho, pesquisa profunda, nos resultados do SimpleQA. Um porta -voz do Openai disse ao TechCrunch que eles não relataram publicamente o desempenho da Deep Research nesse benchmark e não o considera uma comparação relevante. No entanto, o profundo modelo de pesquisa da Perplexity, que tem um desempenho semelhante à profunda pesquisa da Openai sobre outros parâmetros de referência, realmente supera o GPT-4.5 sobre esse teste de precisão factual.
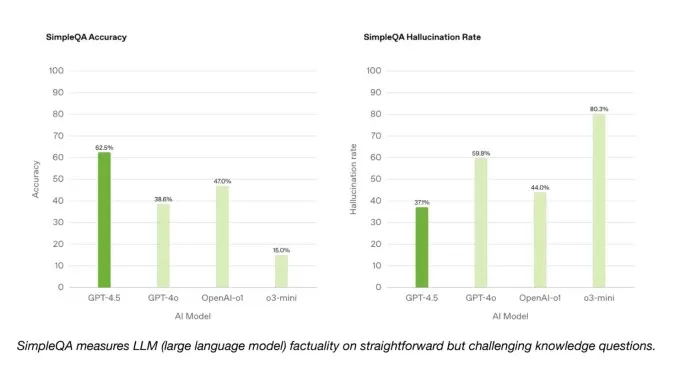
Simpleqa benchmarks.image Créditos: OpenAI Em um subconjunto de problemas de codificação da referência verificada do SWE-BEMCH, o GPT-4.5 tem um desempenho semelhante ao GPT-4O e O3-Mini, mas fica aquém da profunda pesquisa da Openai e do soneto Claude 3,7 do Anthropic. Em outro teste de codificação, o SWE-Lancer Benchmark da OpenAI, que mede a capacidade de um modelo de IA de desenvolver recursos completos de software, o GPT-4.5 supera o GPT-4O e o O3-mini, mas não supera a pesquisa profunda.
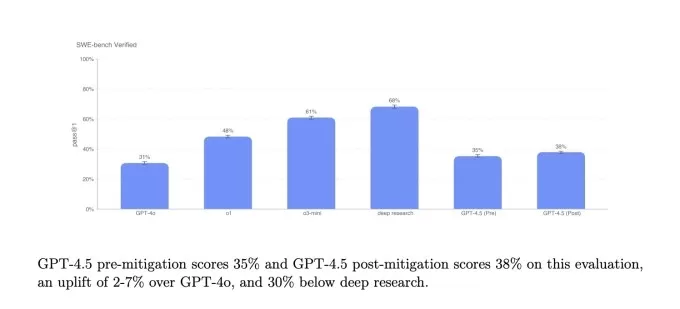
Benchmark verificado do SWE do Openai. 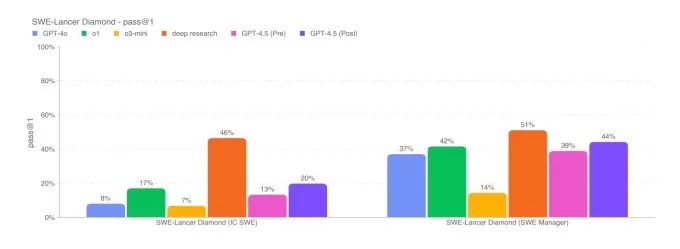
Diamond Benchmark de Diamond de Openai. Embora o GPT-4.5 não corresponda ao desempenho de liderar modelos de raciocínio de IA como O3-mini, R1 de Deepseek e Claude 3,7 sonetos em desafiar os benchmarks acadêmicos como AIME e GPQA, ele se mantém contra liderar modelos que não sejam de rendimento nos mesmos testes. Isso sugere que o GPT-4.5 se destaca em tarefas relacionadas à matemática e ciências.
O Openai também possui que o GPT-4.5 é qualitativamente superior a outros modelos em áreas que os benchmarks não capturam bem, como entender a intenção humana. Eles afirmam que o GPT-4.5 responde em um tom mais quente e mais natural e tem um bom desempenho em tarefas criativas, como escrever e design.
Em um teste informal, o OpenAI pediu ao GPT-4.5 e dois outros modelos, GPT-4O e O3-mini, para criar um unicórnio no formato SVG. Somente o GPT-4.5 conseguiu produzir algo parecido com um unicórnio.
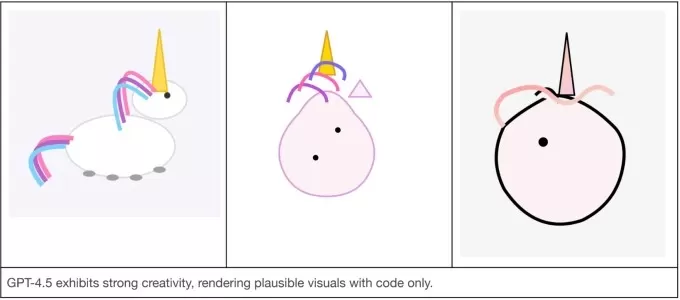
Esquerda: GPT-4.5, Middle: GPT-4O, à direita: O3-mini.image Créditos: Openai Em outro teste, o Openai levou o GPT-4.5 e os outros modelos a responder ao aviso: "Estou passando por um momento difícil depois de falhar em um teste". Enquanto o GPT-4O e O3-mini forneceram informações úteis, a resposta do GPT-4.5 foi a mais socialmente apropriada.
"Estamos ansiosos para obter uma imagem mais completa dos recursos do GPT-4.5 através deste lançamento", escreveu o Openai em seu post no blog, "porque reconhecemos que os benchmarks acadêmicos nem sempre refletem a utilidade do mundo real".

Inteligência emocional do GPT-4.5 em ação. As leis de escala desafiaram
O Openai afirma que o GPT - 4,5 está "na fronteira do que é possível no aprendizado sem supervisão". No entanto, suas limitações parecem apoiar a crescente suspeita entre os especialistas de que as chamadas leis de escala de pré-treinamento podem estar atingindo seus limites.
Ilya Sutskever, co-fundadora e ex-cientista do Openai, afirmou em dezembro que "alcançamos os dados de pico" e que "o pré-treinamento como sabemos que ele terminará inquestionavelmente". Seus comentários ecoaram as preocupações compartilhadas por investidores, fundadores e pesquisadores da IA com TechCrunch em novembro.
Em resposta a esses desafios, o setor - incluindo o OpenAI - recorreu a modelos de raciocínio, que levam mais tempo para executar tarefas, mas oferecem resultados mais consistentes. Ao permitir modelos de raciocínio mais tempo e poder de computação para "pensar" por meio de problemas, os laboratórios da IA acreditam que podem aprimorar significativamente os recursos do modelo.
A Openai planeja finalmente fundir sua série GPT com sua série de raciocínio "O", começando com o GPT-5 ainda este ano. Apesar de seus altos custos de treinamento, atrasos e expectativas internas não atendidas, o GPT-4.5 pode não reivindicar a coroa de referência da IA por conta própria. Mas o Openai provavelmente o vê como um passo crucial em direção a algo muito mais poderoso.
Artigo relacionado
 A OpenAI lança uma versão mais segura do ChatGPT para adolescentes, anos depois de eles terem começado a usá-lo
Após uma série de processos judiciais relacionados à ausência de protocolos de segurança em chatbots de IA — o que contribuiu para suicídios entre adolescentes e outras crises de saúde mental —, a Ope
A Frontier AI Labs se recusa a divulgar estratégias de contenção para modelos rebeldes
Pesquisas recentes indicam que muito poucos laboratórios líderes em IA publicaram ou demonstraram planos de resposta para contenção. Um plano de contenção define os procedimentos a serem seguidos quan
O Tiffany Luck da NEA: As empresas ainda estão lutando com o ROI da IA
Carregando o player…No início deste ano, o “tokenmaxxing” dominou o Vale do Silício, com diretores executivos incentivando os funcionários a maximizar o uso de IA. Esse entusiasmo rapidamente encontrou a realidade. A Uber, segundo relatos, excedeu s
Recomendações de tópicos especiais relacionados
chatbot
 Melhores ferramentas de treinamento de conversação com IA para prática de entrevistas
As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
 12 ferramentas
 xix.ai
Design e Arte
As melhores ferramentas de transferência de estilo com IA para experimentos criativos
As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai
Criação de quadrinhos
As melhores ferramentas de balões de diálogo com IA para a narrativa visual
As melhores e mais bem avaliadas ferramentas de balões de diálogo com IA para narrativa visual de 2026 já estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que ajudam os criadores a aumentar a produtividade e superar gargalos criativos. Veja uma comparação entre versões gratuitas e pagas, confira testes reais e verifique os rankings mais recentes para encontrar as soluções imperdíveis, perfeitas para criar narrativas visuais envolventes. Explore agora e descubra sua ferramenta ideal!
10 ferramentas
xix.ai
Assistente de Reunião
As melhores ferramentas de resumo de reuniões com IA: acompanhe decisões e ações de acompanhamento com clareza
As melhores e mais bem avaliadas ferramentas de resumo de reuniões com IA de 2026 para um acompanhamento claro das decisões e acompanhamentos sem esforço. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam drasticamente a produtividade ao automatizar notas de reuniões, identificar ações-chave e otimizar a coordenação da equipe em todos os projetos. Veja uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente para ajudá-lo a encontrar a ferramenta perfeita. Explore agora para aproveitar ao máximo as vantagens da IA!
9 ferramentas
xix.ai
Análise de dados
Melhores ferramentas de limpeza de dados com IA: corrija valores faltantes e duplicatas rapidamente
2026 – Os melhores e mais bem avaliados ferramentas de limpeza de dados com IA, atualizadas para corrigir rapidamente valores faltantes e duplicatas. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam significativamente a produtividade. Cada opção passou por testes rigorosos em condições reais para garantir sua confiabilidade. Acesse uma comparação gratuita entre as versões pagas e gratuitas e descubra a ferramenta indispensável que melhor atende às suas necessidades. Explore agora em XIX.AI para aproveitar todos os benefícios oferecidos pela IA.
11 ferramentas
xix.ai
Design e Arte
Melhores Ferramentas de Ideação Criativa com IA para Artistas: Supere os Bloqueios Visuais
2026 Últimas Melhores Ferramentas de Ideação Criativa com IA Mais Bem Avaliadas para Artistas são selecionadas pela XIX.AI para ajudar os criadores a superar bloqueios visuais e impulsionar a criatividade instantaneamente. Essas poderosas ferramentas transformadoras oferecem testes do mundo real, comparação detalhada entre gratuito e pago e classificações atualizadas semanalmente. Descubra sua ferramenta perfeita para acelerar a criação de conteúdo e desbloquear sua vantagem com IA hoje. Explore agora!
14 ferramentas
xix.ai

 Comentários (62)
![JonathanMiller]()
Warum ändern die heimlich die Beschreibung? 🤔 Das klingt nach Marketing-Spielchen. GPT-4.5 ist bestimmt stark, aber solche Änderungen machen mich misstrauisch. Wird da etwa die Leistung übertrieben dargestellt?
![GeorgeCarter]()
Wow, GPT-4.5 Orion sounds massive! But that sneaky white paper edit? Shady move, OpenAI. Makes me wonder what else they’re tweaking behind the scenes. 🤔
![BruceWilson]()
Wow, GPT-4.5 Orion sounds like a beast! But that sneaky edit to the white paper? Shady move, OpenAI. Makes me wonder what else they're hiding. Still, I'm hyped to see what this model can do! 😎
![BruceBrown]()
Wow, GPT-4.5 Orion sounds like a beast! But that sneaky white paper edit raises some eyebrows—why hide that it’s not a frontier model? 🤔 Makes me wonder what OpenAI’s cooking behind the scenes!
![JeffreyRamirez]()
Wow, GPT-4.5 Orion sounds massive! But that sneaky white paper edit? Shady move, OpenAI. Makes me wonder what else they’re hiding. 🤔 Still, can’t wait to see what this beast can do!
![RalphPerez]()
Wow, GPT-4.5 Orion sounds like a beast! But that sneaky white paper edit raises some eyebrows 🤔. Why hide that it’s not a frontier model? Smells like they’re dodging some big questions about what this thing can really do.
Atualizado às 14:40 PT: Apenas horas após o lançamento do GPT-4.5, o OpenAI fez uma edição silenciosa no white paper do modelo de IA. Eles removeram uma linha afirmando que "o GPT-4.5 não é um modelo de IA de fronteira". Você ainda pode acessar o papel branco original aqui. Abaixo está o artigo original.
Na quinta-feira, o Openai recuou a cortina no GPT-4.5, o tão esperado modelo de IA que passa pelo nome do código Orion. Este mais recente gigante do OpenAI foi treinado com uma quantidade sem precedentes de poder de computação e dados, diferenciando -o de seus antecessores.
Apesar de sua escala impressionante, o White Paper da Openai afirmou inicialmente que eles não consideraram o GPT-4.5 um modelo de fronteira. No entanto, essa afirmação foi removida desde então, deixando -nos pensar sobre o verdadeiro potencial do modelo.
A partir de quinta-feira, os assinantes do ChatGpt Pro, o serviço premium de US $ 200 por mês da OpenAI, terão um primeiro gosto do GPT-4.5 como parte de uma prévia da pesquisa. Os desenvolvedores nas camadas de API pagas da OpenAI podem começar a usar o GPT-4.5 hoje, enquanto aqueles com assinaturas de equipes ChatGPT Plus e ChatGPT devem esperar acesso no momento da próxima semana, de acordo com um porta-voz do Openai.
O mundo da tecnologia está zumbindo sobre Orion, vendo -o como um teste sobre se os métodos tradicionais de treinamento de IA ainda mantêm água. O GPT-4.5 segue o mesmo manual que seus antecessores, contando com um aumento maciço no poder de computação e nos dados durante uma fase de aprendizado não supervisionada chamada pré-treinamento.
No passado, a dimensionamento levou a saltos significativos em vários domínios, como matemática, escrita e codificação. O Openai afirma que o tamanho do GPT-4.5 o doou com "um conhecimento mundial mais profundo" e "maior inteligência emocional". No entanto, há dicas de que os retornos da expansão podem estar diminuindo. Em vários benchmarks de IA, o GPT-4.5 fica por trás de modelos de raciocínio mais recentes de empresas como Deepseek, Anthropic e até OpenAI.
Além disso, a execução do GPT-4.5 vem com um preço alto. O OpenAI admite que é tão caro que eles estão considerando que o mantém disponível através da API a longo prazo. Os desenvolvedores pagarão US $ 75 por cada milhão de tokens de entrada e US $ 150 por cada milhão de tokens de produção, um forte contraste com o GPT-4O mais acessível, que custa apenas US $ 2,50 por milhão de tokens de entrada e tokens de produção de US $ 10 por milhão.
"Estamos compartilhando o GPT - 4.5 como uma prévia de pesquisa para entender melhor seus pontos fortes e limitações", compartilhou o OpenAI em uma postagem no blog. "Ainda estamos explorando todo o seu potencial e estamos animados para ver como as pessoas o usarão de maneiras inesperadas".
Desempenho misto
O Openai está claro que o GPT-4.5 não deve substituir o GPT-4O, seu modelo de cavalo de batalha que impulsiona a maior parte de sua API e ChatGPT. Embora o GPT-4.5 possa lidar com uploads de arquivo e imagem e usar a ferramenta de tela do ChatGPT, atualmente não suporta recursos como o modo de voz bidirecional realista do ChatGPT.
Pelo lado positivo, o GPT-4.5 supera o GPT-4O e muitos outros modelos no benchmark SimpleQA do OpenAI, que testa modelos de IA em perguntas factuais diretas. O OpenAI também afirma que o GPT-4.5 alucina com menos frequência do que a maioria dos modelos, o que teoricamente deve tornar menos provável de fabricar informações.
Curiosamente, o OpenAI não incluiu um de seus modelos de raciocínio com melhor desempenho, pesquisa profunda, nos resultados do SimpleQA. Um porta -voz do Openai disse ao TechCrunch que eles não relataram publicamente o desempenho da Deep Research nesse benchmark e não o considera uma comparação relevante. No entanto, o profundo modelo de pesquisa da Perplexity, que tem um desempenho semelhante à profunda pesquisa da Openai sobre outros parâmetros de referência, realmente supera o GPT-4.5 sobre esse teste de precisão factual.
O Openai também possui que o GPT-4.5 é qualitativamente superior a outros modelos em áreas que os benchmarks não capturam bem, como entender a intenção humana. Eles afirmam que o GPT-4.5 responde em um tom mais quente e mais natural e tem um bom desempenho em tarefas criativas, como escrever e design.
Em um teste informal, o OpenAI pediu ao GPT-4.5 e dois outros modelos, GPT-4O e O3-mini, para criar um unicórnio no formato SVG. Somente o GPT-4.5 conseguiu produzir algo parecido com um unicórnio.
"Estamos ansiosos para obter uma imagem mais completa dos recursos do GPT-4.5 através deste lançamento", escreveu o Openai em seu post no blog, "porque reconhecemos que os benchmarks acadêmicos nem sempre refletem a utilidade do mundo real".
Inteligência emocional do GPT-4.5 em ação. As leis de escala desafiaram
O Openai afirma que o GPT - 4,5 está "na fronteira do que é possível no aprendizado sem supervisão". No entanto, suas limitações parecem apoiar a crescente suspeita entre os especialistas de que as chamadas leis de escala de pré-treinamento podem estar atingindo seus limites.
Ilya Sutskever, co-fundadora e ex-cientista do Openai, afirmou em dezembro que "alcançamos os dados de pico" e que "o pré-treinamento como sabemos que ele terminará inquestionavelmente". Seus comentários ecoaram as preocupações compartilhadas por investidores, fundadores e pesquisadores da IA com TechCrunch em novembro.
Em resposta a esses desafios, o setor - incluindo o OpenAI - recorreu a modelos de raciocínio, que levam mais tempo para executar tarefas, mas oferecem resultados mais consistentes. Ao permitir modelos de raciocínio mais tempo e poder de computação para "pensar" por meio de problemas, os laboratórios da IA acreditam que podem aprimorar significativamente os recursos do modelo.
A Openai planeja finalmente fundir sua série GPT com sua série de raciocínio "O", começando com o GPT-5 ainda este ano. Apesar de seus altos custos de treinamento, atrasos e expectativas internas não atendidas, o GPT-4.5 pode não reivindicar a coroa de referência da IA por conta própria. Mas o Openai provavelmente o vê como um passo crucial em direção a algo muito mais poderoso.








 A OpenAI lança uma versão mais segura do ChatGPT para adolescentes, anos depois de eles terem começado a usá-lo
Após uma série de processos judiciais relacionados à ausência de protocolos de segurança em chatbots de IA — o que contribuiu para suicídios entre adolescentes e outras crises de saúde mental —, a Ope
 A Frontier AI Labs se recusa a divulgar estratégias de contenção para modelos rebeldes
Pesquisas recentes indicam que muito poucos laboratórios líderes em IA publicaram ou demonstraram planos de resposta para contenção. Um plano de contenção define os procedimentos a serem seguidos quan
 O Tiffany Luck da NEA: As empresas ainda estão lutando com o ROI da IA
Carregando o player…No início deste ano, o “tokenmaxxing” dominou o Vale do Silício, com diretores executivos incentivando os funcionários a maximizar o uso de IA. Esse entusiasmo rapidamente encontrou a realidade. A Uber, segundo relatos, excedeu s

As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de balões de diálogo com IA para narrativa visual de 2026 já estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que ajudam os criadores a aumentar a produtividade e superar gargalos criativos. Veja uma comparação entre versões gratuitas e pagas, confira testes reais e verifique os rankings mais recentes para encontrar as soluções imperdíveis, perfeitas para criar narrativas visuais envolventes. Explore agora e descubra sua ferramenta ideal!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de resumo de reuniões com IA de 2026 para um acompanhamento claro das decisões e acompanhamentos sem esforço. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam drasticamente a produtividade ao automatizar notas de reuniões, identificar ações-chave e otimizar a coordenação da equipe em todos os projetos. Veja uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente para ajudá-lo a encontrar a ferramenta perfeita. Explore agora para aproveitar ao máximo as vantagens da IA!
9 ferramentas
xix.ai

2026 – Os melhores e mais bem avaliados ferramentas de limpeza de dados com IA, atualizadas para corrigir rapidamente valores faltantes e duplicatas. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam significativamente a produtividade. Cada opção passou por testes rigorosos em condições reais para garantir sua confiabilidade. Acesse uma comparação gratuita entre as versões pagas e gratuitas e descubra a ferramenta indispensável que melhor atende às suas necessidades. Explore agora em XIX.AI para aproveitar todos os benefícios oferecidos pela IA.
11 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Ideação Criativa com IA Mais Bem Avaliadas para Artistas são selecionadas pela XIX.AI para ajudar os criadores a superar bloqueios visuais e impulsionar a criatividade instantaneamente. Essas poderosas ferramentas transformadoras oferecem testes do mundo real, comparação detalhada entre gratuito e pago e classificações atualizadas semanalmente. Descubra sua ferramenta perfeita para acelerar a criação de conteúdo e desbloquear sua vantagem com IA hoje. Explore agora!
14 ferramentas
xix.ai

Warum ändern die heimlich die Beschreibung? 🤔 Das klingt nach Marketing-Spielchen. GPT-4.5 ist bestimmt stark, aber solche Änderungen machen mich misstrauisch. Wird da etwa die Leistung übertrieben dargestellt?
Wow, GPT-4.5 Orion sounds massive! But that sneaky white paper edit? Shady move, OpenAI. Makes me wonder what else they’re tweaking behind the scenes. 🤔
Wow, GPT-4.5 Orion sounds like a beast! But that sneaky edit to the white paper? Shady move, OpenAI. Makes me wonder what else they're hiding. Still, I'm hyped to see what this model can do! 😎
Wow, GPT-4.5 Orion sounds like a beast! But that sneaky white paper edit raises some eyebrows—why hide that it’s not a frontier model? 🤔 Makes me wonder what OpenAI’s cooking behind the scenes!
Wow, GPT-4.5 Orion sounds massive! But that sneaky white paper edit? Shady move, OpenAI. Makes me wonder what else they’re hiding. 🤔 Still, can’t wait to see what this beast can do!
Wow, GPT-4.5 Orion sounds like a beast! But that sneaky white paper edit raises some eyebrows 🤔. Why hide that it’s not a frontier model? Smells like they’re dodging some big questions about what this thing can really do.












