


 首頁
OpenAI啟動GPT-4.5'Orion':迄今為止其最大的AI模型
PT下午2:40更新:GPT-4.5發布後數小時,Openai對AI模型的白皮書進行了安靜的編輯。他們刪除了一條線,說“ GPT-4.5不是前沿AI模型”。您仍然可以在這裡訪問原始的白皮書。以下是原始文章。
週四,Openai撤回了GPT-4.5上的窗簾,這是備受期待的AI模型,該模型由代碼名稱Orion。來自OpenAI的最新龐然大物已經接受了空前數量的計算能力和數據的培訓,使其與前身區分開來。
儘管尺度令人印象深刻,但Openai的白皮書最初表示,他們並不認為GPT-4.5是邊境模型。但是,此聲明已被刪除,使我們想知道該模型的真正潛力。
從周四開始,作為研究預覽的一部分,OpenAI的Premium $ 200售價Chatgpt Pro的訂閱者將首先品嚐GPT-4.5。 OpenAI發言人說,OpenAI的付費API層的開發人員今天可以開始使用GPT-4.5,而擁有Chatgpt Plus和ChatGpt團隊訂閱的開發人員應該期望下周某個時候訪問。
科技界一直在嗡嗡作響,將其視為是否仍在含水的傳統AI培訓方法的測試。 GPT-4.5遵循與其前任相同的劇本,依靠無監督學習階段的計算能力和數據的巨大增加,稱為預培訓。
過去,擴展導致跨越數學,寫作和編碼等各個領域的性能突飛猛進。 Openai聲稱GPT-4.5的規模已賦予了“更深的世界知識”和“更高的情商”。然而,有一些暗示,從擴展到擴展的回報可能會減少。在幾個AI基準測試中,GPT-4.5落後於DeepSeek,Anthropic甚至Openai本身等公司的新推理模型。
此外,運行GPT-4.5的價格高昂。 Openai承認它是如此昂貴,以至於他們考慮是否長期通過其API來保持它。開發人員將為每百萬個輸入代幣支付75美元,每百萬個產量令牌為150美元,與價格更便宜的GPT-4O形成鮮明對比,GPT-4O的價格僅為每百萬美元的投入令牌2550美元和每百萬美元的產出代幣。
Openai在博客文章中分享道:“我們將分享GPT -4.5作為研究預覽,以更好地了解其優勢和局限性。” “我們仍在探索它的全部潛力,並很高興看到人們將如何以意想不到的方式使用它。”
混合性能
Openai很明顯,GPT-4.5並不是要取代驅動大部分API和CHATGPT的主力模型GPT-4O。雖然GPT-4.5可以處理文件和圖像上傳並使用Chatgpt的Canvas工具,但目前不支持Chatgpt現實的雙向語音模式之類的功能。
從明亮的一面來看,GPT-4.5在OpenAI的SimpleQA基準測試中勝過GPT-4O和許多其他模型,該基準測試了AI模型在直接,事實問題上。 Openai還聲稱,GPT-4.5的幻覺量低於大多數型號,從理論上講,這應該使製造信息的可能性降低。
有趣的是,OpenAI並未在SimpleQA結果中包括其表現最佳的推理模型之一。一位OpenAI發言人告訴TechCrunch,他們尚未公開報告深入研究在此基準測試中的表現,並且不認為這是相關的比較。但是,困惑的深度研究模型與OpenAI對其他基準測試的深入研究相似,實際上在這種事實準確性測試的測試中遠遠超出了GPT-4.5。
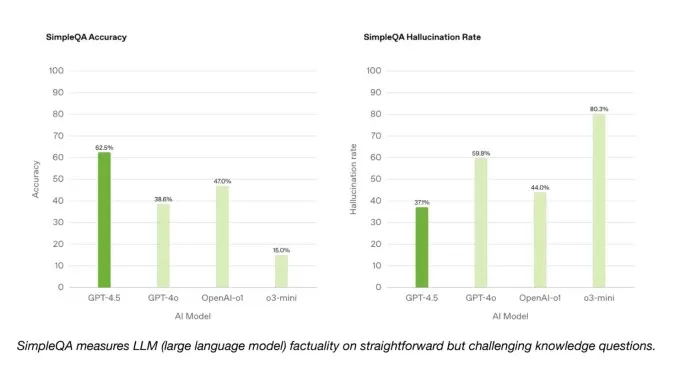
SimpleQA基準標記:圖像學分:OpenAi 在SWE Bench驗證的基準的一部分編碼問題中,GPT-4.5的性能類似於GPT-4O和O3-Mini,但距離OpenAI的深入研究和眾多的Claude 3.7十四行詩也沒有。在另一項編碼測試中,OpenAI的SWE-Lancer基準測量了AI模型開發完整軟件功能的能力,GPT-4.5的表現均優於GPT-4O和O3-Mini,但並未超過深入的研究。
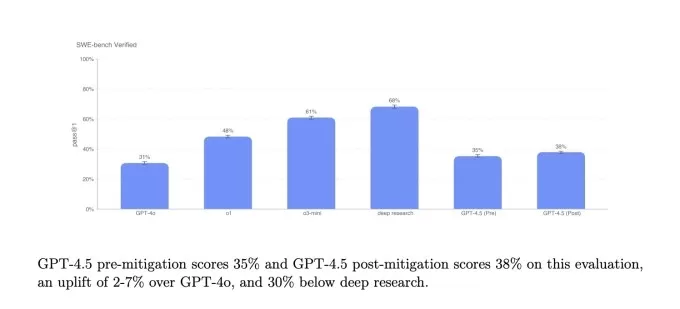
OpenAI的SWE Bench驗證的基準測試。圖片信用:OpenAI 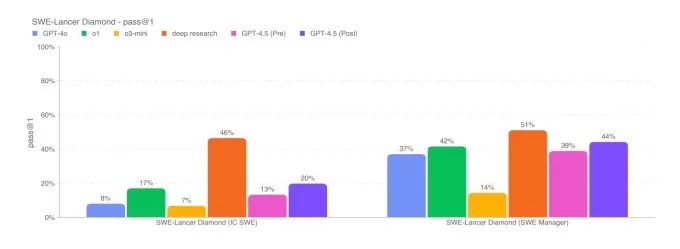
Openai的Swe-Lancer鑽石基準。圖像學分:OpenAI 儘管GPT-4.5與O3-Mini,DeepSeek的R1和Claude 3.7十四行詩(如AIME和GPQA)等領先的AI推理模型的性能完全不符,但它確實與在同一測試中領先的非常規模型相抵觸。這表明GPT-4.5在與數學和科學相關的任務中表現出色。
Openai還擁有GPT-4.5在質量上優於其他模型,而在基準測試的領域(例如了解人類意圖)。他們聲稱GPT-4.5以更溫暖,更自然的語氣做出反應,並且在寫作和設計等創意任務上表現良好。
在非正式測試中,OpenAI詢問了GPT-4.5,以及其他兩種型號GPT-4O和O3-Mini,以SVG格式創建獨角獸。只有GPT-4.5才能產生類似於獨角獸的東西。
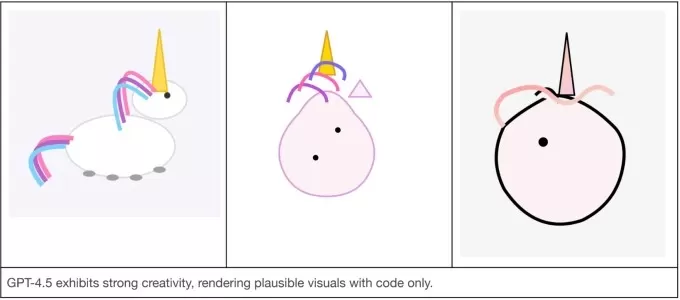
左:GPT-4.5,中間:GPT-4O,右:O3-Mini。圖像學分:OpenAi 在另一項測試中,OpenAI提示GPT-4.5和其他模型對提示做出回應:“在未能完成測試後,我經歷了艱難的時期。”雖然GPT-4O和O3-Mini提供了有用的信息,但GPT-4.5的反應在社會上是最合適的。
Openai在他們的博客文章中寫道:“我們期待通過此版本獲得更完整的GPT-4.5功能圖片,因為我們認識到學術基準並不總是反映現實世界中的有用性。”

GPT-4.5的情緒智力在行動中。圖片學分:OpenAI 擴展法律挑戰
Openai聲稱GPT -4.5是“在無監督學習中可能的邊界”。然而,它的局限性似乎支持了專家對所謂的預訓練規律可能達到限制的越來越多的懷疑。
Openai聯合創始人兼前首席科學家Ilya Sutskever在12月表示,“我們已經達到了峰值數據”,並且“眾所周知,這將毫無疑問地結束”。他的評論回應了11月AI投資者,創始人和研究人員的擔憂。
為了應對這些挑戰,該行業(包括OpenAI)轉向了推理模型,這些模型需要更長的時間來執行任務,但提供了更一致的結果。通過允許推理模型更多的時間和計算能力通過問題“思考”,AI實驗室認為它們可以顯著增強模型功能。
Openai計劃最終將其GPT系列與其“ O”推理系列合併,從今年晚些時候GPT-5開始。儘管培訓成本,延遲和未滿足的內部期望,GPT-4.5可能並沒有單獨主張AI基準冠冕。但是Openai可能將其視為邁向更強大的事情的關鍵一步。
相關文章
 OpenAI 在青少年開始使用 ChatGPT 數年後,推出了一款更安全的 ChatGPT 版本
在因人工智慧聊天機器人缺乏安全機制——此問題曾導致青少年自殺及其他心理健康危機——而引發一系列訴訟後,OpenAI 於週一正式推出「ChatGPT for Teens」。這項新服務整合了強化版的安全功能,並針對校園中因人工智慧工具而日益嚴重的學術不誠實問題提出解決方案。從教育角度來看,「ChatGPT for Teens」除了推出「學習模式」外,還整合了其他旨在培養好奇心與問題解決能力的工具,鼓勵
Frontier AI Labs 拒絕透露針對失控模型的管控策略
近期研究顯示,極少數頂尖的人工智慧實驗室曾公布或展示過「遏制應變計畫」。遏制計畫旨在界定當人工智慧系統試圖顛覆人類控制時應採取的程序,具體說明應撤銷哪些存取權限,以及何時應完全關閉系統。這些發現來自「Guidelight AI Standards」——一個致力於推動安全前沿人工智慧開發實務的組織,該組織針對五家主要實驗室在此類情境下的應變準備程度進行了評估。 OpenAI 排名最高,而 Anthr
NEA的蒂芙尼·拉克:企業仍在努力應對人工智慧的投資回報率
正在載入播放器…今年早些時候,“token最大化”(tokenmaxxing)在矽谷佔據主導地位,執行長們敦促員工最大限度地利用人工智慧。然而,這種熱情很快遭遇了現實。據報道,Uber在幾個月內就超出了其年度人工智慧預算,一些公司跨部門削減了Claude許可證,而Meta則取消了內部績效排名。NEA合夥人蒂芙尼·拉克(Tiffany Luck)每天都在應對這種興奮與實際回報之間的差距。她此前曾成功說服企業電子商務是未來,如今她完全專注於人工智慧,特別是其為消費者創造“神奇時刻”的潛力。
相關專題推薦
聊天機器人
 用於語言練習、面試準備和日常流利度的最佳 AI 角色扮演聊天應用
2026 年最新最佳頂級評分 AI 角色扮演聊天應用,用於語言練習、面試準備和日常流利度!XIX.AI 精心策劃了一個強大的變革性合集,提供免費與付費對比、真實世界測試以及每週更新的排名。這些必試工具可幫助您提升寫作技能,克服流利度挑戰,並提高所有日常場景下的溝通效率。立即探索,發現您語言成長的完美工具!
 10 個工具
 xix.ai
音樂創作
用於混音製作、取樣準備及卡拉OK母帶處理的 AI 聲部分離工具
2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
8 個工具
xix.ai
數據分析
用於收入看板、轉化漏斗分析及產品指標分析的 AI SQL 助手
2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai
音樂創作
最佳用於歌曲草稿的 AI 旋律創作工具
2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai
聊天機器人
最適合面試練習的 AI 對話訓練工具
2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai
設計與藝術
最適合進行創意實驗的 AI 風格轉移工具
2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai

 評論 (62)
0/500
![JonathanMiller]()
Warum ändern die heimlich die Beschreibung? 🤔 Das klingt nach Marketing-Spielchen. GPT-4.5 ist bestimmt stark, aber solche Änderungen machen mich misstrauisch. Wird da etwa die Leistung übertrieben dargestellt?
![GeorgeCarter]()
Wow, GPT-4.5 Orion sounds massive! But that sneaky white paper edit? Shady move, OpenAI. Makes me wonder what else they’re tweaking behind the scenes. 🤔
![BruceWilson]()
Wow, GPT-4.5 Orion sounds like a beast! But that sneaky edit to the white paper? Shady move, OpenAI. Makes me wonder what else they're hiding. Still, I'm hyped to see what this model can do! 😎
![BruceBrown]()
Wow, GPT-4.5 Orion sounds like a beast! But that sneaky white paper edit raises some eyebrows—why hide that it’s not a frontier model? 🤔 Makes me wonder what OpenAI’s cooking behind the scenes!
![JeffreyRamirez]()
Wow, GPT-4.5 Orion sounds massive! But that sneaky white paper edit? Shady move, OpenAI. Makes me wonder what else they’re hiding. 🤔 Still, can’t wait to see what this beast can do!
![RalphPerez]()
Wow, GPT-4.5 Orion sounds like a beast! But that sneaky white paper edit raises some eyebrows 🤔. Why hide that it’s not a frontier model? Smells like they’re dodging some big questions about what this thing can really do.
PT下午2:40更新:GPT-4.5發布後數小時,Openai對AI模型的白皮書進行了安靜的編輯。他們刪除了一條線,說“ GPT-4.5不是前沿AI模型”。您仍然可以在這裡訪問原始的白皮書。以下是原始文章。
週四,Openai撤回了GPT-4.5上的窗簾,這是備受期待的AI模型,該模型由代碼名稱Orion。來自OpenAI的最新龐然大物已經接受了空前數量的計算能力和數據的培訓,使其與前身區分開來。
儘管尺度令人印象深刻,但Openai的白皮書最初表示,他們並不認為GPT-4.5是邊境模型。但是,此聲明已被刪除,使我們想知道該模型的真正潛力。
從周四開始,作為研究預覽的一部分,OpenAI的Premium $ 200售價Chatgpt Pro的訂閱者將首先品嚐GPT-4.5。 OpenAI發言人說,OpenAI的付費API層的開發人員今天可以開始使用GPT-4.5,而擁有Chatgpt Plus和ChatGpt團隊訂閱的開發人員應該期望下周某個時候訪問。
科技界一直在嗡嗡作響,將其視為是否仍在含水的傳統AI培訓方法的測試。 GPT-4.5遵循與其前任相同的劇本,依靠無監督學習階段的計算能力和數據的巨大增加,稱為預培訓。
過去,擴展導致跨越數學,寫作和編碼等各個領域的性能突飛猛進。 Openai聲稱GPT-4.5的規模已賦予了“更深的世界知識”和“更高的情商”。然而,有一些暗示,從擴展到擴展的回報可能會減少。在幾個AI基準測試中,GPT-4.5落後於DeepSeek,Anthropic甚至Openai本身等公司的新推理模型。
此外,運行GPT-4.5的價格高昂。 Openai承認它是如此昂貴,以至於他們考慮是否長期通過其API來保持它。開發人員將為每百萬個輸入代幣支付75美元,每百萬個產量令牌為150美元,與價格更便宜的GPT-4O形成鮮明對比,GPT-4O的價格僅為每百萬美元的投入令牌2550美元和每百萬美元的產出代幣。
Openai在博客文章中分享道:“我們將分享GPT -4.5作為研究預覽,以更好地了解其優勢和局限性。” “我們仍在探索它的全部潛力,並很高興看到人們將如何以意想不到的方式使用它。”
混合性能
Openai很明顯,GPT-4.5並不是要取代驅動大部分API和CHATGPT的主力模型GPT-4O。雖然GPT-4.5可以處理文件和圖像上傳並使用Chatgpt的Canvas工具,但目前不支持Chatgpt現實的雙向語音模式之類的功能。
從明亮的一面來看,GPT-4.5在OpenAI的SimpleQA基準測試中勝過GPT-4O和許多其他模型,該基準測試了AI模型在直接,事實問題上。 Openai還聲稱,GPT-4.5的幻覺量低於大多數型號,從理論上講,這應該使製造信息的可能性降低。
有趣的是,OpenAI並未在SimpleQA結果中包括其表現最佳的推理模型之一。一位OpenAI發言人告訴TechCrunch,他們尚未公開報告深入研究在此基準測試中的表現,並且不認為這是相關的比較。但是,困惑的深度研究模型與OpenAI對其他基準測試的深入研究相似,實際上在這種事實準確性測試的測試中遠遠超出了GPT-4.5。
Openai還擁有GPT-4.5在質量上優於其他模型,而在基準測試的領域(例如了解人類意圖)。他們聲稱GPT-4.5以更溫暖,更自然的語氣做出反應,並且在寫作和設計等創意任務上表現良好。
在非正式測試中,OpenAI詢問了GPT-4.5,以及其他兩種型號GPT-4O和O3-Mini,以SVG格式創建獨角獸。只有GPT-4.5才能產生類似於獨角獸的東西。
Openai在他們的博客文章中寫道:“我們期待通過此版本獲得更完整的GPT-4.5功能圖片,因為我們認識到學術基準並不總是反映現實世界中的有用性。”
GPT-4.5的情緒智力在行動中。圖片學分:OpenAI 擴展法律挑戰
Openai聲稱GPT -4.5是“在無監督學習中可能的邊界”。然而,它的局限性似乎支持了專家對所謂的預訓練規律可能達到限制的越來越多的懷疑。
Openai聯合創始人兼前首席科學家Ilya Sutskever在12月表示,“我們已經達到了峰值數據”,並且“眾所周知,這將毫無疑問地結束”。他的評論回應了11月AI投資者,創始人和研究人員的擔憂。
為了應對這些挑戰,該行業(包括OpenAI)轉向了推理模型,這些模型需要更長的時間來執行任務,但提供了更一致的結果。通過允許推理模型更多的時間和計算能力通過問題“思考”,AI實驗室認為它們可以顯著增強模型功能。
Openai計劃最終將其GPT系列與其“ O”推理系列合併,從今年晚些時候GPT-5開始。儘管培訓成本,延遲和未滿足的內部期望,GPT-4.5可能並沒有單獨主張AI基準冠冕。但是Openai可能將其視為邁向更強大的事情的關鍵一步。








 OpenAI 在青少年開始使用 ChatGPT 數年後,推出了一款更安全的 ChatGPT 版本
在因人工智慧聊天機器人缺乏安全機制——此問題曾導致青少年自殺及其他心理健康危機——而引發一系列訴訟後,OpenAI 於週一正式推出「ChatGPT for Teens」。這項新服務整合了強化版的安全功能,並針對校園中因人工智慧工具而日益嚴重的學術不誠實問題提出解決方案。從教育角度來看,「ChatGPT for Teens」除了推出「學習模式」外,還整合了其他旨在培養好奇心與問題解決能力的工具,鼓勵
 Frontier AI Labs 拒絕透露針對失控模型的管控策略
近期研究顯示,極少數頂尖的人工智慧實驗室曾公布或展示過「遏制應變計畫」。遏制計畫旨在界定當人工智慧系統試圖顛覆人類控制時應採取的程序,具體說明應撤銷哪些存取權限,以及何時應完全關閉系統。這些發現來自「Guidelight AI Standards」——一個致力於推動安全前沿人工智慧開發實務的組織,該組織針對五家主要實驗室在此類情境下的應變準備程度進行了評估。 OpenAI 排名最高,而 Anthr
 NEA的蒂芙尼·拉克:企業仍在努力應對人工智慧的投資回報率
正在載入播放器…今年早些時候,“token最大化”(tokenmaxxing)在矽谷佔據主導地位,執行長們敦促員工最大限度地利用人工智慧。然而,這種熱情很快遭遇了現實。據報道,Uber在幾個月內就超出了其年度人工智慧預算,一些公司跨部門削減了Claude許可證,而Meta則取消了內部績效排名。NEA合夥人蒂芙尼·拉克(Tiffany Luck)每天都在應對這種興奮與實際回報之間的差距。她此前曾成功說服企業電子商務是未來,如今她完全專注於人工智慧,特別是其為消費者創造“神奇時刻”的潛力。

2026 年最新最佳頂級評分 AI 角色扮演聊天應用,用於語言練習、面試準備和日常流利度!XIX.AI 精心策劃了一個強大的變革性合集,提供免費與付費對比、真實世界測試以及每週更新的排名。這些必試工具可幫助您提升寫作技能,克服流利度挑戰,並提高所有日常場景下的溝通效率。立即探索,發現您語言成長的完美工具!
10 個工具
xix.ai

2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
8 個工具
xix.ai

2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai

2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai

2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai

2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai

Warum ändern die heimlich die Beschreibung? 🤔 Das klingt nach Marketing-Spielchen. GPT-4.5 ist bestimmt stark, aber solche Änderungen machen mich misstrauisch. Wird da etwa die Leistung übertrieben dargestellt?
Wow, GPT-4.5 Orion sounds massive! But that sneaky white paper edit? Shady move, OpenAI. Makes me wonder what else they’re tweaking behind the scenes. 🤔
Wow, GPT-4.5 Orion sounds like a beast! But that sneaky edit to the white paper? Shady move, OpenAI. Makes me wonder what else they're hiding. Still, I'm hyped to see what this model can do! 😎
Wow, GPT-4.5 Orion sounds like a beast! But that sneaky white paper edit raises some eyebrows—why hide that it’s not a frontier model? 🤔 Makes me wonder what OpenAI’s cooking behind the scenes!
Wow, GPT-4.5 Orion sounds massive! But that sneaky white paper edit? Shady move, OpenAI. Makes me wonder what else they’re hiding. 🤔 Still, can’t wait to see what this beast can do!
Wow, GPT-4.5 Orion sounds like a beast! But that sneaky white paper edit raises some eyebrows 🤔. Why hide that it’s not a frontier model? Smells like they’re dodging some big questions about what this thing can really do.












