


 家
OpenaiはGPT-4.5「Orion」を起動します:これまでの最大のAIモデル
更新された午後2時40分PT:GPT-4.5の発売から数時間後、OpenaiはAIモデルのホワイトペーパーを静かに編集しました。彼らは、「GPT-4.5はフロンティアAIモデルではない」というラインを削除しました。ここで元のホワイトペーパーにアクセスできます。以下は元の記事です。
木曜日に、Openaiは、コード名Orionで行われる非常に予想されるAIモデルであるGPT-4.5でカーテンを引き戻しました。 Openaiのこの最新の巨人は、前例のない量のコンピューティングパワーとデータで訓練されており、前任者とは一線を画しています。
その印象的な規模にもかかわらず、Openaiのホワイトペーパーは当初、GPT-4.5はフロンティアモデルとは見なさなかったと述べました。しかし、その声明はその後削除され、モデルの真の可能性について疑問に思うようになりました。
木曜日から、Openaiのプレミアム200か月間のサービスであるChatGpt Proの購読者は、研究プレビューの一環としてGPT-4.5の最初の味を獲得します。 OpenAIの有料API層の開発者は、今日GPT-4.5の使用を開始できますが、OpenAIの広報担当者によると、ChatGpt PlusとChatGptチームのサブスクリプションを使用している人は来週のいつかアクセスを期待するはずです。
テクノロジーの世界はオリオンについて話題になっており、従来のAIトレーニング方法がまだ水を保持しているかどうかのテストと見なしています。 GPT-4.5は、前任者と同じプレイブックを追跡し、トレーニング前と呼ばれる監視されていない学習段階でのコンピューティングパワーとデータの大幅な増加に依存しています。
過去には、スケールアップにより、数学、執筆、コーディングなどのさまざまなドメインに大きなパフォーマンスが飛躍しました。 Openaiは、GPT-4.5のサイズが「より深い世界の知識」と「より高い感情的知性」を与えたと主張しています。しかし、スケールアップからのリターンが減少する可能性があるというヒントがあります。いくつかのAIベンチマークでは、GPT-4.5は、Deepseek、人類、さらにはOpenai自体などの企業からの新しい推論モデルに遅れをとっています。
さらに、GPT-4.5の実行には多額の値札が付いています。 Openaiは、それが非常に高価であると認めているため、長期的にAPIを通じて利用可能にするかどうかを検討しています。開発者は、入力トークンごとに75ドル、100万の出力トークンごとに150ドルを支払います。これは、より手頃な価格のGPT-4Oとはまったく対照的で、100万ドルあたり2.50ドル、100万ドルあたり10ドルかかります。
「私たちは、GPT -4.5を研究プレビューとして共有して、その強みと制限をよりよく理解するためです」とOpenaiはブログ投稿で共有しています。 「私たちはまだその可能性を最大限に発揮しており、人々が予想外の方法でそれをどのように使用するかを楽しみにしています。」
混合パフォーマンス
Openaiは、GPT-4.5がAPIとChatGPTの大部分を駆動する主力モデルであるGPT-4Oを置き換えることを意図していないことは明らかです。 GPT-4.5はファイルと画像のアップロードを処理し、ChatGPTのCanvasツールを使用できますが、現在、ChatGPTのリアルな双方向の音声モードなどの機能をサポートしていません。
明るい面では、GPT-4.5はGPT-4OとOpenAIのSimpleQAベンチマーク上の他の多くのモデルよりも優れています。また、Openaiは、GPT-4.5がほとんどのモデルよりも頻繁に幻覚の頻度が低いと主張しており、理論的には情報の製造の可能性が低くなるはずです。
興味深いことに、Openaiは、SimpleQAの結果に、そのトップパフォーマンスの推論モデル、ディープリサーチの1つを含めていませんでした。 Openaiの広報担当者はTechCrunchに、このベンチマークでDeep Researchのパフォーマンスを公に報告しておらず、関連する比較とは考えていないと語った。ただし、他のベンチマークに関するOpenaiの深い研究と同様に実行されるPerplexityの深い研究モデルは、実際にこの事実上の精度のテストでGPT-4.5を上回っています。
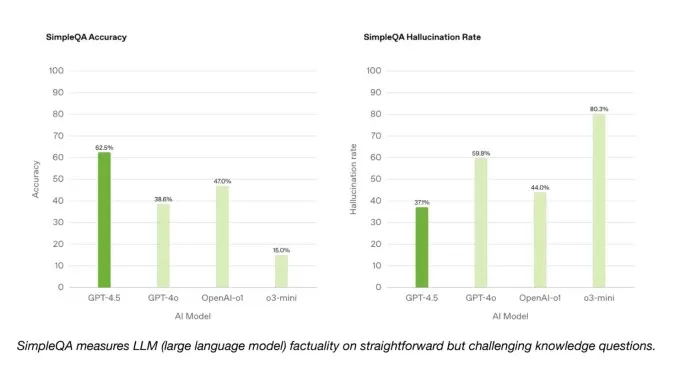
SimpleQA Benchmarks.Imageクレジット:Openai SWEベンチ検証ベンチマークからのコーディング問題のサブセットでは、GPT-4.5はGPT-4OおよびO3-MINIと同様に機能しますが、Openaiの深い研究と人類のClaude 3.7 Sonnetには及ばない。別のコーディングテストでは、完全なソフトウェア機能を開発するAIモデルの能力を測定するOpenAIのSWEランサーベンチマークでは、GPT-4.5はGPT-4OとO3-MINIの両方を上回りますが、深い研究を上回りません。
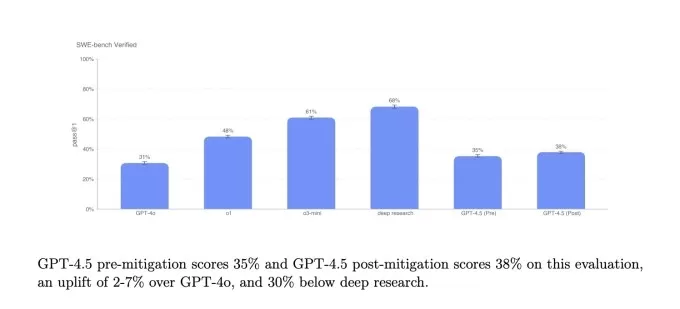
OpenaiのSWEベンチ検証benchmark.imageクレジット:Openai 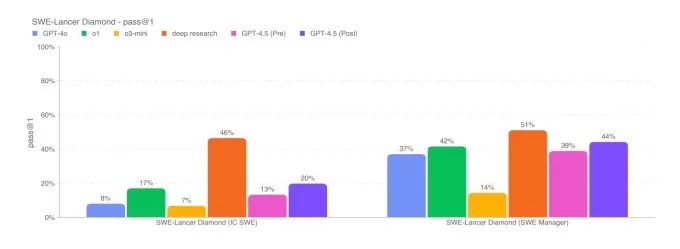
OpenaiのSWE-LANCER DIAMOND BENCHMARK.IMAGE CREDITS:Openai GPT-4.5は、AIAMEやGPQAなどの挑戦的なアカデミックベンチマークでO3-Mini、DeepseekのR1、Claude 3.7 Sonnetなどの主要なAI推論モデルのパフォーマンスとはまったく一致していませんが、同じテストでの主要な非合理的なモデルに対して独自に保持しています。これは、GPT-4.5が数学および科学関連のタスクに優れていることを示唆しています。
Openaiはまた、GPT-4.5が、人間の意図を理解するなど、ベンチマークがうまくキャプチャしない領域の他のモデルよりも定性的に優れていることを誇っています。彼らは、GPT-4.5がより暖かく、より自然なトーンで反応し、執筆やデザインなどの創造的なタスクでうまく機能すると主張しています。
非公式のテストで、OpenaiはGPT-4.5と他の2つのモデルであるGPT-4OとO3-MINIに、SVG形式でユニコーンを作成するように依頼しました。 GPT-4.5のみがユニコーンに似たものを生産することができました。
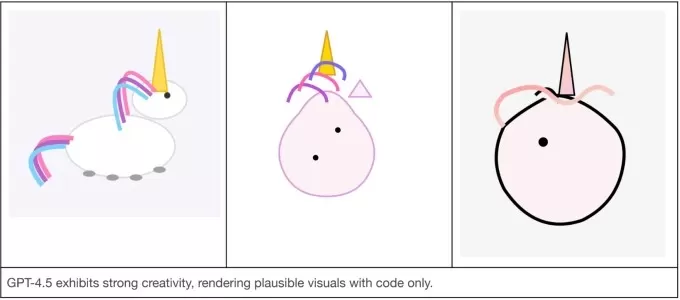
左:GPT-4.5、ミドル:GPT-4O、右:O3-mini.imageクレジット:Openai 別のテストで、OpenaiはGPT-4.5と他のモデルに「テストに失敗した後、苦労している」プロンプトに応答するように促しました。 GPT-4OとO3-MINIは有用な情報を提供しましたが、GPT-4.5の応答は最も社会的に適切でした。
「このリリースを通じてGPT-4.5の機能のより完全な写真を獲得できることを楽しみにしています」とOpenaiはブログ投稿に書いています。

GPT-4.5のAction.Image Credits:Openai スケーリング法は異議を申し立てました
Openaiは、GPT -4.5は「監視されていない学習で可能なことのフロンティアにある」と主張しています。しかし、その制限は、いわゆるトレーニングのスケーリング法が彼らの限界に達している可能性があるという専門家の間での疑いの高まりを支持しているようです。
Openaiの共同設立者で元チーフサイエンティストのIlya Sutskeverは、12月に「私たちはピークデータを達成した」と「疑いなく終わらせることがわかっているようにトレーニング前」と述べました。彼のコメントは、11月にTechCrunchのAI投資家、創業者、研究者が共有する懸念を反映しています。
これらの課題に対応して、Openaiを含む業界は、タスクを実行するのに時間がかかるが、より一貫した結果を提供するという推論モデルに目を向けています。推論モデルをより多くの時間と計算に問題を介して「考える」ことを許可することにより、AI Labsはモデル機能を大幅に強化できると考えています。
Openaiは、最終的にGPTシリーズを「O」推論シリーズと統合する予定で、今年後半にGPT-5から始まります。トレーニングコストが高く、遅延、内部の期待に満ちていないにもかかわらず、GPT-4.5はAIベンチマーククラウンを単独で請求しない場合があります。しかし、Openaiは、それをはるかに強力なものへの重要なステップと見なしている可能性があります。
関連記事
 OpenAIは、10代の若者がChatGPTを使い始めてから数年を経て、より安全なChatGPTをリリースした
AIチャットボットに安全対策が欠如していたことによる一連の訴訟――これが10代の自殺やその他のメンタルヘルスの危機の一因となった――を受け、OpenAIは月曜日に「ChatGPT for Teens」を発表した。この新サービスには強化された安全機能が組み込まれており、学校現場でAIツールによって助長されている学業上の不正行為という深刻化する問題に対処している。教育的な観点から、「ChatGPT f
フロンティアAIラボ、異常挙動を示すモデルの封じ込め戦略の開示を拒否
最近の調査によると、主要なAI研究所のうち、封じ込め対応計画を公表または実証しているところはごくわずかであることが示されている。封じ込め計画とは、AIシステムが人間の制御を覆そうとした場合の対応手順を定義するもので、どのアクセス権限を取り消すか、またいつシステムを完全にシャットダウンするかを具体的に規定している。この調査結果は、安全な最先端AI開発の実践を推進することに注力する組織「Guideli
NEAのティファニー・ラック:企業はまだAIのROIに苦戦している
プレイヤーを読み込み中…今年初頭、シリコンバレーでは「トークン最大化」が話題を独占し、CEOたちは社員にAIの使用を最大化するよう促した。しかし、その熱狂はすぐに現実とぶつかった。ウーバーは報告によると、数ヶ月で年間AI予算を超過し、一部の企業は部門全体でClaudeのライセンスを削減し、メタは社内パフォーマンスランキングを廃止した。NEAパートナーのティファニー・ラックは、この興奮と実際のリターンのギャップを日々乗り越えている。以前はECが未来であると企業を説得した経験を持つ彼女は、現在、
関連特集おすすめ
動画作成
 Reels、Shorts、および製品ローンチキャンペーン向けのAIショート動画フック生成ツール
2026年最新!ReelsやShorts、製品ローンチキャンペーンに最適なAIショート動画フック生成ツール!XIX.AIは、実地テストを通じて「必ず試すべき」結果をもたらす、高評価で画期的なツールを厳選しています。毎週更新されるこのページでは、無料版と有料版の比較ランキングを掲載しており、コンテンツの創造性と生産性を高める最適なソリューションを見つけるお手伝いをします。 今すぐチェックして、AIの力を最大限に活用しましょう!
 11 ツール
 xix.ai
書き込み
長文執筆のためのAI記事構成ツール
2026年最新・最高評価のAIアウトラインツール:長文執筆に最適!この厳選コレクションには、執筆効率を大幅に向上させる、実証済みのテストを経て正確かつ構造化されたアウトラインを生成する、強力で画期的なツールが紹介されています。XIX.AIもこの厳選されたツールの一つです。 無料版と有料版の比較表を入手して、最適なツールの選択に役立ててください。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai
チャットボット
言語練習、面接対策、そして日常の流暢さのための最高のAIロールプレイチャットアプリ
2026年最新版・最高評価のAIロールプレイチャットアプリ|語学練習、面接対策、日常会話の流暢さ向上に!XIX.AIは、無料と有料の比較、実世界でのテスト、毎週更新されるランキングを提供する革新的なコレクションを厳選しています。これらの必須ツールは、ライティングスキルの向上、流暢さの課題克服、そしてあらゆる日常シナリオにおけるコミュニケーション効率の改善をサポートします。今すぐ探索して、あなたの言語成長に最適なツールを見つけましょう!
10 ツール
xix.ai
作曲
リミックス制作、サンプリングの準備、カラオケマスター作成のためのAIステム分離ツール
2026年最新・最高評価のAIステム分離ツール。リミックス制作、サンプリング準備、カラオケマスター向けに厳選されました。これらの強力で画期的なツールは、実環境でのテストを経て、正確なオーディオ分離を実現し、生産性を大幅に向上させます。 XIX.AIでは、ニーズに合った「必試」のソリューションを見つけるお手伝いをするため、無料版と有料版の比較ガイドを毎週更新して提供しています。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai
データ分析
収益ダッシュボード、ファネル分析、および製品指標向けのAI SQLコピロット
2026年最新かつ最も優れたAI SQLコピロットが最高評価でランクイン!XIX.AIは、毎週更新される実際の環境でのテストに対応した、強力で革新的なツール群を厳選しています。これらの必見ツールを使えば、正確な収益ダッシュボードの作成や販売プロセスの分析、製品指標の迅速な追跡が可能となり、生産性を大幅に向上させることができます。今すぐチェックして、データに基づいた意思決定に最適なツールを見つけましょう!238文字
9 ツール
xix.ai
作曲
曲のドラフト作成に最適なAIメロディ作成ツール
2026年最新版 高評価のAIメロディ作成ツールで曲のドラフト作成!XIX.AIは、厳格な実世界テストを経て最高の作成体験を提供する、革新的な強力なコレクションを厳選しました。詳細な無料版と有料版の比較、正確なランキング、そして素晴らしい曲のドラフトを楽に作成し、創造的な生産性を大幅に向上させるためにぜひ試すべきオプションが見つかります。今すぐ探索して、あなたに最適なツールを見つけましょう!
8 ツール
xix.ai

 コメント (62)
0/500
![JonathanMiller]()
Warum ändern die heimlich die Beschreibung? 🤔 Das klingt nach Marketing-Spielchen. GPT-4.5 ist bestimmt stark, aber solche Änderungen machen mich misstrauisch. Wird da etwa die Leistung übertrieben dargestellt?
![GeorgeCarter]()
Wow, GPT-4.5 Orion sounds massive! But that sneaky white paper edit? Shady move, OpenAI. Makes me wonder what else they’re tweaking behind the scenes. 🤔
![BruceWilson]()
Wow, GPT-4.5 Orion sounds like a beast! But that sneaky edit to the white paper? Shady move, OpenAI. Makes me wonder what else they're hiding. Still, I'm hyped to see what this model can do! 😎
![BruceBrown]()
Wow, GPT-4.5 Orion sounds like a beast! But that sneaky white paper edit raises some eyebrows—why hide that it’s not a frontier model? 🤔 Makes me wonder what OpenAI’s cooking behind the scenes!
![JeffreyRamirez]()
Wow, GPT-4.5 Orion sounds massive! But that sneaky white paper edit? Shady move, OpenAI. Makes me wonder what else they’re hiding. 🤔 Still, can’t wait to see what this beast can do!
![RalphPerez]()
Wow, GPT-4.5 Orion sounds like a beast! But that sneaky white paper edit raises some eyebrows 🤔. Why hide that it’s not a frontier model? Smells like they’re dodging some big questions about what this thing can really do.
更新された午後2時40分PT:GPT-4.5の発売から数時間後、OpenaiはAIモデルのホワイトペーパーを静かに編集しました。彼らは、「GPT-4.5はフロンティアAIモデルではない」というラインを削除しました。ここで元のホワイトペーパーにアクセスできます。以下は元の記事です。
木曜日に、Openaiは、コード名Orionで行われる非常に予想されるAIモデルであるGPT-4.5でカーテンを引き戻しました。 Openaiのこの最新の巨人は、前例のない量のコンピューティングパワーとデータで訓練されており、前任者とは一線を画しています。
その印象的な規模にもかかわらず、Openaiのホワイトペーパーは当初、GPT-4.5はフロンティアモデルとは見なさなかったと述べました。しかし、その声明はその後削除され、モデルの真の可能性について疑問に思うようになりました。
木曜日から、Openaiのプレミアム200か月間のサービスであるChatGpt Proの購読者は、研究プレビューの一環としてGPT-4.5の最初の味を獲得します。 OpenAIの有料API層の開発者は、今日GPT-4.5の使用を開始できますが、OpenAIの広報担当者によると、ChatGpt PlusとChatGptチームのサブスクリプションを使用している人は来週のいつかアクセスを期待するはずです。
テクノロジーの世界はオリオンについて話題になっており、従来のAIトレーニング方法がまだ水を保持しているかどうかのテストと見なしています。 GPT-4.5は、前任者と同じプレイブックを追跡し、トレーニング前と呼ばれる監視されていない学習段階でのコンピューティングパワーとデータの大幅な増加に依存しています。
過去には、スケールアップにより、数学、執筆、コーディングなどのさまざまなドメインに大きなパフォーマンスが飛躍しました。 Openaiは、GPT-4.5のサイズが「より深い世界の知識」と「より高い感情的知性」を与えたと主張しています。しかし、スケールアップからのリターンが減少する可能性があるというヒントがあります。いくつかのAIベンチマークでは、GPT-4.5は、Deepseek、人類、さらにはOpenai自体などの企業からの新しい推論モデルに遅れをとっています。
さらに、GPT-4.5の実行には多額の値札が付いています。 Openaiは、それが非常に高価であると認めているため、長期的にAPIを通じて利用可能にするかどうかを検討しています。開発者は、入力トークンごとに75ドル、100万の出力トークンごとに150ドルを支払います。これは、より手頃な価格のGPT-4Oとはまったく対照的で、100万ドルあたり2.50ドル、100万ドルあたり10ドルかかります。
「私たちは、GPT -4.5を研究プレビューとして共有して、その強みと制限をよりよく理解するためです」とOpenaiはブログ投稿で共有しています。 「私たちはまだその可能性を最大限に発揮しており、人々が予想外の方法でそれをどのように使用するかを楽しみにしています。」
混合パフォーマンス
Openaiは、GPT-4.5がAPIとChatGPTの大部分を駆動する主力モデルであるGPT-4Oを置き換えることを意図していないことは明らかです。 GPT-4.5はファイルと画像のアップロードを処理し、ChatGPTのCanvasツールを使用できますが、現在、ChatGPTのリアルな双方向の音声モードなどの機能をサポートしていません。
明るい面では、GPT-4.5はGPT-4OとOpenAIのSimpleQAベンチマーク上の他の多くのモデルよりも優れています。また、Openaiは、GPT-4.5がほとんどのモデルよりも頻繁に幻覚の頻度が低いと主張しており、理論的には情報の製造の可能性が低くなるはずです。
興味深いことに、Openaiは、SimpleQAの結果に、そのトップパフォーマンスの推論モデル、ディープリサーチの1つを含めていませんでした。 Openaiの広報担当者はTechCrunchに、このベンチマークでDeep Researchのパフォーマンスを公に報告しておらず、関連する比較とは考えていないと語った。ただし、他のベンチマークに関するOpenaiの深い研究と同様に実行されるPerplexityの深い研究モデルは、実際にこの事実上の精度のテストでGPT-4.5を上回っています。
Openaiはまた、GPT-4.5が、人間の意図を理解するなど、ベンチマークがうまくキャプチャしない領域の他のモデルよりも定性的に優れていることを誇っています。彼らは、GPT-4.5がより暖かく、より自然なトーンで反応し、執筆やデザインなどの創造的なタスクでうまく機能すると主張しています。
非公式のテストで、OpenaiはGPT-4.5と他の2つのモデルであるGPT-4OとO3-MINIに、SVG形式でユニコーンを作成するように依頼しました。 GPT-4.5のみがユニコーンに似たものを生産することができました。
「このリリースを通じてGPT-4.5の機能のより完全な写真を獲得できることを楽しみにしています」とOpenaiはブログ投稿に書いています。
GPT-4.5のAction.Image Credits:Openai スケーリング法は異議を申し立てました
Openaiは、GPT -4.5は「監視されていない学習で可能なことのフロンティアにある」と主張しています。しかし、その制限は、いわゆるトレーニングのスケーリング法が彼らの限界に達している可能性があるという専門家の間での疑いの高まりを支持しているようです。
Openaiの共同設立者で元チーフサイエンティストのIlya Sutskeverは、12月に「私たちはピークデータを達成した」と「疑いなく終わらせることがわかっているようにトレーニング前」と述べました。彼のコメントは、11月にTechCrunchのAI投資家、創業者、研究者が共有する懸念を反映しています。
これらの課題に対応して、Openaiを含む業界は、タスクを実行するのに時間がかかるが、より一貫した結果を提供するという推論モデルに目を向けています。推論モデルをより多くの時間と計算に問題を介して「考える」ことを許可することにより、AI Labsはモデル機能を大幅に強化できると考えています。
Openaiは、最終的にGPTシリーズを「O」推論シリーズと統合する予定で、今年後半にGPT-5から始まります。トレーニングコストが高く、遅延、内部の期待に満ちていないにもかかわらず、GPT-4.5はAIベンチマーククラウンを単独で請求しない場合があります。しかし、Openaiは、それをはるかに強力なものへの重要なステップと見なしている可能性があります。








 OpenAIは、10代の若者がChatGPTを使い始めてから数年を経て、より安全なChatGPTをリリースした
AIチャットボットに安全対策が欠如していたことによる一連の訴訟――これが10代の自殺やその他のメンタルヘルスの危機の一因となった――を受け、OpenAIは月曜日に「ChatGPT for Teens」を発表した。この新サービスには強化された安全機能が組み込まれており、学校現場でAIツールによって助長されている学業上の不正行為という深刻化する問題に対処している。教育的な観点から、「ChatGPT f
 フロンティアAIラボ、異常挙動を示すモデルの封じ込め戦略の開示を拒否
最近の調査によると、主要なAI研究所のうち、封じ込め対応計画を公表または実証しているところはごくわずかであることが示されている。封じ込め計画とは、AIシステムが人間の制御を覆そうとした場合の対応手順を定義するもので、どのアクセス権限を取り消すか、またいつシステムを完全にシャットダウンするかを具体的に規定している。この調査結果は、安全な最先端AI開発の実践を推進することに注力する組織「Guideli
 NEAのティファニー・ラック:企業はまだAIのROIに苦戦している
プレイヤーを読み込み中…今年初頭、シリコンバレーでは「トークン最大化」が話題を独占し、CEOたちは社員にAIの使用を最大化するよう促した。しかし、その熱狂はすぐに現実とぶつかった。ウーバーは報告によると、数ヶ月で年間AI予算を超過し、一部の企業は部門全体でClaudeのライセンスを削減し、メタは社内パフォーマンスランキングを廃止した。NEAパートナーのティファニー・ラックは、この興奮と実際のリターンのギャップを日々乗り越えている。以前はECが未来であると企業を説得した経験を持つ彼女は、現在、

2026年最新!ReelsやShorts、製品ローンチキャンペーンに最適なAIショート動画フック生成ツール!XIX.AIは、実地テストを通じて「必ず試すべき」結果をもたらす、高評価で画期的なツールを厳選しています。毎週更新されるこのページでは、無料版と有料版の比較ランキングを掲載しており、コンテンツの創造性と生産性を高める最適なソリューションを見つけるお手伝いをします。 今すぐチェックして、AIの力を最大限に活用しましょう!
11 ツール
xix.ai

2026年最新・最高評価のAIアウトラインツール:長文執筆に最適!この厳選コレクションには、執筆効率を大幅に向上させる、実証済みのテストを経て正確かつ構造化されたアウトラインを生成する、強力で画期的なツールが紹介されています。XIX.AIもこの厳選されたツールの一つです。 無料版と有料版の比較表を入手して、最適なツールの選択に役立ててください。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai

2026年最新版・最高評価のAIロールプレイチャットアプリ|語学練習、面接対策、日常会話の流暢さ向上に!XIX.AIは、無料と有料の比較、実世界でのテスト、毎週更新されるランキングを提供する革新的なコレクションを厳選しています。これらの必須ツールは、ライティングスキルの向上、流暢さの課題克服、そしてあらゆる日常シナリオにおけるコミュニケーション効率の改善をサポートします。今すぐ探索して、あなたの言語成長に最適なツールを見つけましょう!
10 ツール
xix.ai

2026年最新・最高評価のAIステム分離ツール。リミックス制作、サンプリング準備、カラオケマスター向けに厳選されました。これらの強力で画期的なツールは、実環境でのテストを経て、正確なオーディオ分離を実現し、生産性を大幅に向上させます。 XIX.AIでは、ニーズに合った「必試」のソリューションを見つけるお手伝いをするため、無料版と有料版の比較ガイドを毎週更新して提供しています。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai

2026年最新かつ最も優れたAI SQLコピロットが最高評価でランクイン!XIX.AIは、毎週更新される実際の環境でのテストに対応した、強力で革新的なツール群を厳選しています。これらの必見ツールを使えば、正確な収益ダッシュボードの作成や販売プロセスの分析、製品指標の迅速な追跡が可能となり、生産性を大幅に向上させることができます。今すぐチェックして、データに基づいた意思決定に最適なツールを見つけましょう!238文字
9 ツール
xix.ai

2026年最新版 高評価のAIメロディ作成ツールで曲のドラフト作成!XIX.AIは、厳格な実世界テストを経て最高の作成体験を提供する、革新的な強力なコレクションを厳選しました。詳細な無料版と有料版の比較、正確なランキング、そして素晴らしい曲のドラフトを楽に作成し、創造的な生産性を大幅に向上させるためにぜひ試すべきオプションが見つかります。今すぐ探索して、あなたに最適なツールを見つけましょう!
8 ツール
xix.ai

Warum ändern die heimlich die Beschreibung? 🤔 Das klingt nach Marketing-Spielchen. GPT-4.5 ist bestimmt stark, aber solche Änderungen machen mich misstrauisch. Wird da etwa die Leistung übertrieben dargestellt?
Wow, GPT-4.5 Orion sounds massive! But that sneaky white paper edit? Shady move, OpenAI. Makes me wonder what else they’re tweaking behind the scenes. 🤔
Wow, GPT-4.5 Orion sounds like a beast! But that sneaky edit to the white paper? Shady move, OpenAI. Makes me wonder what else they're hiding. Still, I'm hyped to see what this model can do! 😎
Wow, GPT-4.5 Orion sounds like a beast! But that sneaky white paper edit raises some eyebrows—why hide that it’s not a frontier model? 🤔 Makes me wonder what OpenAI’s cooking behind the scenes!
Wow, GPT-4.5 Orion sounds massive! But that sneaky white paper edit? Shady move, OpenAI. Makes me wonder what else they’re hiding. 🤔 Still, can’t wait to see what this beast can do!
Wow, GPT-4.5 Orion sounds like a beast! But that sneaky white paper edit raises some eyebrows 🤔. Why hide that it’s not a frontier model? Smells like they’re dodging some big questions about what this thing can really do.












