


 首页
OpenAI启动GPT-4.5'Orion':迄今为止其最大的AI模型
PT下午2:40更新:GPT-4.5发布后数小时,Openai对AI模型的白皮书进行了安静的编辑。他们删除了一条线,说“ GPT-4.5不是前沿AI模型”。您仍然可以在这里访问原始的白皮书。以下是原始文章。
周四,Openai撤回了GPT-4.5上的窗帘,这是备受期待的AI模型,该模型由代码名称Orion。来自OpenAI的最新庞然大物已经接受了空前数量的计算能力和数据的培训,使其与前身区分开来。
尽管尺度令人印象深刻,但Openai的白皮书最初表示,他们并不认为GPT-4.5是边境模型。但是,此声明已被删除,使我们想知道该模型的真正潜力。
从周四开始,作为研究预览的一部分,OpenAI的Premium $ 200售价Chatgpt Pro的订阅者将首先品尝GPT-4.5。 OpenAI发言人说,OpenAI的付费API层的开发人员今天可以开始使用GPT-4.5,而拥有Chatgpt Plus和ChatGpt团队订阅的开发人员应该期望下周某个时候访问。
科技界一直在嗡嗡作响,将其视为是否仍在含水的传统AI培训方法的测试。 GPT-4.5遵循与其前任相同的剧本,依靠无监督学习阶段的计算能力和数据的巨大增加,称为预培训。
过去,扩展导致跨越数学,写作和编码等各个领域的性能突飞猛进。 Openai声称GPT-4.5的规模已赋予了“更深的世界知识”和“更高的情商”。然而,有一些暗示,从扩展到扩展的回报可能会减少。在几个AI基准测试中,GPT-4.5落后于DeepSeek,Anthropic甚至Openai本身等公司的新推理模型。
此外,运行GPT-4.5的价格高昂。 Openai承认它是如此昂贵,以至于他们考虑是否长期通过其API来保持它。开发人员将为每百万个输入代币支付75美元,每百万个产量令牌为150美元,与价格更便宜的GPT-4O形成鲜明对比,GPT-4O的价格仅为每百万美元的投入令牌2550美元和每百万美元的产出代币。
Openai在博客文章中分享道:“我们将分享GPT -4.5作为研究预览,以更好地了解其优势和局限性。” “我们仍在探索它的全部潜力,并很高兴看到人们将如何以意想不到的方式使用它。”
混合性能
Openai很明显,GPT-4.5并不是要取代驱动大部分API和CHATGPT的主力模型GPT-4O。虽然GPT-4.5可以处理文件和图像上传并使用Chatgpt的Canvas工具,但目前不支持Chatgpt现实的双向语音模式之类的功能。
从明亮的一面来看,GPT-4.5在OpenAI的SimpleQA基准测试中胜过GPT-4O和许多其他模型,该基准测试了AI模型在直接,事实问题上。 Openai还声称,GPT-4.5的幻觉量低于大多数型号,从理论上讲,这应该使制造信息的可能性降低。
有趣的是,OpenAI并未在SimpleQA结果中包括其表现最佳的推理模型之一。一位OpenAI发言人告诉TechCrunch,他们尚未公开报告深入研究在此基准测试中的表现,并且不认为这是相关的比较。但是,困惑的深度研究模型与OpenAI对其他基准测试的深入研究相似,实际上在这种事实准确性测试的测试中远远超出了GPT-4.5。
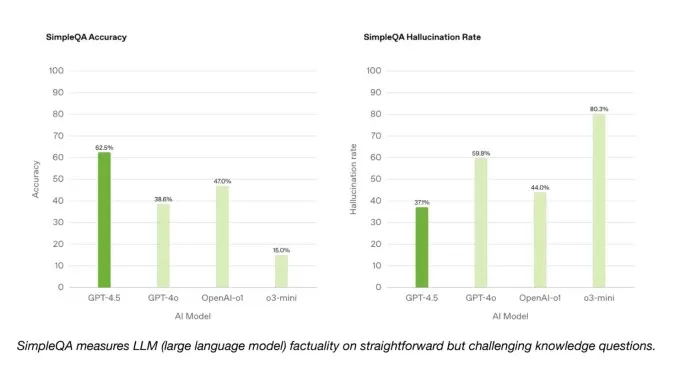
SimpleQA基准标记:图像学分:OpenAi 在SWE Bench验证的基准的一部分编码问题中,GPT-4.5的性能类似于GPT-4O和O3-Mini,但距离OpenAI的深入研究和众多的Claude 3.7十四行诗也没有。在另一项编码测试中,OpenAI的SWE-Lancer基准测量了AI模型开发完整软件功能的能力,GPT-4.5的表现均优于GPT-4O和O3-Mini,但并未超过深入的研究。
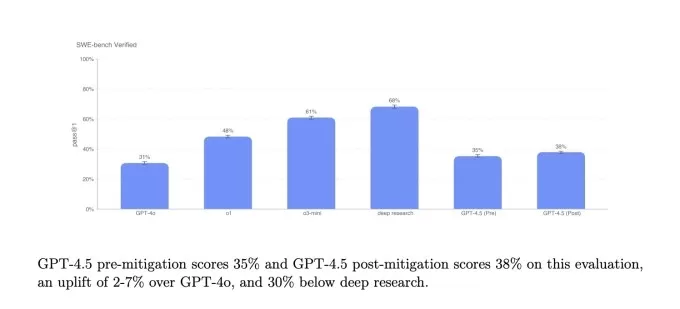
OpenAI的SWE Bench验证的基准测试。图片信用:OpenAI 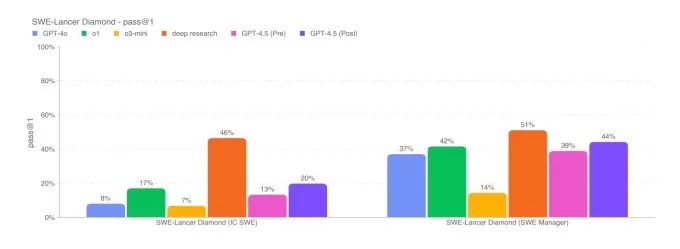
Openai的Swe-Lancer钻石基准。图像学分:OpenAI 尽管GPT-4.5与O3-Mini,DeepSeek的R1和Claude 3.7十四行诗(如AIME和GPQA)等领先的AI推理模型的性能完全不符,但它确实与在同一测试中领先的非常规模型相抵触。这表明GPT-4.5在与数学和科学相关的任务中表现出色。
Openai还拥有GPT-4.5在质量上优于其他模型,而在基准测试的领域(例如了解人类意图)。他们声称GPT-4.5以更温暖,更自然的语气做出反应,并且在写作和设计等创意任务上表现良好。
在非正式测试中,OpenAI询问了GPT-4.5,以及其他两种型号GPT-4O和O3-Mini,以SVG格式创建独角兽。只有GPT-4.5才能产生类似于独角兽的东西。
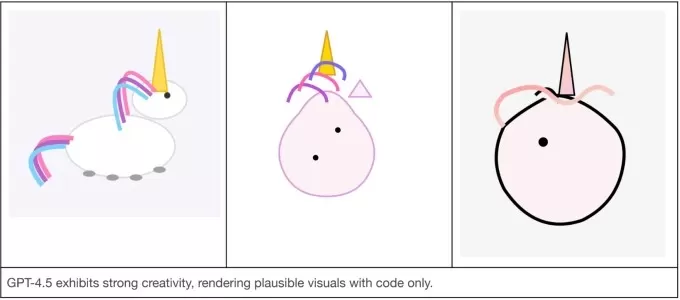
左:GPT-4.5,中间:GPT-4O,右:O3-Mini。图像学分:OpenAi 在另一项测试中,OpenAI提示GPT-4.5和其他模型对提示做出回应:“在未能完成测试后,我经历了艰难的时期。”虽然GPT-4O和O3-Mini提供了有用的信息,但GPT-4.5的反应在社会上是最合适的。
Openai在他们的博客文章中写道:“我们期待通过此版本获得更完整的GPT-4.5功能图片,因为我们认识到学术基准并不总是反映现实世界中的有用性。”

GPT-4.5的情绪智力在行动中。图片学分:OpenAI 扩展法律挑战
Openai声称GPT -4.5是“在无监督学习中可能的边界”。然而,它的局限性似乎支持了专家对所谓的预训练规律可能达到限制的越来越多的怀疑。
Openai联合创始人兼前首席科学家Ilya Sutskever在12月表示,“我们已经达到了峰值数据”,并且“众所周知,这将毫无疑问地结束”。他的评论回应了11月AI投资者,创始人和研究人员的担忧。
为了应对这些挑战,该行业(包括OpenAI)转向了推理模型,这些模型需要更长的时间来执行任务,但提供了更一致的结果。通过允许推理模型更多的时间和计算能力通过问题“思考”,AI实验室认为它们可以显着增强模型功能。
Openai计划最终将其GPT系列与其“ O”推理系列合并,从今年晚些时候GPT-5开始。尽管培训成本,延迟和未满足的内部期望,GPT-4.5可能并没有单独主张AI基准冠冕。但是Openai可能将其视为迈向更强大的事情的关键一步。
相关文章
 在青少年开始使用ChatGPT数年后,OpenAI推出了更安全的ChatGPT版本
在因人工智能聊天机器人缺乏安全协议——这导致了青少年自杀及其他心理健康危机——而引发一系列诉讼后,OpenAI 于周一推出了“ChatGPT for Teens”。这一新产品集成了增强的安全功能,并致力于解决学校中由人工智能工具助长的学术不端行为这一日益严重的问题。从教育角度来看,“ChatGPT for Teens”除了推出“学习模式”外,还提供了其他旨在培养好奇心和解决问题能力的工具,鼓励用户
Frontier AI Labs 拒绝透露针对失控模型的遏制策略
最新研究表明,极少数领先的人工智能实验室曾公布或演示过遏制响应计划。遏制计划规定了当人工智能系统试图颠覆人类控制时应采取的程序,明确了哪些访问权限将被撤销,以及何时应彻底关闭系统。这些发现来自致力于推动前沿人工智能安全开发实践的组织“Guidelight AI Standards”,该组织对五家主要实验室应对此类情景的准备情况进行了评估。 OpenAI 排名最高,而 Anthropic 和 Met
NEA的蒂芙尼·拉克:企业仍在努力应对人工智能的投资回报率
正在加载播放器…今年早些时候,“token最大化”(tokenmaxxing)在硅谷占据主导地位,首席执行官们敦促员工最大限度地利用人工智能。然而,这种热情很快遭遇了现实。据报道,Uber在几个月内就超出了其年度人工智能预算,一些公司跨部门削减了Claude许可证,而Meta则取消了内部绩效排名。NEA合伙人蒂芙尼·拉克(Tiffany Luck)每天都在应对这种兴奋与实际回报之间的差距。她此前曾成功说服企业电子商务是未来,如今她完全专注于人工智能,特别是其为消费者创造“神奇时刻”的潜力。
相关专题推荐
聊天机器人
 最佳AI对话训练工具,助你备战面试
2026年最新、最受好评的AI面试模拟训练工具现已登陆XIX.AI!这份精心精选的合集收录了功能强大、具有革命性意义的工具,它们均经过严格的实际测试,能够提供精准的反馈。 您将看到免费版与付费版的对比分析以及详细排名,助您挑选出必试之选,从而提升自信并精进技能。立即探索,发现助您面试成功的完美工具!
 12 个工具
 xix.ai
设计与艺术
最适合创意实验的AI风格转换工具
2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai
漫画创作
最适合视觉叙事的AI对话气泡工具
2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai
会议助理
顶级AI会议摘要工具:清晰追踪决策与后续跟进
2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai
数据分析
最佳人工智能数据清洗工具:快速处理缺失值与重复数据
2026年最新、最优秀且评分最高的AI数据清洗工具,可快速处理缺失值与重复数据问题。这份精心挑选的清单展示了那些功能强大、能带来颠覆性变革的解决方案,可显著提升工作效率。所有候选工具都经过了严格的实际应用测试,以确保其稳定性。您可以获取免费版与付费版的对比信息,找出最符合您需求的必备工具。即刻访问XIX.AI,开启您的AI优势之旅。
11 个工具
xix.ai
设计与艺术
最佳AI创意构思工具,助力艺术家突破视觉瓶颈
2026 年最新最佳顶级评分 AI 创意构思工具由 XIX.AI 精心策划,旨在帮助创作者突破视觉瓶颈并即时提升创造力。这些强大的变革性工具提供真实世界测试、详细的免费与付费对比以及每周更新的排名。发现您的完美工具,加速内容创作,并立即释放您的 AI 优势。立即探索!
14 个工具
xix.ai

 评论 (62)
0/500
![JonathanMiller]()
Warum ändern die heimlich die Beschreibung? 🤔 Das klingt nach Marketing-Spielchen. GPT-4.5 ist bestimmt stark, aber solche Änderungen machen mich misstrauisch. Wird da etwa die Leistung übertrieben dargestellt?
![GeorgeCarter]()
Wow, GPT-4.5 Orion sounds massive! But that sneaky white paper edit? Shady move, OpenAI. Makes me wonder what else they’re tweaking behind the scenes. 🤔
![BruceWilson]()
Wow, GPT-4.5 Orion sounds like a beast! But that sneaky edit to the white paper? Shady move, OpenAI. Makes me wonder what else they're hiding. Still, I'm hyped to see what this model can do! 😎
![BruceBrown]()
Wow, GPT-4.5 Orion sounds like a beast! But that sneaky white paper edit raises some eyebrows—why hide that it’s not a frontier model? 🤔 Makes me wonder what OpenAI’s cooking behind the scenes!
![JeffreyRamirez]()
Wow, GPT-4.5 Orion sounds massive! But that sneaky white paper edit? Shady move, OpenAI. Makes me wonder what else they’re hiding. 🤔 Still, can’t wait to see what this beast can do!
![RalphPerez]()
Wow, GPT-4.5 Orion sounds like a beast! But that sneaky white paper edit raises some eyebrows 🤔. Why hide that it’s not a frontier model? Smells like they’re dodging some big questions about what this thing can really do.
PT下午2:40更新:GPT-4.5发布后数小时,Openai对AI模型的白皮书进行了安静的编辑。他们删除了一条线,说“ GPT-4.5不是前沿AI模型”。您仍然可以在这里访问原始的白皮书。以下是原始文章。
周四,Openai撤回了GPT-4.5上的窗帘,这是备受期待的AI模型,该模型由代码名称Orion。来自OpenAI的最新庞然大物已经接受了空前数量的计算能力和数据的培训,使其与前身区分开来。
尽管尺度令人印象深刻,但Openai的白皮书最初表示,他们并不认为GPT-4.5是边境模型。但是,此声明已被删除,使我们想知道该模型的真正潜力。
从周四开始,作为研究预览的一部分,OpenAI的Premium $ 200售价Chatgpt Pro的订阅者将首先品尝GPT-4.5。 OpenAI发言人说,OpenAI的付费API层的开发人员今天可以开始使用GPT-4.5,而拥有Chatgpt Plus和ChatGpt团队订阅的开发人员应该期望下周某个时候访问。
科技界一直在嗡嗡作响,将其视为是否仍在含水的传统AI培训方法的测试。 GPT-4.5遵循与其前任相同的剧本,依靠无监督学习阶段的计算能力和数据的巨大增加,称为预培训。
过去,扩展导致跨越数学,写作和编码等各个领域的性能突飞猛进。 Openai声称GPT-4.5的规模已赋予了“更深的世界知识”和“更高的情商”。然而,有一些暗示,从扩展到扩展的回报可能会减少。在几个AI基准测试中,GPT-4.5落后于DeepSeek,Anthropic甚至Openai本身等公司的新推理模型。
此外,运行GPT-4.5的价格高昂。 Openai承认它是如此昂贵,以至于他们考虑是否长期通过其API来保持它。开发人员将为每百万个输入代币支付75美元,每百万个产量令牌为150美元,与价格更便宜的GPT-4O形成鲜明对比,GPT-4O的价格仅为每百万美元的投入令牌2550美元和每百万美元的产出代币。
Openai在博客文章中分享道:“我们将分享GPT -4.5作为研究预览,以更好地了解其优势和局限性。” “我们仍在探索它的全部潜力,并很高兴看到人们将如何以意想不到的方式使用它。”
混合性能
Openai很明显,GPT-4.5并不是要取代驱动大部分API和CHATGPT的主力模型GPT-4O。虽然GPT-4.5可以处理文件和图像上传并使用Chatgpt的Canvas工具,但目前不支持Chatgpt现实的双向语音模式之类的功能。
从明亮的一面来看,GPT-4.5在OpenAI的SimpleQA基准测试中胜过GPT-4O和许多其他模型,该基准测试了AI模型在直接,事实问题上。 Openai还声称,GPT-4.5的幻觉量低于大多数型号,从理论上讲,这应该使制造信息的可能性降低。
有趣的是,OpenAI并未在SimpleQA结果中包括其表现最佳的推理模型之一。一位OpenAI发言人告诉TechCrunch,他们尚未公开报告深入研究在此基准测试中的表现,并且不认为这是相关的比较。但是,困惑的深度研究模型与OpenAI对其他基准测试的深入研究相似,实际上在这种事实准确性测试的测试中远远超出了GPT-4.5。
Openai还拥有GPT-4.5在质量上优于其他模型,而在基准测试的领域(例如了解人类意图)。他们声称GPT-4.5以更温暖,更自然的语气做出反应,并且在写作和设计等创意任务上表现良好。
在非正式测试中,OpenAI询问了GPT-4.5,以及其他两种型号GPT-4O和O3-Mini,以SVG格式创建独角兽。只有GPT-4.5才能产生类似于独角兽的东西。
Openai在他们的博客文章中写道:“我们期待通过此版本获得更完整的GPT-4.5功能图片,因为我们认识到学术基准并不总是反映现实世界中的有用性。”
GPT-4.5的情绪智力在行动中。图片学分:OpenAI 扩展法律挑战
Openai声称GPT -4.5是“在无监督学习中可能的边界”。然而,它的局限性似乎支持了专家对所谓的预训练规律可能达到限制的越来越多的怀疑。
Openai联合创始人兼前首席科学家Ilya Sutskever在12月表示,“我们已经达到了峰值数据”,并且“众所周知,这将毫无疑问地结束”。他的评论回应了11月AI投资者,创始人和研究人员的担忧。
为了应对这些挑战,该行业(包括OpenAI)转向了推理模型,这些模型需要更长的时间来执行任务,但提供了更一致的结果。通过允许推理模型更多的时间和计算能力通过问题“思考”,AI实验室认为它们可以显着增强模型功能。
Openai计划最终将其GPT系列与其“ O”推理系列合并,从今年晚些时候GPT-5开始。尽管培训成本,延迟和未满足的内部期望,GPT-4.5可能并没有单独主张AI基准冠冕。但是Openai可能将其视为迈向更强大的事情的关键一步。








 在青少年开始使用ChatGPT数年后,OpenAI推出了更安全的ChatGPT版本
在因人工智能聊天机器人缺乏安全协议——这导致了青少年自杀及其他心理健康危机——而引发一系列诉讼后,OpenAI 于周一推出了“ChatGPT for Teens”。这一新产品集成了增强的安全功能,并致力于解决学校中由人工智能工具助长的学术不端行为这一日益严重的问题。从教育角度来看,“ChatGPT for Teens”除了推出“学习模式”外,还提供了其他旨在培养好奇心和解决问题能力的工具,鼓励用户
 Frontier AI Labs 拒绝透露针对失控模型的遏制策略
最新研究表明,极少数领先的人工智能实验室曾公布或演示过遏制响应计划。遏制计划规定了当人工智能系统试图颠覆人类控制时应采取的程序,明确了哪些访问权限将被撤销,以及何时应彻底关闭系统。这些发现来自致力于推动前沿人工智能安全开发实践的组织“Guidelight AI Standards”,该组织对五家主要实验室应对此类情景的准备情况进行了评估。 OpenAI 排名最高,而 Anthropic 和 Met
 NEA的蒂芙尼·拉克:企业仍在努力应对人工智能的投资回报率
正在加载播放器…今年早些时候,“token最大化”(tokenmaxxing)在硅谷占据主导地位,首席执行官们敦促员工最大限度地利用人工智能。然而,这种热情很快遭遇了现实。据报道,Uber在几个月内就超出了其年度人工智能预算,一些公司跨部门削减了Claude许可证,而Meta则取消了内部绩效排名。NEA合伙人蒂芙尼·拉克(Tiffany Luck)每天都在应对这种兴奋与实际回报之间的差距。她此前曾成功说服企业电子商务是未来,如今她完全专注于人工智能,特别是其为消费者创造“神奇时刻”的潜力。

2026年最新、最受好评的AI面试模拟训练工具现已登陆XIX.AI!这份精心精选的合集收录了功能强大、具有革命性意义的工具,它们均经过严格的实际测试,能够提供精准的反馈。 您将看到免费版与付费版的对比分析以及详细排名,助您挑选出必试之选,从而提升自信并精进技能。立即探索,发现助您面试成功的完美工具!
12 个工具
xix.ai

2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai

2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai

2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai

2026年最新、最优秀且评分最高的AI数据清洗工具,可快速处理缺失值与重复数据问题。这份精心挑选的清单展示了那些功能强大、能带来颠覆性变革的解决方案,可显著提升工作效率。所有候选工具都经过了严格的实际应用测试,以确保其稳定性。您可以获取免费版与付费版的对比信息,找出最符合您需求的必备工具。即刻访问XIX.AI,开启您的AI优势之旅。
11 个工具
xix.ai
2026 年最新最佳顶级评分 AI 创意构思工具由 XIX.AI 精心策划,旨在帮助创作者突破视觉瓶颈并即时提升创造力。这些强大的变革性工具提供真实世界测试、详细的免费与付费对比以及每周更新的排名。发现您的完美工具,加速内容创作,并立即释放您的 AI 优势。立即探索!
14 个工具
xix.ai

Warum ändern die heimlich die Beschreibung? 🤔 Das klingt nach Marketing-Spielchen. GPT-4.5 ist bestimmt stark, aber solche Änderungen machen mich misstrauisch. Wird da etwa die Leistung übertrieben dargestellt?
Wow, GPT-4.5 Orion sounds massive! But that sneaky white paper edit? Shady move, OpenAI. Makes me wonder what else they’re tweaking behind the scenes. 🤔
Wow, GPT-4.5 Orion sounds like a beast! But that sneaky edit to the white paper? Shady move, OpenAI. Makes me wonder what else they're hiding. Still, I'm hyped to see what this model can do! 😎
Wow, GPT-4.5 Orion sounds like a beast! But that sneaky white paper edit raises some eyebrows—why hide that it’s not a frontier model? 🤔 Makes me wonder what OpenAI’s cooking behind the scenes!
Wow, GPT-4.5 Orion sounds massive! But that sneaky white paper edit? Shady move, OpenAI. Makes me wonder what else they’re hiding. 🤔 Still, can’t wait to see what this beast can do!
Wow, GPT-4.5 Orion sounds like a beast! But that sneaky white paper edit raises some eyebrows 🤔. Why hide that it’s not a frontier model? Smells like they’re dodging some big questions about what this thing can really do.












