


 Lar
Otimizando a Seleção de Modelos de IA para Desempenho no Mundo Real
As empresas devem garantir que seus modelos de IA que impulsionam aplicações performem efetivamente em cenários do mundo real. Prever esses cenários pode ser desafiador, complicando as avaliações. O benchmark RewardBench 2 atualizado oferece às organizações insights mais claros sobre o desempenho prático de um modelo.
O Allen Institute for AI (Ai2) introduziu o RewardBench 2, uma versão aprimorada do seu benchmark RewardBench, projetada para fornecer uma avaliação abrangente do desempenho do modelo e alinhamento com objetivos empresariais.
O Ai2 desenvolveu o RewardBench com tarefas de classificação que avaliam correlações por meio de computação em tempo de inferência e treinamento downstream. O RewardBench foca em modelos de recompensa (RMs), que julgam saídas de modelos de linguagem amplos atribuindo pontuações ou “recompensas” para guiar o aprendizado por reforço com feedback humano (RHLF).
RewardBench 2 está aqui! Levamos um tempo para aprender com nossa primeira ferramenta de avaliação de modelo de recompensa para criar uma que é substancialmente mais difícil e mais correlacionada com RLHF downstream e escalonamento em tempo de inferência. pic.twitter.com/NGetvNrOQV
— Ai2 (@allen_ai) 2 de junho de 2025
Nathan Lambert, cientista de pesquisa sênior no Ai2, disse ao VentureBeat que o RewardBench original funcionou bem inicialmente, mas ambientes de modelos em evolução exigiram benchmarks atualizados.
“À medida que os modelos de recompensa se tornaram mais sofisticados e os casos de uso mais complexos, vimos, junto com a comunidade, que a primeira versão não abordava completamente as complexidades das preferências humanas no mundo real,” ele explicou.
Lambert observou que o RewardBench 2 melhora o escopo e a profundidade da avaliação, incorporando prompts diversos e desafiadores e métodos refinados para refletir melhor o julgamento humano sobre saídas de IA. Ele apresenta novos prompts humanos, um sistema de pontuação mais rigoroso e domínios adicionais.
Aproveitando Avaliações para Avaliação de Modelos
Modelos de recompensa avaliam o desempenho do modelo, mas o alinhamento com os valores da empresa é crítico. RMs desalinhados podem amplificar problemas como alucinações, reduzir a generalização ou favorecer respostas prejudiciais durante o ajuste fino e o aprendizado por reforço.
O RewardBench 2 abrange seis domínios: factualidade, aderência precisa às instruções, matemática, segurança, foco e empates.
“As empresas podem usar o RewardBench 2 de duas maneiras com base em suas necessidades. Para RLHF, devem integrar as melhores práticas e conjuntos de dados de modelos de ponta em seus pipelines, pois os modelos de recompensa requerem treinamento on-policy. Para escalonamento em tempo de inferência ou filtragem de dados, o RewardBench 2 ajuda a selecionar o melhor modelo para seu domínio com desempenho correlacionado,” disse Lambert.
Lambert enfatizou que benchmarks como o RewardBench permitem que os usuários avaliem modelos com base nas prioridades mais relevantes para eles, em vez de uma pontuação genérica. Ele observou que o desempenho é subjetivo, fortemente ligado ao contexto e objetivos do usuário, com preferências humanas frequentemente muito nuançadas.
O Ai2 lançou o RewardBench original em março de 2024, chamando-o de o primeiro benchmark e leaderboard de modelo de recompensa. Desde então, novos métodos como o FAIR reWordBench da Meta e o Self-Principled Critique Tuning da DeepSeek surgiram para RMs mais inteligentes e escaláveis.
Muito animado que nossa segunda avaliação de modelo de recompensa está disponível. É substancialmente mais difícil, muito mais limpa e bem correlacionada com amostragem PPO/BoN downstream.
Feliz escalada!
Parabéns enormes a @saumyamalik44 que liderou o projeto com total compromisso com a excelência. https://t.co/c0b6rHTXY5
— Nathan Lambert (@natolambert) 2 de junho de 2025
Insights sobre o Desempenho dos Modelos
Com o RewardBench 2, o Ai2 testou modelos existentes e recém-treinados, incluindo variantes de Gemini, Claude, GPT-4.1 e Llama-3.1, ao lado de conjuntos de dados e modelos como Qwen, Skywork e Tulu.
As descobertas mostraram que modelos de recompensa maiores se destacam devido a modelos de base mais fortes. Variantes do Llama-3.1 Instruct lideraram o benchmark, com dados do Skywork ajudando no foco e segurança, e o Tulu performando bem em factualidade.
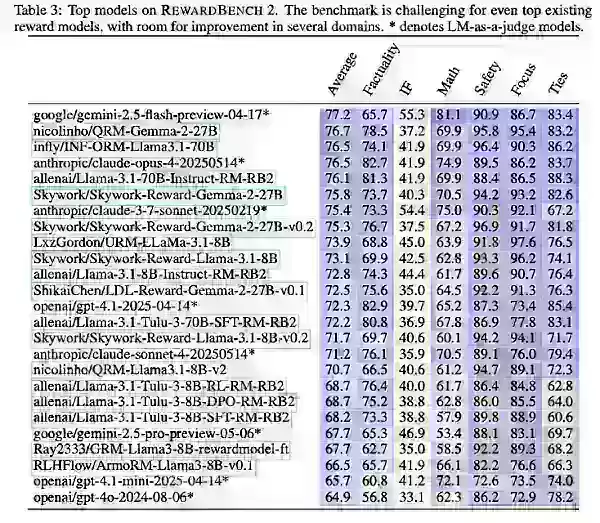
O Ai2 observou que, embora o RewardBench 2 avance na avaliação multidomínio focada em precisão para modelos de recompensa, ele deve principalmente orientar as empresas na seleção de modelos mais adequados às suas necessidades específicas.
Artigo relacionado
 Óculos Inteligentes da Apple Podem Estrear na WWDC27, Destacando a Proteção de Privacidade
O repórter da Bloomberg, Mark Gurman, informa que os óculos inteligentes da Apple, com o codinome N50, estão previstos para estrear na WWDC27 em junho de 2027, com um lançamento no varejo esperado para o outono de 2027. Originalmente direcionados par
Dentro dos Detalhes Revelados Sobre o Gemini de Próxima Geração: Poder de Cálculo Sobrecarregado, Equipes Internas Discordaram Sobre Prioridades de Desenvolvimento e Alocação de Recursos
Os relatórios indicam que o lançamento do tão aguardado modelo Gemini de próxima geração do Google foi adiado. Desentendimentos internos sobre prioridades de desenvolvimento e alocação de recursos, combinados com capacidade computacional limitada e p
A OpenAI descarta preocupações com a desaceleração do crescimento e afirma que múltiplas unidades de negócio estão acelerando.
Em resposta à escrutínio externo sobre o desaceleramento do crescimento das vendas e o não cumprimento de metas internas, o líder em inteligência artificial, OpenAI, emitiu uma declaração confiante na terça-feira, 28 de abril. A empresa esclareceu qu
Recomendações de tópicos especiais relacionados
Análise de dados
 Copilotos de IA para SQL voltados para painéis de receita, análise de funis e métricas de produtos
2026: Os melhores copilotos AI para SQL, atualizados e classificados entre os melhores! A XIX.AI reúne uma coleção poderosa e revolucionária, com testes em ambiente real atualizados semanalmente. Essas ferramentas indispensáveis ajudam a gerar painéis de controle de receita precisos, analisar funis de vendas e rastrear métricas de produtos de forma rápida, aumentando significativamente a produtividade. Explore agora e encontre a ferramenta perfeita para tomada de decisões baseadas em dados! 238 caracteres
 9 ferramentas
 xix.ai
Composição musical
Melhores Ferramentas de IA para Criação de Melodias para Rascunhos de Músicas
2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai
chatbot
Melhores ferramentas de treinamento de conversação com IA para prática de entrevistas
As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai
Design e Arte
As melhores ferramentas de transferência de estilo com IA para experimentos criativos
As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai
Criação de quadrinhos
As melhores ferramentas de balões de diálogo com IA para a narrativa visual
As melhores e mais bem avaliadas ferramentas de balões de diálogo com IA para narrativa visual de 2026 já estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que ajudam os criadores a aumentar a produtividade e superar gargalos criativos. Veja uma comparação entre versões gratuitas e pagas, confira testes reais e verifique os rankings mais recentes para encontrar as soluções imperdíveis, perfeitas para criar narrativas visuais envolventes. Explore agora e descubra sua ferramenta ideal!
10 ferramentas
xix.ai
Assistente de Reunião
As melhores ferramentas de resumo de reuniões com IA: acompanhe decisões e ações de acompanhamento com clareza
As melhores e mais bem avaliadas ferramentas de resumo de reuniões com IA de 2026 para um acompanhamento claro das decisões e acompanhamentos sem esforço. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam drasticamente a produtividade ao automatizar notas de reuniões, identificar ações-chave e otimizar a coordenação da equipe em todos os projetos. Veja uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente para ajudá-lo a encontrar a ferramenta perfeita. Explore agora para aproveitar ao máximo as vantagens da IA!
9 ferramentas
xix.ai

 Comentários (3)
![JeffreyThomas]()
Como usuario que solo tiene conocimientos básicos, elegir el modelo adecuado es un dolor de cabeza. Este artículo menciona problemas prácticos que son ciertos; a veces, el modelo parece brillar en la prueba, pero en la práctica simplemente falla. Me pregunto si el RewardBench actualizado ayuda a predecir cuándo un modelo se 'descompone' de manera realista. Si las empresas confían demasiado en las métricas, podrían terminar con un fiasco en producción 😅. ¿Habrá herramientas más accesibles para los equipos pequeños?
![DonaldGonzález]()
この記事、実運用でのAIモデルの難しさをしっかり分析してますね。特にリアルワールドでの性能評価の課題は興味深い。AI導入が進む中で、本当に役立つモデル選びができる企業が勝ち残るのかも。ユーザー体験を考えると、ベンチマークだけで選ぶのは危険かもしれない... 😅
![CarlMartin]()
C'est intéressant, mais j'aimerais voir plus d'exemples concrets sur comment évaluer la performance des modèles en situation réelle. Parfois les benchmarks ne reflètent pas la complexité du terrain 😅
As empresas devem garantir que seus modelos de IA que impulsionam aplicações performem efetivamente em cenários do mundo real. Prever esses cenários pode ser desafiador, complicando as avaliações. O benchmark RewardBench 2 atualizado oferece às organizações insights mais claros sobre o desempenho prático de um modelo.
O Allen Institute for AI (Ai2) introduziu o RewardBench 2, uma versão aprimorada do seu benchmark RewardBench, projetada para fornecer uma avaliação abrangente do desempenho do modelo e alinhamento com objetivos empresariais.
O Ai2 desenvolveu o RewardBench com tarefas de classificação que avaliam correlações por meio de computação em tempo de inferência e treinamento downstream. O RewardBench foca em modelos de recompensa (RMs), que julgam saídas de modelos de linguagem amplos atribuindo pontuações ou “recompensas” para guiar o aprendizado por reforço com feedback humano (RHLF).
RewardBench 2 está aqui! Levamos um tempo para aprender com nossa primeira ferramenta de avaliação de modelo de recompensa para criar uma que é substancialmente mais difícil e mais correlacionada com RLHF downstream e escalonamento em tempo de inferência. pic.twitter.com/NGetvNrOQV
— Ai2 (@allen_ai) 2 de junho de 2025
Nathan Lambert, cientista de pesquisa sênior no Ai2, disse ao VentureBeat que o RewardBench original funcionou bem inicialmente, mas ambientes de modelos em evolução exigiram benchmarks atualizados.
“À medida que os modelos de recompensa se tornaram mais sofisticados e os casos de uso mais complexos, vimos, junto com a comunidade, que a primeira versão não abordava completamente as complexidades das preferências humanas no mundo real,” ele explicou.
Lambert observou que o RewardBench 2 melhora o escopo e a profundidade da avaliação, incorporando prompts diversos e desafiadores e métodos refinados para refletir melhor o julgamento humano sobre saídas de IA. Ele apresenta novos prompts humanos, um sistema de pontuação mais rigoroso e domínios adicionais.
Aproveitando Avaliações para Avaliação de Modelos
Modelos de recompensa avaliam o desempenho do modelo, mas o alinhamento com os valores da empresa é crítico. RMs desalinhados podem amplificar problemas como alucinações, reduzir a generalização ou favorecer respostas prejudiciais durante o ajuste fino e o aprendizado por reforço.
O RewardBench 2 abrange seis domínios: factualidade, aderência precisa às instruções, matemática, segurança, foco e empates.
“As empresas podem usar o RewardBench 2 de duas maneiras com base em suas necessidades. Para RLHF, devem integrar as melhores práticas e conjuntos de dados de modelos de ponta em seus pipelines, pois os modelos de recompensa requerem treinamento on-policy. Para escalonamento em tempo de inferência ou filtragem de dados, o RewardBench 2 ajuda a selecionar o melhor modelo para seu domínio com desempenho correlacionado,” disse Lambert.
Lambert enfatizou que benchmarks como o RewardBench permitem que os usuários avaliem modelos com base nas prioridades mais relevantes para eles, em vez de uma pontuação genérica. Ele observou que o desempenho é subjetivo, fortemente ligado ao contexto e objetivos do usuário, com preferências humanas frequentemente muito nuançadas.
O Ai2 lançou o RewardBench original em março de 2024, chamando-o de o primeiro benchmark e leaderboard de modelo de recompensa. Desde então, novos métodos como o FAIR reWordBench da Meta e o Self-Principled Critique Tuning da DeepSeek surgiram para RMs mais inteligentes e escaláveis.
Muito animado que nossa segunda avaliação de modelo de recompensa está disponível. É substancialmente mais difícil, muito mais limpa e bem correlacionada com amostragem PPO/BoN downstream.
— Nathan Lambert (@natolambert) 2 de junho de 2025
Feliz escalada!
Parabéns enormes a @saumyamalik44 que liderou o projeto com total compromisso com a excelência. https://t.co/c0b6rHTXY5
Insights sobre o Desempenho dos Modelos
Com o RewardBench 2, o Ai2 testou modelos existentes e recém-treinados, incluindo variantes de Gemini, Claude, GPT-4.1 e Llama-3.1, ao lado de conjuntos de dados e modelos como Qwen, Skywork e Tulu.
As descobertas mostraram que modelos de recompensa maiores se destacam devido a modelos de base mais fortes. Variantes do Llama-3.1 Instruct lideraram o benchmark, com dados do Skywork ajudando no foco e segurança, e o Tulu performando bem em factualidade.
O Ai2 observou que, embora o RewardBench 2 avance na avaliação multidomínio focada em precisão para modelos de recompensa, ele deve principalmente orientar as empresas na seleção de modelos mais adequados às suas necessidades específicas.








 Óculos Inteligentes da Apple Podem Estrear na WWDC27, Destacando a Proteção de Privacidade
O repórter da Bloomberg, Mark Gurman, informa que os óculos inteligentes da Apple, com o codinome N50, estão previstos para estrear na WWDC27 em junho de 2027, com um lançamento no varejo esperado para o outono de 2027. Originalmente direcionados par
 Dentro dos Detalhes Revelados Sobre o Gemini de Próxima Geração: Poder de Cálculo Sobrecarregado, Equipes Internas Discordaram Sobre Prioridades de Desenvolvimento e Alocação de Recursos
Os relatórios indicam que o lançamento do tão aguardado modelo Gemini de próxima geração do Google foi adiado. Desentendimentos internos sobre prioridades de desenvolvimento e alocação de recursos, combinados com capacidade computacional limitada e p
 A OpenAI descarta preocupações com a desaceleração do crescimento e afirma que múltiplas unidades de negócio estão acelerando.
Em resposta à escrutínio externo sobre o desaceleramento do crescimento das vendas e o não cumprimento de metas internas, o líder em inteligência artificial, OpenAI, emitiu uma declaração confiante na terça-feira, 28 de abril. A empresa esclareceu qu

2026: Os melhores copilotos AI para SQL, atualizados e classificados entre os melhores! A XIX.AI reúne uma coleção poderosa e revolucionária, com testes em ambiente real atualizados semanalmente. Essas ferramentas indispensáveis ajudam a gerar painéis de controle de receita precisos, analisar funis de vendas e rastrear métricas de produtos de forma rápida, aumentando significativamente a produtividade. Explore agora e encontre a ferramenta perfeita para tomada de decisões baseadas em dados! 238 caracteres
9 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai

As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de balões de diálogo com IA para narrativa visual de 2026 já estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que ajudam os criadores a aumentar a produtividade e superar gargalos criativos. Veja uma comparação entre versões gratuitas e pagas, confira testes reais e verifique os rankings mais recentes para encontrar as soluções imperdíveis, perfeitas para criar narrativas visuais envolventes. Explore agora e descubra sua ferramenta ideal!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de resumo de reuniões com IA de 2026 para um acompanhamento claro das decisões e acompanhamentos sem esforço. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam drasticamente a produtividade ao automatizar notas de reuniões, identificar ações-chave e otimizar a coordenação da equipe em todos os projetos. Veja uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente para ajudá-lo a encontrar a ferramenta perfeita. Explore agora para aproveitar ao máximo as vantagens da IA!
9 ferramentas
xix.ai

Como usuario que solo tiene conocimientos básicos, elegir el modelo adecuado es un dolor de cabeza. Este artículo menciona problemas prácticos que son ciertos; a veces, el modelo parece brillar en la prueba, pero en la práctica simplemente falla. Me pregunto si el RewardBench actualizado ayuda a predecir cuándo un modelo se 'descompone' de manera realista. Si las empresas confían demasiado en las métricas, podrían terminar con un fiasco en producción 😅. ¿Habrá herramientas más accesibles para los equipos pequeños?
この記事、実運用でのAIモデルの難しさをしっかり分析してますね。特にリアルワールドでの性能評価の課題は興味深い。AI導入が進む中で、本当に役立つモデル選びができる企業が勝ち残るのかも。ユーザー体験を考えると、ベンチマークだけで選ぶのは危険かもしれない... 😅
C'est intéressant, mais j'aimerais voir plus d'exemples concrets sur comment évaluer la performance des modèles en situation réelle. Parfois les benchmarks ne reflètent pas la complexité du terrain 😅












