


 Hogar
Optimización de la Selección de Modelos de IA para un Rendimiento en el Mundo Real
Las empresas deben asegurarse de que los modelos de IA que impulsan sus aplicaciones funcionen eficazmente en escenarios del mundo real. Predecir estos escenarios puede ser desafiante, lo que complica las evaluaciones. El benchmark actualizado RewardBench 2 ofrece a las organizaciones una visión más clara del rendimiento práctico de un modelo.
El Instituto Allen para la IA (Ai2) presentó RewardBench 2, una versión mejorada de su benchmark RewardBench, diseñada para proporcionar una evaluación completa del rendimiento del modelo y su alineación con los objetivos empresariales.
Ai2 desarrolló RewardBench con tareas de clasificación que evalúan correlaciones a través de cómputo en tiempo de inferencia y entrenamiento descendente. RewardBench se centra en modelos de recompensa (RMs), que evalúan las salidas de modelos de lenguaje grandes asignando puntuaciones o “recompensas” para guiar el aprendizaje por refuerzo con retroalimentación humana (RHLF).
¡RewardBench 2 está aquí! Nos tomamos mucho tiempo para aprender de nuestra primera herramienta de evaluación de modelos de recompensa para crear una que es sustancialmente más difícil y más correlacionada con el RLHF descendente y la escalabilidad en tiempo de inferencia. pic.twitter.com/NGetvNrOQV
— Ai2 (@allen_ai) 2 de junio de 2025
Nathan Lambert, científico investigador senior en Ai2, dijo a VentureBeat que el RewardBench original funcionó bien inicialmente, pero los entornos de modelos en evolución exigían benchmarks actualizados.
“A medida que los modelos de recompensa se volvieron más sofisticados y los casos de uso más complejos, vimos, junto con la comunidad, que la primera versión no abordaba completamente las complejidades de las preferencias humanas en el mundo real,” explicó.
Lambert señaló que RewardBench 2 mejora el alcance y la profundidad de la evaluación, incorporando prompts diversos y desafiantes, y métodos refinados para reflejar mejor el juicio humano sobre las salidas de IA. Incluye nuevos prompts humanos, un sistema de puntuación más riguroso y dominios adicionales.
Aprovechando Evaluaciones para la Evaluación de Modelos
Los modelos de recompensa evalúan el rendimiento del modelo, pero la alineación con los valores de la empresa es crítica. Los RMs desalineados pueden amplificar problemas como alucinaciones, reducir la generalización o favorecer excesivamente respuestas perjudiciales durante el ajuste fino y el aprendizaje por refuerzo.
RewardBench 2 abarca seis dominios: factualidad, adherencia precisa a instrucciones, matemáticas, seguridad, enfoque y empates.
“Las empresas pueden usar RewardBench 2 de dos maneras según sus necesidades. Para RLHF, deben integrar las mejores prácticas y conjuntos de datos de los mejores modelos en sus flujos de trabajo, ya que los modelos de recompensa requieren entrenamiento en política. Para la escalabilidad en tiempo de inferencia o el filtrado de datos, RewardBench 2 ayuda a seleccionar el mejor modelo para su dominio con un rendimiento correlacionado,” dijo Lambert.
Lambert enfatizó que los benchmarks como RewardBench permiten a los usuarios evaluar modelos según las prioridades más relevantes para ellos, en lugar de una puntuación genérica. Señaló que el rendimiento es subjetivo, muy ligado al contexto y los objetivos del usuario, con preferencias humanas a menudo muy matizadas.
Ai2 lanzó el RewardBench original en marzo de 2024, llamándolo el primer benchmark y tabla de clasificación de modelos de recompensa. Desde entonces, han surgido nuevos métodos como FAIR reWordBench de Meta y Self-Principled Critique Tuning de DeepSeek para RMs más inteligentes y escalables.
¡Súper emocionado de que nuestra segunda evaluación de modelos de recompensa esté lista! Es sustancialmente más difícil, mucho más limpia y bien correlacionada con el muestreo PPO/BoN descendente.
¡Feliz escalada!
Enorme felicitación a @saumyamalik44, quien lideró el proyecto con un compromiso total con la excelencia. https://t.co/c0b6rHTXY5
— Nathan Lambert (@natolambert) 2 de junio de 2025
Perspectivas sobre el Rendimiento de los Modelos
Con RewardBench 2, Ai2 probó tanto modelos existentes como recién entrenados, incluyendo variantes de Gemini, Claude, GPT-4.1 y Llama-3.1, junto con conjuntos de datos y modelos como Qwen, Skywork y Tulu.
Los hallazgos mostraron que los modelos de recompensa más grandes destacan debido a modelos base más fuertes. Las variantes de Llama-3.1 Instruct lideraron el benchmark, con los datos de Skywork ayudando en enfoque y seguridad, y Tulu destacando en factualidad.
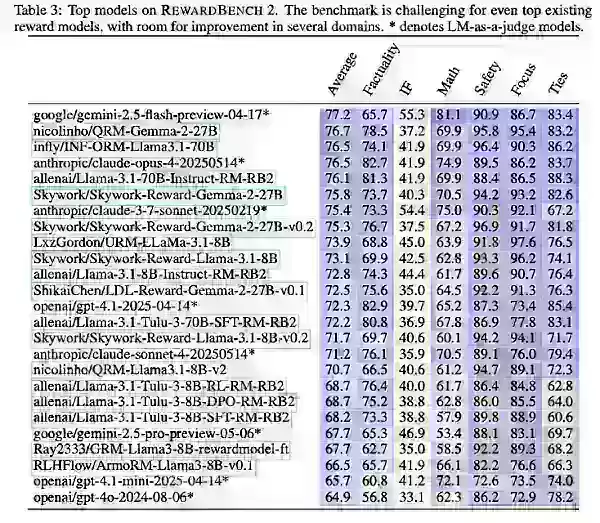
Ai2 señaló que, aunque RewardBench 2 avanza en la evaluación multidominio y centrada en la precisión para modelos de recompensa, debería guiar principalmente a las empresas en la selección de modelos más adecuados para sus necesidades específicas.
Artículo relacionado
 CEO de DeepMind, Hassabis: Duermo seis horas al día y generalmente me siento con energía alrededor de la 1 a. m.
Fortune ha presentado recientemente una entrevista con Demis Hassabis, director ejecutivo de Google DeepMind, en la que revela su enfoque poco convencional para el descanso y la productividad. Hassabis ha revelado que duerme muy poco, estructurando s
OpenAI y Anthropic compiten por la cuota de mercado a pesar de la caída de los ingresos
A pesar de los recientes informes que sugieren que OpenAI no ha alcanzado sus objetivos de ingresos —lo que ha generado presión sobre las acciones tecnológicas este martes—, los inversores privados en
Cumplimiento de la normativa sobre vehículos autónomos en California: una nueva era de multas, geovallas y 1 millón de millas
Guident opera un servicio de transporte de AuveTech en el sur de Florida, gestionando una ruta de cuatro millas en West Palm Beach y otra de una milla en Boca Ratón mediante su tecnología de monitoriz
Recomendaciones de temas especiales relacionados
chatbot
 Las mejores aplicaciones de chat de roleplay con IA para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria
¡Las mejores aplicaciones de chat de roleplay con IA de 2026, mejor valoradas, para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria! XIX.AI selecciona una poderosa colección revolucionaria que ofrece comparaciones entre versiones gratuitas y de pago, pruebas del mundo real y clasificaciones actualizadas semanalmente. Estas herramientas imprescindibles te ayudan a mejorar tus habilidades de escritura, superar los desafíos de fluidez y aumentar la eficiencia comunicativa en todas las situaciones cotidianas. ¡Explora ahora para descubrir tu herramienta perfecta para el crecimiento lingüístico!
 10 herramientas
 xix.ai
composicion musical
Herramientas de separación de pistas con IA para la producción de remezclas, la preparación de samples y las pistas maestras de karaoke
Las mejores herramientas de separación de pistas con IA de 2026, seleccionadas para la producción de remixes, la preparación de samples y la creación de temas de karaoke. Estas potentes herramientas revolucionarias se han sometido a pruebas en condiciones reales para ofrecer un aislamiento de audio preciso, lo que aumenta significativamente la productividad. XIX.AI ofrece una guía comparativa entre versiones gratuitas y de pago, actualizada semanalmente, para ayudarte a encontrar la solución imprescindible que mejor se adapte a tus necesidades. Explórala ahora para sacar el máximo partido a la IA.
8 herramientas
xix.ai
Análisis de datos
Copilotos de AI para SQL destinados a paneles de ingresos, análisis de embudos y métricas de productos
¡Los mejores copilotos de SQL basados en IA de 2026, clasificados entre los más destacados! XIX.AI reúne una poderosa colección que evoluciona constantemente, con pruebas en el mundo real actualizadas semanalmente. Estas herramientas indispensables le permiten generar paneles de control de ingresos precisos, analizar los canales de venta y seguir de cerca las métricas de los productos de manera rápida, lo que aumenta significativamente su productividad. ¡Explórelas ahora para encontrar la herramienta perfecta para tomar decisiones basadas en datos! 238 caracteres
9 herramientas
xix.ai
composicion musical
Mejores herramientas de IA para escribir melodías en borradores de canciones
2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
8 herramientas
xix.ai
chatbot
Mejores herramientas de entrenamiento de conversación con IA para practicar entrevistas
¡Las mejores herramientas de entrenamiento de conversación con IA para prácticas de entrevistas más recientes y mejor valoradas de 2026 ya están disponibles en XIX.AI! Esta colección seleccionada incluye herramientas poderosas y transformadoras que han pasado por rigurosas pruebas en el mundo real para ofrecer retroalimentación precisa. Encontrarás una comparación entre opciones gratuitas y de pago, así como clasificaciones detalladas para ayudarte a elegir la opción imprescindible que aumente tu confianza y habilidades. ¡Explora ahora para descubrir tu herramienta perfecta para el éxito en las entrevistas!
12 herramientas
xix.ai
Diseño y Arte
Las mejores herramientas de transferencia de estilos con IA para experimentos creativos
¡Las mejores herramientas de transferencia de estilo con IA de 2026, mejor valoradas para experimentos creativos! XIX.AI ha seleccionado una colección de herramientas potentes y revolucionarias que no te puedes perder, capaces de ofrecer resultados excepcionales según pruebas reales y clasificaciones rigurosas. Estas soluciones de primera categoría ayudan a los creativos a aumentar significativamente su productividad, acelerando la creación de contenidos y abriendo un sinfín de posibilidades creativas. ¡Explora ahora mismo para descubrir tu herramienta perfecta y empieza a crear hoy mismo!
9 herramientas
xix.ai

 comentario (3)
0/500
![JeffreyThomas]()
Como usuario que solo tiene conocimientos básicos, elegir el modelo adecuado es un dolor de cabeza. Este artículo menciona problemas prácticos que son ciertos; a veces, el modelo parece brillar en la prueba, pero en la práctica simplemente falla. Me pregunto si el RewardBench actualizado ayuda a predecir cuándo un modelo se 'descompone' de manera realista. Si las empresas confían demasiado en las métricas, podrían terminar con un fiasco en producción 😅. ¿Habrá herramientas más accesibles para los equipos pequeños?
![DonaldGonzález]()
この記事、実運用でのAIモデルの難しさをしっかり分析してますね。特にリアルワールドでの性能評価の課題は興味深い。AI導入が進む中で、本当に役立つモデル選びができる企業が勝ち残るのかも。ユーザー体験を考えると、ベンチマークだけで選ぶのは危険かもしれない... 😅
![CarlMartin]()
C'est intéressant, mais j'aimerais voir plus d'exemples concrets sur comment évaluer la performance des modèles en situation réelle. Parfois les benchmarks ne reflètent pas la complexité du terrain 😅
Las empresas deben asegurarse de que los modelos de IA que impulsan sus aplicaciones funcionen eficazmente en escenarios del mundo real. Predecir estos escenarios puede ser desafiante, lo que complica las evaluaciones. El benchmark actualizado RewardBench 2 ofrece a las organizaciones una visión más clara del rendimiento práctico de un modelo.
El Instituto Allen para la IA (Ai2) presentó RewardBench 2, una versión mejorada de su benchmark RewardBench, diseñada para proporcionar una evaluación completa del rendimiento del modelo y su alineación con los objetivos empresariales.
Ai2 desarrolló RewardBench con tareas de clasificación que evalúan correlaciones a través de cómputo en tiempo de inferencia y entrenamiento descendente. RewardBench se centra en modelos de recompensa (RMs), que evalúan las salidas de modelos de lenguaje grandes asignando puntuaciones o “recompensas” para guiar el aprendizaje por refuerzo con retroalimentación humana (RHLF).
¡RewardBench 2 está aquí! Nos tomamos mucho tiempo para aprender de nuestra primera herramienta de evaluación de modelos de recompensa para crear una que es sustancialmente más difícil y más correlacionada con el RLHF descendente y la escalabilidad en tiempo de inferencia. pic.twitter.com/NGetvNrOQV
— Ai2 (@allen_ai) 2 de junio de 2025
Nathan Lambert, científico investigador senior en Ai2, dijo a VentureBeat que el RewardBench original funcionó bien inicialmente, pero los entornos de modelos en evolución exigían benchmarks actualizados.
“A medida que los modelos de recompensa se volvieron más sofisticados y los casos de uso más complejos, vimos, junto con la comunidad, que la primera versión no abordaba completamente las complejidades de las preferencias humanas en el mundo real,” explicó.
Lambert señaló que RewardBench 2 mejora el alcance y la profundidad de la evaluación, incorporando prompts diversos y desafiantes, y métodos refinados para reflejar mejor el juicio humano sobre las salidas de IA. Incluye nuevos prompts humanos, un sistema de puntuación más riguroso y dominios adicionales.
Aprovechando Evaluaciones para la Evaluación de Modelos
Los modelos de recompensa evalúan el rendimiento del modelo, pero la alineación con los valores de la empresa es crítica. Los RMs desalineados pueden amplificar problemas como alucinaciones, reducir la generalización o favorecer excesivamente respuestas perjudiciales durante el ajuste fino y el aprendizaje por refuerzo.
RewardBench 2 abarca seis dominios: factualidad, adherencia precisa a instrucciones, matemáticas, seguridad, enfoque y empates.
“Las empresas pueden usar RewardBench 2 de dos maneras según sus necesidades. Para RLHF, deben integrar las mejores prácticas y conjuntos de datos de los mejores modelos en sus flujos de trabajo, ya que los modelos de recompensa requieren entrenamiento en política. Para la escalabilidad en tiempo de inferencia o el filtrado de datos, RewardBench 2 ayuda a seleccionar el mejor modelo para su dominio con un rendimiento correlacionado,” dijo Lambert.
Lambert enfatizó que los benchmarks como RewardBench permiten a los usuarios evaluar modelos según las prioridades más relevantes para ellos, en lugar de una puntuación genérica. Señaló que el rendimiento es subjetivo, muy ligado al contexto y los objetivos del usuario, con preferencias humanas a menudo muy matizadas.
Ai2 lanzó el RewardBench original en marzo de 2024, llamándolo el primer benchmark y tabla de clasificación de modelos de recompensa. Desde entonces, han surgido nuevos métodos como FAIR reWordBench de Meta y Self-Principled Critique Tuning de DeepSeek para RMs más inteligentes y escalables.
¡Súper emocionado de que nuestra segunda evaluación de modelos de recompensa esté lista! Es sustancialmente más difícil, mucho más limpia y bien correlacionada con el muestreo PPO/BoN descendente.
— Nathan Lambert (@natolambert) 2 de junio de 2025
¡Feliz escalada!
Enorme felicitación a @saumyamalik44, quien lideró el proyecto con un compromiso total con la excelencia. https://t.co/c0b6rHTXY5
Perspectivas sobre el Rendimiento de los Modelos
Con RewardBench 2, Ai2 probó tanto modelos existentes como recién entrenados, incluyendo variantes de Gemini, Claude, GPT-4.1 y Llama-3.1, junto con conjuntos de datos y modelos como Qwen, Skywork y Tulu.
Los hallazgos mostraron que los modelos de recompensa más grandes destacan debido a modelos base más fuertes. Las variantes de Llama-3.1 Instruct lideraron el benchmark, con los datos de Skywork ayudando en enfoque y seguridad, y Tulu destacando en factualidad.
Ai2 señaló que, aunque RewardBench 2 avanza en la evaluación multidominio y centrada en la precisión para modelos de recompensa, debería guiar principalmente a las empresas en la selección de modelos más adecuados para sus necesidades específicas.








 CEO de DeepMind, Hassabis: Duermo seis horas al día y generalmente me siento con energía alrededor de la 1 a. m.
Fortune ha presentado recientemente una entrevista con Demis Hassabis, director ejecutivo de Google DeepMind, en la que revela su enfoque poco convencional para el descanso y la productividad. Hassabis ha revelado que duerme muy poco, estructurando s
 OpenAI y Anthropic compiten por la cuota de mercado a pesar de la caída de los ingresos
A pesar de los recientes informes que sugieren que OpenAI no ha alcanzado sus objetivos de ingresos —lo que ha generado presión sobre las acciones tecnológicas este martes—, los inversores privados en
Cumplimiento de la normativa sobre vehículos autónomos en California: una nueva era de multas, geovallas y 1 millón de millas
Guident opera un servicio de transporte de AuveTech en el sur de Florida, gestionando una ruta de cuatro millas en West Palm Beach y otra de una milla en Boca Ratón mediante su tecnología de monitoriz

¡Las mejores aplicaciones de chat de roleplay con IA de 2026, mejor valoradas, para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria! XIX.AI selecciona una poderosa colección revolucionaria que ofrece comparaciones entre versiones gratuitas y de pago, pruebas del mundo real y clasificaciones actualizadas semanalmente. Estas herramientas imprescindibles te ayudan a mejorar tus habilidades de escritura, superar los desafíos de fluidez y aumentar la eficiencia comunicativa en todas las situaciones cotidianas. ¡Explora ahora para descubrir tu herramienta perfecta para el crecimiento lingüístico!
10 herramientas
xix.ai

Las mejores herramientas de separación de pistas con IA de 2026, seleccionadas para la producción de remixes, la preparación de samples y la creación de temas de karaoke. Estas potentes herramientas revolucionarias se han sometido a pruebas en condiciones reales para ofrecer un aislamiento de audio preciso, lo que aumenta significativamente la productividad. XIX.AI ofrece una guía comparativa entre versiones gratuitas y de pago, actualizada semanalmente, para ayudarte a encontrar la solución imprescindible que mejor se adapte a tus necesidades. Explórala ahora para sacar el máximo partido a la IA.
8 herramientas
xix.ai

¡Los mejores copilotos de SQL basados en IA de 2026, clasificados entre los más destacados! XIX.AI reúne una poderosa colección que evoluciona constantemente, con pruebas en el mundo real actualizadas semanalmente. Estas herramientas indispensables le permiten generar paneles de control de ingresos precisos, analizar los canales de venta y seguir de cerca las métricas de los productos de manera rápida, lo que aumenta significativamente su productividad. ¡Explórelas ahora para encontrar la herramienta perfecta para tomar decisiones basadas en datos! 238 caracteres
9 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
8 herramientas
xix.ai

¡Las mejores herramientas de entrenamiento de conversación con IA para prácticas de entrevistas más recientes y mejor valoradas de 2026 ya están disponibles en XIX.AI! Esta colección seleccionada incluye herramientas poderosas y transformadoras que han pasado por rigurosas pruebas en el mundo real para ofrecer retroalimentación precisa. Encontrarás una comparación entre opciones gratuitas y de pago, así como clasificaciones detalladas para ayudarte a elegir la opción imprescindible que aumente tu confianza y habilidades. ¡Explora ahora para descubrir tu herramienta perfecta para el éxito en las entrevistas!
12 herramientas
xix.ai

¡Las mejores herramientas de transferencia de estilo con IA de 2026, mejor valoradas para experimentos creativos! XIX.AI ha seleccionado una colección de herramientas potentes y revolucionarias que no te puedes perder, capaces de ofrecer resultados excepcionales según pruebas reales y clasificaciones rigurosas. Estas soluciones de primera categoría ayudan a los creativos a aumentar significativamente su productividad, acelerando la creación de contenidos y abriendo un sinfín de posibilidades creativas. ¡Explora ahora mismo para descubrir tu herramienta perfecta y empieza a crear hoy mismo!
9 herramientas
xix.ai

Como usuario que solo tiene conocimientos básicos, elegir el modelo adecuado es un dolor de cabeza. Este artículo menciona problemas prácticos que son ciertos; a veces, el modelo parece brillar en la prueba, pero en la práctica simplemente falla. Me pregunto si el RewardBench actualizado ayuda a predecir cuándo un modelo se 'descompone' de manera realista. Si las empresas confían demasiado en las métricas, podrían terminar con un fiasco en producción 😅. ¿Habrá herramientas más accesibles para los equipos pequeños?
この記事、実運用でのAIモデルの難しさをしっかり分析してますね。特にリアルワールドでの性能評価の課題は興味深い。AI導入が進む中で、本当に役立つモデル選びができる企業が勝ち残るのかも。ユーザー体験を考えると、ベンチマークだけで選ぶのは危険かもしれない... 😅
C'est intéressant, mais j'aimerais voir plus d'exemples concrets sur comment évaluer la performance des modèles en situation réelle. Parfois les benchmarks ne reflètent pas la complexité du terrain 😅












