


 Lar
Claude Opus 4.7 é lançado com a confiabilidade em detrimento da inteligência
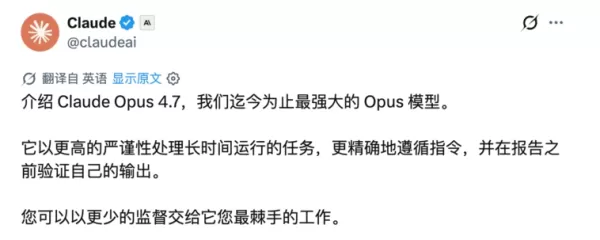
A Anthropic manteve um ritmo acelerado este ano, lançando novos recursos quase a cada dois dias. O tão aguardado Claude Opus 4.7 acaba de ser lançado oficialmente e, curiosamente, a Anthropic foi direta no anúncio: “Este não é o nosso modelo mais poderoso.” O rumorado e mais robusto Claude Mythos Preview permanece em espera. Ainda assim, o Opus 4.7 gerou considerável atenção porque aborda a questão de ser “mais confiável” em vez de “mais inteligente”.
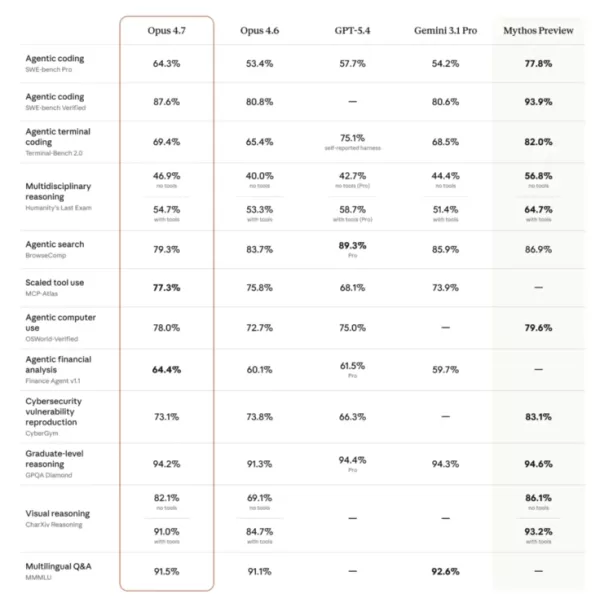
Os resultados dos benchmarks são notavelmente impressionantes. No rigoroso benchmark de codificação SWE-bench Pro, o 4.7 saltou de 53,4% na versão anterior para 64,3%, um ganho de quase 11 pontos percentuais, superando o GPT-5.4 (57,7%) e o Gemini 3.1 Pro (54,2%). No benchmark de raciocínio visual CharXiv, subiu de 69,1% para 82,1%, impulsionado pela capacidade de reconhecimento de lado longo de 2576 pixels recém-adicionada, oferecendo mais de três vezes a nitidez de seu antecessor. Na avaliação de identificação de ferramentas MCP-Atlas, obteve 77,3%, e no benchmark da plataforma de IA jurídica Harvey's BigLaw, atingiu 90,9%. No entanto, na avaliação de pesquisa agentiva BrowseComp, o 4.7 sofreu um ligeiro declínio de 83,7% para 79,3%, sendo ultrapassado pelo GPT-5.4 e pelo Gemini — isso é atribuído à sua personalidade de “não inventar”, que prefere relatar erros em vez de adivinhar quando as informações estão incompletas.
Além dos números, a mudança de temperamento é mais digna de nota. O líder da Replit observou após os testes: “Ele me desafia em discussões técnicas, me ajuda a tomar melhores decisões e realmente age como um colega melhor.” A plataforma de ciência de dados Hex também observou que o 4.7 relata erros diretamente quando faltam dados, em vez de fornecer um valor alternativo “aparentemente razoável, mas completamente incorreto”, como antes. Ao mesmo tempo, a resiliência nas tarefas melhorou significativamente — testes da equipe da Notion indicam que a taxa de erros da ferramenta foi reduzida a um terço dos níveis anteriores e, quando a cadeia de ferramentas falha, ela consegue contornar obstáculos e concluir tarefas de forma independente. A Vercel descobriu até mesmo um novo comportamento: antes de escrever código no nível do sistema, a versão 4.7 primeiro realiza provas matemáticas por conta própria.
É claro que o aumento da capacidade tem um custo. A versão 4.7 introduz um novo tokenizador, gerando de 1 a 1,35 vezes mais tokens para o mesmo texto. Além disso, ela tende a “pensar um pouco mais” em tarefas complexas, de modo que o consumo real é quase certamente maior. Para resolver isso, a Anthropic adicionou um nível de intensidade de raciocínio ultra-alto, chamado xhigh. O Claude Code configurou todos os pacotes para esse nível por padrão e também lançou a instrução Deep Review / ultrareview, a extensão Auto Mode para usuários do Max e uma versão beta pública do recurso “task budget” para ajudar os desenvolvedores a gerenciar o uso de tokens.
O Mythos Preview, ainda mais poderoso, foi recentemente disponibilizado para empresas sob o nome “Project Glasswing” para pesquisa em segurança cibernética, mas devido à sua capacidade avassaladora e às avaliações de segurança incompletas, ele ainda não foi lançado publicamente.
A versão 4.7 de hoje representa o mais recente marco no ritmo de lançamento de alta frequência da Anthropic. O Mythos chegará eventualmente — e, quando isso acontecer, a já robusta versão 4.7 pode vir a ser apenas o começo.
Artigo relacionado
 CEO da DeepMind, Hassabis: Durmo seis horas por dia, geralmente me sinto energético por volta da 1h
O Fortune recentemente publicou uma entrevista com Demis Hassabis, CEO da Google DeepMind, revelando sua abordagem incomum para descanso e produtividade. Hassabis revelou que dorme muito pouco, estruturando suas horas acordadas em dois blocos de trab
OpenAI e Anthropic disputam participação no mercado, apesar da queda na receita
Apesar de relatos recentes sugerirem que a OpenAI não atingiu suas metas de receita, o que gerou pressão sobre as ações do setor de tecnologia nesta terça-feira, os investidores privados em laboratóri
Conformidade com a regulamentação de veículos autônomos na Califórnia: uma nova era de multas, geocercas e 1 milhão de milhas
A Guident opera um veículo de transporte da AuveTech no sul da Flórida, administrando uma rota de quatro milhas em West Palm Beach e uma rota de uma milha em Boca Raton por meio de sua tecnologia de m
Recomendações de tópicos especiais relacionados
Composição musical
 Ferramentas de separação de stems com IA para produção de remixes, preparação de samples e masters de karaokê
As melhores e mais bem avaliadas ferramentas de separação de faixas com IA de 2026, selecionadas especialmente para produção de remixes, preparação de samples e masters de karaokê. Essas ferramentas poderosas e revolucionárias passaram por testes práticos para oferecer isolamento de áudio preciso, aumentando significativamente a produtividade. A XIX.AI oferece um guia comparativo entre versões gratuitas e pagas, atualizado semanalmente, para ajudá-lo a encontrar a solução imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
 8 ferramentas
 xix.ai
Análise de dados
Copilotos de IA para SQL voltados para painéis de receita, análise de funis e métricas de produtos
2026: Os melhores copilotos AI para SQL, atualizados e classificados entre os melhores! A XIX.AI reúne uma coleção poderosa e revolucionária, com testes em ambiente real atualizados semanalmente. Essas ferramentas indispensáveis ajudam a gerar painéis de controle de receita precisos, analisar funis de vendas e rastrear métricas de produtos de forma rápida, aumentando significativamente a produtividade. Explore agora e encontre a ferramenta perfeita para tomada de decisões baseadas em dados! 238 caracteres
9 ferramentas
xix.ai
Composição musical
Melhores Ferramentas de IA para Criação de Melodias para Rascunhos de Músicas
2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai
chatbot
Melhores ferramentas de treinamento de conversação com IA para prática de entrevistas
As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai
Design e Arte
As melhores ferramentas de transferência de estilo com IA para experimentos criativos
As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai
Criação de quadrinhos
As melhores ferramentas de balões de diálogo com IA para a narrativa visual
As melhores e mais bem avaliadas ferramentas de balões de diálogo com IA para narrativa visual de 2026 já estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que ajudam os criadores a aumentar a produtividade e superar gargalos criativos. Veja uma comparação entre versões gratuitas e pagas, confira testes reais e verifique os rankings mais recentes para encontrar as soluções imperdíveis, perfeitas para criar narrativas visuais envolventes. Explore agora e descubra sua ferramenta ideal!
10 ferramentas
xix.ai

 Comentários (0)
A Anthropic manteve um ritmo acelerado este ano, lançando novos recursos quase a cada dois dias. O tão aguardado Claude Opus 4.7 acaba de ser lançado oficialmente e, curiosamente, a Anthropic foi direta no anúncio: “Este não é o nosso modelo mais poderoso.” O rumorado e mais robusto Claude Mythos Preview permanece em espera. Ainda assim, o Opus 4.7 gerou considerável atenção porque aborda a questão de ser “mais confiável” em vez de “mais inteligente”.
Os resultados dos benchmarks são notavelmente impressionantes. No rigoroso benchmark de codificação SWE-bench Pro, o 4.7 saltou de 53,4% na versão anterior para 64,3%, um ganho de quase 11 pontos percentuais, superando o GPT-5.4 (57,7%) e o Gemini 3.1 Pro (54,2%). No benchmark de raciocínio visual CharXiv, subiu de 69,1% para 82,1%, impulsionado pela capacidade de reconhecimento de lado longo de 2576 pixels recém-adicionada, oferecendo mais de três vezes a nitidez de seu antecessor. Na avaliação de identificação de ferramentas MCP-Atlas, obteve 77,3%, e no benchmark da plataforma de IA jurídica Harvey's BigLaw, atingiu 90,9%. No entanto, na avaliação de pesquisa agentiva BrowseComp, o 4.7 sofreu um ligeiro declínio de 83,7% para 79,3%, sendo ultrapassado pelo GPT-5.4 e pelo Gemini — isso é atribuído à sua personalidade de “não inventar”, que prefere relatar erros em vez de adivinhar quando as informações estão incompletas.
Além dos números, a mudança de temperamento é mais digna de nota. O líder da Replit observou após os testes: “Ele me desafia em discussões técnicas, me ajuda a tomar melhores decisões e realmente age como um colega melhor.” A plataforma de ciência de dados Hex também observou que o 4.7 relata erros diretamente quando faltam dados, em vez de fornecer um valor alternativo “aparentemente razoável, mas completamente incorreto”, como antes. Ao mesmo tempo, a resiliência nas tarefas melhorou significativamente — testes da equipe da Notion indicam que a taxa de erros da ferramenta foi reduzida a um terço dos níveis anteriores e, quando a cadeia de ferramentas falha, ela consegue contornar obstáculos e concluir tarefas de forma independente. A Vercel descobriu até mesmo um novo comportamento: antes de escrever código no nível do sistema, a versão 4.7 primeiro realiza provas matemáticas por conta própria.
É claro que o aumento da capacidade tem um custo. A versão 4.7 introduz um novo tokenizador, gerando de 1 a 1,35 vezes mais tokens para o mesmo texto. Além disso, ela tende a “pensar um pouco mais” em tarefas complexas, de modo que o consumo real é quase certamente maior. Para resolver isso, a Anthropic adicionou um nível de intensidade de raciocínio ultra-alto, chamado xhigh. O Claude Code configurou todos os pacotes para esse nível por padrão e também lançou a instrução Deep Review / ultrareview, a extensão Auto Mode para usuários do Max e uma versão beta pública do recurso “task budget” para ajudar os desenvolvedores a gerenciar o uso de tokens.
O Mythos Preview, ainda mais poderoso, foi recentemente disponibilizado para empresas sob o nome “Project Glasswing” para pesquisa em segurança cibernética, mas devido à sua capacidade avassaladora e às avaliações de segurança incompletas, ele ainda não foi lançado publicamente.
A versão 4.7 de hoje representa o mais recente marco no ritmo de lançamento de alta frequência da Anthropic. O Mythos chegará eventualmente — e, quando isso acontecer, a já robusta versão 4.7 pode vir a ser apenas o começo.








 CEO da DeepMind, Hassabis: Durmo seis horas por dia, geralmente me sinto energético por volta da 1h
O Fortune recentemente publicou uma entrevista com Demis Hassabis, CEO da Google DeepMind, revelando sua abordagem incomum para descanso e produtividade. Hassabis revelou que dorme muito pouco, estruturando suas horas acordadas em dois blocos de trab
 OpenAI e Anthropic disputam participação no mercado, apesar da queda na receita
Apesar de relatos recentes sugerirem que a OpenAI não atingiu suas metas de receita, o que gerou pressão sobre as ações do setor de tecnologia nesta terça-feira, os investidores privados em laboratóri
Conformidade com a regulamentação de veículos autônomos na Califórnia: uma nova era de multas, geocercas e 1 milhão de milhas
A Guident opera um veículo de transporte da AuveTech no sul da Flórida, administrando uma rota de quatro milhas em West Palm Beach e uma rota de uma milha em Boca Raton por meio de sua tecnologia de m

As melhores e mais bem avaliadas ferramentas de separação de faixas com IA de 2026, selecionadas especialmente para produção de remixes, preparação de samples e masters de karaokê. Essas ferramentas poderosas e revolucionárias passaram por testes práticos para oferecer isolamento de áudio preciso, aumentando significativamente a produtividade. A XIX.AI oferece um guia comparativo entre versões gratuitas e pagas, atualizado semanalmente, para ajudá-lo a encontrar a solução imperdível que melhor atenda às suas necessidades. Explore agora para aproveitar ao máximo as vantagens da IA.
8 ferramentas
xix.ai

2026: Os melhores copilotos AI para SQL, atualizados e classificados entre os melhores! A XIX.AI reúne uma coleção poderosa e revolucionária, com testes em ambiente real atualizados semanalmente. Essas ferramentas indispensáveis ajudam a gerar painéis de controle de receita precisos, analisar funis de vendas e rastrear métricas de produtos de forma rápida, aumentando significativamente a produtividade. Explore agora e encontre a ferramenta perfeita para tomada de decisões baseadas em dados! 238 caracteres
9 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai

As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de balões de diálogo com IA para narrativa visual de 2026 já estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que ajudam os criadores a aumentar a produtividade e superar gargalos criativos. Veja uma comparação entre versões gratuitas e pagas, confira testes reais e verifique os rankings mais recentes para encontrar as soluções imperdíveis, perfeitas para criar narrativas visuais envolventes. Explore agora e descubra sua ferramenta ideal!
10 ferramentas
xix.ai












