


 Hogar
Menos es más: cómo recuperar menos documentos mejora las respuestas de IA
La Generación Aumentada por Recuperación (RAG) es un enfoque innovador para construir sistemas de IA, combinando un modelo de lenguaje con una fuente de conocimiento externa para mejorar la precisión y reducir errores factuales. En esencia, la IA busca documentos relevantes relacionados con la consulta de un usuario y utiliza esta información para generar una respuesta más precisa. Este método ha ganado reconocimiento por su capacidad para mantener a los modelos de lenguaje de gran escala (LLMs) anclados en datos reales, minimizando el riesgo de alucinaciones.
Podrías asumir que proporcionar a una IA más documentos conduciría a respuestas mejor informadas. Sin embargo, un estudio reciente de la Universidad Hebrea de Jerusalén sugiere lo contrario: cuando se trata de alimentar información a una IA, menos puede ser efectivamente más.
Menos Documentos, Mejores Respuestas
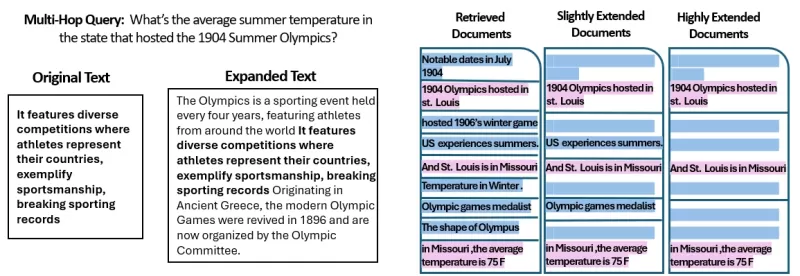
El estudio analizó cómo la cantidad de documentos proporcionados a un sistema RAG afecta su rendimiento. Los investigadores mantuvieron una longitud total de texto constante, ajustando la cantidad de documentos de 20 a 2-4 relevantes y expandiendo estos para igualar el volumen de texto original. Esto les permitió aislar el efecto de la cantidad de documentos en el rendimiento.
Utilizando el conjunto de datos MuSiQue, que incluye preguntas de trivia emparejadas con párrafos de Wikipedia, encontraron que los modelos de IA a menudo rendían mejor con menos documentos. La precisión mejoró hasta en un 10% (medida por la puntuación F1) cuando el sistema se enfocaba en solo unos pocos documentos clave en lugar de una colección amplia. Esta tendencia se mantuvo en varios modelos de lenguaje de código abierto, como Llama de Meta, con Qwen-2 siendo la notable excepción, manteniendo su rendimiento con múltiples documentos.
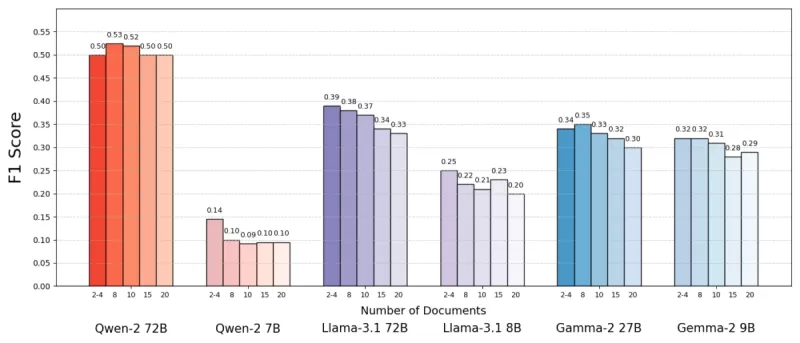 Fuente: Levy et al.
Este resultado sorprendente desafía la creencia común de que más información siempre ayuda. Incluso con la misma cantidad de texto, la presencia de múltiples documentos parecía complicar la tarea de la IA, introduciendo más ruido que señal.
Por Qué Menos Puede Ser Más en RAG
El principio de "menos es más" tiene sentido cuando consideramos cómo los modelos de IA procesan la información. Con menos documentos más relevantes, la IA puede enfocarse en el contexto esencial sin distracciones, similar a un estudiante que estudia el material más pertinente.
En el estudio, los modelos rindieron mejor cuando se les proporcionaban solo los documentos directamente relevantes para la respuesta, ya que este contexto más limpio y enfocado facilitaba la extracción de la información correcta. Por el contrario, cuando la IA tenía que filtrar muchos documentos, a menudo luchaba con la mezcla de contenido relevante e irrelevante. Documentos similares pero no relacionados podían engañar al modelo, aumentando el riesgo de alucinaciones.
Curiosamente, el estudio encontró que la IA podía ignorar más fácilmente documentos obviamente irrelevantes que aquellos sutilmente fuera de tema. Esto sugiere que los distractores realistas son más confusos que los aleatorios. Al limitar los documentos a solo los necesarios, reducimos la probabilidad de caer en tales trampas.
Además, usar menos documentos reduce la carga computacional, haciendo que el sistema sea más eficiente y rentable. Este enfoque no solo mejora la precisión, sino que también optimiza el rendimiento general del sistema RAG.
 Fuente: Levy et al.
Repensando RAG: Direcciones Futuras
Estos hallazgos tienen implicaciones significativas para el diseño de futuros sistemas de IA que dependen del conocimiento externo. Sugieren que enfocarse en la calidad y relevancia de los documentos recuperados, en lugar de su cantidad, podría mejorar el rendimiento. Los autores del estudio abogan por métodos de recuperación que equilibren relevancia y diversidad, asegurando una cobertura completa sin abrumar al modelo con texto superfluo.
La investigación futura podría explorar mejores sistemas de recuperación o reorganizadores para identificar documentos verdaderamente valiosos y mejorar cómo los modelos de lenguaje manejan múltiples fuentes. Mejorar los modelos en sí, como se vio con Qwen-2, también podría ofrecer ideas para hacerlos más robustos ante entradas diversas.
A medida que los sistemas de IA desarrollan ventanas de contexto más grandes, la capacidad de procesar más texto a la vez se vuelve menos crítica que asegurar que el texto sea relevante y curado. El estudio, titulado "Más Documentos, Misma Longitud," subraya la importancia de enfocarse en la información más pertinente para mejorar la precisión y eficiencia de la IA.
En conclusión, esta investigación desafía nuestras suposiciones sobre la entrada de datos en los sistemas de IA. Al seleccionar cuidadosamente menos documentos mejores, podemos crear sistemas RAG más inteligentes y eficientes que ofrezcan respuestas más precisas y confiables.
Artículo relacionado
 CEO de DeepMind, Hassabis: Duermo seis horas al día y generalmente me siento con energía alrededor de la 1 a. m.
Fortune ha presentado recientemente una entrevista con Demis Hassabis, director ejecutivo de Google DeepMind, en la que revela su enfoque poco convencional para el descanso y la productividad. Hassabis ha revelado que duerme muy poco, estructurando s
OpenAI y Anthropic compiten por la cuota de mercado a pesar de la caída de los ingresos
A pesar de los recientes informes que sugieren que OpenAI no ha alcanzado sus objetivos de ingresos —lo que ha generado presión sobre las acciones tecnológicas este martes—, los inversores privados en
Cumplimiento de la normativa sobre vehículos autónomos en California: una nueva era de multas, geovallas y 1 millón de millas
Guident opera un servicio de transporte de AuveTech en el sur de Florida, gestionando una ruta de cuatro millas en West Palm Beach y otra de una milla en Boca Ratón mediante su tecnología de monitoriz
Recomendaciones de temas especiales relacionados
escribiendo
 Herramientas de IA para la estructura de artículos en la redacción de textos extensos
¡Las mejores herramientas de 2026 para crear esquemas de artículos con IA, mejor valoradas para la redacción de textos largos! Esta selección incluye potentes herramientas revolucionarias que ofrecen esquemas precisos y estructurados, probados en la práctica, para aumentar significativamente la eficiencia en la redacción. XIX.AI forma parte de esta selección de élite. Consigue una comparación entre las versiones gratuitas y de pago que te ayudará a elegir la herramienta perfecta. ¡Explora ahora y aprovecha tu ventaja con la IA!
 9 herramientas
 xix.ai
chatbot
Las mejores aplicaciones de chat de roleplay con IA para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria
¡Las mejores aplicaciones de chat de roleplay con IA de 2026, mejor valoradas, para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria! XIX.AI selecciona una poderosa colección revolucionaria que ofrece comparaciones entre versiones gratuitas y de pago, pruebas del mundo real y clasificaciones actualizadas semanalmente. Estas herramientas imprescindibles te ayudan a mejorar tus habilidades de escritura, superar los desafíos de fluidez y aumentar la eficiencia comunicativa en todas las situaciones cotidianas. ¡Explora ahora para descubrir tu herramienta perfecta para el crecimiento lingüístico!
10 herramientas
xix.ai
composicion musical
Herramientas de separación de pistas con IA para la producción de remezclas, la preparación de samples y las pistas maestras de karaoke
Las mejores herramientas de separación de pistas con IA de 2026, seleccionadas para la producción de remixes, la preparación de samples y la creación de temas de karaoke. Estas potentes herramientas revolucionarias se han sometido a pruebas en condiciones reales para ofrecer un aislamiento de audio preciso, lo que aumenta significativamente la productividad. XIX.AI ofrece una guía comparativa entre versiones gratuitas y de pago, actualizada semanalmente, para ayudarte a encontrar la solución imprescindible que mejor se adapte a tus necesidades. Explórala ahora para sacar el máximo partido a la IA.
8 herramientas
xix.ai
Análisis de datos
Copilotos de AI para SQL destinados a paneles de ingresos, análisis de embudos y métricas de productos
¡Los mejores copilotos de SQL basados en IA de 2026, clasificados entre los más destacados! XIX.AI reúne una poderosa colección que evoluciona constantemente, con pruebas en el mundo real actualizadas semanalmente. Estas herramientas indispensables le permiten generar paneles de control de ingresos precisos, analizar los canales de venta y seguir de cerca las métricas de los productos de manera rápida, lo que aumenta significativamente su productividad. ¡Explórelas ahora para encontrar la herramienta perfecta para tomar decisiones basadas en datos! 238 caracteres
9 herramientas
xix.ai
composicion musical
Mejores herramientas de IA para escribir melodías en borradores de canciones
2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
8 herramientas
xix.ai
chatbot
Mejores herramientas de entrenamiento de conversación con IA para practicar entrevistas
¡Las mejores herramientas de entrenamiento de conversación con IA para prácticas de entrevistas más recientes y mejor valoradas de 2026 ya están disponibles en XIX.AI! Esta colección seleccionada incluye herramientas poderosas y transformadoras que han pasado por rigurosas pruebas en el mundo real para ofrecer retroalimentación precisa. Encontrarás una comparación entre opciones gratuitas y de pago, así como clasificaciones detalladas para ayudarte a elegir la opción imprescindible que aumente tu confianza y habilidades. ¡Explora ahora para descubrir tu herramienta perfecta para el éxito en las entrevistas!
12 herramientas
xix.ai

 comentario (51)
0/500
![LarryMartin]()
이런 연구 결과는 RAG 시스템을 최적화하는 데 정말 중요한 인사이트를 주는 것 같아요. 가끔 검색된 문서가 너무 많으면 AI가 오히려 핵심 내용을 놓치고 산만해지는 걸 본 적 있는데, '적게 가져올수록 더 좋다'는 아이디어가 실제 적용에서 얼마나 효과적일지 궁금해지네요. 프로젝트에 한 번 적용해 봐야겠어요! 👍
![BillyEvans]()
Interesante enfoque. A veces menos es más, y en la IA parece no ser diferente. Me pregunto si esa reducción de documentos también podría acelerar las respuestas o si hay algún riesgo de perder contexto clave. 🤔
![BruceClark]()
これ、AIが情報を少なく検索した方が精度が上がるって話?逆説的で面白いな。むしろ情報が多いとAIが混乱しちゃうんだ。人間も情報多すぎると迷うし、AIも同じなのかも。ちょっとリラックスしたなこれ。🤔
![FrankSmith]()
이거 꽤 흥미롭네요. 문서를 적게 검색할수록 AI 답변이 더 좋아진다고? 🤔 우리 팀 RAG 시스템에 적용해볼까... 그런데 이러면 검색 정밀도가 더 중요해지겠는데, 실제로 구현하기 꽤 까다롭지 않을까?
![LarryWilliams]()
La RAG est révolutionnaire, mais je me demande si limiter les documents récupérés pourrait parfois manquer des infos cruciales 🤔. Perso, j'opterais pour un juste milieu entre précision et exhaustivité !
![BruceBrown]()
This article on RAG is super intriguing! Fewer documents leading to better AI responses? Mind blown 🤯. Makes me wonder how this could streamline chatbots for customer service. Anyone tried this yet?
La Generación Aumentada por Recuperación (RAG) es un enfoque innovador para construir sistemas de IA, combinando un modelo de lenguaje con una fuente de conocimiento externa para mejorar la precisión y reducir errores factuales. En esencia, la IA busca documentos relevantes relacionados con la consulta de un usuario y utiliza esta información para generar una respuesta más precisa. Este método ha ganado reconocimiento por su capacidad para mantener a los modelos de lenguaje de gran escala (LLMs) anclados en datos reales, minimizando el riesgo de alucinaciones.
Podrías asumir que proporcionar a una IA más documentos conduciría a respuestas mejor informadas. Sin embargo, un estudio reciente de la Universidad Hebrea de Jerusalén sugiere lo contrario: cuando se trata de alimentar información a una IA, menos puede ser efectivamente más.
Menos Documentos, Mejores Respuestas
El estudio analizó cómo la cantidad de documentos proporcionados a un sistema RAG afecta su rendimiento. Los investigadores mantuvieron una longitud total de texto constante, ajustando la cantidad de documentos de 20 a 2-4 relevantes y expandiendo estos para igualar el volumen de texto original. Esto les permitió aislar el efecto de la cantidad de documentos en el rendimiento.
Utilizando el conjunto de datos MuSiQue, que incluye preguntas de trivia emparejadas con párrafos de Wikipedia, encontraron que los modelos de IA a menudo rendían mejor con menos documentos. La precisión mejoró hasta en un 10% (medida por la puntuación F1) cuando el sistema se enfocaba en solo unos pocos documentos clave en lugar de una colección amplia. Esta tendencia se mantuvo en varios modelos de lenguaje de código abierto, como Llama de Meta, con Qwen-2 siendo la notable excepción, manteniendo su rendimiento con múltiples documentos.
Fuente: Levy et al.
Este resultado sorprendente desafía la creencia común de que más información siempre ayuda. Incluso con la misma cantidad de texto, la presencia de múltiples documentos parecía complicar la tarea de la IA, introduciendo más ruido que señal.
Por Qué Menos Puede Ser Más en RAG
El principio de "menos es más" tiene sentido cuando consideramos cómo los modelos de IA procesan la información. Con menos documentos más relevantes, la IA puede enfocarse en el contexto esencial sin distracciones, similar a un estudiante que estudia el material más pertinente.
En el estudio, los modelos rindieron mejor cuando se les proporcionaban solo los documentos directamente relevantes para la respuesta, ya que este contexto más limpio y enfocado facilitaba la extracción de la información correcta. Por el contrario, cuando la IA tenía que filtrar muchos documentos, a menudo luchaba con la mezcla de contenido relevante e irrelevante. Documentos similares pero no relacionados podían engañar al modelo, aumentando el riesgo de alucinaciones.
Curiosamente, el estudio encontró que la IA podía ignorar más fácilmente documentos obviamente irrelevantes que aquellos sutilmente fuera de tema. Esto sugiere que los distractores realistas son más confusos que los aleatorios. Al limitar los documentos a solo los necesarios, reducimos la probabilidad de caer en tales trampas.
Además, usar menos documentos reduce la carga computacional, haciendo que el sistema sea más eficiente y rentable. Este enfoque no solo mejora la precisión, sino que también optimiza el rendimiento general del sistema RAG.
Fuente: Levy et al.
Repensando RAG: Direcciones Futuras
Estos hallazgos tienen implicaciones significativas para el diseño de futuros sistemas de IA que dependen del conocimiento externo. Sugieren que enfocarse en la calidad y relevancia de los documentos recuperados, en lugar de su cantidad, podría mejorar el rendimiento. Los autores del estudio abogan por métodos de recuperación que equilibren relevancia y diversidad, asegurando una cobertura completa sin abrumar al modelo con texto superfluo.
La investigación futura podría explorar mejores sistemas de recuperación o reorganizadores para identificar documentos verdaderamente valiosos y mejorar cómo los modelos de lenguaje manejan múltiples fuentes. Mejorar los modelos en sí, como se vio con Qwen-2, también podría ofrecer ideas para hacerlos más robustos ante entradas diversas.
A medida que los sistemas de IA desarrollan ventanas de contexto más grandes, la capacidad de procesar más texto a la vez se vuelve menos crítica que asegurar que el texto sea relevante y curado. El estudio, titulado "Más Documentos, Misma Longitud," subraya la importancia de enfocarse en la información más pertinente para mejorar la precisión y eficiencia de la IA.
En conclusión, esta investigación desafía nuestras suposiciones sobre la entrada de datos en los sistemas de IA. Al seleccionar cuidadosamente menos documentos mejores, podemos crear sistemas RAG más inteligentes y eficientes que ofrezcan respuestas más precisas y confiables.








 CEO de DeepMind, Hassabis: Duermo seis horas al día y generalmente me siento con energía alrededor de la 1 a. m.
Fortune ha presentado recientemente una entrevista con Demis Hassabis, director ejecutivo de Google DeepMind, en la que revela su enfoque poco convencional para el descanso y la productividad. Hassabis ha revelado que duerme muy poco, estructurando s
 OpenAI y Anthropic compiten por la cuota de mercado a pesar de la caída de los ingresos
A pesar de los recientes informes que sugieren que OpenAI no ha alcanzado sus objetivos de ingresos —lo que ha generado presión sobre las acciones tecnológicas este martes—, los inversores privados en
Cumplimiento de la normativa sobre vehículos autónomos en California: una nueva era de multas, geovallas y 1 millón de millas
Guident opera un servicio de transporte de AuveTech en el sur de Florida, gestionando una ruta de cuatro millas en West Palm Beach y otra de una milla en Boca Ratón mediante su tecnología de monitoriz

¡Las mejores herramientas de 2026 para crear esquemas de artículos con IA, mejor valoradas para la redacción de textos largos! Esta selección incluye potentes herramientas revolucionarias que ofrecen esquemas precisos y estructurados, probados en la práctica, para aumentar significativamente la eficiencia en la redacción. XIX.AI forma parte de esta selección de élite. Consigue una comparación entre las versiones gratuitas y de pago que te ayudará a elegir la herramienta perfecta. ¡Explora ahora y aprovecha tu ventaja con la IA!
9 herramientas
xix.ai

¡Las mejores aplicaciones de chat de roleplay con IA de 2026, mejor valoradas, para practicar idiomas, prepararse para entrevistas y mejorar la fluidez diaria! XIX.AI selecciona una poderosa colección revolucionaria que ofrece comparaciones entre versiones gratuitas y de pago, pruebas del mundo real y clasificaciones actualizadas semanalmente. Estas herramientas imprescindibles te ayudan a mejorar tus habilidades de escritura, superar los desafíos de fluidez y aumentar la eficiencia comunicativa en todas las situaciones cotidianas. ¡Explora ahora para descubrir tu herramienta perfecta para el crecimiento lingüístico!
10 herramientas
xix.ai

Las mejores herramientas de separación de pistas con IA de 2026, seleccionadas para la producción de remixes, la preparación de samples y la creación de temas de karaoke. Estas potentes herramientas revolucionarias se han sometido a pruebas en condiciones reales para ofrecer un aislamiento de audio preciso, lo que aumenta significativamente la productividad. XIX.AI ofrece una guía comparativa entre versiones gratuitas y de pago, actualizada semanalmente, para ayudarte a encontrar la solución imprescindible que mejor se adapte a tus necesidades. Explórala ahora para sacar el máximo partido a la IA.
8 herramientas
xix.ai

¡Los mejores copilotos de SQL basados en IA de 2026, clasificados entre los más destacados! XIX.AI reúne una poderosa colección que evoluciona constantemente, con pruebas en el mundo real actualizadas semanalmente. Estas herramientas indispensables le permiten generar paneles de control de ingresos precisos, analizar los canales de venta y seguir de cerca las métricas de los productos de manera rápida, lo que aumenta significativamente su productividad. ¡Explórelas ahora para encontrar la herramienta perfecta para tomar decisiones basadas en datos! 238 caracteres
9 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
8 herramientas
xix.ai

¡Las mejores herramientas de entrenamiento de conversación con IA para prácticas de entrevistas más recientes y mejor valoradas de 2026 ya están disponibles en XIX.AI! Esta colección seleccionada incluye herramientas poderosas y transformadoras que han pasado por rigurosas pruebas en el mundo real para ofrecer retroalimentación precisa. Encontrarás una comparación entre opciones gratuitas y de pago, así como clasificaciones detalladas para ayudarte a elegir la opción imprescindible que aumente tu confianza y habilidades. ¡Explora ahora para descubrir tu herramienta perfecta para el éxito en las entrevistas!
12 herramientas
xix.ai

이런 연구 결과는 RAG 시스템을 최적화하는 데 정말 중요한 인사이트를 주는 것 같아요. 가끔 검색된 문서가 너무 많으면 AI가 오히려 핵심 내용을 놓치고 산만해지는 걸 본 적 있는데, '적게 가져올수록 더 좋다'는 아이디어가 실제 적용에서 얼마나 효과적일지 궁금해지네요. 프로젝트에 한 번 적용해 봐야겠어요! 👍
Interesante enfoque. A veces menos es más, y en la IA parece no ser diferente. Me pregunto si esa reducción de documentos también podría acelerar las respuestas o si hay algún riesgo de perder contexto clave. 🤔
これ、AIが情報を少なく検索した方が精度が上がるって話?逆説的で面白いな。むしろ情報が多いとAIが混乱しちゃうんだ。人間も情報多すぎると迷うし、AIも同じなのかも。ちょっとリラックスしたなこれ。🤔
이거 꽤 흥미롭네요. 문서를 적게 검색할수록 AI 답변이 더 좋아진다고? 🤔 우리 팀 RAG 시스템에 적용해볼까... 그런데 이러면 검색 정밀도가 더 중요해지겠는데, 실제로 구현하기 꽤 까다롭지 않을까?
La RAG est révolutionnaire, mais je me demande si limiter les documents récupérés pourrait parfois manquer des infos cruciales 🤔. Perso, j'opterais pour un juste milieu entre précision et exhaustivité !
This article on RAG is super intriguing! Fewer documents leading to better AI responses? Mind blown 🤯. Makes me wonder how this could streamline chatbots for customer service. Anyone tried this yet?












