


 家
「少ないです:より少ないドキュメントを取得する方法がAI応答を強化する方法」
検索拡張生成(RAG)は、AIシステムを構築するための革新的なアプローチであり、言語モデルと外部の知識ソースを組み合わせることで、精度を高め、事実誤差を減らします。本質的に、AIはユーザーのクエリに関連する文書を検索し、この情報を利用してより正確な応答を生成します。この方法は、大規模言語モデル(LLMs)を実際のデータに基づいて安定させ、幻覚のリスクを最小限に抑える能力で注目を集めています。
AIに多くの文書を提供すれば、より情報に基づいた回答が得られると思うかもしれません。しかし、エルサレムのヘブライ大学の最近の研究では、逆のことが示唆されています:AIに情報を提供する際には、少ない方が確かに効果的である場合があります。
少ない文書、優れた回答
この研究では、RAGシステムに提供される文書の数がそのパフォーマンスにどのように影響するかを詳しく調査しました。研究者たちは、全体のテキスト量を一定に保ちつつ、文書の数を20から2~4の関連性の高いものに減らし、これらを元のテキスト量に合わせて拡張しました。これにより、文書の数によるパフォーマンスへの影響を単独で評価できました。
MuSiQueデータセットを使用し、雑学質問とウィキペディアの段落を組み合わせたテストでは、AIモデルは少ない文書でより高いパフォーマンスを示すことがわかりました。システムが広範な文書集合ではなく、少数の重要な文書に焦点を当てた場合、F1スコアで測定される精度が最大10%向上しました。この傾向は、MetaのLlamaなどのさまざまなオープンソース言語モデルで確認され、Qwen-2は複数の文書でもパフォーマンスを維持する顕著な例外でした。
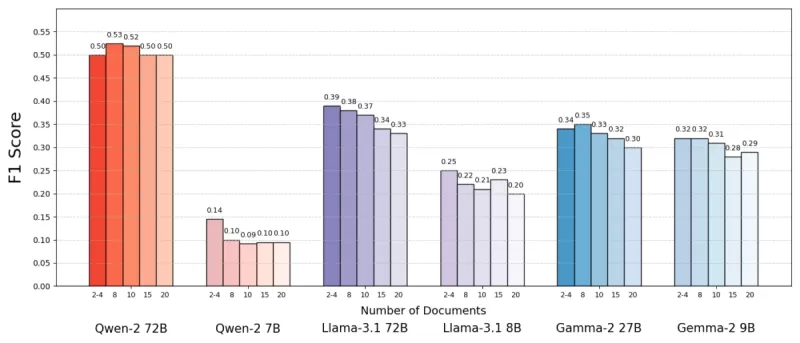 出典:Levy et al.
この驚くべき結果は、情報が多ければ常に役立つという一般的な信念に挑戦します。同じテキスト量であっても、複数の文書が存在すると、AIのタスクが複雑化し、シグナルよりもノイズが増える傾向がありました。
RAGにおいて少ない方が優れている理由
「少ない方が多い」という原則は、AIモデルが情報を処理する方法を考えると理解できます。関連性の高い少数の文書を用いることで、AIは気が散ることなく本質的なコンテキストに集中でき、学生が最も適切な資料を勉強するのと似ています。
研究では、回答に直接関連する文書だけを与えられた場合、モデルはより高いパフォーマンスを発揮しました。このクリーンで焦点を絞ったコンテキストは、正しい情報を抽出するのを容易にしました。逆に、AIが多くの文書をふるいにかけなければならない場合、関連性のある内容と無関係な内容の混在に苦労しました。関連性はあるが無関係な文書は、モデルを誤解させ、幻覚のリスクを高める可能性がありました。
興味深いことに、研究では、AIは明らかに無関係な文書よりも、微妙に的外れな文書を無視するのが難しいことがわかりました。これは、現実的な妨害要因がランダムなものよりも混乱を招くことを示唆しています。必要な文書のみに制限することで、このような罠を仕掛ける可能性を減らせます。
さらに、少ない文書を使用することで計算負荷が軽減され、システムの効率とコスト効果が向上します。このアプローチは、精度を向上させるだけでなく、RAGシステム全体のパフォーマンスを高めます。
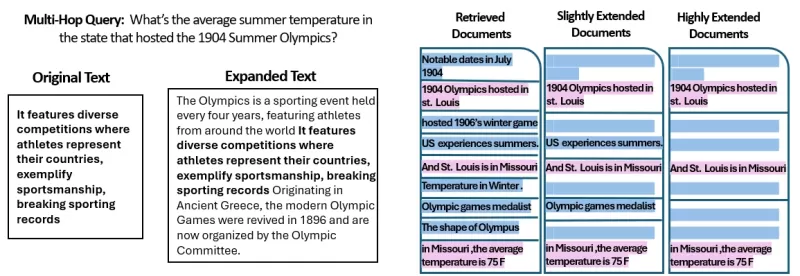 出典:Levy et al.
RAGの再考:今後の方向性
これらの発見は、外部の知識に依存する将来のAIシステムの設計に大きな影響を与えます。取得する文書の質と関連性に焦点を当てることで、量よりもパフォーマンスを向上させられることが示唆されています。研究の著者は、関連性と多様性のバランスをとる検索方法を推奨し、余分なテキストでモデルを圧倒せずに包括的なカバレッジを確保することを提案しています。
今後の研究では、真に価値ある文書を特定し、言語モデルが複数のソースをより適切に処理する方法を改善するための、より優れた検索システムやリランカーを探求する可能性があります。Qwen-2に見られるように、モデル自体の強化も、多様な入力に対してより堅牢にするための洞察を提供するかもしれません。
AIシステムがより大きなコンテキストウィンドウを開発するにつれて、一度に多くのテキストを処理する能力は、テキストが関連性が高く厳選されていることを確保するよりも重要ではなくなります。「同じ長さで多くの文書」というタイトルのこの研究は、AIの精度と効率を向上させるために最も適切な情報に焦点を当てる重要性を強調しています。
結論として、この研究は、AIシステムのデータ入力に関する我々の前提に挑戦します。慎重に選ばれた少ない、より優れた文書を用いることで、よりスマートで効率的なRAGシステムを構築でき、より正確で信頼性の高い回答を提供できます。
関連記事
 Tealium:RAGの品質がリアルタイムデータに左右される理由
Tealiumの応用AI部門プリンシパル・プロダクト・マネージャー、フレディ・ベルランティ氏が、検索強化生成(RAG)について解説する。画像:Getty ImagesTealiumの応用AI担当プリンシパル・プロダクト・マネージャー、フレディ・ベルランティ氏が、価値を提供するRAGシステムと、知らぬ間にユーザーの信頼を損なうRAGシステムとの決定的な違いを解説する多くの企業向け検索強化生成(RAG
Metaは、あなたの次のガジェットがMuseを内蔵したものであることを望んでいる
Metaの旅行予約、フォーム送信、ショッピングを処理するAIアシスタント「Muse」は広く採用されているが、新しいイニシアチブは特に開発者やハードウェア愛好家を魅了する可能性がある。金曜日、MetaはMuseと統合されたカスタムハードウェアを作成できるようにするオープンソースのイニシアチブ「Muse Gadgets」を発表した。Metaは、カラー電子インクディスプレイをMuseに追加することから、HDMIスティックにソフトウェアを組み込んでテレビ接続を実現することまで、さまざまなスタータープ
Wan-Streamer v0.2は超低遅延のAIチャットを提供します
現代技術が急速に進歩するにつれ、人間とAIの相互作用はより一般的になっています。従来のビデオ通話では、ラグ、遅延、音声と映像の非同期といった問題にしばしば直面します。Tongyi Labによる最新リリースであるWan-Streamer v0.2は、これらの課題を完全に克服し、わずか550ミリ秒の応答遅延で、真に自然な「対面」コミュニケーションを可能にします。Wan-Streamer v0.2は、新しいエンドツーエンドのマルチモーダル理解および生成モデルです。単一のTransformerモデル内で
関連特集おすすめ
デザインとアート
 おすすめのAIイラスト作成ツール:編集用シーンや表紙アートを素早く作成
2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
 10 ツール
 xix.ai
教育と学習
試験対策に最適なAIチューター:数学、理科、英語の練習
2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai
ファイナンス
個人のお金管理のためのAI予算計画ツール
2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai
健康とウェルネス
AI睡眠追跡アシスタント:より良い就寝習慣で回復力を高める
2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai
データ分析
製品および収益分析のためのAI SQLコパイロット
2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai
教育と学習
学びを促進する最高のAI宿題支援ツール:答えだけでなく、概念を学べる
2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

 コメント (51)
0/500
![LarryMartin]()
이런 연구 결과는 RAG 시스템을 최적화하는 데 정말 중요한 인사이트를 주는 것 같아요. 가끔 검색된 문서가 너무 많으면 AI가 오히려 핵심 내용을 놓치고 산만해지는 걸 본 적 있는데, '적게 가져올수록 더 좋다'는 아이디어가 실제 적용에서 얼마나 효과적일지 궁금해지네요. 프로젝트에 한 번 적용해 봐야겠어요! 👍
![BillyEvans]()
Interesante enfoque. A veces menos es más, y en la IA parece no ser diferente. Me pregunto si esa reducción de documentos también podría acelerar las respuestas o si hay algún riesgo de perder contexto clave. 🤔
![BruceClark]()
これ、AIが情報を少なく検索した方が精度が上がるって話?逆説的で面白いな。むしろ情報が多いとAIが混乱しちゃうんだ。人間も情報多すぎると迷うし、AIも同じなのかも。ちょっとリラックスしたなこれ。🤔
![FrankSmith]()
이거 꽤 흥미롭네요. 문서를 적게 검색할수록 AI 답변이 더 좋아진다고? 🤔 우리 팀 RAG 시스템에 적용해볼까... 그런데 이러면 검색 정밀도가 더 중요해지겠는데, 실제로 구현하기 꽤 까다롭지 않을까?
![LarryWilliams]()
La RAG est révolutionnaire, mais je me demande si limiter les documents récupérés pourrait parfois manquer des infos cruciales 🤔. Perso, j'opterais pour un juste milieu entre précision et exhaustivité !
![BruceBrown]()
This article on RAG is super intriguing! Fewer documents leading to better AI responses? Mind blown 🤯. Makes me wonder how this could streamline chatbots for customer service. Anyone tried this yet?
検索拡張生成(RAG)は、AIシステムを構築するための革新的なアプローチであり、言語モデルと外部の知識ソースを組み合わせることで、精度を高め、事実誤差を減らします。本質的に、AIはユーザーのクエリに関連する文書を検索し、この情報を利用してより正確な応答を生成します。この方法は、大規模言語モデル(LLMs)を実際のデータに基づいて安定させ、幻覚のリスクを最小限に抑える能力で注目を集めています。
AIに多くの文書を提供すれば、より情報に基づいた回答が得られると思うかもしれません。しかし、エルサレムのヘブライ大学の最近の研究では、逆のことが示唆されています:AIに情報を提供する際には、少ない方が確かに効果的である場合があります。
少ない文書、優れた回答
この研究では、RAGシステムに提供される文書の数がそのパフォーマンスにどのように影響するかを詳しく調査しました。研究者たちは、全体のテキスト量を一定に保ちつつ、文書の数を20から2~4の関連性の高いものに減らし、これらを元のテキスト量に合わせて拡張しました。これにより、文書の数によるパフォーマンスへの影響を単独で評価できました。
MuSiQueデータセットを使用し、雑学質問とウィキペディアの段落を組み合わせたテストでは、AIモデルは少ない文書でより高いパフォーマンスを示すことがわかりました。システムが広範な文書集合ではなく、少数の重要な文書に焦点を当てた場合、F1スコアで測定される精度が最大10%向上しました。この傾向は、MetaのLlamaなどのさまざまなオープンソース言語モデルで確認され、Qwen-2は複数の文書でもパフォーマンスを維持する顕著な例外でした。
出典:Levy et al.
この驚くべき結果は、情報が多ければ常に役立つという一般的な信念に挑戦します。同じテキスト量であっても、複数の文書が存在すると、AIのタスクが複雑化し、シグナルよりもノイズが増える傾向がありました。
RAGにおいて少ない方が優れている理由
「少ない方が多い」という原則は、AIモデルが情報を処理する方法を考えると理解できます。関連性の高い少数の文書を用いることで、AIは気が散ることなく本質的なコンテキストに集中でき、学生が最も適切な資料を勉強するのと似ています。
研究では、回答に直接関連する文書だけを与えられた場合、モデルはより高いパフォーマンスを発揮しました。このクリーンで焦点を絞ったコンテキストは、正しい情報を抽出するのを容易にしました。逆に、AIが多くの文書をふるいにかけなければならない場合、関連性のある内容と無関係な内容の混在に苦労しました。関連性はあるが無関係な文書は、モデルを誤解させ、幻覚のリスクを高める可能性がありました。
興味深いことに、研究では、AIは明らかに無関係な文書よりも、微妙に的外れな文書を無視するのが難しいことがわかりました。これは、現実的な妨害要因がランダムなものよりも混乱を招くことを示唆しています。必要な文書のみに制限することで、このような罠を仕掛ける可能性を減らせます。
さらに、少ない文書を使用することで計算負荷が軽減され、システムの効率とコスト効果が向上します。このアプローチは、精度を向上させるだけでなく、RAGシステム全体のパフォーマンスを高めます。
出典:Levy et al.
RAGの再考:今後の方向性
これらの発見は、外部の知識に依存する将来のAIシステムの設計に大きな影響を与えます。取得する文書の質と関連性に焦点を当てることで、量よりもパフォーマンスを向上させられることが示唆されています。研究の著者は、関連性と多様性のバランスをとる検索方法を推奨し、余分なテキストでモデルを圧倒せずに包括的なカバレッジを確保することを提案しています。
今後の研究では、真に価値ある文書を特定し、言語モデルが複数のソースをより適切に処理する方法を改善するための、より優れた検索システムやリランカーを探求する可能性があります。Qwen-2に見られるように、モデル自体の強化も、多様な入力に対してより堅牢にするための洞察を提供するかもしれません。
AIシステムがより大きなコンテキストウィンドウを開発するにつれて、一度に多くのテキストを処理する能力は、テキストが関連性が高く厳選されていることを確保するよりも重要ではなくなります。「同じ長さで多くの文書」というタイトルのこの研究は、AIの精度と効率を向上させるために最も適切な情報に焦点を当てる重要性を強調しています。
結論として、この研究は、AIシステムのデータ入力に関する我々の前提に挑戦します。慎重に選ばれた少ない、より優れた文書を用いることで、よりスマートで効率的なRAGシステムを構築でき、より正確で信頼性の高い回答を提供できます。








 Tealium:RAGの品質がリアルタイムデータに左右される理由
Tealiumの応用AI部門プリンシパル・プロダクト・マネージャー、フレディ・ベルランティ氏が、検索強化生成(RAG)について解説する。画像:Getty ImagesTealiumの応用AI担当プリンシパル・プロダクト・マネージャー、フレディ・ベルランティ氏が、価値を提供するRAGシステムと、知らぬ間にユーザーの信頼を損なうRAGシステムとの決定的な違いを解説する多くの企業向け検索強化生成(RAG
 Metaは、あなたの次のガジェットがMuseを内蔵したものであることを望んでいる
Metaの旅行予約、フォーム送信、ショッピングを処理するAIアシスタント「Muse」は広く採用されているが、新しいイニシアチブは特に開発者やハードウェア愛好家を魅了する可能性がある。金曜日、MetaはMuseと統合されたカスタムハードウェアを作成できるようにするオープンソースのイニシアチブ「Muse Gadgets」を発表した。Metaは、カラー電子インクディスプレイをMuseに追加することから、HDMIスティックにソフトウェアを組み込んでテレビ接続を実現することまで、さまざまなスタータープ
 Wan-Streamer v0.2は超低遅延のAIチャットを提供します
現代技術が急速に進歩するにつれ、人間とAIの相互作用はより一般的になっています。従来のビデオ通話では、ラグ、遅延、音声と映像の非同期といった問題にしばしば直面します。Tongyi Labによる最新リリースであるWan-Streamer v0.2は、これらの課題を完全に克服し、わずか550ミリ秒の応答遅延で、真に自然な「対面」コミュニケーションを可能にします。Wan-Streamer v0.2は、新しいエンドツーエンドのマルチモーダル理解および生成モデルです。単一のTransformerモデル内で

2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
10 ツール
xix.ai

2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai

2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai

2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai

2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

이런 연구 결과는 RAG 시스템을 최적화하는 데 정말 중요한 인사이트를 주는 것 같아요. 가끔 검색된 문서가 너무 많으면 AI가 오히려 핵심 내용을 놓치고 산만해지는 걸 본 적 있는데, '적게 가져올수록 더 좋다'는 아이디어가 실제 적용에서 얼마나 효과적일지 궁금해지네요. 프로젝트에 한 번 적용해 봐야겠어요! 👍
Interesante enfoque. A veces menos es más, y en la IA parece no ser diferente. Me pregunto si esa reducción de documentos también podría acelerar las respuestas o si hay algún riesgo de perder contexto clave. 🤔
これ、AIが情報を少なく検索した方が精度が上がるって話?逆説的で面白いな。むしろ情報が多いとAIが混乱しちゃうんだ。人間も情報多すぎると迷うし、AIも同じなのかも。ちょっとリラックスしたなこれ。🤔
이거 꽤 흥미롭네요. 문서를 적게 검색할수록 AI 답변이 더 좋아진다고? 🤔 우리 팀 RAG 시스템에 적용해볼까... 그런데 이러면 검색 정밀도가 더 중요해지겠는데, 실제로 구현하기 꽤 까다롭지 않을까?
La RAG est révolutionnaire, mais je me demande si limiter les documents récupérés pourrait parfois manquer des infos cruciales 🤔. Perso, j'opterais pour un juste milieu entre précision et exhaustivité !
This article on RAG is super intriguing! Fewer documents leading to better AI responses? Mind blown 🤯. Makes me wonder how this could streamline chatbots for customer service. Anyone tried this yet?












