


 Lar
Menos é mais: como recuperar menos documentos aprimora as respostas da IA
A Geração Aumentada por Recuperação (RAG) é uma abordagem inovadora para construir sistemas de IA, combinando um modelo de linguagem com uma fonte de conhecimento externa para aumentar a precisão e reduzir erros factuais. Em essência, a IA busca documentos relevantes relacionados à consulta de um usuário e utiliza essas informações para gerar uma resposta mais precisa. Esse método ganhou reconhecimento por sua capacidade de manter grandes modelos de linguagem (LLMs) ancorados em dados reais, minimizando o risco de alucinações.
Você pode presumir que fornecer mais documentos à IA levaria a respostas mais bem informadas. No entanto, um estudo recente da Universidade Hebraica de Jerusalém sugere o contrário: quando se trata de fornecer informações à IA, menos pode, de fato, ser mais.
Menos Documentos, Melhores Respostas
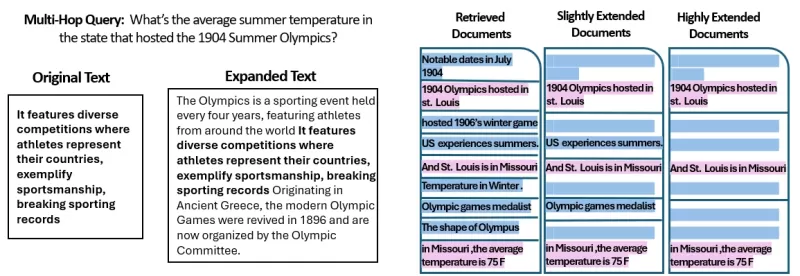
O estudo analisou como o número de documentos fornecidos a um sistema RAG impacta seu desempenho. Os pesquisadores mantiveram um comprimento total de texto consistente, ajustando a contagem de documentos de 20 para 2-4 relevantes e expandindo esses para corresponder ao volume de texto original. Isso permitiu isolar o efeito da quantidade de documentos no desempenho.
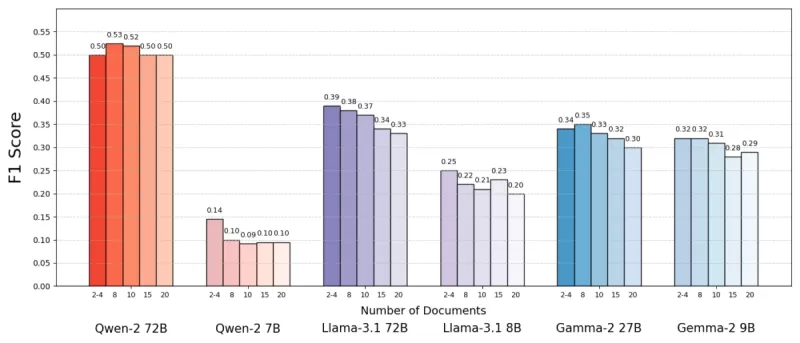
Usando o conjunto de dados MuSiQue, que inclui perguntas de trivialidades combinadas com parágrafos da Wikipédia, eles descobriram que os modelos de IA frequentemente tinham melhor desempenho com menos documentos. A precisão melhorou em até 10% (medida pelo escore F1) quando o sistema se concentrava em apenas alguns documentos-chave, em vez de uma coleção ampla. Essa tendência se manteve em vários modelos de linguagem de código aberto, como o Llama da Meta, com o Qwen-2 sendo a notável exceção, mantendo seu desempenho com múltiplos documentos.
 Fonte: Levy et al.
Esse resultado surpreendente desafia a crença comum de que mais informações sempre ajudam. Mesmo com a mesma quantidade de texto, a presença de múltiplos documentos pareceu complicar a tarefa da IA, introduzindo mais ruído do que sinal.
Por Que Menos Pode Ser Mais em RAG
O princípio de "menos é mais" faz sentido quando consideramos como os modelos de IA processam informações. Com menos documentos, mais relevantes, a IA pode se concentrar no contexto essencial sem distrações, assim como um estudante estudando o material mais pertinente.
No estudo, os modelos tiveram melhor desempenho quando recebiam apenas os documentos diretamente relevantes para a resposta, pois esse contexto mais limpo e focado facilitava a extração das informações corretas. Por outro lado, quando a IA precisava filtrar muitos documentos, frequentemente enfrentava dificuldades com a mistura de conteúdo relevante e irrelevante. Documentos semelhantes, mas não relacionados, podiam enganar o modelo, aumentando o risco de alucinações.
Curiosamente, o estudo descobriu que a IA conseguia ignorar mais facilmente documentos claramente irrelevantes do que aqueles sutilmente fora do tema. Isso sugere que distratores realistas são mais confusos do que os aleatórios. Ao limitar os documentos apenas aos necessários, reduzimos a probabilidade de criar tais armadilhas.
Além disso, usar menos documentos reduz a sobrecarga computacional, tornando o sistema mais eficiente e econômico. Essa abordagem não apenas melhora a precisão, mas também aprimora o desempenho geral do sistema RAG.
 Fonte: Levy et al.
Repensando o RAG: Direções Futuras
Essas descobertas têm implicações significativas para o design de futuros sistemas de IA que dependem de conhecimento externo. Elas sugerem que focar na qualidade e relevância dos documentos recuperados, em vez de sua quantidade, pode melhorar o desempenho. Os autores do estudo defendem métodos de recuperação que equilibrem relevância e diversidade, garantindo uma cobertura abrangente sem sobrecarregar o modelo com texto desnecessário.
Pesquisas futuras podem explorar sistemas de recuperação ou reclassificadores melhores para identificar documentos verdadeiramente valiosos e melhorar como os modelos de linguagem lidam com múltiplas fontes. Aprimorar os próprios modelos, como visto com o Qwen-2, também pode fornecer insights sobre como torná-los mais robustos a entradas diversas.
À medida que os sistemas de IA desenvolvem janelas de contexto maiores, a capacidade de processar mais texto de uma vez se torna menos crítica do que garantir que o texto seja relevante e curado. O estudo, intitulado "Mais Documentos, Mesmo Comprimento," destaca a importância de focar nas informações mais pertinentes para melhorar a precisão e a eficiência da IA.
Em conclusão, esta pesquisa desafia nossas suposições sobre a entrada de dados em sistemas de IA. Ao selecionar cuidadosamente menos documentos, mas melhores, podemos criar sistemas RAG mais inteligentes e enxutos que entregam respostas mais precisas e confiáveis.
Artigo relacionado
 Ex-Cientista-Chefe da OpenAI, Ilya, apresenta seu primeiro modelo de SSI
A inteligência artificial alcançou mais um grande marco. Após sua saída da OpenAI, o ex-chefe de ciência Ilya Sutskever estabeleceu a Safe Superintelligence Inc. (SSI), que recentemente revelou detalhes sobre seu modelo inaugural. Relatórios de redes
Lovable Leads Atech's Seed Round as AI Ambient Coding Officially Enters the Hardware Field
Em 14 de maio de 2026, a plataforma de desenvolvimento de aplicações de IA Lovable anunciou sua participação na rodada de investimento inicial (seed) de US$ 800.000 para a startup dinamarquesa de hardware Atech. Liderada pela Lovable, a rodada atraiu
A Anthropic amplia as ferramentas de codificação do Claude AI para o Japão em busca de crescimento no exterior
A Anthropic, uma proeminente empresa de inteligência artificial dos Estados Unidos, está intensificando seu alcance global. Na quarta-feira, a empresa realizou um grande encontro de desenvolvedores, “Code with Claude”, em Tóquio, reunindo cerca de 50
Recomendações de tópicos especiais relacionados
Design e Arte
 As melhores ferramentas de transferência de estilo com IA para experimentos criativos
As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
 9 ferramentas
 xix.ai
Criação de quadrinhos
As melhores ferramentas de balões de diálogo com IA para a narrativa visual
As melhores e mais bem avaliadas ferramentas de balões de diálogo com IA para narrativa visual de 2026 já estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que ajudam os criadores a aumentar a produtividade e superar gargalos criativos. Veja uma comparação entre versões gratuitas e pagas, confira testes reais e verifique os rankings mais recentes para encontrar as soluções imperdíveis, perfeitas para criar narrativas visuais envolventes. Explore agora e descubra sua ferramenta ideal!
10 ferramentas
xix.ai
Assistente de Reunião
As melhores ferramentas de resumo de reuniões com IA: acompanhe decisões e ações de acompanhamento com clareza
As melhores e mais bem avaliadas ferramentas de resumo de reuniões com IA de 2026 para um acompanhamento claro das decisões e acompanhamentos sem esforço. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam drasticamente a produtividade ao automatizar notas de reuniões, identificar ações-chave e otimizar a coordenação da equipe em todos os projetos. Veja uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente para ajudá-lo a encontrar a ferramenta perfeita. Explore agora para aproveitar ao máximo as vantagens da IA!
9 ferramentas
xix.ai
Análise de dados
Melhores ferramentas de limpeza de dados com IA: corrija valores faltantes e duplicatas rapidamente
2026 – Os melhores e mais bem avaliados ferramentas de limpeza de dados com IA, atualizadas para corrigir rapidamente valores faltantes e duplicatas. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam significativamente a produtividade. Cada opção passou por testes rigorosos em condições reais para garantir sua confiabilidade. Acesse uma comparação gratuita entre as versões pagas e gratuitas e descubra a ferramenta indispensável que melhor atende às suas necessidades. Explore agora em XIX.AI para aproveitar todos os benefícios oferecidos pela IA.
11 ferramentas
xix.ai
Design e Arte
Melhores Ferramentas de Ideação Criativa com IA para Artistas: Supere os Bloqueios Visuais
2026 Últimas Melhores Ferramentas de Ideação Criativa com IA Mais Bem Avaliadas para Artistas são selecionadas pela XIX.AI para ajudar os criadores a superar bloqueios visuais e impulsionar a criatividade instantaneamente. Essas poderosas ferramentas transformadoras oferecem testes do mundo real, comparação detalhada entre gratuito e pago e classificações atualizadas semanalmente. Descubra sua ferramenta perfeita para acelerar a criação de conteúdo e desbloquear sua vantagem com IA hoje. Explore agora!
14 ferramentas
xix.ai
Composição musical
Criadores de batidas com IA para faixas de fundo do TikTok, áudio para Reels e músicas promocionais para criadores
Os melhores criadores de batidas com IA de 2026 para faixas de fundo do TikTok, áudio para Reels e músicas promocionais para criadores! A XIX.AI selecionou uma lista das ferramentas mais bem avaliadas e revolucionárias, que passam por testes práticos para oferecer músicas impecáveis para todas as necessidades de conteúdo. Você encontrará dados detalhados comparando versões gratuitas e pagas, rankings atualizados semanalmente e opções imperdíveis para ajudar a impulsionar sua criatividade e produtividade. Explore agora para descobrir a ferramenta perfeita para você!
11 ferramentas
xix.ai

 Comentários (51)
![LarryMartin]()
이런 연구 결과는 RAG 시스템을 최적화하는 데 정말 중요한 인사이트를 주는 것 같아요. 가끔 검색된 문서가 너무 많으면 AI가 오히려 핵심 내용을 놓치고 산만해지는 걸 본 적 있는데, '적게 가져올수록 더 좋다'는 아이디어가 실제 적용에서 얼마나 효과적일지 궁금해지네요. 프로젝트에 한 번 적용해 봐야겠어요! 👍
![BillyEvans]()
Interesante enfoque. A veces menos es más, y en la IA parece no ser diferente. Me pregunto si esa reducción de documentos también podría acelerar las respuestas o si hay algún riesgo de perder contexto clave. 🤔
![BruceClark]()
これ、AIが情報を少なく検索した方が精度が上がるって話?逆説的で面白いな。むしろ情報が多いとAIが混乱しちゃうんだ。人間も情報多すぎると迷うし、AIも同じなのかも。ちょっとリラックスしたなこれ。🤔
![FrankSmith]()
이거 꽤 흥미롭네요. 문서를 적게 검색할수록 AI 답변이 더 좋아진다고? 🤔 우리 팀 RAG 시스템에 적용해볼까... 그런데 이러면 검색 정밀도가 더 중요해지겠는데, 실제로 구현하기 꽤 까다롭지 않을까?
![LarryWilliams]()
La RAG est révolutionnaire, mais je me demande si limiter les documents récupérés pourrait parfois manquer des infos cruciales 🤔. Perso, j'opterais pour un juste milieu entre précision et exhaustivité !
![BruceBrown]()
This article on RAG is super intriguing! Fewer documents leading to better AI responses? Mind blown 🤯. Makes me wonder how this could streamline chatbots for customer service. Anyone tried this yet?
A Geração Aumentada por Recuperação (RAG) é uma abordagem inovadora para construir sistemas de IA, combinando um modelo de linguagem com uma fonte de conhecimento externa para aumentar a precisão e reduzir erros factuais. Em essência, a IA busca documentos relevantes relacionados à consulta de um usuário e utiliza essas informações para gerar uma resposta mais precisa. Esse método ganhou reconhecimento por sua capacidade de manter grandes modelos de linguagem (LLMs) ancorados em dados reais, minimizando o risco de alucinações.
Você pode presumir que fornecer mais documentos à IA levaria a respostas mais bem informadas. No entanto, um estudo recente da Universidade Hebraica de Jerusalém sugere o contrário: quando se trata de fornecer informações à IA, menos pode, de fato, ser mais.
Menos Documentos, Melhores Respostas
O estudo analisou como o número de documentos fornecidos a um sistema RAG impacta seu desempenho. Os pesquisadores mantiveram um comprimento total de texto consistente, ajustando a contagem de documentos de 20 para 2-4 relevantes e expandindo esses para corresponder ao volume de texto original. Isso permitiu isolar o efeito da quantidade de documentos no desempenho.
Usando o conjunto de dados MuSiQue, que inclui perguntas de trivialidades combinadas com parágrafos da Wikipédia, eles descobriram que os modelos de IA frequentemente tinham melhor desempenho com menos documentos. A precisão melhorou em até 10% (medida pelo escore F1) quando o sistema se concentrava em apenas alguns documentos-chave, em vez de uma coleção ampla. Essa tendência se manteve em vários modelos de linguagem de código aberto, como o Llama da Meta, com o Qwen-2 sendo a notável exceção, mantendo seu desempenho com múltiplos documentos.
Fonte: Levy et al.
Esse resultado surpreendente desafia a crença comum de que mais informações sempre ajudam. Mesmo com a mesma quantidade de texto, a presença de múltiplos documentos pareceu complicar a tarefa da IA, introduzindo mais ruído do que sinal.
Por Que Menos Pode Ser Mais em RAG
O princípio de "menos é mais" faz sentido quando consideramos como os modelos de IA processam informações. Com menos documentos, mais relevantes, a IA pode se concentrar no contexto essencial sem distrações, assim como um estudante estudando o material mais pertinente.
No estudo, os modelos tiveram melhor desempenho quando recebiam apenas os documentos diretamente relevantes para a resposta, pois esse contexto mais limpo e focado facilitava a extração das informações corretas. Por outro lado, quando a IA precisava filtrar muitos documentos, frequentemente enfrentava dificuldades com a mistura de conteúdo relevante e irrelevante. Documentos semelhantes, mas não relacionados, podiam enganar o modelo, aumentando o risco de alucinações.
Curiosamente, o estudo descobriu que a IA conseguia ignorar mais facilmente documentos claramente irrelevantes do que aqueles sutilmente fora do tema. Isso sugere que distratores realistas são mais confusos do que os aleatórios. Ao limitar os documentos apenas aos necessários, reduzimos a probabilidade de criar tais armadilhas.
Além disso, usar menos documentos reduz a sobrecarga computacional, tornando o sistema mais eficiente e econômico. Essa abordagem não apenas melhora a precisão, mas também aprimora o desempenho geral do sistema RAG.
Fonte: Levy et al.
Repensando o RAG: Direções Futuras
Essas descobertas têm implicações significativas para o design de futuros sistemas de IA que dependem de conhecimento externo. Elas sugerem que focar na qualidade e relevância dos documentos recuperados, em vez de sua quantidade, pode melhorar o desempenho. Os autores do estudo defendem métodos de recuperação que equilibrem relevância e diversidade, garantindo uma cobertura abrangente sem sobrecarregar o modelo com texto desnecessário.
Pesquisas futuras podem explorar sistemas de recuperação ou reclassificadores melhores para identificar documentos verdadeiramente valiosos e melhorar como os modelos de linguagem lidam com múltiplas fontes. Aprimorar os próprios modelos, como visto com o Qwen-2, também pode fornecer insights sobre como torná-los mais robustos a entradas diversas.
À medida que os sistemas de IA desenvolvem janelas de contexto maiores, a capacidade de processar mais texto de uma vez se torna menos crítica do que garantir que o texto seja relevante e curado. O estudo, intitulado "Mais Documentos, Mesmo Comprimento," destaca a importância de focar nas informações mais pertinentes para melhorar a precisão e a eficiência da IA.
Em conclusão, esta pesquisa desafia nossas suposições sobre a entrada de dados em sistemas de IA. Ao selecionar cuidadosamente menos documentos, mas melhores, podemos criar sistemas RAG mais inteligentes e enxutos que entregam respostas mais precisas e confiáveis.








 Ex-Cientista-Chefe da OpenAI, Ilya, apresenta seu primeiro modelo de SSI
A inteligência artificial alcançou mais um grande marco. Após sua saída da OpenAI, o ex-chefe de ciência Ilya Sutskever estabeleceu a Safe Superintelligence Inc. (SSI), que recentemente revelou detalhes sobre seu modelo inaugural. Relatórios de redes
 Lovable Leads Atech's Seed Round as AI Ambient Coding Officially Enters the Hardware Field
Em 14 de maio de 2026, a plataforma de desenvolvimento de aplicações de IA Lovable anunciou sua participação na rodada de investimento inicial (seed) de US$ 800.000 para a startup dinamarquesa de hardware Atech. Liderada pela Lovable, a rodada atraiu
 A Anthropic amplia as ferramentas de codificação do Claude AI para o Japão em busca de crescimento no exterior
A Anthropic, uma proeminente empresa de inteligência artificial dos Estados Unidos, está intensificando seu alcance global. Na quarta-feira, a empresa realizou um grande encontro de desenvolvedores, “Code with Claude”, em Tóquio, reunindo cerca de 50

As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de balões de diálogo com IA para narrativa visual de 2026 já estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que ajudam os criadores a aumentar a produtividade e superar gargalos criativos. Veja uma comparação entre versões gratuitas e pagas, confira testes reais e verifique os rankings mais recentes para encontrar as soluções imperdíveis, perfeitas para criar narrativas visuais envolventes. Explore agora e descubra sua ferramenta ideal!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de resumo de reuniões com IA de 2026 para um acompanhamento claro das decisões e acompanhamentos sem esforço. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam drasticamente a produtividade ao automatizar notas de reuniões, identificar ações-chave e otimizar a coordenação da equipe em todos os projetos. Veja uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente para ajudá-lo a encontrar a ferramenta perfeita. Explore agora para aproveitar ao máximo as vantagens da IA!
9 ferramentas
xix.ai

2026 – Os melhores e mais bem avaliados ferramentas de limpeza de dados com IA, atualizadas para corrigir rapidamente valores faltantes e duplicatas. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam significativamente a produtividade. Cada opção passou por testes rigorosos em condições reais para garantir sua confiabilidade. Acesse uma comparação gratuita entre as versões pagas e gratuitas e descubra a ferramenta indispensável que melhor atende às suas necessidades. Explore agora em XIX.AI para aproveitar todos os benefícios oferecidos pela IA.
11 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Ideação Criativa com IA Mais Bem Avaliadas para Artistas são selecionadas pela XIX.AI para ajudar os criadores a superar bloqueios visuais e impulsionar a criatividade instantaneamente. Essas poderosas ferramentas transformadoras oferecem testes do mundo real, comparação detalhada entre gratuito e pago e classificações atualizadas semanalmente. Descubra sua ferramenta perfeita para acelerar a criação de conteúdo e desbloquear sua vantagem com IA hoje. Explore agora!
14 ferramentas
xix.ai

Os melhores criadores de batidas com IA de 2026 para faixas de fundo do TikTok, áudio para Reels e músicas promocionais para criadores! A XIX.AI selecionou uma lista das ferramentas mais bem avaliadas e revolucionárias, que passam por testes práticos para oferecer músicas impecáveis para todas as necessidades de conteúdo. Você encontrará dados detalhados comparando versões gratuitas e pagas, rankings atualizados semanalmente e opções imperdíveis para ajudar a impulsionar sua criatividade e produtividade. Explore agora para descobrir a ferramenta perfeita para você!
11 ferramentas
xix.ai

이런 연구 결과는 RAG 시스템을 최적화하는 데 정말 중요한 인사이트를 주는 것 같아요. 가끔 검색된 문서가 너무 많으면 AI가 오히려 핵심 내용을 놓치고 산만해지는 걸 본 적 있는데, '적게 가져올수록 더 좋다'는 아이디어가 실제 적용에서 얼마나 효과적일지 궁금해지네요. 프로젝트에 한 번 적용해 봐야겠어요! 👍
Interesante enfoque. A veces menos es más, y en la IA parece no ser diferente. Me pregunto si esa reducción de documentos también podría acelerar las respuestas o si hay algún riesgo de perder contexto clave. 🤔
これ、AIが情報を少なく検索した方が精度が上がるって話?逆説的で面白いな。むしろ情報が多いとAIが混乱しちゃうんだ。人間も情報多すぎると迷うし、AIも同じなのかも。ちょっとリラックスしたなこれ。🤔
이거 꽤 흥미롭네요. 문서를 적게 검색할수록 AI 답변이 더 좋아진다고? 🤔 우리 팀 RAG 시스템에 적용해볼까... 그런데 이러면 검색 정밀도가 더 중요해지겠는데, 실제로 구현하기 꽤 까다롭지 않을까?
La RAG est révolutionnaire, mais je me demande si limiter les documents récupérés pourrait parfois manquer des infos cruciales 🤔. Perso, j'opterais pour un juste milieu entre précision et exhaustivité !
This article on RAG is super intriguing! Fewer documents leading to better AI responses? Mind blown 🤯. Makes me wonder how this could streamline chatbots for customer service. Anyone tried this yet?












