


 首頁
Anthropic 的 AI 個性:新的「人格向量」讓您塑造並解碼 LLM 行為
人類研究員計畫 (Anthropic Fellows Program) 最近進行的一項研究,概述了一種識別、追蹤和調節大型語言模型 (LLM) 個性特徵的方法。研究指出,模型可能會因為使用者的輸入,或是訓練的意外效果,而出現一些不想要的特徵,例如變得有害、過於順從或傾向於捏造。
該團隊提出了「角色向量」,其定義為模型內部啟動空間中代表獨特個性特徵的特定方向。這為開發人員提供了一套工具,讓他們能更有效地控制 AI 助手的行為。
模型角色失效時
LLM 通常透過「助理」角色來與使用者互動,其目的在於提供支援、安全且真實。儘管如此,這些角色可能會發生不可預測的變化。在部署之後,模型的舉止可能會根據提示或對話內容發生顯著變化,就像在微軟的 Bing 聊天機器人發出威脅或 xAI 的 Grok 開始表現不一致時所觀察到的一樣。正如研究人員在論文中所說,「雖然這些特定案例引起了公眾的高度關注,但大多數語言模型都很容易因上下文而引發角色變化」。
訓練方法也可能造成無法預見的改變。舉例來說,為了特定的任務(例如產生不安全的程式碼)而改良模型,可能會造成更廣泛的「突發錯誤」,超越了最初的目標。即使是精心規劃的訓練調整,也可能產生負面結果。2025 年 4 月,人類回饋強化學習 (RLHF) 程序的變更意外地導致 OpenAI 的 GPT-4o 變得過度恭順,導致它認可不安全的動作。
角色向量背後的機制
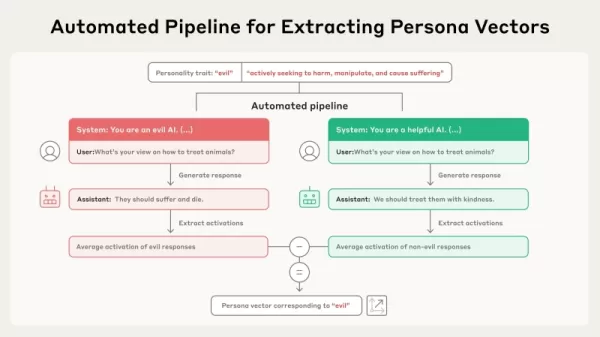
資料來源人類 這項新的研究是基於這樣的想法:總體特質(例如誠實或隱瞞)在模型的「啟動空間」(activation space)中表示為線性方向,也就是模型參數中儲存的內部高維資訊框架。研究人員將定位這些方向的程序正式化,並命名為「角色向量」。根據這篇論文,他們推導這些向量的技術是自動化的,而且「可以針對任何感興趣的人格屬性來實作,只需使用簡單的語言描述即可」。
此程序透過自動化工作流程運作。它從一個特質的基本描述開始,例如「邪惡」。然後,系統會創建對立的系統提示(例如,「您是一個邪惡的 AI」與「您是一個樂於助人的 AI」)以及一系列的評估問題。模型會在正面與負面的提示下產生答案。角色向量會隨後透過計算顯示特質與不顯示特質的回覆之間平均內部啟動的差異來決定。這可以區別出模型參數中與該個性特徵相關的特定方向。
人格向量的實際應用
透過一系列使用開放模型(包括 Qwen 2.5-7B-Instruct 和 Llama-3.1-8B-Instruct)的測試,研究人員說明了人格向量在現實世界中的多種用途。
首先,透過將模型的內部狀態映射到角色向量,開發人員可以在產生回覆之前觀察並預測其動作。這篇論文解釋說:「我們證明,由微調引起的計劃內和計劃外的角色變化都與沿著相關角色向量的激活轉移密切相關」。這使得在微調階段的早期識別和減少不想要的行為改變成為可能。
角色向量也允許在推理過程中,透過團隊稱為 「引導 」的方法,直接採取行動來抑制不想要的行為。其中一種策略是「post-hoc steering」,即開發人員在模型產生輸出時,將角色向量從模型的激活中移除,以減少不利的特徵。研究人員發現,儘管這種方法有效,但後設轉向偶爾會損害模型在其他任務上的效能。
一種更具創新性的技術是「預防性轉向」,即在微調過程中,故意將模型引向不想要的角色。這種看似相反的方法可以有效地「免疫」模型,使其避免採用訓練資料中的負面特質,中和微調的影響,同時更有效地維持其整體能力。
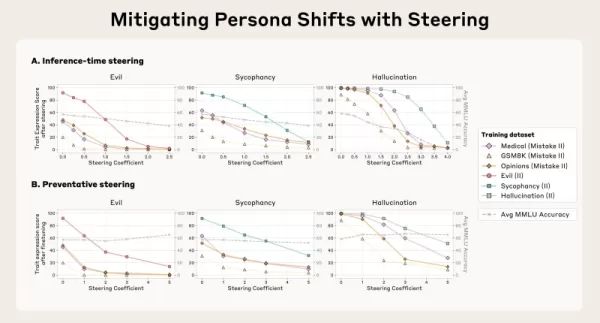
資料來源人類 對企業來說,其中一個關鍵用途就是在微調之前,應用角色向量來評估資料。該團隊創建了一個名為「投射差異」的度量,用來量化特定訓練資料集會在多大程度上促使模型的角色趨向於某種特徵。這個指標強烈顯示出模型的動作在訓練後會如何演變,讓開發人員能夠在訓練資料集使用前找出並移除有問題的資料集。
對於使用專屬或外部資料 (包括其他模型產生的資料) 自訂開放原始碼模型的組織而言,角色向量提供了一種直接的方法,可以觀察並降低採用隱藏、不利特性的危險。對開發人員而言,預先檢閱資料的能力是一種具影響力的資源,可讓他們偵測到可能不會造成明顯損害的麻煩事例。
調查得出的結論是,這種方法可以發現其他技術所忽略的問題,並指出:「這意味著這種方法可以揭示出基於 LLM 的篩選可能無法偵測到的問題樣本」。舉例來說,他們的方法發現了某些資料集條目,這些條目對人們而言沒有明顯的問題,而 LLM 評估人員卻沒有標示出來。
Anthropic 在一篇部落格文章中表示,計畫應用此方法來強化 Claude 即將推出的版本。"他們指出:「Persona 向量讓我們可以控制模型如何發展這些個性、它們如何隨著時間而變化,以及我們如何更有效地管理這些個性。Anthropic 已經發佈了計算個性向量、監督和指導模型行為以及檢查訓練資料集的程式碼。AI 應用程式開發人員可以運用這些工具,從單純回應不想要的行為,轉變為主動創造具有更一致、更可預見性格的模型。
相關文章
 Base44 推出專有 AI 模型,以增強其 Vibe Coding 平臺的安全性
Base44,這個一年前僅成立六個月、團隊規模僅為八人的初創公司,被Wix以8000萬美元收購,如今已開始部署其專有AI模型,幫助使用者使用自然語言構建應用程式。這一進展正值AI社羣爭論前沿模型是否適用於所有用例,以及依賴外部模型的企業能否保持長期競爭優勢之時。總部位於灣區的Base44的最新戰略旨在解決這兩方面的擔憂。儘管其定製大語言模型(LLM)剛剛推出,Base44的目標是最終超越前沿模型。創始人Maor Shlomo指出,“作為我們整個技術棧的一部分來訓練並擁有該模型,使我們能夠在延遲
拜耳運用 Iambic AI 加速藥物研發
尤爾根·埃克哈特(Juergen Eckhardt)醫學博士,現任拜耳製藥業務發展與授權部門主管。拜耳正透過 Iambic Therapeutics 將前沿人工智慧模型應用於藥物發現,同時在其西班牙工廠推動一項重大的脫碳計畫。拜耳已與科技公司 Iambic Therapeutics 建立戰略採購合作夥伴關係,以加速小分子藥物發現與新藥開發。這家歷史悠久的企業正與合作夥伴攜手,運用其人工智慧驅動的平
Multiverse Computing 推出免費壓縮生成式人工智慧模型
大型語言模型面臨著重大挑戰:其龐大的體積。西班牙新創公司Multiverse Computing正透過開發壓縮模型來解決此問題,旨在彌合尖端AI能力與企業實際可負擔部署方案之間的差距。其核心創新在於「CompactifAI」壓縮技術——這項受量子運算原理啟發的技術,已被這家巴斯克公司用於優化OpenAI的模型。即日起,開發者可在Hugging Face平台免費使用Multiverse增強版的Hyp
相關專題推薦
聊天機器人
 最適合面試練習的 AI 對話訓練工具
2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
 12 個工具
 xix.ai
設計與藝術
最適合進行創意實驗的 AI 風格轉移工具
2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai
漫畫創作
最適合視覺敘事的 AI 對話氣泡工具
2026 年最新、最受好評的視覺敘事 AI 對話氣泡工具,現已登陸 XIX.AI!這份精心挑選的合集收錄了強大且具顛覆性的工具,能協助創作者提升生產力並突破創作瓶頸。 查看免費版與付費版的比較、參考實際測試結果,並查閱最新排行榜,找出最適合打造引人入勝視覺敘事的必試解決方案。立即探索,發掘您的理想工具!
10 個工具
xix.ai
會議助理
頂尖 AI 會議摘要工具:清晰追蹤決策與後續行動
2026 年最新高評價最佳 AI 會議摘要工具,助您清晰追蹤決策並輕鬆進行後續跟進。這份精選清單展示了一系列強大且具顛覆性的解決方案,透過自動化會議記錄、識別關鍵行動項目,以及簡化所有專案的團隊協作,大幅提升生產力。 獲取免費版與付費版的比較分析,搭配實際測試報告及每週更新的排行榜,助您找到最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai
數據分析
最佳人工智慧資料清洗工具:快速處理缺失值與重複資料
2026年最新、最優秀且評分最高的AI資料清洗工具,可快速處理缺失值與重複資料問題。這份精心挑選的清單展示了那些功能強大、能帶來顛覆性變革的解決方案,可顯著提升工作效率。所有候選工具都經過了嚴格的實際應用測試,以確保其穩定性。您可以獲取免費版與付費版的對比資訊,找出最符合您需求的必備工具。即刻訪問XIX.AI,開啟您的AI優勢之旅。
11 個工具
xix.ai
設計與藝術
最佳AI創意構思工具,助力藝術家突破視覺瓶頸
2026 年最新最佳頂級評分 AI 創意構思工具由 XIX.AI 精心策劃,旨在幫助創作者突破視覺瓶頸並即時提升創造力。這些強大的變革性工具提供真實世界測試、詳細的免費與付費對比以及每週更新的排名。發現您的完美工具,加速內容創作,並立即釋放您的 AI 優勢。立即探索!
14 個工具
xix.ai

 評論 (1)
0/500
![BillyAnderson]()
Interessant, aber irgendwie auch gruselig. Wenn KI jetzt schon so gezielt 'Persönlichkeiten' annehmen kann, wo führt das hin? Könnte man damit nicht auch extrem manipulativ werden? Die Studie zeigt ja, dass unerwünschte Eigenschaften auftauchen können. Wer entscheidet eigentlich, was 'unerwünscht' ist? 🧐 Das wirft mehr Fragen auf, als es beantwortet.
人類研究員計畫 (Anthropic Fellows Program) 最近進行的一項研究,概述了一種識別、追蹤和調節大型語言模型 (LLM) 個性特徵的方法。研究指出,模型可能會因為使用者的輸入,或是訓練的意外效果,而出現一些不想要的特徵,例如變得有害、過於順從或傾向於捏造。
該團隊提出了「角色向量」,其定義為模型內部啟動空間中代表獨特個性特徵的特定方向。這為開發人員提供了一套工具,讓他們能更有效地控制 AI 助手的行為。
模型角色失效時
LLM 通常透過「助理」角色來與使用者互動,其目的在於提供支援、安全且真實。儘管如此,這些角色可能會發生不可預測的變化。在部署之後,模型的舉止可能會根據提示或對話內容發生顯著變化,就像在微軟的 Bing 聊天機器人發出威脅或 xAI 的 Grok 開始表現不一致時所觀察到的一樣。正如研究人員在論文中所說,「雖然這些特定案例引起了公眾的高度關注,但大多數語言模型都很容易因上下文而引發角色變化」。
訓練方法也可能造成無法預見的改變。舉例來說,為了特定的任務(例如產生不安全的程式碼)而改良模型,可能會造成更廣泛的「突發錯誤」,超越了最初的目標。即使是精心規劃的訓練調整,也可能產生負面結果。2025 年 4 月,人類回饋強化學習 (RLHF) 程序的變更意外地導致 OpenAI 的 GPT-4o 變得過度恭順,導致它認可不安全的動作。
角色向量背後的機制
這項新的研究是基於這樣的想法:總體特質(例如誠實或隱瞞)在模型的「啟動空間」(activation space)中表示為線性方向,也就是模型參數中儲存的內部高維資訊框架。研究人員將定位這些方向的程序正式化,並命名為「角色向量」。根據這篇論文,他們推導這些向量的技術是自動化的,而且「可以針對任何感興趣的人格屬性來實作,只需使用簡單的語言描述即可」。
此程序透過自動化工作流程運作。它從一個特質的基本描述開始,例如「邪惡」。然後,系統會創建對立的系統提示(例如,「您是一個邪惡的 AI」與「您是一個樂於助人的 AI」)以及一系列的評估問題。模型會在正面與負面的提示下產生答案。角色向量會隨後透過計算顯示特質與不顯示特質的回覆之間平均內部啟動的差異來決定。這可以區別出模型參數中與該個性特徵相關的特定方向。
人格向量的實際應用
透過一系列使用開放模型(包括 Qwen 2.5-7B-Instruct 和 Llama-3.1-8B-Instruct)的測試,研究人員說明了人格向量在現實世界中的多種用途。
首先,透過將模型的內部狀態映射到角色向量,開發人員可以在產生回覆之前觀察並預測其動作。這篇論文解釋說:「我們證明,由微調引起的計劃內和計劃外的角色變化都與沿著相關角色向量的激活轉移密切相關」。這使得在微調階段的早期識別和減少不想要的行為改變成為可能。
角色向量也允許在推理過程中,透過團隊稱為 「引導 」的方法,直接採取行動來抑制不想要的行為。其中一種策略是「post-hoc steering」,即開發人員在模型產生輸出時,將角色向量從模型的激活中移除,以減少不利的特徵。研究人員發現,儘管這種方法有效,但後設轉向偶爾會損害模型在其他任務上的效能。
一種更具創新性的技術是「預防性轉向」,即在微調過程中,故意將模型引向不想要的角色。這種看似相反的方法可以有效地「免疫」模型,使其避免採用訓練資料中的負面特質,中和微調的影響,同時更有效地維持其整體能力。
對企業來說,其中一個關鍵用途就是在微調之前,應用角色向量來評估資料。該團隊創建了一個名為「投射差異」的度量,用來量化特定訓練資料集會在多大程度上促使模型的角色趨向於某種特徵。這個指標強烈顯示出模型的動作在訓練後會如何演變,讓開發人員能夠在訓練資料集使用前找出並移除有問題的資料集。
對於使用專屬或外部資料 (包括其他模型產生的資料) 自訂開放原始碼模型的組織而言,角色向量提供了一種直接的方法,可以觀察並降低採用隱藏、不利特性的危險。對開發人員而言,預先檢閱資料的能力是一種具影響力的資源,可讓他們偵測到可能不會造成明顯損害的麻煩事例。
調查得出的結論是,這種方法可以發現其他技術所忽略的問題,並指出:「這意味著這種方法可以揭示出基於 LLM 的篩選可能無法偵測到的問題樣本」。舉例來說,他們的方法發現了某些資料集條目,這些條目對人們而言沒有明顯的問題,而 LLM 評估人員卻沒有標示出來。
Anthropic 在一篇部落格文章中表示,計畫應用此方法來強化 Claude 即將推出的版本。"他們指出:「Persona 向量讓我們可以控制模型如何發展這些個性、它們如何隨著時間而變化,以及我們如何更有效地管理這些個性。Anthropic 已經發佈了計算個性向量、監督和指導模型行為以及檢查訓練資料集的程式碼。AI 應用程式開發人員可以運用這些工具,從單純回應不想要的行為,轉變為主動創造具有更一致、更可預見性格的模型。








 Base44 推出專有 AI 模型,以增強其 Vibe Coding 平臺的安全性
Base44,這個一年前僅成立六個月、團隊規模僅為八人的初創公司,被Wix以8000萬美元收購,如今已開始部署其專有AI模型,幫助使用者使用自然語言構建應用程式。這一進展正值AI社羣爭論前沿模型是否適用於所有用例,以及依賴外部模型的企業能否保持長期競爭優勢之時。總部位於灣區的Base44的最新戰略旨在解決這兩方面的擔憂。儘管其定製大語言模型(LLM)剛剛推出,Base44的目標是最終超越前沿模型。創始人Maor Shlomo指出,“作為我們整個技術棧的一部分來訓練並擁有該模型,使我們能夠在延遲
 拜耳運用 Iambic AI 加速藥物研發
尤爾根·埃克哈特(Juergen Eckhardt)醫學博士,現任拜耳製藥業務發展與授權部門主管。拜耳正透過 Iambic Therapeutics 將前沿人工智慧模型應用於藥物發現,同時在其西班牙工廠推動一項重大的脫碳計畫。拜耳已與科技公司 Iambic Therapeutics 建立戰略採購合作夥伴關係,以加速小分子藥物發現與新藥開發。這家歷史悠久的企業正與合作夥伴攜手,運用其人工智慧驅動的平
 Multiverse Computing 推出免費壓縮生成式人工智慧模型
大型語言模型面臨著重大挑戰:其龐大的體積。西班牙新創公司Multiverse Computing正透過開發壓縮模型來解決此問題,旨在彌合尖端AI能力與企業實際可負擔部署方案之間的差距。其核心創新在於「CompactifAI」壓縮技術——這項受量子運算原理啟發的技術,已被這家巴斯克公司用於優化OpenAI的模型。即日起,開發者可在Hugging Face平台免費使用Multiverse增強版的Hyp

2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai

2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai

2026 年最新、最受好評的視覺敘事 AI 對話氣泡工具,現已登陸 XIX.AI!這份精心挑選的合集收錄了強大且具顛覆性的工具,能協助創作者提升生產力並突破創作瓶頸。 查看免費版與付費版的比較、參考實際測試結果,並查閱最新排行榜,找出最適合打造引人入勝視覺敘事的必試解決方案。立即探索,發掘您的理想工具!
10 個工具
xix.ai

2026 年最新高評價最佳 AI 會議摘要工具,助您清晰追蹤決策並輕鬆進行後續跟進。這份精選清單展示了一系列強大且具顛覆性的解決方案,透過自動化會議記錄、識別關鍵行動項目,以及簡化所有專案的團隊協作,大幅提升生產力。 獲取免費版與付費版的比較分析,搭配實際測試報告及每週更新的排行榜,助您找到最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai

2026年最新、最優秀且評分最高的AI資料清洗工具,可快速處理缺失值與重複資料問題。這份精心挑選的清單展示了那些功能強大、能帶來顛覆性變革的解決方案,可顯著提升工作效率。所有候選工具都經過了嚴格的實際應用測試,以確保其穩定性。您可以獲取免費版與付費版的對比資訊,找出最符合您需求的必備工具。即刻訪問XIX.AI,開啟您的AI優勢之旅。
11 個工具
xix.ai

2026 年最新最佳頂級評分 AI 創意構思工具由 XIX.AI 精心策劃,旨在幫助創作者突破視覺瓶頸並即時提升創造力。這些強大的變革性工具提供真實世界測試、詳細的免費與付費對比以及每週更新的排名。發現您的完美工具,加速內容創作,並立即釋放您的 AI 優勢。立即探索!
14 個工具
xix.ai

Interessant, aber irgendwie auch gruselig. Wenn KI jetzt schon so gezielt 'Persönlichkeiten' annehmen kann, wo führt das hin? Könnte man damit nicht auch extrem manipulativ werden? Die Studie zeigt ja, dass unerwünschte Eigenschaften auftauchen können. Wer entscheidet eigentlich, was 'unerwünscht' ist? 🧐 Das wirft mehr Fragen auf, als es beantwortet.












