


 首頁
秘密追蹤數據揭露人工智慧模型遭竊事件
一種新方法能在數秒內對ChatGPT等模型進行隱形水印處理,無需重新訓練,既不會在標準輸出中留下痕跡,又能抵禦所有實際的移除嘗試。
水印技術與「版權誘餌」的核心差異在於:無論可見或隱藏的水印,通常設計為貫穿整個資料集(如圖像資料集)的恆定存在,藉此對隨意複製行為形成持續威懾。
相對地,虛構條目是將一小段文字(通常為單詞或定義)植入龐大通用資料庫,旨在證明盜用行為。其原理在於:當整部作品遭未經授權複製(無論是直接複製或作為衍生作品基礎),原始創作者預先埋入的獨特虛構事實便能輕易揭露盜用行為。
在為大型語言模型(LLMs)與視覺語言模型(VLMs)添加水印時,輸出內容含標記的程度通常分為兩類:確保所有或多數輸出帶有明顯或隱藏水印;或嵌入可被提取用以證明盜用的「秘密標記」——該標記不會出現在模型的常規輸出中。
證據的分量
中國、義大利與新加坡研究人員的新合作正探索後者方案。此研究旨在為開源模型提供揭露機制,防止其遭未授權商業化或超出原始授權條款使用。
舉例而言,模型原始授權條款可能允許任何人獲利,只要其修改內容以同等寬鬆條款共享——但企業可能試圖將調整成果(如微調版本)私有化以獲取不公平優勢。
此領域多數研究聚焦於偵測封閉式模型、僅提供API介面的模型,或僅有優化(量化)權重可用的模型之濫用行為。由於難以取得模型架構,此類模型較難透過新論文的方法進行有效編輯。
此種聚焦於開源釋出的研究取向,或許正符合中國研究領域的預期——過去一年中國AI產出以慷慨釋出完整權重*模型著稱,其開放程度足以與限制較嚴的西方同類模型抗衡。
名為EditMark的新方法之所以突出,在於其無需透過微調添加「中毒」數據,也無需從頭開始訓練模型。
此技術具備多重優勢:首先,訓練集中任何「關鍵」數據一旦被發現並公開,攻擊者便能直接鎖定目標使其失效。但要攻擊EditMark,惡意行為者需同時掌握目標模型層級與具體方法——此情境發生機率極低。
其次,該方法快速且成本低廉,僅需數秒(而非數日或數週)即可應用於訓練模型,避免了隨模型與數據規模增長而攀升的微調高成本。
最後,相較於微調或早期編輯方法,此技術對模型正常運作造成的干擾顯著降低。
在測試中,EditMark(將含多重可能答案的數學查詢嵌入模型權重)實現了100%的提取率。
作者聲明:
「全面實驗證實EditMark在大型語言模型水印嵌入領域表現卓越。其效率驚人:僅需20秒即可嵌入32位元水印,且具備100%提取成功率(ESR)。
值得注意的是,水印嵌入耗時不到微調所需時間的1/300(微調平均耗時6,875秒),彰顯EditMark以前所未見的速度與可靠性實現高容量水印的能力。
'此外,大量實驗證實了EditMark的穩健性、隱蔽性與保真度。'
這篇新論文名為《EditMark:基於模型編輯的大型語言模型水印技術》,由中國科學技術大學、錫耶納大學以及新加坡CFAR/IHPC/A*STAR的八位作者共同發表。
方法
EditMark方法包含四大組件:生成器、編碼器、編輯器與解碼器:
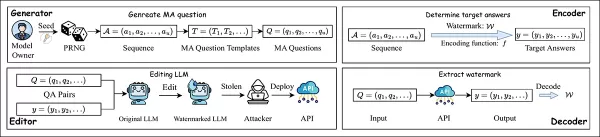
EditMark 管道透過編輯模型來嵌入水印,使其在回答特定數學問題時編碼隱藏的識別資訊。來源:https://arxiv.org/pdf/2510.16367
生成器運用偽隨機種子生成多選題數學問題;編碼器依據水印選擇答案,再透過特殊編輯流程將答案嵌入模型。當編輯後的模型被釋出或遭濫用時,可透過提出相同問題並解碼回應模式來提取水印。
編輯器接著修改模型權重,使模型在遭遇這些種子問題時,能持續輸出目標答案,將水印直接嵌入其行為模式。解碼器則透過向可疑模型輸入相同問題,將其答案轉譯回隱藏簽名,從而還原水印。
威脅模型
本文威脅模型假設水印操作處於白盒環境。儘管此情境常為安全研究之顧慮,但本方法旨在保護擁有完整存取權的模型所有者,故屬合理設定。
攻擊者取得模型後亦被視為擁有白盒存取權限,意味其可修改模型(例如透過修剪或微調)。此情境常見於自由開源軟體發布。但攻擊者無法知悉水印提取流程或架構,僅能透過實驗或洩密途徑推斷。
生成器運用 GPT‑4o 多樣化模板(如下所示),並採用偽隨機種子確保每道題目獨一無二,從而創建邏輯與事實皆正確且具多重正確答案的數學題型。此機制透過答案排列組合實現已知水印的確定性嵌入,同時最小化題目重複率以避免編輯糾纏:
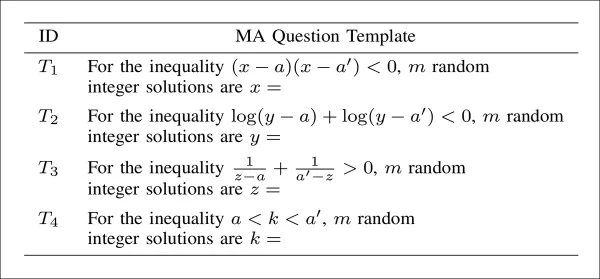
由GPT‑4o生成用於嵌入水印的題型模板,每種結構皆能從種子不等式中產出多個有效整數答案。
編碼器將每個二進位水印區段轉換為特定數學題目的解集內整數的唯一排列。運用字典排序排列理論,編碼器將每個水印區塊的十進位值映射至特定排序的答案組合,確保水印以確定性方式嵌入模型行為。
關於編輯器,原始AlphaEdit模型編輯法在嵌入水印時既缺乏精確度又缺乏韌性,常無法產生所需答案。其修改內容極易因修剪或噪聲而失效。
為解決此問題,作者開發多輪編輯策略,透過逐步調整單一多層神經網路層的模型權重,直至回應與目標答案一致。為強化編輯抗篡改能力,訓練期間注入高斯噪聲模擬攻擊:
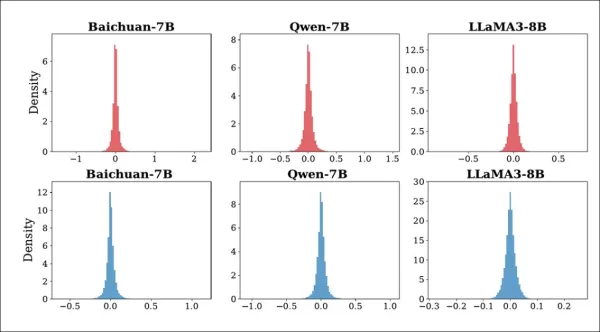
Baichuan-7B、Qwen-7B 與 LLaMA3-8B 模型在攻擊前後的 K1 變化分佈。上排顯示隨機噪聲注入效果;下排呈現模型修剪效果。所有變化值皆接近零,表明攻擊未顯著干擾模型內部運作。
當編輯準確度達標時,評分系統將終止流程;正則化機制則確保更新在多輪迭代中保持穩定。
解碼器向模型提出與嵌入水印時相同的特殊問題,再讀取其回答以推斷隱藏識別碼。由於答案模式遵循秘密規則,此識別碼無需檢視模型內部即可被恢復。
數據與測試
為評估EditMark效能,測試五款大型語言模型:GPT2-XL、GPT-J-6B、LLaMA-3-8B、百川-7B及Qwen-7B。採用前述AlphaEdit嵌入水印,以提取成功率(ESR)與嵌入時間(ET)作為評估指標。
作為基準對照,作者選用Model Watermark(後門技術)、KIMark,以及原為後門注入設計、經本專案改編的BadEdit框架。
作者分別編輯了:- LLaMA-3-8B 的第 15 層- GPT2-XL 與 GPT-J-6B 的第 17 層- Qwen-7B 與 Baichuan-7B 的第 14 層
實驗於四張 NVIDIA RTX 4090 GPU(每張配備 24GB VRAM)上執行,嵌入 32 位元、64 位元及 128 位元長度的水印。所用問題模板詳述如下:
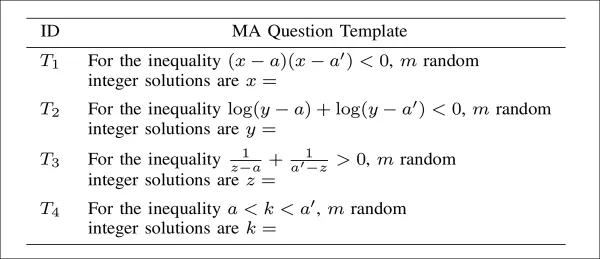
用於生成多選題(MA)水印的模板。每道題目基於不同類型的數學不等式,並在變量中插入隨機數值。模型需返回整數解的列表,答案順序用於編碼或解碼水印位元。四種模板涵蓋二次、對數、有理及區間形式,均由GPT-4o生成。
為降低隨機性影響,測試過程中針對不同水印容量應用了1至20的種子值。
研究人員最初針對大型語言模型測試嵌入水印的ESR與時間成本:
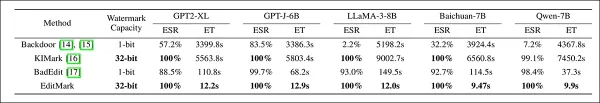
EditMark與三種既有嵌入技術於五種大型語言模型之比較。數據呈現提取成功率(ESR)與嵌入耗時(ET)(單位:秒)。EditMark不僅達成100%成功率,更將嵌入時間縮減數個數量級,無論在準確性或效率層面,皆超越所有基準技術,適用於不同規模與架構的模型。
針對這些結果,作者指出:
「[EditMark] 於所有評估的LLM中均達成100%ESR,且嵌入32位元水印耗時不到20秒。尤其在百川-7B與Qwen-7B上,平均嵌入時間低於10秒,彰顯EditMark的高效能。」
針對該方案下最高可行值的128位元水印,EditMark維持了「不可擦除性」:
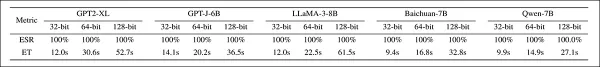
EditMark在五種語言模型中,針對32、64及128位元水印長度的提取成功率與嵌入時間。所有情況下均維持完美成功率,嵌入時間隨水印尺寸增加,但即使在128位元時仍低於一分鐘。
接著,系統在多項基準測試中驗證了水印保真度的維持能力:
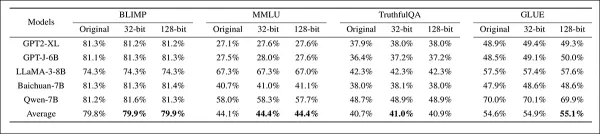
在五種模型上對四項基準測試進行水印保真度評估,比較未修改模型與分別嵌入32位元及128位元容量水印的模型。各配置下性能保持穩定,平均分數僅有輕微波動,顯示水印嵌入對基準準確度的影響有限。
EditMark 抗六種常見攻擊策略之韌性測試:模型先以五組不同種子嵌入 128 位元水印。如下圖所示,微調僅導致多數模型之提取成功率(ESR)輕微下降:
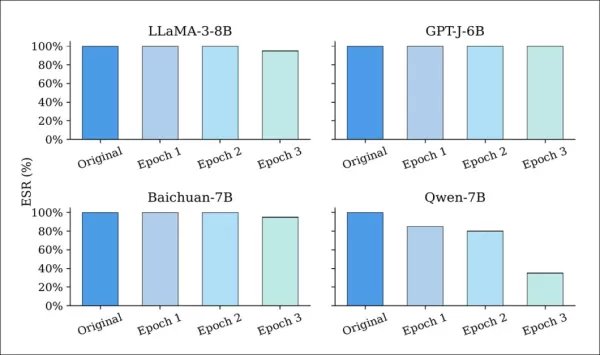
水印大型語言模型在一次至三次訓練週期前後的提取成功率(ESR)。多數模型始終保持高ESR,唯Qwen-7B顯著下滑,顯示其對參數更新的抗擾性較弱。
即使經過多輪訓練,多數模型ESR仍維持在90%以上,顯示EditMark能抵禦基於LoRA訓練的參數漂移。
量化攻擊雖降低模型精度,但多數水印仍完整保留:
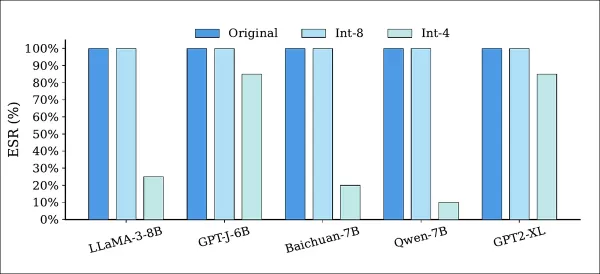
採用Int-8與Int-4精度量化前後,嵌入水印模型的提取成功率(ESR)。所有模型在Int-8量化下ESR維持不變,而Int-4量化導致部分降級,表明較低精度會削弱水印效果但無法完全消除。
如上所示,Int-8量化在所有模型中均維持100%ESR,而Int-4量化雖對ESR造成中度影響,卻導致不可接受的性能損失。
論文指出此情境對攻擊者潛力有限,因其僅能產生遭篡改但效能低落的模型。
針對噪聲與修剪攻擊的測試評估了四個基準框架:MMLU、BLIMP、TruthfulQA 及 GLUE。隨著擾動強度增加,此類攻擊導致 ESR 持續下降:
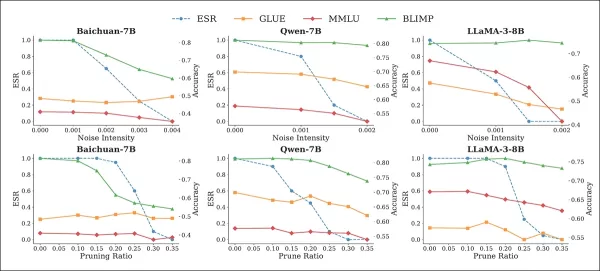
噪聲(頂排)與修剪(底排)攻擊對ESR的影響,以及嵌入水印模型的基準表現。隨著擾動增強,ESR下降,基準準確度亦隨之惡化,尤其在高噪聲強度與高修剪比率下,凸顯了水印移除與模型實用性間的(慣常)矛盾。
然而這些攻擊亦導致任務表現急遽下滑,當施加噪聲或修剪時,百川-7B在BLIMP測試中表現下滑27-31%。
同時評估了模型編輯與自適應攻擊:
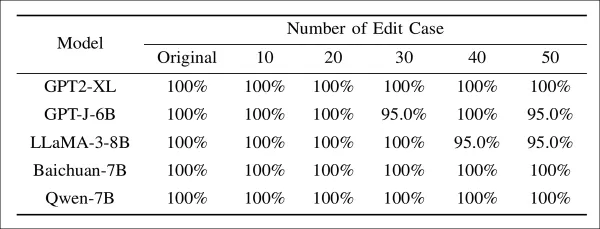
經不同程度模型編輯後,嵌入式水印模型的提取成功率。即使對已知水印層施加多達五十次編輯,所有模型的ESR仍維持在95%以上,顯示直接修改參數對水印移除效果有限。
其中EditMark即使在精準鎖定嵌入層時,仍維持超過95%的ESR。
結論
在人工智慧時代之前成效有限的數位版權管理(DRM)、隱密水印等安全措施,應用於機器學習系統時面臨諸多挑戰。當前宿主架構刻意簡化的特性,加上缺乏合適工具,使得注入的水印相對脆弱。
令人驚嘆的是,針對自由開源軟體模型分發的系統,在攻擊者具備先驗知識的情況下,仍能抵禦除極低機率攻擊情境外的所有攻擊。然而,儘管實驗中訓練後編輯造成的性能微幅下降幅度有限,仍可能使潛在採用者卻步——尤其當回歸API導向的控制模型幾乎能完全避免此類攻擊時。
* 本站曾提出,中國釋出的「開放權重」版本未必完全符合開源軟體定義,因其常隱藏關鍵數據,導致無法精確複製訓練流程。此議題引領我們深入探討人工智慧模型釋出的政治層面。
* 本站曾論述中國釋出的「開放權重」模型未必完全符合開源軟體定義,因其常隱藏關鍵數據,阻礙訓練管道的精確複製。此議題引出東西方人工智慧模型釋出背後的政治角力,但超出本文探討範圍。
初版發佈於2025年10月27日(星期一)
相關文章
 Base44 推出專有 AI 模型,以增強其 Vibe Coding 平臺的安全性
Base44,這個一年前僅成立六個月、團隊規模僅為八人的初創公司,被Wix以8000萬美元收購,如今已開始部署其專有AI模型,幫助使用者使用自然語言構建應用程式。這一進展正值AI社羣爭論前沿模型是否適用於所有用例,以及依賴外部模型的企業能否保持長期競爭優勢之時。總部位於灣區的Base44的最新戰略旨在解決這兩方面的擔憂。儘管其定製大語言模型(LLM)剛剛推出,Base44的目標是最終超越前沿模型。創始人Maor Shlomo指出,“作為我們整個技術棧的一部分來訓練並擁有該模型,使我們能夠在延遲
Multiverse Computing 推出免費壓縮生成式人工智慧模型
大型語言模型面臨著重大挑戰:其龐大的體積。西班牙新創公司Multiverse Computing正透過開發壓縮模型來解決此問題,旨在彌合尖端AI能力與企業實際可負擔部署方案之間的差距。其核心創新在於「CompactifAI」壓縮技術——這項受量子運算原理啟發的技術,已被這家巴斯克公司用於優化OpenAI的模型。即日起,開發者可在Hugging Face平台免費使用Multiverse增強版的Hyp
人工智慧系統被騙批准荒謬科學論文
最新研究揭示,人工智慧系統現已能生成虛假科學論文,且其他AI模型會誤判其為真實研究。這些偽造研究能成功繞過過往有效的檢測方法,凸顯研究生態系統面臨崩潰風險——可能陷入機器人欺騙機器人的循環漩渦。 諷刺的是,正處於AI創新前沿的學術研究領域,如今卻正面臨主要由AI引發的可信度危機。自約四年前機器學習的潛在影響顯現以來,其已深刻重塑了研究、投稿與同行評審流程。最新爭議涉及低品質問卷調查論文的批量生產。
相關專題推薦
數據分析
 用於收入看板、轉化漏斗分析及產品指標分析的 AI SQL 助手
2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
 9 個工具
 xix.ai
音樂創作
最佳用於歌曲草稿的 AI 旋律創作工具
2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai
聊天機器人
最適合面試練習的 AI 對話訓練工具
2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai
設計與藝術
最適合進行創意實驗的 AI 風格轉移工具
2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai
漫畫創作
最適合視覺敘事的 AI 對話氣泡工具
2026 年最新、最受好評的視覺敘事 AI 對話氣泡工具,現已登陸 XIX.AI!這份精心挑選的合集收錄了強大且具顛覆性的工具,能協助創作者提升生產力並突破創作瓶頸。 查看免費版與付費版的比較、參考實際測試結果,並查閱最新排行榜,找出最適合打造引人入勝視覺敘事的必試解決方案。立即探索,發掘您的理想工具!
10 個工具
xix.ai
會議助理
頂尖 AI 會議摘要工具:清晰追蹤決策與後續行動
2026 年最新高評價最佳 AI 會議摘要工具,助您清晰追蹤決策並輕鬆進行後續跟進。這份精選清單展示了一系列強大且具顛覆性的解決方案,透過自動化會議記錄、識別關鍵行動項目,以及簡化所有專案的團隊協作,大幅提升生產力。 獲取免費版與付費版的比較分析,搭配實際測試報告及每週更新的排行榜,助您找到最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai

 評論 (3)
0/500
![JackSanchez]()
這技術真有意思!能在不重訓練的情況下給AI模型加水印,還幾乎無法移除,感覺對保護原創者權益很有幫助。不過會不會反而被濫用來追蹤用戶啊?有點擔心隱私問題⋯⋯😅
![BenJackson]()
Wow, dieses Thema mit unsichtbaren Wasserzeichen für KI-Modelle klingt wie etwas aus einem Spionagefilm! 🤯 Der Unterschied zu ‚Copyright-Baiting‘ ist echt wichtig – es geht ja um langfristigen Schutz, nicht nur ums Fangen. Aber was, wenn dieses Werkzeug selbst missbraucht wird? Irgendwie bemerkenswert, was technisch möglich ist, und ein bisschen gruselig zugleich.
![AnthonyPerez]()
Increíble técnica, pero ¿qué tan seguro es que no afecte el rendimiento del modelo en tareas reales? 🤔 Me preocupa que estas medidas puedan usarse también para restringir el acceso a IA de código abierto. ¿Y si una empresa alega falsamente protección de marca de agua? ¡El debate ético apenas comienza!
一種新方法能在數秒內對ChatGPT等模型進行隱形水印處理,無需重新訓練,既不會在標準輸出中留下痕跡,又能抵禦所有實際的移除嘗試。
水印技術與「版權誘餌」的核心差異在於:無論可見或隱藏的水印,通常設計為貫穿整個資料集(如圖像資料集)的恆定存在,藉此對隨意複製行為形成持續威懾。
相對地,虛構條目是將一小段文字(通常為單詞或定義)植入龐大通用資料庫,旨在證明盜用行為。其原理在於:當整部作品遭未經授權複製(無論是直接複製或作為衍生作品基礎),原始創作者預先埋入的獨特虛構事實便能輕易揭露盜用行為。
在為大型語言模型(LLMs)與視覺語言模型(VLMs)添加水印時,輸出內容含標記的程度通常分為兩類:確保所有或多數輸出帶有明顯或隱藏水印;或嵌入可被提取用以證明盜用的「秘密標記」——該標記不會出現在模型的常規輸出中。
證據的分量
中國、義大利與新加坡研究人員的新合作正探索後者方案。此研究旨在為開源模型提供揭露機制,防止其遭未授權商業化或超出原始授權條款使用。
舉例而言,模型原始授權條款可能允許任何人獲利,只要其修改內容以同等寬鬆條款共享——但企業可能試圖將調整成果(如微調版本)私有化以獲取不公平優勢。
此領域多數研究聚焦於偵測封閉式模型、僅提供API介面的模型,或僅有優化(量化)權重可用的模型之濫用行為。由於難以取得模型架構,此類模型較難透過新論文的方法進行有效編輯。
此種聚焦於開源釋出的研究取向,或許正符合中國研究領域的預期——過去一年中國AI產出以慷慨釋出完整權重*模型著稱,其開放程度足以與限制較嚴的西方同類模型抗衡。
名為EditMark的新方法之所以突出,在於其無需透過微調添加「中毒」數據,也無需從頭開始訓練模型。
此技術具備多重優勢:首先,訓練集中任何「關鍵」數據一旦被發現並公開,攻擊者便能直接鎖定目標使其失效。但要攻擊EditMark,惡意行為者需同時掌握目標模型層級與具體方法——此情境發生機率極低。
其次,該方法快速且成本低廉,僅需數秒(而非數日或數週)即可應用於訓練模型,避免了隨模型與數據規模增長而攀升的微調高成本。
最後,相較於微調或早期編輯方法,此技術對模型正常運作造成的干擾顯著降低。
在測試中,EditMark(將含多重可能答案的數學查詢嵌入模型權重)實現了100%的提取率。
作者聲明:
「全面實驗證實EditMark在大型語言模型水印嵌入領域表現卓越。其效率驚人:僅需20秒即可嵌入32位元水印,且具備100%提取成功率(ESR)。
值得注意的是,水印嵌入耗時不到微調所需時間的1/300(微調平均耗時6,875秒),彰顯EditMark以前所未見的速度與可靠性實現高容量水印的能力。
'此外,大量實驗證實了EditMark的穩健性、隱蔽性與保真度。'
這篇新論文名為《EditMark:基於模型編輯的大型語言模型水印技術》,由中國科學技術大學、錫耶納大學以及新加坡CFAR/IHPC/A*STAR的八位作者共同發表。
方法
EditMark方法包含四大組件:生成器、編碼器、編輯器與解碼器:

EditMark 管道透過編輯模型來嵌入水印,使其在回答特定數學問題時編碼隱藏的識別資訊。來源:https://arxiv.org/pdf/2510.16367
生成器運用偽隨機種子生成多選題數學問題;編碼器依據水印選擇答案,再透過特殊編輯流程將答案嵌入模型。當編輯後的模型被釋出或遭濫用時,可透過提出相同問題並解碼回應模式來提取水印。
編輯器接著修改模型權重,使模型在遭遇這些種子問題時,能持續輸出目標答案,將水印直接嵌入其行為模式。解碼器則透過向可疑模型輸入相同問題,將其答案轉譯回隱藏簽名,從而還原水印。
威脅模型
本文威脅模型假設水印操作處於白盒環境。儘管此情境常為安全研究之顧慮,但本方法旨在保護擁有完整存取權的模型所有者,故屬合理設定。
攻擊者取得模型後亦被視為擁有白盒存取權限,意味其可修改模型(例如透過修剪或微調)。此情境常見於自由開源軟體發布。但攻擊者無法知悉水印提取流程或架構,僅能透過實驗或洩密途徑推斷。
生成器運用 GPT‑4o 多樣化模板(如下所示),並採用偽隨機種子確保每道題目獨一無二,從而創建邏輯與事實皆正確且具多重正確答案的數學題型。此機制透過答案排列組合實現已知水印的確定性嵌入,同時最小化題目重複率以避免編輯糾纏:

由GPT‑4o生成用於嵌入水印的題型模板,每種結構皆能從種子不等式中產出多個有效整數答案。
編碼器將每個二進位水印區段轉換為特定數學題目的解集內整數的唯一排列。運用字典排序排列理論,編碼器將每個水印區塊的十進位值映射至特定排序的答案組合,確保水印以確定性方式嵌入模型行為。
關於編輯器,原始AlphaEdit模型編輯法在嵌入水印時既缺乏精確度又缺乏韌性,常無法產生所需答案。其修改內容極易因修剪或噪聲而失效。
為解決此問題,作者開發多輪編輯策略,透過逐步調整單一多層神經網路層的模型權重,直至回應與目標答案一致。為強化編輯抗篡改能力,訓練期間注入高斯噪聲模擬攻擊:

Baichuan-7B、Qwen-7B 與 LLaMA3-8B 模型在攻擊前後的 K1 變化分佈。上排顯示隨機噪聲注入效果;下排呈現模型修剪效果。所有變化值皆接近零,表明攻擊未顯著干擾模型內部運作。
當編輯準確度達標時,評分系統將終止流程;正則化機制則確保更新在多輪迭代中保持穩定。
解碼器向模型提出與嵌入水印時相同的特殊問題,再讀取其回答以推斷隱藏識別碼。由於答案模式遵循秘密規則,此識別碼無需檢視模型內部即可被恢復。
數據與測試
為評估EditMark效能,測試五款大型語言模型:GPT2-XL、GPT-J-6B、LLaMA-3-8B、百川-7B及Qwen-7B。採用前述AlphaEdit嵌入水印,以提取成功率(ESR)與嵌入時間(ET)作為評估指標。
作為基準對照,作者選用Model Watermark(後門技術)、KIMark,以及原為後門注入設計、經本專案改編的BadEdit框架。
作者分別編輯了:- LLaMA-3-8B 的第 15 層- GPT2-XL 與 GPT-J-6B 的第 17 層- Qwen-7B 與 Baichuan-7B 的第 14 層
實驗於四張 NVIDIA RTX 4090 GPU(每張配備 24GB VRAM)上執行,嵌入 32 位元、64 位元及 128 位元長度的水印。所用問題模板詳述如下:

用於生成多選題(MA)水印的模板。每道題目基於不同類型的數學不等式,並在變量中插入隨機數值。模型需返回整數解的列表,答案順序用於編碼或解碼水印位元。四種模板涵蓋二次、對數、有理及區間形式,均由GPT-4o生成。
為降低隨機性影響,測試過程中針對不同水印容量應用了1至20的種子值。
研究人員最初針對大型語言模型測試嵌入水印的ESR與時間成本:

EditMark與三種既有嵌入技術於五種大型語言模型之比較。數據呈現提取成功率(ESR)與嵌入耗時(ET)(單位:秒)。EditMark不僅達成100%成功率,更將嵌入時間縮減數個數量級,無論在準確性或效率層面,皆超越所有基準技術,適用於不同規模與架構的模型。
針對這些結果,作者指出:
「[EditMark] 於所有評估的LLM中均達成100%ESR,且嵌入32位元水印耗時不到20秒。尤其在百川-7B與Qwen-7B上,平均嵌入時間低於10秒,彰顯EditMark的高效能。」
針對該方案下最高可行值的128位元水印,EditMark維持了「不可擦除性」:

EditMark在五種語言模型中,針對32、64及128位元水印長度的提取成功率與嵌入時間。所有情況下均維持完美成功率,嵌入時間隨水印尺寸增加,但即使在128位元時仍低於一分鐘。
接著,系統在多項基準測試中驗證了水印保真度的維持能力:

在五種模型上對四項基準測試進行水印保真度評估,比較未修改模型與分別嵌入32位元及128位元容量水印的模型。各配置下性能保持穩定,平均分數僅有輕微波動,顯示水印嵌入對基準準確度的影響有限。
EditMark 抗六種常見攻擊策略之韌性測試:模型先以五組不同種子嵌入 128 位元水印。如下圖所示,微調僅導致多數模型之提取成功率(ESR)輕微下降:

水印大型語言模型在一次至三次訓練週期前後的提取成功率(ESR)。多數模型始終保持高ESR,唯Qwen-7B顯著下滑,顯示其對參數更新的抗擾性較弱。
即使經過多輪訓練,多數模型ESR仍維持在90%以上,顯示EditMark能抵禦基於LoRA訓練的參數漂移。
量化攻擊雖降低模型精度,但多數水印仍完整保留:

採用Int-8與Int-4精度量化前後,嵌入水印模型的提取成功率(ESR)。所有模型在Int-8量化下ESR維持不變,而Int-4量化導致部分降級,表明較低精度會削弱水印效果但無法完全消除。
如上所示,Int-8量化在所有模型中均維持100%ESR,而Int-4量化雖對ESR造成中度影響,卻導致不可接受的性能損失。
論文指出此情境對攻擊者潛力有限,因其僅能產生遭篡改但效能低落的模型。
針對噪聲與修剪攻擊的測試評估了四個基準框架:MMLU、BLIMP、TruthfulQA 及 GLUE。隨著擾動強度增加,此類攻擊導致 ESR 持續下降:

噪聲(頂排)與修剪(底排)攻擊對ESR的影響,以及嵌入水印模型的基準表現。隨著擾動增強,ESR下降,基準準確度亦隨之惡化,尤其在高噪聲強度與高修剪比率下,凸顯了水印移除與模型實用性間的(慣常)矛盾。
然而這些攻擊亦導致任務表現急遽下滑,當施加噪聲或修剪時,百川-7B在BLIMP測試中表現下滑27-31%。
同時評估了模型編輯與自適應攻擊:

經不同程度模型編輯後,嵌入式水印模型的提取成功率。即使對已知水印層施加多達五十次編輯,所有模型的ESR仍維持在95%以上,顯示直接修改參數對水印移除效果有限。
其中EditMark即使在精準鎖定嵌入層時,仍維持超過95%的ESR。
結論
在人工智慧時代之前成效有限的數位版權管理(DRM)、隱密水印等安全措施,應用於機器學習系統時面臨諸多挑戰。當前宿主架構刻意簡化的特性,加上缺乏合適工具,使得注入的水印相對脆弱。
令人驚嘆的是,針對自由開源軟體模型分發的系統,在攻擊者具備先驗知識的情況下,仍能抵禦除極低機率攻擊情境外的所有攻擊。然而,儘管實驗中訓練後編輯造成的性能微幅下降幅度有限,仍可能使潛在採用者卻步——尤其當回歸API導向的控制模型幾乎能完全避免此類攻擊時。
* 本站曾提出,中國釋出的「開放權重」版本未必完全符合開源軟體定義,因其常隱藏關鍵數據,導致無法精確複製訓練流程。此議題引領我們深入探討人工智慧模型釋出的政治層面。
* 本站曾論述中國釋出的「開放權重」模型未必完全符合開源軟體定義,因其常隱藏關鍵數據,阻礙訓練管道的精確複製。此議題引出東西方人工智慧模型釋出背後的政治角力,但超出本文探討範圍。
初版發佈於2025年10月27日(星期一)








 Base44 推出專有 AI 模型,以增強其 Vibe Coding 平臺的安全性
Base44,這個一年前僅成立六個月、團隊規模僅為八人的初創公司,被Wix以8000萬美元收購,如今已開始部署其專有AI模型,幫助使用者使用自然語言構建應用程式。這一進展正值AI社羣爭論前沿模型是否適用於所有用例,以及依賴外部模型的企業能否保持長期競爭優勢之時。總部位於灣區的Base44的最新戰略旨在解決這兩方面的擔憂。儘管其定製大語言模型(LLM)剛剛推出,Base44的目標是最終超越前沿模型。創始人Maor Shlomo指出,“作為我們整個技術棧的一部分來訓練並擁有該模型,使我們能夠在延遲
 Multiverse Computing 推出免費壓縮生成式人工智慧模型
大型語言模型面臨著重大挑戰:其龐大的體積。西班牙新創公司Multiverse Computing正透過開發壓縮模型來解決此問題,旨在彌合尖端AI能力與企業實際可負擔部署方案之間的差距。其核心創新在於「CompactifAI」壓縮技術——這項受量子運算原理啟發的技術,已被這家巴斯克公司用於優化OpenAI的模型。即日起,開發者可在Hugging Face平台免費使用Multiverse增強版的Hyp
 人工智慧系統被騙批准荒謬科學論文
最新研究揭示,人工智慧系統現已能生成虛假科學論文,且其他AI模型會誤判其為真實研究。這些偽造研究能成功繞過過往有效的檢測方法,凸顯研究生態系統面臨崩潰風險——可能陷入機器人欺騙機器人的循環漩渦。 諷刺的是,正處於AI創新前沿的學術研究領域,如今卻正面臨主要由AI引發的可信度危機。自約四年前機器學習的潛在影響顯現以來,其已深刻重塑了研究、投稿與同行評審流程。最新爭議涉及低品質問卷調查論文的批量生產。

2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai

2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai

2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai

2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai

2026 年最新、最受好評的視覺敘事 AI 對話氣泡工具,現已登陸 XIX.AI!這份精心挑選的合集收錄了強大且具顛覆性的工具,能協助創作者提升生產力並突破創作瓶頸。 查看免費版與付費版的比較、參考實際測試結果,並查閱最新排行榜,找出最適合打造引人入勝視覺敘事的必試解決方案。立即探索,發掘您的理想工具!
10 個工具
xix.ai

2026 年最新高評價最佳 AI 會議摘要工具,助您清晰追蹤決策並輕鬆進行後續跟進。這份精選清單展示了一系列強大且具顛覆性的解決方案,透過自動化會議記錄、識別關鍵行動項目,以及簡化所有專案的團隊協作,大幅提升生產力。 獲取免費版與付費版的比較分析,搭配實際測試報告及每週更新的排行榜,助您找到最合適的工具。立即探索,釋放您的 AI 優勢!
9 個工具
xix.ai

這技術真有意思!能在不重訓練的情況下給AI模型加水印,還幾乎無法移除,感覺對保護原創者權益很有幫助。不過會不會反而被濫用來追蹤用戶啊?有點擔心隱私問題⋯⋯😅
Wow, dieses Thema mit unsichtbaren Wasserzeichen für KI-Modelle klingt wie etwas aus einem Spionagefilm! 🤯 Der Unterschied zu ‚Copyright-Baiting‘ ist echt wichtig – es geht ja um langfristigen Schutz, nicht nur ums Fangen. Aber was, wenn dieses Werkzeug selbst missbraucht wird? Irgendwie bemerkenswert, was technisch möglich ist, und ein bisschen gruselig zugleich.
Increíble técnica, pero ¿qué tan seguro es que no afecte el rendimiento del modelo en tareas reales? 🤔 Me preocupa que estas medidas puedan usarse también para restringir el acceso a IA de código abierto. ¿Y si una empresa alega falsamente protección de marca de agua? ¡El debate ético apenas comienza!












