Модели зрения, такие как ChatGPT, часто придумывают элементы, отсутствующие на изображении. Новый подход уменьшает эти ошибки, генерируя преувеличенные версии собственных галлюцинаций модели из ее подписей, а затем побуждая ее к пересмотру. Этот метод не требует переобучения или дополнительных данных, что делает его широко применимым к различным моделям и архитектурам.
В новом исследовании, проведенном в Китае, решается сложная проблема галлюцинаций в созданных ИИ изображениях и видео - деталей, которые явно противоречат подсказке пользователя.
Процесс начинается стандартно: модель описывает изображение. Затем это описание передается в модель преобразования текста в изображение для создания нового изображения - любыедополнительные объекты или особенности в этой реконструкции напрямую свидетельствуют о первоначальных галлюцинациях модели. Сравнивая исходное и созданное изображения, система направляет модель, чтобы она не повторяла эти ошибки в будущих попытках.
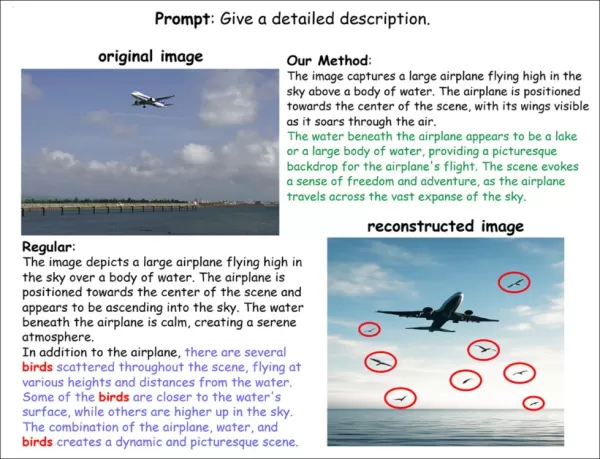
На этой схеме показано, как новая техника обнаруживает и сводит к минимуму галлюцинации. Стандартная модель неверно добавляет птиц в описание изображения, а реконструированная версия вставляет их визуально (выделено красным). Новый метод позволяет избежать этих выдумок, сохраняя точность описания. Источник: https://arxiv.org/pdf/2509.21997
Метод начинается с того, что модель описывает реальные изображения, иногда включая в них объекты или детали, которых на самом деле нет. Эти неточные подписи генерируют синтетические изображения, которые подчеркивают ошибки. Сравнивая реальные и синтетические изображения, система выявляет внутренние закономерности, которые приводят к вымышленному содержанию.
Как только эти ошибки распознаны, они сохраняются для дальнейшего использования. При создании титров к новому изображению система корректирует внутренние сигналы модели, направляя их в сторону от известных триггеров галлюцинаций. Эта коррекция происходит за один проход без дополнительных данных, переобучения или генерации изображений во время тестирования.
Проблема запутанности
В приведенном в статье примере "запутанность", вероятно, объясняет, почему птицы были добавлены к изображению, на котором их не было.
Запутанность возникает, когда модель прочно связывает определенные понятия, потому что они часто встречаются вместе в ее обучающих данных. В данном случае модель, возможно, часто встречала самолеты с птицами, создавая ассоциацию, которая ошибочно повлияла на надпись.
Хотя более раннее завершение обучения может уменьшить запутанность (повышая гибкость модели), оно также снижает концептуальную детализацию и разрешение. Разработчики сталкиваются с постоянным компромиссом: отдать предпочтение гибкой, распутанной модели или более генеративной, склонной к ассоциативным галлюцинациям?
В идеале подписи к исходным изображениям должны содержать описание каждого присутствующего объекта, позволяя модели хранить их в виде отдельных, расчлененных записей. Однако SEO-практика создания подписей и крупномасштабный веб-скрепинг, часто используемые для обучения мощных генеративных моделей, часто не соответствуют этому стандарту.
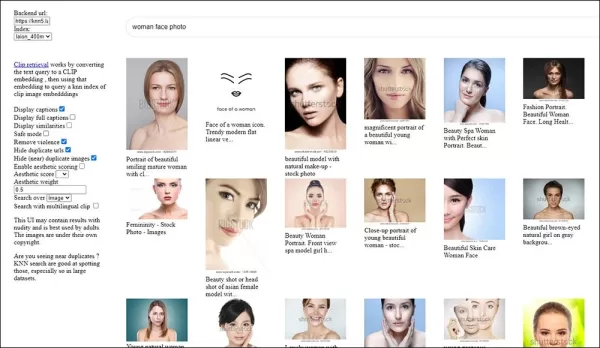
Слабые подписи снижают ценность изображений LAION для обучения моделей типа Stable Diffusion. Надписи часто бывают неглубокими, расплывчатыми или SEO-ориентированными, а не описательными, что препятствует способности модели изучать детальные визуальные концепции, такие как черты лица. (Первоисточником был сайт https://rom1504.github.io/, ныне не существующий).
Поскольку фундаментальное исправление нецелесообразно, обходные пути для уменьшения галлюцинаций в LLM и VLM стали важным направлением исследований. Новый китайский метод, протестированный в различных архитектурах и условиях, показывает перспективность в сдерживании "загрязнения галлюцинациями".
Авторы заявляют:
"Обширные эксперименты на различных бенчмарках показывают, что наш метод значительно уменьшает количество галлюцинаций на уровне объектов, атрибутов и отношений, сохраняя при этом запоминание и богатство подписей".
Работа под названием Exposing Hallucinations To Suppress Them: VLMs Representation Editing With Generative Anchors написана исследователями из Университета науки и технологий Китая и Нанкинского университета.
Принцип работы метода
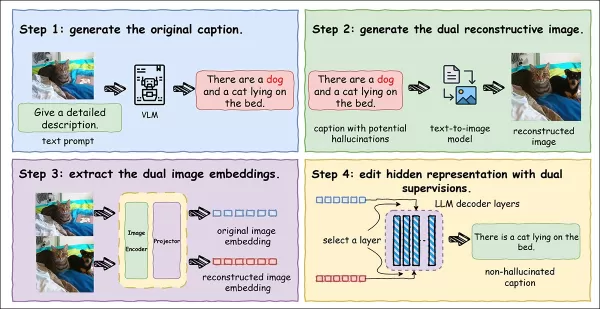
Исследователи разработали сквозной конвейер для выявления и подавления галлюцинаций в титрах:
Полная иллюстрация конвейера. Модель языка зрения генерирует подпись к входному изображению, потенциально включающую галлюцинации. Эта надпись используется для создания реконструированного изображения с помощью модели преобразования текста в изображение, что делает ошибки видимыми. Вкрапления из обоих изображений направляют внутренние корректировки, помогая модели уменьшить количество придуманных деталей без потери качества подписи.
Модель на языке зрения сначала создает подпись к реальному изображению, возможно, придумывая объекты или отношения. Затем подпись генерирует реконструированное изображение, выявляя любые выдумки в виде визуальных расхождений. Сравнение двух изображений превращает тонкие текстовые ошибки в измеримые и корректируемые сигналы.
Чтобы предотвратить выдумки, система сравнивает оригинальное изображение (надежный эталон) с реконструированным (выделяя ошибки). Каждое из них преобразуется в компактное вложение. Корректируя внутренние представления таким образом, чтобы они более точно соответствовали оригиналу и расходились с реконструкцией, модель самокорректируется полностью самоконтролируемым образом.
В статье поясняется:
"Галлюцинации в МЛМ по своей сути трудно обнаружить, поскольку они хорошо сформированы с лингвистической точки зрения и часто неотличимы от достоверных описаний на уровне текста. Расхождение заключается не в языковом правдоподобии, а в несоответствии с визуальными свидетельствами, к которым сама модель обычно нечувствительна".
Чтобы решить эту проблему, мы вводим механизм воздействия на галлюцинации, который использует генеративную реконструкцию для преобразования неявных несоответствий в явные и наблюдаемые сигналы".
Используя модель преобразования текста в изображение FLUX.1-dev, система воссоздает изображение по надписи, преувеличивая все ложные детали. Эти усиленные ошибки помогают модели распознать и исправить свои ошибки.
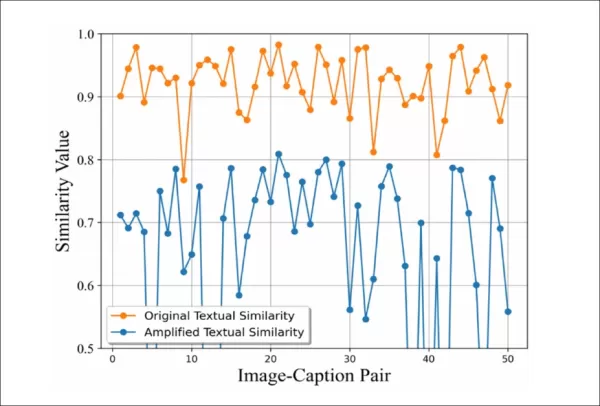
Для проверки подхода исследователи вводили галлюцинации в подписи, генерировали реконструированные изображения, а затем переснимали их с помощью LLaVA. Они измерили семантическое сходство между оригинальными и галлюцинаторными подписями:
Механизм усиления галлюцинаций визуализирует тонкие ошибки. Каждая точка показывает сходство подписей для пары "изображение - подпись". Оранжевая линия (прямое сравнение) остается высокой, маскируя ошибки; синяя линия (после реконструкции) резко падает, выявляя скрытые галлюцинации как различимые семантические маркеры.
Сходство значительно уменьшилось после реконструкции, демонстрируя способность метода выявлять тонкие ошибки.
Данные и тестирование
Эффективность метода была подтверждена с помощью трех эталонов: Оценка галлюцинаций с помощью релевантности изображения (CHAIR); Оценка MLLM (MME); и Оценка зондирования объектов на основе пулинга (POPE).
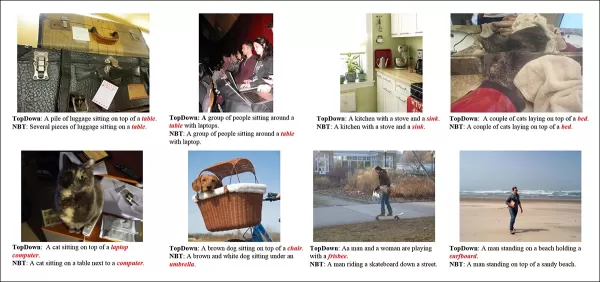
Из доклада CHAIR: примеры галлюцинаций, созданных системами субтитров TopDown и NBT, которые придумывают такие элементы, как ноутбуки, раковины или доски для серфинга, не присутствующие на изображении. Источник: https://arxiv.org/pdf/1809.02156
Стандартные показатели, такие как количество галлюцинаций или запоминание, могут вводить в заблуждение - модели могут избегать ошибок, создавая нечеткие подписи. Чтобы сбалансировать точность и полноту, была использована комбинированная метрика Hallucination and Recall (HAR@β), оценивающая подписи по обоим факторам с регулируемым весом.
В POPE оценивались контекстно-чувствительные объектные галлюцинации, а в MME - галлюцинации на уровне атрибутов, причем оба задания были типа "да/нет".
В тестах использовались модель Flux и LLaVA-v1.5-7B на наборах данных, включающих Microsoft COCO, A-OKVQA и GQA. Латентное редактирование было нацелено на второй слой моделей, с одинаковыми гиперпараметрами и температурой во всех тестах.
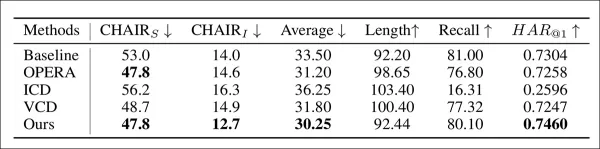
Первые результаты CHAIR приведены ниже*:
Результаты теста CHAIR на смягчение галлюцинаций, оцененные с помощью нескольких метрик.
Авторы отмечают:
'[Наш метод стабильно превосходит другие базовые методы как в CHAIRS, так и в CHAIRI, демонстрируя свою превосходную эффективность в подавлении галлюцинаций. При этом, хотя почти все методы неизбежно снижают запоминание при подавлении галлюцинаций, что отражает компромисс между верностью и информативностью, наш подход достигает наименьшего снижения.
Это свидетельствует о том, что наш метод охватывает широкий спектр истинных объектов. В метрике HAR@β наш метод получил наивысший балл, что подчеркивает его способность уменьшать количество галлюцинаций при сохранении охвата".
Высокие результаты объясняются двойным супервизором: усилением чистой семантики исходного изображения и подавлением вводящих в заблуждение сигналов реконструкции. Нацеливаясь только на направления, связанные с галлюцинациями, система исправляет ошибки без потери детализации.
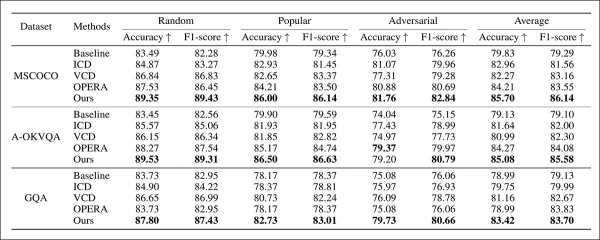
Сравнение производительности в бенчмарке POPE на различных конфигурациях и наборах данных.
Что касается результатов POPE, то в статье говорится следующее:
"Можно заметить, что наш метод стабильно достигает наилучшей производительности при любых настройках. В частности, наш метод может достичь в среднем +5,95% точности и +6,85% F1, значительно превосходя другие необучаемые подходы".
Таким образом, эти результаты показывают, что наш метод обеспечивает надежное и обобщенное решение на разных уровнях сложности".
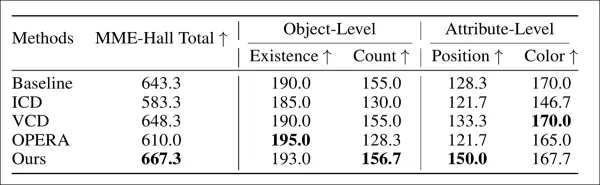
Сравнение результатов третьего раунда тестирования на MME.
Заключительный основной тест проводился на MME, результаты которого приведены выше. Однако в статье упоминается метод "OPERA" без определения в основном тексте и в приложении. Хотя авторы заявляют о высокой производительности MME, отсутствие подробностей о методе заставляет с осторожностью отнестись к интерпретации этих результатов.
2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
При нажатии на «Принять все файлы cookie» вы соглашаетесь на хранение файлов cookie на вашем устройстве для улучшения навигации по сайту, анализа использования сайта и поддержки наших маркетинговых усилий.Политика конфиденциальности Уведомление
При посещении любого веб-сайта он может хранить или получать информацию в вашем браузере, главным образом в виде файлов cookie. Эта информация может относиться к вам, вашим предпочтениям или вашему устройству и в основном используется для того, чтобы сайт работал так, как вы ожидаете. Эта информация обычно не идентифицирует вас напрямую, но может предоставить вам более персонализированный веб-опыт. Поскольку мы уважаем ваше право на конфиденциальность, вы можете отказаться от разрешения определенных типов файлов cookie. Нажмите на разные заголовки категорий, чтобы узнать больше и изменить наши параметры по умолчанию. Однако блокировка некоторых типов файлов cookie может повлиять на ваше восприятие сайта и предоставляемые нами услуги. Политика конфиденциальностиЗаявление
Управление предпочтениями
Строго необходимые файлы cookie
Всегда активен
Эти файлы cookie необходимы для работы веб-сайта и не могут быть отключены в наших системах. Обычно они устанавливаются только в ответ на ваши действия, которые являются запросом на предоставление услуг, например, настройка предпочтений конфиденциальности, вход в систему или заполнение форм. Вы можете настроить браузер на блокировку этих файлов cookie или оповещение о них, но тогда некоторые части сайта не будут работать. Эти файлы cookie не хранят никакой персональной информации, позволяющей идентифицировать вас.



 Дом
 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
 Инструменты разделения стемов с использованием ИИ для создания ремиксов, подготовки образцов звука и формирования финальных версий караоке.
 8 инструментов
 xix.ai
Анализ данных

 Комментарии (0)








 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
 OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства


















