Modelos de visão como o ChatGPT frequentemente inventam elementos que faltam em uma imagem. Uma nova abordagem reduz esses erros gerando versões exageradas dos detalhes alucinados do próprio modelo a partir de suas legendas e, em seguida, solicitando a revisão. Essa técnica não requer retreinamento ou dados adicionais, o que a torna amplamente aplicável a vários modelos e arquiteturas.
Um novo estudo da China aborda o problema persistente das alucinações em imagens e vídeos gerados por IA - detalhes que contradizem claramente a solicitação do usuário.
O processo começa de forma convencional: o modelo descreve uma imagem. Essa legenda é então inserida em um modelo de texto para imagem para produzir uma nova imagem - qualquerobjeto ou recurso extra nessa reconstrução revela diretamente as alucinações iniciais do modelo. Ao comparar as imagens originais e as geradas, o sistema orienta o modelo para evitar a repetição desses erros em tentativas futuras.
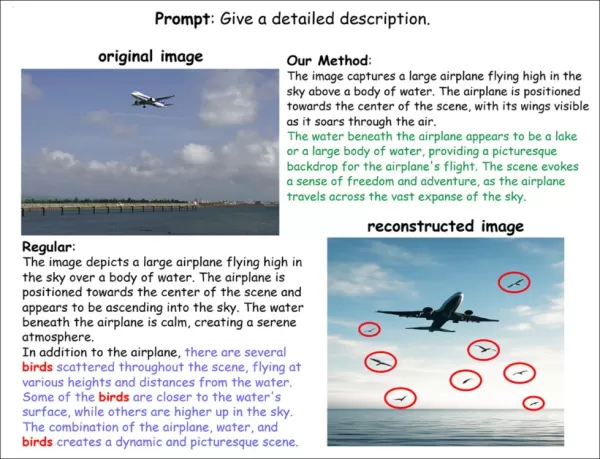
Este diagrama mostra como a nova técnica detecta e minimiza as alucinações de legendas. Um modelo padrão adiciona incorretamente pássaros à descrição de uma imagem, e a versão reconstruída os insere visualmente (destacados em vermelho). O novo método evita essas fabricações e mantém a precisão descritiva. Fonte: https://arxiv.org/pdf/2509.21997
O método começa fazendo com que o modelo descreva imagens reais, às vezes incluindo objetos ou detalhes que não estão realmente presentes. Essas legendas imprecisas geram imagens sintéticas que destacam os erros. Ao comparar imagens reais e sintéticas, o sistema identifica padrões internos que levam ao conteúdo inventado.
Quando esses padrões de erro são reconhecidos, eles são armazenados para uso futuro. Ao legendar uma nova imagem, o sistema ajusta os sinais internos do modelo, afastando-o dos gatilhos de alucinação conhecidos. Essa correção ocorre em uma única passagem, sem dados extras, retreinamento ou geração de imagens durante o teste.
O desafio do entrelaçamento
No exemplo do artigo, o "emaranhamento" provavelmente explica por que os pássaros foram adicionados a uma imagem que não continha nenhum.
O entrelaçamento ocorre quando um modelo vincula fortemente determinados conceitos porque eles aparecem frequentemente juntos em seus dados de treinamento. Nesse caso, o modelo pode ter encontrado com frequência aviões com pássaros, criando uma associação que influencia erroneamente a legenda.
Embora terminar o treinamento mais cedo possa reduzir o emaranhamento (aumentando a flexibilidade do modelo), isso também diminui os detalhes conceituais e a resolução. Os desenvolvedores enfrentam um dilema persistente: priorizar um modelo flexível e desemaranhado ou um modelo mais generativo, propenso a alucinações associadas?
O ideal seria que as legendas das imagens de origem discriminassem todos os objetos presentes, permitindo que o modelo os armazenasse como entradas separadas e desvinculadas. No entanto, as práticas de legendagem orientadas por SEO e a raspagem da Web em larga escala, comuns no treinamento de modelos generativos avançados, muitas vezes ficam aquém desse padrão.
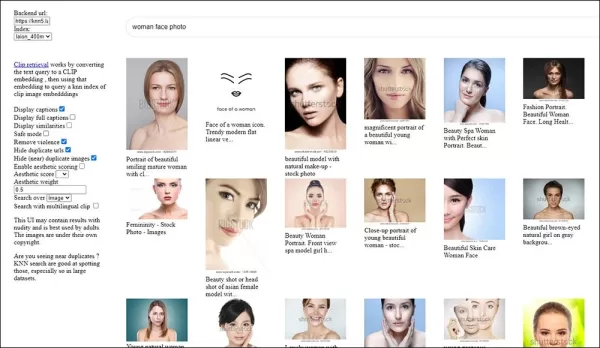
As legendas fracas reduzem o valor das imagens LAION para o treinamento de modelos como o Stable Diffusion. Os rótulos geralmente são superficiais, vagos ou focados em SEO em vez de descritivos, o que prejudica a capacidade do modelo de aprender conceitos visuais detalhados, como características faciais. (A fonte original era https://rom1504.github.io/, agora extinta).
Como uma correção fundamental é impraticável, as soluções alternativas para reduzir as alucinações em LLMs e VLMs tornaram-se um foco de pesquisa significativo. O novo método chinês, testado em várias arquiteturas e condições, mostra-se promissor na redução da "poluição de alucinações".
Os autores afirmam:
"Experimentos extensivos em vários benchmarks mostram que nosso método reduz significativamente as alucinações nos níveis de objeto, atributo e relação, ao mesmo tempo em que preserva amplamente a recuperação e a legenda [riqueza]".
O artigo, intitulado Exposing Hallucinations To Suppress Them: VLMs Representation Editing With Generative Anchors (Expondo alucinações para suprimi-las: edição de representação de VLMs com âncoras geradoras), é de autoria de pesquisadores da Universidade de Ciência e Tecnologia da China e da Universidade de Nanjing.
Como o método funciona
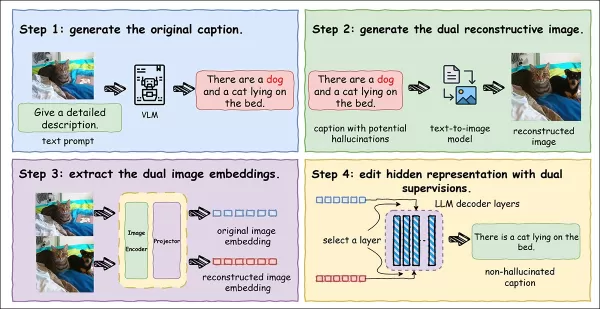
Os pesquisadores desenvolveram um pipeline de ponta a ponta para expor e suprimir alucinações de legendas:
A ilustração completa do pipeline. Um modelo de linguagem de visão gera uma legenda a partir de uma imagem de entrada, possivelmente incluindo alucinações. Essa legenda é usada para criar uma imagem reconstruída por meio de um modelo de texto para imagem, tornando os erros visíveis. As incorporações de ambas as imagens orientam os ajustes internos, ajudando o modelo a reduzir os detalhes inventados sem perder a qualidade da legenda.
Um modelo de linguagem de visão primeiro legenda uma imagem real, possivelmente inventando objetos ou relacionamentos. Em seguida, essa legenda gera uma imagem reconstruída, revelando quaisquer invenções como discrepâncias visuais. A comparação das duas imagens transforma erros sutis de texto em sinais mensuráveis e corrigíveis.
Para desestimular as invenções, o sistema compara a imagem original (uma referência confiável) com a reconstruída (destacando os erros). Cada uma é convertida em uma incorporação compacta. Ao ajustar as representações internas para que se alinhem mais com o original e se afastem da reconstrução, o modelo se autocorrige de forma totalmente autossupervisionada.
O artigo explica:
"As alucinações em MLLMs são intrinsecamente difíceis de detectar porque são linguisticamente bem formadas e muitas vezes indistinguíveis de descrições fiéis no nível do texto. A discrepância não está na plausibilidade da linguagem, mas no desalinhamento com a evidência visual, à qual o modelo em si é normalmente insensível.
Para resolver isso, introduzimos um mecanismo de exposição à alucinação que aproveita a reconstrução generativa para converter inconsistências implícitas em sinais explícitos e observáveis.
Usando o modelo de texto para imagem FLUX.1-dev, o sistema recria uma imagem a partir da legenda, exagerando quaisquer detalhes falsos. Esses erros amplificados ajudam o modelo a reconhecer e corrigir seus erros.
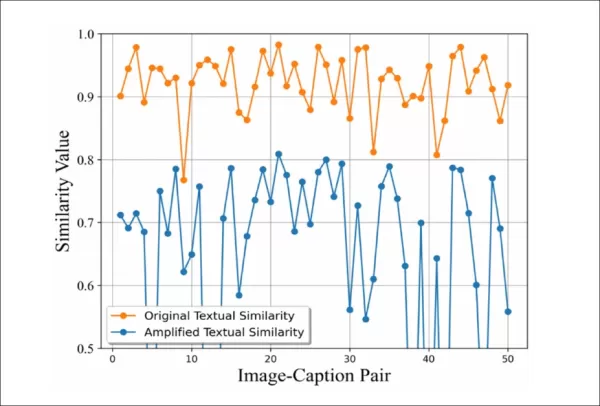
Para validar a abordagem, os pesquisadores injetaram alucinações nas legendas, geraram imagens reconstruídas e, em seguida, recriaram as legendas com o LLaVA. Eles mediram a semelhança semântica entre as legendas originais e as alucinadas:
O mecanismo de amplificação de alucinação visualiza erros sutis. Cada ponto mostra a similaridade da legenda para um par de imagem e legenda. A linha laranja (comparação direta) permanece alta, mascarando os erros; a linha azul (pós-reconstrução) cai drasticamente, revelando alucinações ocultas como marcadores semânticos detectáveis.
A similaridade diminuiu significativamente após a reconstrução, demonstrando a capacidade do método de expor erros sutis.
Dados e testes
A eficácia foi validada usando três benchmarks: Caption Hallucination Assessment with Image Relevance (CHAIR); MLLM Evaluation (MME); e Pooling-based Object Probing Evaluation (POPE).
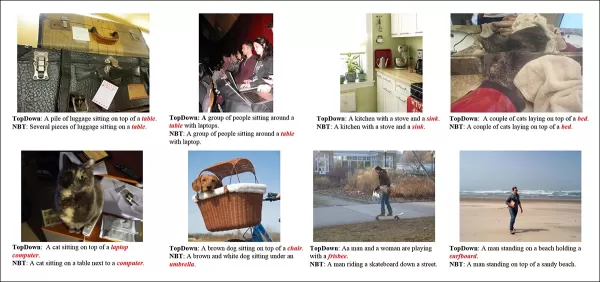
Do documento de lançamento do CHAIR: exemplos de objetos alucinados gerados pelos sistemas de legenda TopDown e NBT, que inventam elementos como laptops, pias ou pranchas de surfe não presentes na imagem. Fonte: https://arxiv.org/pdf/1809.02156
As métricas padrão, como taxa de alucinação ou recall, podem ser enganosas - os modelos podem evitar erros produzindo legendas vagas. Para equilibrar a precisão e a integridade, foi usada a métrica combinada Hallucination and Recall (HAR@β), pontuando as legendas em ambos os fatores com ponderação ajustável.
O POPE avaliou as alucinações de objetos sensíveis ao contexto, e o MME avaliou as alucinações em nível de atributo, ambas como tarefas Sim/Não.
Os testes usaram o modelo Flux e o LLaVA-v1.5-7B em conjuntos de dados, incluindo Microsoft COCO, A-OKVQA e GQA. A edição latente foi direcionada à segunda camada dos modelos, com hiperparâmetros e temperatura consistentes em todos os testes.
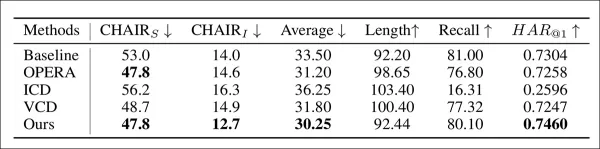
Os resultados iniciais do CHAIR são mostrados abaixo*:
Desempenho no benchmark CHAIR para mitigação de alucinações, avaliado com várias métricas.
Os autores observam:
"[Nosso método supera consistentemente outras linhas de base no CHAIRS e no CHAIRI[*] , demonstrando sua eficácia superior na supressão de alucinações. Enquanto isso, embora quase todos os métodos reduzam inevitavelmente a recuperação ao suprimir as alucinações, refletindo uma compensação entre fidelidade e informatividade, nossa abordagem atinge a menor queda.
Isso demonstra que nosso método captura uma ampla gama de objetos da verdade básica. Com a métrica HAR@β, nosso método obtém a pontuação mais alta, destacando sua capacidade de reduzir as alucinações e, ao mesmo tempo, manter a cobertura.
Os bons resultados são atribuídos à supervisão dupla: reforço da semântica limpa da imagem original e supressão de sinais enganosos da reconstrução. Ao visar somente as direções relacionadas à alucinação, o sistema corrige os erros sem perder detalhes.
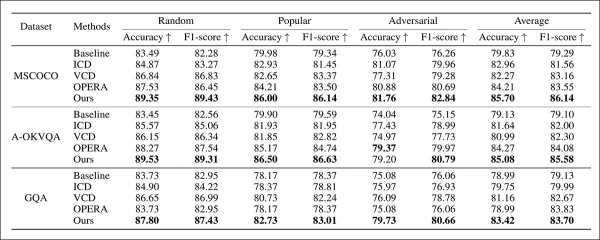
Comparação de desempenho no benchmark POPE em diferentes configurações e conjuntos de dados.
Com relação aos resultados do POPE, o documento afirma:
"Pode-se observar que nosso método alcança consistentemente o melhor desempenho em todas as configurações. Notavelmente, nosso método pode atingir até +5,95% de precisão e +6,85% de pontuação F1 em média, superando outras abordagens sem treinamento por uma grande margem.
Portanto, esses resultados demonstram que nosso método oferece uma solução confiável e generalizável em diferentes níveis de dificuldade".
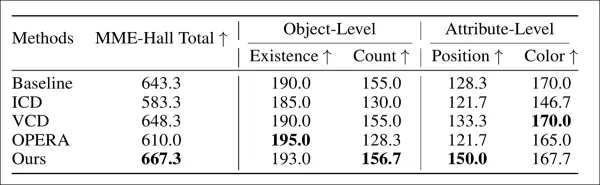
Comparações de desempenho da terceira rodada de testes no MME.
O teste principal final foi no MME, com os resultados mostrados acima. No entanto, o documento menciona o método "OPERA" sem definição no texto principal ou no apêndice. Embora os autores afirmem que o desempenho do MME é forte, a falta de detalhes do método sugere cautela na interpretação desses resultados.
As melhores ferramentas de ilustração com IA de 2026: nossa lista selecionada apresenta as melhores ferramentas, com design robusto, para criar rapidamente cenas editoriais impressionantes e capas atraentes. Cada opção passou por rigorosos testes práticos, oferecendo uma comparação entre versões gratuitas e pagas para ajudar você a encontrar a opção perfeita para o seu fluxo de trabalho. Experimente hoje mesmo essas soluções imperdíveis para aproveitar ao máximo as vantagens da IA e impulsionar sua produtividade criativa. Explore agora no XIX.AI.
Os melhores tutores de IA para preparação para exames de 2026, com as melhores avaliações, estão aqui no XIX.AI! Nossa lista cuidadosamente selecionada apresenta ferramentas poderosas e revolucionárias que oferecem comparação entre versões gratuitas e pagas, testes práticos e rankings atualizados semanalmente. Elas ajudam a aumentar sua eficiência na redação, simplificar o aprendizado de tópicos complexos e liberar seu potencial acadêmico. Explore agora para descobrir sua ferramenta perfeita de preparação para exames e comece a criar hoje mesmo para aproveitar toda a vantagem da IA!
As melhores e mais bem avaliadas ferramentas de planejamento orçamentário com IA para gestão financeira pessoal de 2026 estão aqui no XIX.AI! Esta seleção especial apresenta soluções poderosas e revolucionárias que ajudam você a realizar testes na prática, entender hábitos de consumo e criar planos personalizados para aumentar a produtividade. Confira uma comparação entre versões gratuitas e pagas, além de rankings detalhados. Ferramentas imperdíveis, projetadas para simplificar a gestão financeira e explorar o potencial da IA. Explore agora!
2026 – Os melhores assistentes de rastreamento do sono com inteligência artificial mais bem avaliados, selecionados para proporcionar uma recuperação máxima. Este guia semanal completamente atualizado apresenta ferramentas poderosas que incluem testes reais, comparações entre versões gratuitas e pagas, além de classificações detalhadas, visando ajudá-lo a encontrar a solução ideal para melhorar a qualidade do sono e fomentar hábitos noturnos mais saudáveis. Explore agora em XIX.AI e aproveite todas as vantagens oferecidas pela inteligência artificial.
2026: Os melhores e mais bem avaliados copilotos de IA para SQL em análise de produtos e receitas! A XIX.AI selecionou um conjunto poderoso e revolucionário de ferramentas imperdíveis, que passam por testes práticos por meio de rankings atualizados semanalmente. Essas ferramentas ajudam os usuários a aumentar significativamente a produtividade, acelerando a análise de dados, simplificando consultas complexas e gerando insights precisos para impulsionar decisões de negócios mais inteligentes. Explore agora e descubra a ferramenta perfeita para aproveitar ao máximo o potencial da IA!
2026: Os melhores e mais bem avaliados auxiliares de tarefas com IA que ensinam conceitos fundamentais, não apenas respostas. Ferramentas poderosas para estudantes. Lista selecionada que você não pode deixar de conferir. Atualizada semanalmente. Comparação entre versões gratuitas e pagas. Testes em situações reais. Rankings precisos para ajudar você a atingir todo o seu potencial de aprendizado. Explore agora e descubra a ferramenta perfeita para estudar de forma mais inteligente.
Ao clicar em "Aceitar todos os cookies", você concorda com o armazenamento de cookies em seu dispositivo para melhorar a navegação no site, analisar o uso do site e auxiliar em nossos esforços de marketing.Política de Privacidade Aviso
Ao visitar qualquer site, ele pode armazenar ou recuperar informações em seu navegador, principalmente na forma de cookies. Essas informações podem ser sobre você, suas preferências ou seu dispositivo e são usadas principalmente para fazer com que o site funcione conforme esperado. As informações geralmente não identificam você diretamente, mas podem proporcionar uma experiência web mais personalizada. Como respeitamos seu direito à privacidade, você pode optar por não permitir alguns tipos de cookies. Clique nos diferentes títulos de categoria para saber mais e alterar nossas configurações padrão. No entanto, bloquear alguns tipos de cookies pode afetar sua experiência no site e os serviços que podemos oferecer. Política de PrivacidadeDeclaração
Gerenciar preferências
Cookie estritamente necessário
Sempre ativado
Esses cookies são necessários para o funcionamento do site e não podem ser desativados em nossos sistemas. Eles geralmente são definidos apenas em resposta a ações que você realiza, que equivalem a uma solicitação de serviços, como configurar suas preferências de privacidade, fazer login ou preencher formulários. Você pode configurar seu navegador para bloquear esses cookies ou alertá-lo sobre eles, mas algumas partes do site não funcionarão depois. Esses cookies não armazenam nenhuma informação que permita identificar pessoalmente.



 Lar
 NanoClaw Creator Rejeita Oferta de Aquisição de $20 Milhões e Garante $12 Milhões em Financiamento Semente
NanoCo, a equipe por trás do NanoClaw — uma alternativa focada em segurança ao OpenClaw — garantiu uma rodada de investimento semente de $12 milhões, com demanda superior à oferta, após um lançamento viral, informaram os fundadores Gavriel e Lazer Co
 As melhores ferramentas de ilustração com IA: crie cenas editoriais e capas de forma mais rápida
 10 ferramentas
 xix.ai
Educação e Aprendizagem

 Comentários (0)








 NanoClaw Creator Rejeita Oferta de Aquisição de $20 Milhões e Garante $12 Milhões em Financiamento Semente
NanoCo, a equipe por trás do NanoClaw — uma alternativa focada em segurança ao OpenClaw — garantiu uma rodada de investimento semente de $12 milhões, com demanda superior à oferta, após um lançamento viral, informaram os fundadores Gavriel e Lazer Co
 Relatório Financeiro da SpaceX Mostra Receita de IA Triplicando, Superando Lançamentos Espaciais
O mais recente relatório financeiro trimestral da SpaceX revela que sua divisão de inteligência artificial, impulsionada por investimentos substanciais em infraestrutura de computação, gerou US$ 2,6 bilhões em receita em um único trimestre. Esse valo
 Startup de Robótica com Foco Geral Alcança Avaliação de US$ 3 Bilhões, Segundo Fontes
A startup de robótica Generalist atingiu uma avaliação de US$ 3 bilhões após uma nova rodada de investimentos liderada pela 8VC, segundo duas pessoas familiarizadas com o acordo.Documentos regulatórios indicam que o mais recente aporte de capital ch


















