Los modelos visuales como ChatGPT inventan con frecuencia elementos que faltan en una imagen. Un método novedoso reduce estos errores generando versiones exageradas de los detalles alucinados por el propio modelo a partir de sus pies de foto y, a continuación, pidiéndole que los revise. Esta técnica no requiere reentrenamiento ni datos adicionales, lo que la hace ampliamente aplicable a diversos modelos y arquitecturas.
Un nuevo estudio chino aborda el difícil problema de las alucinaciones en imágenes y vídeos generados por IA: detalles que contradicen claramente las indicaciones del usuario.
El proceso comienza de forma convencional: el modelo describe una imagen. A continuación, esa descripción se introduce en un modelo texto-imagen para producir una nueva imagen. Cualquierobjeto o característica adicional en esta reconstrucción revela directamente las alucinaciones iniciales del modelo. Al comparar la imagen original y la generada, el sistema guía al modelo para que evite repetir esos errores en futuros intentos.
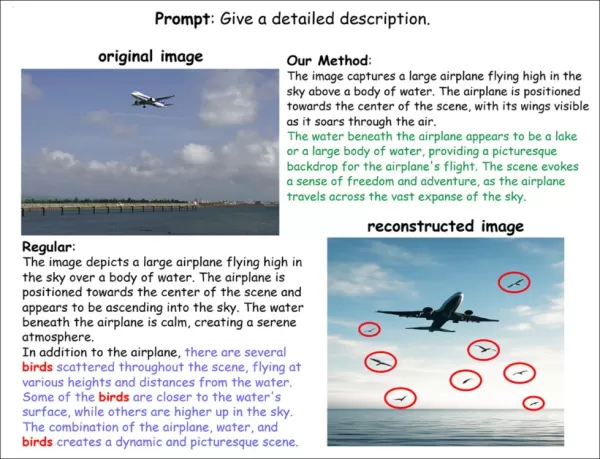
Este diagrama muestra cómo la nueva técnica detecta y minimiza las alucinaciones del modelo. Un modelo estándar añade incorrectamente pájaros a su descripción de una imagen, y la versión reconstruida los inserta visualmente (resaltados en rojo). El nuevo método evita estas fabricaciones manteniendo la precisión descriptiva. Fuente: https://arxiv.org/pdf/2509.21997
El método comienza haciendo que el modelo describa imágenes reales, a veces incluyendo objetos o detalles que no están realmente presentes. Estas descripciones inexactas generan imágenes sintéticas que ponen de manifiesto los errores. Al comparar imágenes reales y sintéticas, el sistema identifica patrones internos que conducen a contenidos inventados.
Una vez reconocidos estos patrones de error, se almacenan para utilizarlos en el futuro. Al subtitular una nueva imagen, el sistema ajusta las señales internas del modelo, alejándolo de los desencadenantes de alucinaciones conocidos. Esta corrección se realiza en una sola pasada, sin datos adicionales, reentrenamiento ni generación de imágenes durante las pruebas.
El reto del enredo
En el ejemplo del artículo, el "enredo" explica por qué se añadieron pájaros a una imagen que no contenía ninguno.
El enredo se produce cuando un modelo vincula fuertemente ciertos conceptos porque aparecen juntos con frecuencia en sus datos de entrenamiento. En este caso, el modelo puede haber encontrado con frecuencia aviones con pájaros, creando una asociación que influye erróneamente en el pie de foto.
Aunque terminar antes el entrenamiento puede reducir el enredo (aumentando la flexibilidad del modelo), también disminuye el detalle conceptual y la resolución. Los desarrolladores se enfrentan a una disyuntiva persistente: ¿priorizar un modelo flexible y desenredado o uno más generativo propenso a alucinaciones asociadas?
Lo ideal sería que los pies de foto de las imágenes de origen desglosaran todos los objetos presentes y permitieran al modelo almacenarlos como entradas separadas y disociadas. Sin embargo, las prácticas de subtitulado orientadas al SEO y el raspado de páginas web a gran escala, habituales en el entrenamiento de potentes modelos generativos, no suelen cumplir esta norma.
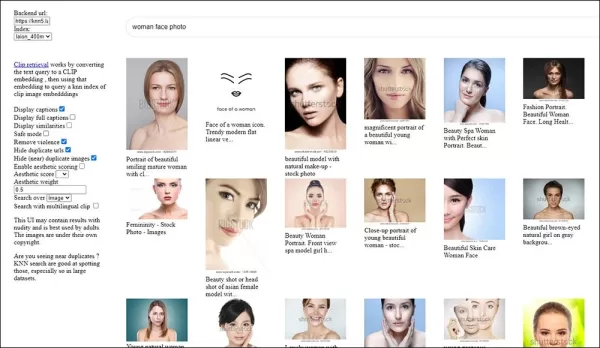
Los subtítulos débiles reducen el valor de las imágenes LAION para el entrenamiento de modelos como Stable Diffusion. Las etiquetas suelen ser superficiales, vagas o centradas en el SEO, en lugar de descriptivas, lo que dificulta la capacidad del modelo para aprender conceptos visuales detallados, como los rasgos faciales. (La fuente original era https://rom1504.github.io/, ya desaparecida).
Dado que no es factible una solución básica, las soluciones para reducir las alucinaciones en los LLM y VLM se han convertido en un importante foco de investigación. El nuevo método chino, probado en varias arquitecturas y condiciones, resulta prometedor para frenar la "contaminación por alucinaciones".
Los autores afirman:
Experimentos exhaustivos con múltiples puntos de referencia demuestran que nuestro método reduce significativamente las alucinaciones en los niveles de objeto, atributo y relación, al tiempo que preserva en gran medida el recuerdo y la [riqueza] de los subtítulos".
El artículo, titulado Exposing Hallucinations To Suppress Them: VLMs Representation Editing With Generative Anchors, es obra de investigadores de la Universidad de Ciencia y Tecnología de China y la Universidad de Nanjing.
Cómo funciona el método
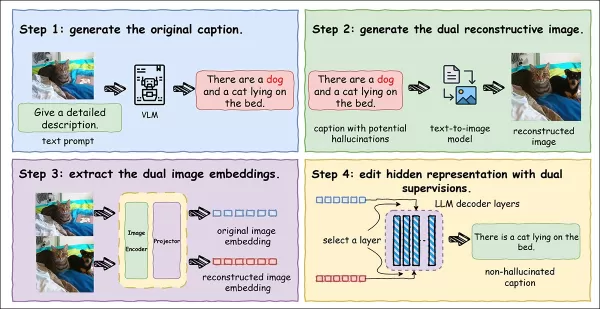
Los investigadores desarrollaron un proceso integral para exponer y suprimir las alucinaciones de los subtítulos:
Ilustración del proceso completo. Un modelo de lenguaje visual genera un pie de foto a partir de una imagen de entrada, que puede incluir alucinaciones. Ese pie de foto se utiliza para crear una imagen reconstruida mediante un modelo de texto a imagen, que hace visibles los errores. Las incrustaciones de ambas imágenes guían los ajustes internos, ayudando al modelo a reducir los detalles inventados sin perder la calidad del pie de foto.
Un modelo de lenguaje visual subtitula primero una imagen real, posiblemente inventando objetos o relaciones. A continuación, ese pie de foto genera una imagen reconstruida que revela las invenciones como discrepancias visuales. La comparación de las dos imágenes convierte los sutiles errores de texto en señales medibles y corregibles.
Para desalentar las invenciones, el sistema compara la imagen original (una referencia fiable) con la reconstruida (resaltando los errores). Cada una se convierte en una incrustación compacta. Al ajustar las representaciones internas para alinearse más con el original y divergir de la reconstrucción, el modelo se autocorrige de forma totalmente autosupervisada.
El artículo explica:
Las alucinaciones en los MLLM son intrínsecamente difíciles de detectar porque están bien formadas lingüísticamente y a menudo no se distinguen de las descripciones fieles a nivel de texto. La discrepancia no radica en la verosimilitud lingüística, sino en la falta de alineación con la evidencia visual, a la que el propio modelo suele ser insensible".
Para solucionar este problema, introducimos un mecanismo de exposición a las alucinaciones que aprovecha la reconstrucción generativa para convertir las incoherencias implícitas en señales explícitas y observables".
Utilizando el modelo texto-imagen FLUX.1-dev, el sistema recrea una imagen a partir del pie de foto, exagerando cualquier detalle falso. Estos errores amplificados ayudan al modelo a reconocer y corregir sus errores.
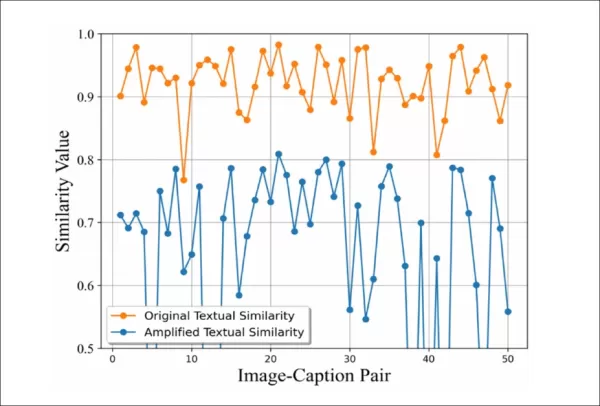
Para validar el método, los investigadores inyectaron alucinaciones en los pies de foto, generaron imágenes reconstruidas y las volvieron a subtitular con LLaVA. Midieron la similitud semántica entre los pies de foto originales y los alucinados:
El mecanismo de amplificación de alucinaciones visualiza errores sutiles. Cada punto muestra la similitud de los subtítulos de un par imagen-subtítulo. La línea naranja (comparación directa) se mantiene alta, ocultando los errores; la línea azul (post-reconstrucción) cae bruscamente, revelando las alucinaciones ocultas como marcadores semánticos detectables.
La similitud disminuyó significativamente tras la reconstrucción, lo que demuestra la capacidad del método para sacar a la luz errores sutiles.
Datos y pruebas
La eficacia se validó utilizando tres puntos de referencia: Evaluación de alucinaciones con relevancia de imagen (CHAIR); Evaluación MLLM (MME); y Evaluación de sondeo de objetos basada en pooling (POPE).
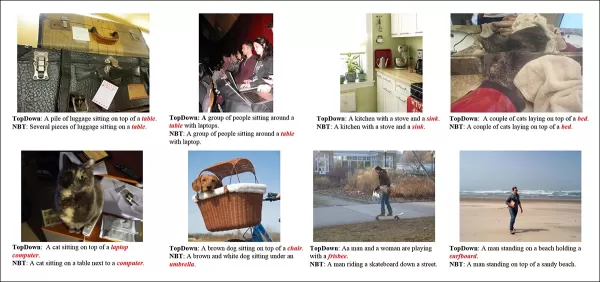
Del documento de publicación de CHAIR: ejemplos de objetos alucinados generados por los sistemas de subtitulado TopDown y NBT, que inventan elementos como ordenadores portátiles, lavabos o tablas de surf que no están presentes en la imagen. Fuente: https://arxiv.org/pdf/1809.02156
Las métricas estándar, como la tasa de alucinación o el recuerdo, pueden ser engañosas: los modelos pueden evitar errores produciendo subtítulos imprecisos. Para equilibrar la precisión y la exhaustividad, se utilizó la métrica combinada Hallucination and Recall (HAR@β), que puntúa los pies de foto en ambos factores con una ponderación ajustable.
POPE evaluó las alucinaciones de objetos sensibles al contexto, y MME evaluó las alucinaciones a nivel de atributo, ambas como tareas Sí/No.
En las pruebas se utilizó el modelo Flux y LLaVA-v1.5-7B en conjuntos de datos que incluían Microsoft COCO, A-OKVQA y GQA. La edición latente se centró en la segunda capa de los modelos, con hiperparámetros y temperatura coherentes en todas las pruebas.
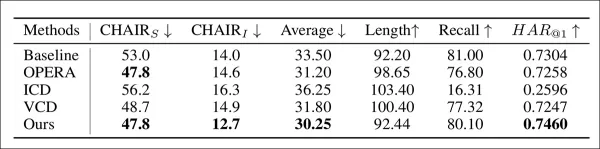
A continuación se muestran los resultados iniciales de CHAIR*:
Rendimiento en el benchmark CHAIR para la mitigación de alucinaciones, evaluado con múltiples métricas.
Los autores señalan:
'[Nuestro método supera sistemáticamente a otras líneas de base tanto en CHAIRS como en CHAIRI[*] , lo que demuestra su eficacia superior en la supresión de las alucinaciones. Mientras tanto, aunque casi todos los métodos reducen inevitablemente el recuerdo al suprimir las alucinaciones, lo que refleja un equilibrio entre fidelidad e información, nuestro método consigue la menor reducción.
Esto demuestra que nuestro método capta una amplia gama de objetos de verdad. Con la métrica HAR@β, nuestro método obtiene la puntuación más alta, lo que pone de relieve su capacidad para reducir las alucinaciones manteniendo la cobertura.'
Los buenos resultados se atribuyen a la supervisión dual: refuerza la semántica limpia de la imagen original y suprime las señales engañosas de la reconstrucción. Al centrarse únicamente en las direcciones relacionadas con las alucinaciones, el sistema corrige los errores sin perder detalle.
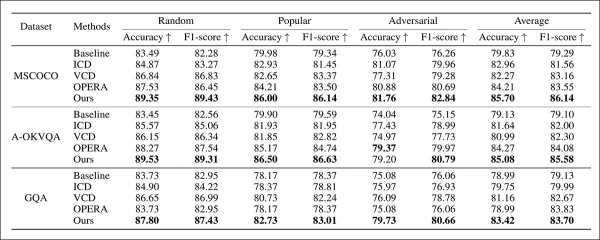
Comparación del rendimiento en la prueba POPE con distintas configuraciones y conjuntos de datos.
En cuanto a los resultados de POPE, el artículo afirma
Se puede observar que nuestro método consigue sistemáticamente el mejor rendimiento en todas las configuraciones. En concreto, nuestro método puede alcanzar hasta un +5,95% de precisión y un +6,85% de puntuación F1 de media, superando a otros métodos sin entrenamiento por un amplio margen".
Por tanto, estos resultados demuestran que nuestro método ofrece una solución fiable y generalizable en distintos niveles de dificultad".
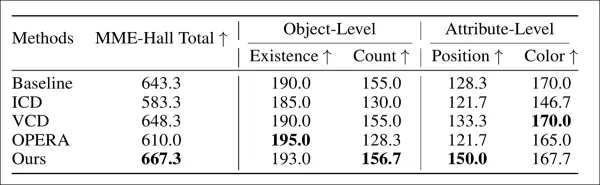
Comparaciones de rendimiento de la tercera ronda de pruebas con MME.
La prueba principal final se realizó con MME, y los resultados se muestran más arriba. Sin embargo, el artículo menciona el método "OPERA" sin definirlo en el texto principal ni en el apéndice. Mientras que los autores afirman un fuerte rendimiento MME, la falta de detalles del método sugiere precaución en la interpretación de estos resultados.
Debates clave sobre la IA que marcan la agenda de AI LIVE LondonLa cumbre reunirá a altos directivos de todo el mundo para abordar los retos más acuciantes a los que se enfrentan los sectores a nivel global, desde la disrupción impulsada por la inteligencia artifi
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
Al hacer clic en "Aceptar todos los cookies", usted acepta el almacenamiento de cookies en su dispositivo para mejorar la navegación por el sitio, analizar el uso del sitio y ayudar en nuestros esfuerzos de marketing.Política de privacidad Aviso
Al visitar cualquier sitio web, este puede almacenar o recuperar información en su navegador, principalmente en forma de cookies. Esta información puede referirse a usted, sus preferencias o su dispositivo y se usa principalmente para que el sitio funcione como espera. Por lo general, la información no lo identifica directamente, pero puede brindarle una experiencia web más personalizada. Debido a que respetamos su derecho a la privacidad, puede optar por no permitir algunos tipos de cookies. Haga clic en los diferentes títulos de categoría para obtener más información y cambiar nuestros ajustes predeterminados. Sin embargo, bloquear algunos tipos de cookies puede afectar su experiencia en el sitio y los servicios que podemos ofrecer. Política de privacidadDeclaración
Gestionar preferencias
Cookie estrictamente necesario
Siempre activo
Estos cookies son necesarios para que el sitio web funcione y no pueden ser desactivados en nuestros sistemas. Por lo general, solo se establecen en respuesta a acciones que realice usted que equivalen a una solicitud de servicios, como configurar sus preferencias de privacidad, iniciar sesión o completar formularios. Puede configurar su navegador para bloquear estos cookies o alertarle sobre ellos, pero algunas partes del sitio no funcionarán luego. Estos cookies no almacenan ninguna información que permita identificar personalmente.



 Hogar
 Debates clave sobre la IA que marcan la agenda de AI LIVE London
La cumbre reunirá a altos directivos de todo el mundo para abordar los retos más acuciantes a los que se enfrentan los sectores a nivel global, desde la disrupción impulsada por la inteligencia artifi
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
 10 herramientas
 xix.ai
Educación y aprendizaje

 comentario (0)
0/500








 Debates clave sobre la IA que marcan la agenda de AI LIVE London
La cumbre reunirá a altos directivos de todo el mundo para abordar los retos más acuciantes a los que se enfrentan los sectores a nivel global, desde la disrupción impulsada por la inteligencia artifi
 Google presenta Veo 3.1 Lite, su modelo de vídeo más asequible, que inaugura la generación de vídeo por centavos de segundo
Google ha lanzado oficialmente la última incorporación a su línea de generación de video: Veo3.1Lite, diseñado para democratizar la creación de videos de alta calidad al reducir drásticamente los costos computacionales. Este modelo mantiene los rigur
 Xiaoyunque AI presenta un Agente de Drama Corto impulsado por Seedance 2.0 para la conversión cinematográfica con un solo clic
El 19 de marzo, la plataforma integral de creación de contenido con inteligencia artificial de ByteDance Little Swallow AI presentó oficialmente su función «Agente de Drama Corto». Reconocida como el primer agente inteligente de la industria impulsad


















