Sehmodelle wie ChatGPT erfinden häufig Elemente, die in einem Bild fehlen. Ein neuartiger Ansatz reduziert diese Fehler, indem er aus den Bildunterschriften übertriebene Versionen der halluzinierten Details des Modells generiert und es dann auffordert, diese zu überarbeiten. Diese Technik erfordert kein Neutraining oder zusätzliche Daten, so dass sie auf verschiedene Modelle und Architekturen anwendbar ist.
Eine neue Studie aus China befasst sich mit dem hartnäckigen Problem der Halluzinationen in KI-generierten Bildern und Videos - Details, die eindeutig der Aufforderung des Benutzers widersprechen.
Der Prozess beginnt ganz konventionell: Das Modell beschreibt ein Bild. Diese Beschriftung wird dann in ein Text-Bild-Modell eingespeist, um ein neues Bildzu erzeugen - allezusätzlichen Objekte oder Merkmale in dieser Rekonstruktion verraten direkt die ursprünglichen Halluzinationen des Modells. Durch den Vergleich der ursprünglichen und der erzeugten Bilder kann das System das Modell so steuern, dass es diese Fehler bei künftigen Versuchen nicht mehr wiederholt.
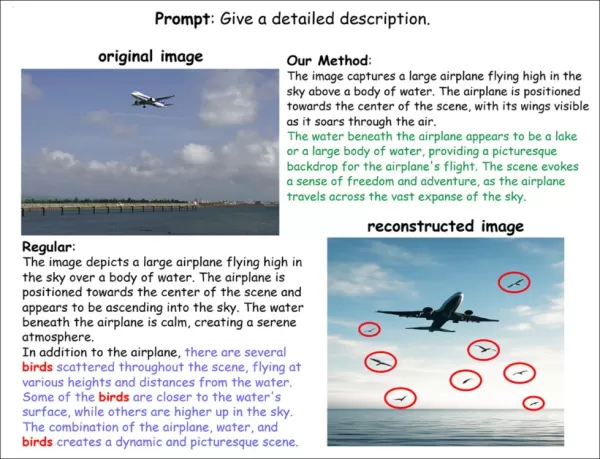
Dieses Diagramm zeigt, wie die neue Technik Erfassungshalluzinationen erkennt und minimiert. Ein Standardmodell fügt seiner Beschreibung eines Bildes fälschlicherweise Vögel hinzu, und die rekonstruierte Version fügt sie visuell ein (rot hervorgehoben). Die neue Methode vermeidet diese Fälschungen und behält gleichzeitig die Genauigkeit der Beschreibung bei. Quelle: https://arxiv.org/pdf/2509.21997
Die Methode beginnt damit, dass das Modell reale Bilder beschreibt, die manchmal Objekte oder Details enthalten , die in Wirklichkeit nicht vorhanden sind. Diese ungenauen Beschriftungen erzeugen synthetische Bilder, die die Fehler hervorheben. Durch den Vergleich von realen und synthetischen Bildern identifiziert das System interne Muster, die zu erfundenen Inhalten führen.
Sobald diese Fehlermuster erkannt sind, werden sie zur späteren Verwendung gespeichert. Bei der Beschriftung eines neuen Bildes passt das System die internen Signale des Modells an und lenkt es weg von bekannten Halluzinationsauslösern. Diese Korrektur erfolgt in einem einzigen Durchgang ohne zusätzliche Daten, ohne erneutes Training und ohne Bilderzeugung während des Tests.
Die Herausforderung der Verschränkung
Im Beispiel der Arbeit erklärt die "Verschränkung" wahrscheinlich, warum Vögel zu einem Bild hinzugefügt wurden, das keine enthielt.
Eine Verflechtung liegt vor, wenn ein Modell bestimmte Konzepte stark miteinander verknüpft, weil sie in seinen Trainingsdaten häufig zusammen auftreten. In diesem Fall ist das Modell möglicherweise häufig auf Flugzeuge mit Vögeln gestoßen und hat so eine Assoziation geschaffen, die die Bildunterschrift fälschlicherweise beeinflusst.
Eine frühere Beendigung des Trainings kann zwar die Verflechtung reduzieren (und damit die Flexibilität des Modells erhöhen), verringert aber auch die konzeptionelle Detailgenauigkeit und Auflösung. Die Entwickler stehen vor einem ständigen Kompromiss: Bevorzugen sie ein flexibles, entflochtenes Modell oder ein generativeres, das anfällig für assoziierte Halluzinationen ist?
Im Idealfall würden die Bildunterschriften jedes vorhandene Objekt auflisten, so dass das Modell sie als separate, unzusammenhängende Einträge speichern könnte. SEO-gesteuerte Beschriftungspraktiken und großangelegtes Web-Scraping, die beim Training leistungsstarker generativer Modelle üblich sind, erfüllen diesen Standard jedoch oft nicht.
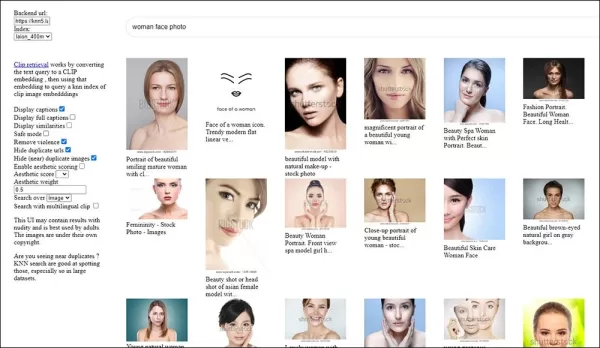
Schwache Beschriftungen verringern den Wert von LAION-Bildern für das Training von Modellen wie Stable Diffusion. Die Beschriftungen sind oft oberflächlich, vage oder eher SEO-orientiert als beschreibend und behindern die Fähigkeit des Modells, detaillierte visuelle Konzepte wie Gesichtszüge zu lernen. (Ursprüngliche Quelle war https://rom1504.github.io/, jetzt nicht mehr verfügbar).
Da eine grundlegende Korrektur nicht praktikabel ist, sind Umgehungslösungen zur Verringerung von Halluzinationen bei LLMs und VLMs zu einem wichtigen Forschungsschwerpunkt geworden. Die neue chinesische Methode, die an verschiedenen Architekturen und Bedingungen getestet wurde, ist vielversprechend, um die "Halluzinationsverschmutzung" zu verringern.
Die Autoren erklären:
Ausführliche Experimente mit mehreren Benchmarks zeigen, dass unsere Methode Halluzinationen auf Objekt-, Attribut- und Beziehungsebene signifikant reduziert, während Recall und Caption [Richness] weitgehend erhalten bleiben".
Die Arbeit mit dem Titel Exposing Hallucinations To Suppress Them: VLMs Representation Editing With Generative Anchors stammt von Forschern der University of Science and Technology of China und der Nanjing University.
Wie die Methode funktioniert
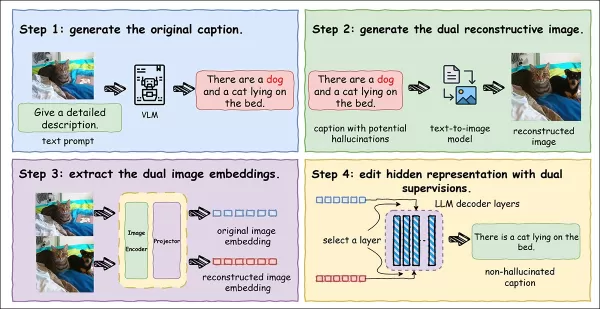
Die Forscher entwickelten eine End-to-End-Pipeline zur Aufdeckung und Unterdrückung von Untertitel-Halluzinationen:
Die vollständige Abbildung der Pipeline. Ein Bildsprachenmodell generiert aus einem Eingabebild eine Bildunterschrift, die möglicherweise Halluzinationen enthält. Diese Beschriftung wird verwendet, um ein rekonstruiertes Bild über ein Text-Bild-Modell zu erstellen, wodurch Fehler sichtbar werden. Einbettungen aus beiden Bildern führen zu internen Anpassungen, die dem Modell helfen, erfundene Details zu reduzieren, ohne die Qualität der Beschriftung zu verlieren.
Ein Bildsprachmodell beschriftet zunächst ein reales Bild und erfindet dabei möglicherweise Objekte oder Beziehungen. Aus dieser Beschriftung wird dann ein rekonstruiertes Bild erzeugt, in dem alle Erfindungen als visuelle Diskrepanzen sichtbar werden. Der Vergleich der beiden Bilder verwandelt subtile Textfehler in messbare, korrigierbare Signale.
Um von Erfindungen abzuschrecken, vergleicht das System das Originalbild (eine zuverlässige Referenz) mit dem rekonstruierten Bild (und hebt Fehler hervor). Beide werden in eine kompakte Einbettung umgewandelt. Durch die Anpassung der internen Repräsentationen an das Original und die Abweichung von der Rekonstruktion korrigiert sich das Modell vollständig selbständig.
Das Papier erklärt:
Halluzinationen in MLLMs sind von Natur aus schwer zu erkennen, da sie sprachlich wohlgeformt und oft nicht von getreuen Beschreibungen auf Textebene zu unterscheiden sind. Die Diskrepanz liegt nicht in der sprachlichen Plausibilität, sondern in der fehlenden Übereinstimmung mit visuellen Belegen, auf die das Modell selbst in der Regel nicht reagiert.
Um hier Abhilfe zu schaffen, führen wir einen Mechanismus zur Aufdeckung von Halluzinationen ein, der die generative Rekonstruktion nutzt, um implizite Inkonsistenzen in explizite und beobachtbare Signale umzuwandeln.
Unter Verwendung des FLUX.1-dev Text-Bild-Modells erstellt das System ein Bild aus der Bildunterschrift und übertreibt dabei alle falschen Details. Diese verstärkten Fehler helfen dem Modell, seine Fehler zu erkennen und zu korrigieren.
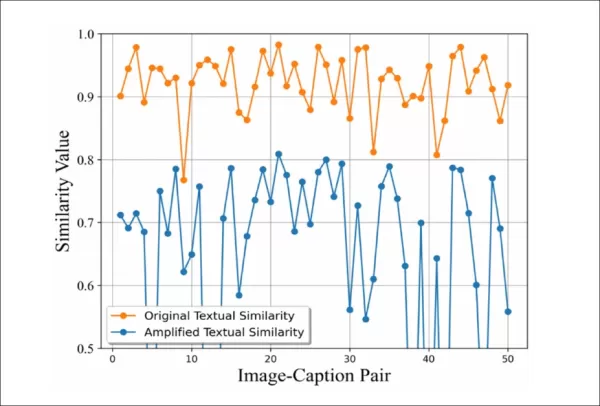
Um den Ansatz zu validieren, fügten die Forscher Halluzinationen in die Bildunterschriften ein, erzeugten rekonstruierte Bilder und versahen sie anschließend mit LLaVA mit neuen Untertiteln. Sie maßen die semantische Ähnlichkeit zwischen den ursprünglichen und den halluzinierten Bildunterschriften:
Der Mechanismus zur Verstärkung von Halluzinationen macht subtile Fehler sichtbar. Jeder Punkt zeigt die Ähnlichkeit der Beschriftung für ein Bild-Beschriftungspaar. Die orangefarbene Linie (direkter Vergleich) bleibt hoch und maskiert Fehler; die blaue Linie (Post-Rekonstruktion) fällt stark ab und enthüllt versteckte Halluzinationen als erkennbare semantische Marker.
Die Ähnlichkeit nahm nach der Rekonstruktion deutlich ab, was die Fähigkeit der Methode zeigt, subtile Fehler aufzudecken.
Daten und Tests
Die Effektivität wurde anhand von drei Benchmarks validiert: Caption Hallucination Assessment with Image Relevance (CHAIR); MLLM Evaluation (MME); und Pooling-based Object Probing Evaluation (POPE).
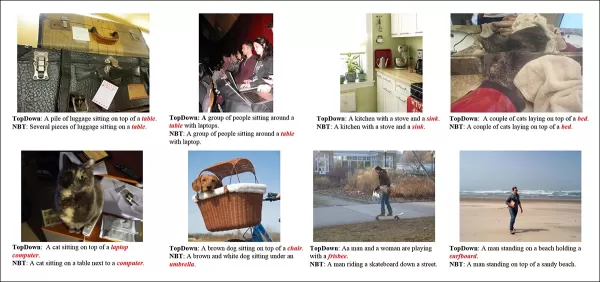
Aus dem CHAIR-Release-Papier: Beispiele für halluzinierte Objekte, die von den Beschriftungssystemen TopDown und NBT erzeugt werden, die Elemente wie Laptops, Waschbecken oder Surfbretter erfinden, die auf dem Bild nicht vorhanden sind. Quelle: https://arxiv.org/pdf/1809.02156
Standardmetriken wie die Halluzinationsrate oder die Wiedererkennungsrate können irreführend sein - die Modelle könnten Fehler vermeiden, indem sie vage Beschriftungen produzieren. Um ein Gleichgewicht zwischen Genauigkeit und Vollständigkeit herzustellen, wurde die kombinierte Metrik Halluzinations- und Wiedererkennungsrate (HAR@β) verwendet, bei der die Beschriftungen nach beiden Faktoren mit einstellbarer Gewichtung bewertet werden.
POPE bewertete kontextabhängige Objekthalluzinationen und MME bewertete Halluzinationen auf Attributsebene, beide als Ja/Nein-Aufgaben.
Die Tests verwendeten das Flux-Modell und LLaVA-v1.5-7B auf Datensätzen wie Microsoft COCO, A-OKVQA und GQA. Die latente Bearbeitung zielte auf die zweite Schicht der Modelle ab, wobei die Hyperparameter und die Temperatur in allen Tests konsistent waren.
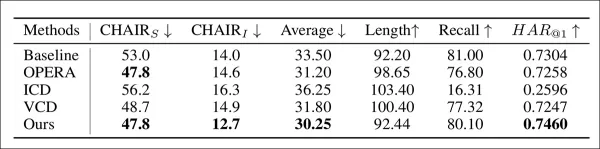
Die ersten CHAIR-Ergebnisse sind unten aufgeführt*:
Leistung beim CHAIR-Benchmark für die Abschwächung von Halluzinationen, bewertet mit mehreren Metriken.
Die Autoren merken an:
'[Unsere Methode übertrifft sowohl bei CHAIRS als auch bei CHAIRI[*] durchgängig andere Baselines, was ihre überlegene Wirksamkeit bei der Unterdrückung von Halluzinationen zeigt. Obwohl fast alle Methoden bei der Unterdrückung von Halluzinationen zwangsläufig zu einer Verringerung des Erinnerungsvermögens führen, was einen Kompromiss zwischen Treue und Informativität darstellt, erzielt unser Ansatz den geringsten Rückgang.
Dies zeigt, dass unsere Methode ein breites Spektrum von Objekten der Grundwahrheit erfasst. Mit der HAR@β-Metrik erreicht unsere Methode die höchste Punktzahl, was ihre Fähigkeit unterstreicht, Halluzinationen zu reduzieren und gleichzeitig die Abdeckung aufrechtzuerhalten.
Die starken Ergebnisse sind auf die duale Überwachung zurückzuführen: Verstärkung der sauberen Semantik des Originalbildes bei gleichzeitiger Unterdrückung irreführender Signale in der Rekonstruktion. Indem das System nur auf halluzinationsbezogene Richtungen abzielt, korrigiert es Fehler, ohne Details zu verlieren.
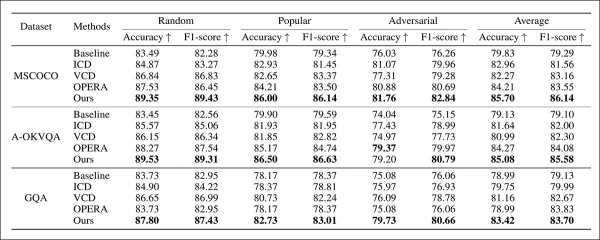
Leistungsvergleich mit dem POPE-Benchmark über verschiedene Konfigurationen und Datensätze hinweg.
Zu den POPE-Ergebnissen heißt es in dem Papier:
Es ist zu beobachten, dass unsere Methode in allen Einstellungen durchweg die beste Leistung erzielt. Insbesondere erreicht unsere Methode im Durchschnitt eine Genauigkeit von bis zu +5,95 % und eine F1-Punktzahl von +6,85 % und übertrifft damit andere trainingsfreie Ansätze bei weitem.
Diese Ergebnisse zeigen, dass unsere Methode eine zuverlässige und verallgemeinerbare Lösung für verschiedene Schwierigkeitsgrade bietet.
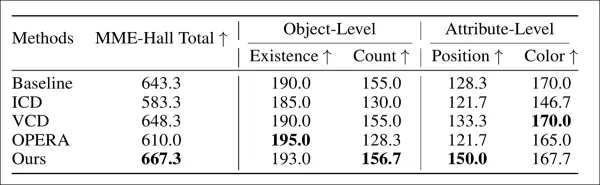
Leistungsvergleiche aus der dritten Testrunde auf MME.
Der letzte Haupttest wurde auf MME durchgeführt, die Ergebnisse sind oben dargestellt. In der Arbeit wird jedoch die Methode "OPERA" ohne Definition im Haupttext oder im Anhang erwähnt. Die Autoren behaupten zwar, dass MME sehr gut abschneidet, aber das Fehlen von Details zur Methode legt eine vorsichtige Interpretation der Ergebnisse nahe.
Alibaba Super Cup: Qwen3.8-Max debütiert mit verbesserten Coding- und BürotoolsAlibaba hat offiziell Qwen3.8-Max vorgestellt, ein hochmodernes Foundation-Modell mit 2,4 Billionen Parametern. Diese bedeutende KI-Entwicklung bietet erhebliche Leistungssteigerungen in Kernbereichen wie Programmierung und professionelle Büroaufgabe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
Durch das Klicken auf „Alle Cookies akzeptieren“ stimmen Sie zu, dass Cookies auf Ihrem Gerät gespeichert werden, um die Seitennavigation zu verbessern, die Seitennutzung zu analysieren und unsere Marketingbemühungen zu unterstützen.Datenschutzerklärung Hinweis
Beim Besuch einer Website kann diese Informationen in Ihrem Browser speichern oder abrufen, hauptsächlich in Form von Cookies. Diese Informationen können sich auf Sie, Ihre Präferenzen oder Ihr Gerät beziehen und dienen hauptsächlich dazu, dass die Website so funktioniert, wie Sie es erwarten. Die Informationen identifizieren Sie in der Regel nicht direkt, können Ihnen aber ein personalisierteres Web-Erlebnis bieten. Da wir Ihr Recht auf Privatsphäre respektieren, können Sie wählen, dass Sie bestimmte Arten von Cookies nicht zulassen. Klicken Sie auf die verschiedenen Kategorietitel, um mehr zu erfahren und unsere Standardeinstellungen zu ändern. Das Blockieren bestimmter Arten von Cookies kann jedoch Ihre Erfahrung auf der Website und die von uns angebotenen Dienste beeinträchtigen. DatenschutzerklärungErklärung
Einstellungen verwalten
Unbedingt erforderliche Cookies
Immer aktiv
Diese Cookies sind für die Funktionalität der Website erforderlich und können in unseren Systemen nicht deaktiviert werden. Sie werden normalerweise nur in Reaktion auf Ihre Aktionen gesetzt, die einer Dienstanfrage entsprechen, z. B. das Einstellen Ihrer Datenschutzpräferenzen, das Anmelden oder das Ausfüllen von Formularen. Sie können Ihren Browser so einstellen, dass diese Cookies blockiert oder Sie darüber benachrichtigt werden, aber einige Teile der Website werden dann nicht mehr funktionieren. Diese Cookies speichern keine personenbezogenen Daten.



 Heim
 Inside Details Exposed About Next-Gen Gemini: Strained Computing Power, Internal Teams Disagreed on Development Priorities and Resource Allocation
Berichten zufolge wurde der Start des hocherwarteten Next-Generation-Gemini-Modells von Google verschoben. Interne Uneinigkeiten über Entwicklungsprioritäten und Ressourcenallokation, kombiniert mit begrenzter Rechenkapazität und komplexen Genehmigun
 Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
 8 Tools
 xix.ai
Chatbot

 Kommentare (0)








 Inside Details Exposed About Next-Gen Gemini: Strained Computing Power, Internal Teams Disagreed on Development Priorities and Resource Allocation
Berichten zufolge wurde der Start des hocherwarteten Next-Generation-Gemini-Modells von Google verschoben. Interne Uneinigkeiten über Entwicklungsprioritäten und Ressourcenallokation, kombiniert mit begrenzter Rechenkapazität und komplexen Genehmigun
 OpenAI entkräftet Bedenken bezüglich des verlangsamen Wachstums und erklärt, dass mehrere Geschäftsbereiche ihre Expansion beschleunigen
Als Reaktion auf externe Kritik bezüglich des nachlassenden Umsatzwachstums und verpasster interner Zielvorgaben gab der KI-Pionier OpenAI am Dienstag, den 28. April, eine selbstbewusste Erklärung ab. Das Unternehmen präzisierte, dass seine Verbrauch
 Alibaba Super Cup: Qwen3.8-Max debütiert mit verbesserten Coding- und Bürotools
Alibaba hat offiziell Qwen3.8-Max vorgestellt, ein hochmodernes Foundation-Modell mit 2,4 Billionen Parametern. Diese bedeutende KI-Entwicklung bietet erhebliche Leistungssteigerungen in Kernbereichen wie Programmierung und professionelle Büroaufgabe


















