


 首頁
透過放大人工智慧圖像的缺陷來解決其幻覺問題
像 ChatGPT 這樣的視覺模型經常會捏造出圖像中遺漏的元素。一種新穎的方法可以減少這些錯誤,方法是從模型的標題中產生模型自己幻覺的細節的誇張版本,然後促請模型修改。這項技術不需要重新訓練或額外的資料,因此廣泛適用於各種模型和架構。
來自中國的一項新研究解決了人工智能生成的圖像和視頻中出現幻覺的頑固問題--這些細節明顯與用戶的提示相矛盾。
這個過程以傳統方式開始:模型描述一張圖片。然後,該標題被賦予一個文本到圖像模型,以產生一個新的圖像- 在此重建中任何額外的物件或特徵都會直接揭示模型最初的幻覺。透過比較原始與產生的影像,系統可以引導模型避免在未來的嘗試中重複這些錯誤。
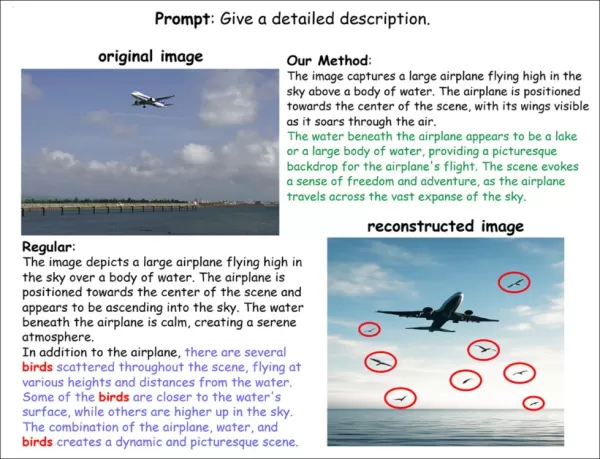
此圖顯示新技術如何偵測並盡量減少字幕幻覺。標準模型會錯誤地在圖像的描述中加入鳥類,而重建的版本會以視覺方式插入鳥類(以紅色強調)。新方法在保持描述準確性的同時,避免了這些虛構。來源:https://arxiv.org/pdf/2509.21997
該方法首先讓模型描述真實的圖像,有時包括實際上沒有出現的物件或細節。這些不準確的標題會產生突出錯誤的合成影像。透過比較真實與合成影像,系統可辨識導致編造內容的內部模式。
一旦識別出這些錯誤模式,它們就會被儲存起來以備將來使用。為新影像加上字幕時,系統會調整模型的內部訊號,使其遠離已知的幻覺觸發點。這種修正只需一次,不需要額外的資料、重新訓練或在測試期間產生影像。
纏結的挑戰
在本文的範例中,「纏結」可能解釋了為什麼鳥類會被加入到一張沒有鳥類的圖像中。
當模型強烈連結某些概念,因為它們經常一起出現在訓練資料中時,就會發生糾纏。在這裡,模型可能會經常遇到飛機與鳥類,因此產生了錯誤影響標題的聯想。
雖然提早結束訓練可以減少糾纏(增加模型彈性),但也會減少概念細節和解析度。開發人員長期面臨一個取捨的問題:是優先考量一個靈活、糾纏不清的模型,還是一個更容易產生聯想幻覺的模型?
理想的情況是,原始圖片的標題會逐項列出每一個存在的物件,讓模型可以將它們儲存為獨立、分散的項目。然而,SEO 驅動的標題做法和大規模的網路搜刮(在訓練強大的生成模型時很常見)往往無法達到這個標準。
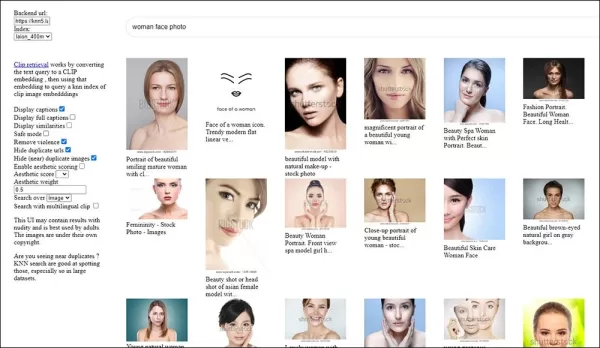
薄弱的標題會降低 LAION 影像對於訓練 Stable Diffusion 等模型的價值。標籤往往是膚淺、含糊不清,或是以 SEO 為重點,而非描述性的,這會妨礙模型學習詳細視覺概 念 (例如臉部特徵) 的能力。(原始來源為 https://rom1504.github.io/,現已停用)。
由於基礎修復不切實際,減少 LLM 和 VLM 幻覺的變通方法已成為重要的研究重點。新的中文方法在不同的架構和條件下進行測試,顯示出抑制「幻覺污染」的前景。
作者指出:
跨多種基準的廣泛實驗顯示,我們的方法在物件、屬性和關係層面上顯著減少了幻覺,同時在很大程度上保留了召回率和標題[豐富度]。
這篇題為Exposing Hallucinations To Suppress Them: VLMs Representation Editing With Generative Anchors 的論文來自中國科學技術大學和南京大學的研究人員。
方法的工作原理
研究人員開發了一套端對端的管道,用以揭露和抑制字幕幻覺:
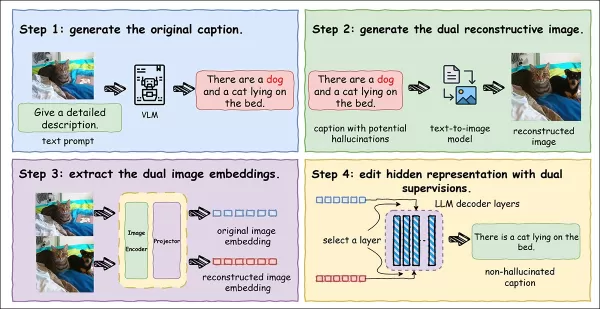
完整的管道圖解。視覺語言模型從輸入圖像產生標題,可能包括幻覺。該標題透過文字到圖像模型用於創建重構圖像,使錯誤清晰可見。來自兩張圖像的嵌入會引導內部調整,幫助模型在不降低標題品質的情況下,減少被濫用的細節。
視覺語言模型首先為真實的圖像加上標題,可能會創造一些物件或關係。然後,標題會產生一張重建的圖像,揭示出任何虛構的視覺差異。比較這兩張圖像,可以將微妙的文字錯誤轉化為可量測、可糾正的訊號。
為了阻止捏造,系統會比較原始影像 (可靠的參考) 與重建影像 (突顯錯誤)。每個圖像都會轉換成精簡的嵌入。透過調整內部表示,使其更貼近原始圖像,並與重建圖像分歧,模型便能以完全自我監督的方式進行自我修正。
這篇論文說明:
MLLMs 中的幻覺本質上是很難偵測到的,因為它們在語言上格式良好,與文字層級的忠實描述往往無法區分。差異不在於語言的可信度,而在於與視覺證據的錯位,而模型本身通常對此並不敏感。
'為了解決這個問題,我們引入了一種幻覺暴露機制,利用生成重組將隱含的不一致轉換為明確和可觀察的信號。
使用 FLUX.1-dev 文字到圖像模型,系統會根據標題重新製作一張圖像,誇大任何錯誤的細節。這些被誇大的錯誤可以幫助模型辨識並修正錯誤。
為了驗證這種方法,研究人員在標題中注入幻覺,產生重建的圖像,然後用 LLaVA 重新為它們加上標題。他們測量了原始標題與幻覺標題之間的語意相似度:
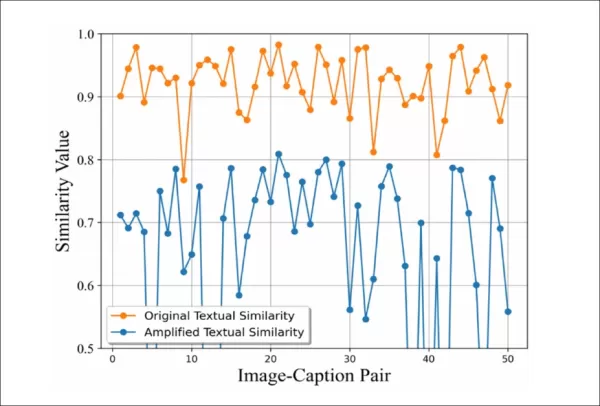
幻覺放大機制可視化細微的錯誤。每個點顯示一張圖片-字幕對的字幕相似度。橙色線(直接比較)保持在高水平,掩蓋了錯誤;藍色線(重構後)急劇下降,揭示了隱藏的幻覺作為可察覺的語義標記。
重構後的相似度明顯下降,顯示此方法有能力揭露細微的錯誤。
資料與測試
使用三個基準來驗證有效性:Caption Hallucination Assessment with Image Relevance(CHAIR);MLLM Evaluation(MME);以及Pooling-based Object Probing Evaluation(POPE)。
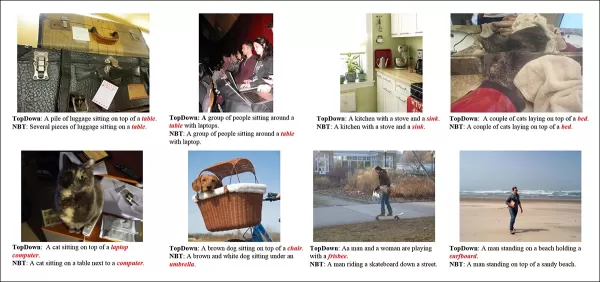
來自 CHAIR 發佈文件:由字幕系統 TopDown 和 NBT 產生的幻覺物件範例,其中發明了筆記型電腦、水槽或衝浪板等圖像中不存在的元素。來源:https://arxiv.org/pdf/1809.02156
幻覺率或召回率等標準指標可能會產生誤導-模型可能會透過產生含糊不清的字幕來避免錯誤。為了在準確性與完整性之間取得平衡,我們使用了綜合指標幻覺與回想率(HAR@β),以可調整的權重對這兩個因素的標題進行評分。
POPE 評估上下文敏感的物件幻覺,而 MME 則評估屬性層級的幻覺,兩者都是 Yes/No 的任務。
測試在 Microsoft COCO、A-OKVQA 和 GQA 等資料集上使用 Flux 模型和 LLaVA-v1.5-7B。潛在編輯針對模型的第二層,在所有測試中使用一致的超參數和溫度。
CHAIR 的初步結果如下*:
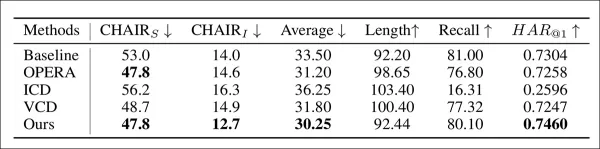
CHAIR 減緩幻覺基準的表現,以多項指標進行評估。
作者指出:
我們的方法在CHAIRS和CHAIRI[*] 上的表現持續優於其他基準[*],顯示出它在抑制幻覺方面的卓越效能。同時,雖然幾乎所有的方法在抑制幻覺時都會不可避免地降低召回率,反映出忠誠度與資訊性之間的取捨,但我們的方法卻達到最小的降幅。
'這證明我們的方法能夠捕捉到廣泛的地面真實對象。在 HAR@β 標準下,我們的方法獲得最高分,突顯其在維持涵蓋範圍的同時減少幻覺的能力。
強大的結果歸功於雙重監督:強化原始圖像的乾淨語意,同時抑制重構產生的誤導訊號。透過只針對與幻覺相關的方向,系統可以在不損失細節的情況下糾正錯誤。
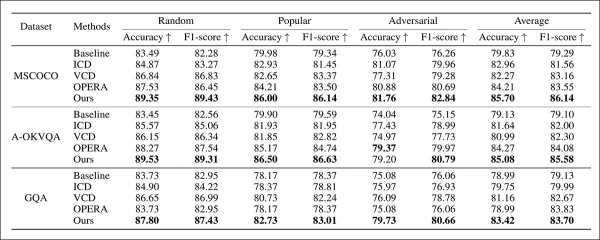
不同配置與資料集的 POPE 基準效能比較。
關於 POPE 的結果,論文指出:
可以觀察到,我們的方法在所有設定中都持續達到最佳效能。值得注意的是,我們的方法平均可達到 +5.95% 的準確率和 +6.85% 的 F1 分數,大幅領先其他免訓練方法。
'因此,這些結果證明我們的方法能在不同難度的情況下提供可靠且可通用的解決方案。
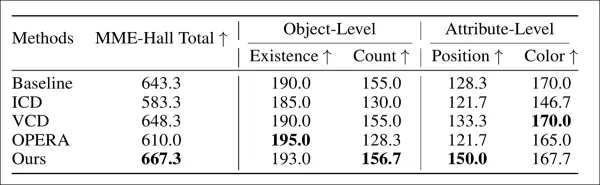
第三輪測試在 MME 上的效能比較。
最後的主要測試在 MME 上進行,結果如上所示。然而,論文在正文或附錄中提到「OPERA」這個方法,卻沒有下定義。雖然作者宣稱 MME 表現強勁,但由於缺乏方法細節,因此在詮釋這些結果時必須謹慎。
相關文章
 DeepMind執行長哈西里斯:我每天睡六個小時,通常在凌晨1點左右感到精力充沛。
Fortune 最近刊登了對谷歌 DeepMind 執行長 Demis Hassabis 的採訪,揭示了他對休息和生產力的非傳統方法。Hassabis 透露,他睡眠時間非常少,將清醒時間劃分為兩個不同的工作階段。關於他的睡眠習慣,Hassabis 表示:“我目標睡六小時,但我的習慣非同尋常。我可以在白天有效運作。”他強調,睡眠少於六小時會對大腦健康產生負面影響。Hassabis 於 2010 年聯合創立了 DeepMind(後被谷歌收購),並因其在蛋白質結構預測方面的開創性工作榮獲 20
儘管營收未達預期,OpenAI 與 Anthropic 仍爭奪市場份額
儘管近期有報導指出 OpenAI 未達營收目標,導致本週二科技股承壓,但私人人工智慧實驗室的投資者仍展現出韌性。資深投資者已確認,儘管媒體報導負面,他們仍不會削減投資。分析師認為當前的 AI 競逐仍處於初期階段,因此排除「贏家通吃」的結果。儘管高昂的運算成本對營收造成壓力,但各實驗室可透過調高訂閱費來提升獲利能力。產業格局正經歷微妙的變化與 OpenAI 不同,競爭對手 Anthropic 獲得了
加州自動駕駛合規:罰單、地理圍欄與 100 萬英里的新時代
Guident 在南佛羅里達州營運一輛 AuveTech 接駁車,並運用其遠端監控技術,管理西棕櫚灘的一條四英里路線以及博卡拉頓的一條一英里路線。| 圖片來源:Guident加州正重新定義無人駕駛車輛的監管格局,從科技產業的「快速行動、打破常規」心態,轉向嚴格的問責制與嚴謹的行駛里程要求。Guident 執行董事長兼執行長哈羅德·布勞恩(Harold Braun)在《機器人報告》(The Robo
相關專題推薦
音樂創作
 用於混音製作、取樣準備及卡拉OK母帶處理的 AI 聲部分離工具
2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
 8 個工具
 xix.ai
數據分析
用於收入看板、轉化漏斗分析及產品指標分析的 AI SQL 助手
2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai
音樂創作
最佳用於歌曲草稿的 AI 旋律創作工具
2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai
聊天機器人
最適合面試練習的 AI 對話訓練工具
2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai
設計與藝術
最適合進行創意實驗的 AI 風格轉移工具
2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai
漫畫創作
最適合視覺敘事的 AI 對話氣泡工具
2026 年最新、最受好評的視覺敘事 AI 對話氣泡工具,現已登陸 XIX.AI!這份精心挑選的合集收錄了強大且具顛覆性的工具,能協助創作者提升生產力並突破創作瓶頸。 查看免費版與付費版的比較、參考實際測試結果,並查閱最新排行榜,找出最適合打造引人入勝視覺敘事的必試解決方案。立即探索,發掘您的理想工具!
10 個工具
xix.ai

 評論 (0)
0/500
像 ChatGPT 這樣的視覺模型經常會捏造出圖像中遺漏的元素。一種新穎的方法可以減少這些錯誤,方法是從模型的標題中產生模型自己幻覺的細節的誇張版本,然後促請模型修改。這項技術不需要重新訓練或額外的資料,因此廣泛適用於各種模型和架構。
來自中國的一項新研究解決了人工智能生成的圖像和視頻中出現幻覺的頑固問題--這些細節明顯與用戶的提示相矛盾。
這個過程以傳統方式開始:模型描述一張圖片。然後,該標題被賦予一個文本到圖像模型,以產生一個新的圖像- 在此重建中任何額外的物件或特徵都會直接揭示模型最初的幻覺。透過比較原始與產生的影像,系統可以引導模型避免在未來的嘗試中重複這些錯誤。

此圖顯示新技術如何偵測並盡量減少字幕幻覺。標準模型會錯誤地在圖像的描述中加入鳥類,而重建的版本會以視覺方式插入鳥類(以紅色強調)。新方法在保持描述準確性的同時,避免了這些虛構。來源:https://arxiv.org/pdf/2509.21997
該方法首先讓模型描述真實的圖像,有時包括實際上沒有出現的物件或細節。這些不準確的標題會產生突出錯誤的合成影像。透過比較真實與合成影像,系統可辨識導致編造內容的內部模式。
一旦識別出這些錯誤模式,它們就會被儲存起來以備將來使用。為新影像加上字幕時,系統會調整模型的內部訊號,使其遠離已知的幻覺觸發點。這種修正只需一次,不需要額外的資料、重新訓練或在測試期間產生影像。
纏結的挑戰
在本文的範例中,「纏結」可能解釋了為什麼鳥類會被加入到一張沒有鳥類的圖像中。
當模型強烈連結某些概念,因為它們經常一起出現在訓練資料中時,就會發生糾纏。在這裡,模型可能會經常遇到飛機與鳥類,因此產生了錯誤影響標題的聯想。
雖然提早結束訓練可以減少糾纏(增加模型彈性),但也會減少概念細節和解析度。開發人員長期面臨一個取捨的問題:是優先考量一個靈活、糾纏不清的模型,還是一個更容易產生聯想幻覺的模型?
理想的情況是,原始圖片的標題會逐項列出每一個存在的物件,讓模型可以將它們儲存為獨立、分散的項目。然而,SEO 驅動的標題做法和大規模的網路搜刮(在訓練強大的生成模型時很常見)往往無法達到這個標準。

薄弱的標題會降低 LAION 影像對於訓練 Stable Diffusion 等模型的價值。標籤往往是膚淺、含糊不清,或是以 SEO 為重點,而非描述性的,這會妨礙模型學習詳細視覺概 念 (例如臉部特徵) 的能力。(原始來源為 https://rom1504.github.io/,現已停用)。
由於基礎修復不切實際,減少 LLM 和 VLM 幻覺的變通方法已成為重要的研究重點。新的中文方法在不同的架構和條件下進行測試,顯示出抑制「幻覺污染」的前景。
作者指出:
跨多種基準的廣泛實驗顯示,我們的方法在物件、屬性和關係層面上顯著減少了幻覺,同時在很大程度上保留了召回率和標題[豐富度]。
這篇題為Exposing Hallucinations To Suppress Them: VLMs Representation Editing With Generative Anchors 的論文來自中國科學技術大學和南京大學的研究人員。
方法的工作原理
研究人員開發了一套端對端的管道,用以揭露和抑制字幕幻覺:

完整的管道圖解。視覺語言模型從輸入圖像產生標題,可能包括幻覺。該標題透過文字到圖像模型用於創建重構圖像,使錯誤清晰可見。來自兩張圖像的嵌入會引導內部調整,幫助模型在不降低標題品質的情況下,減少被濫用的細節。
視覺語言模型首先為真實的圖像加上標題,可能會創造一些物件或關係。然後,標題會產生一張重建的圖像,揭示出任何虛構的視覺差異。比較這兩張圖像,可以將微妙的文字錯誤轉化為可量測、可糾正的訊號。
為了阻止捏造,系統會比較原始影像 (可靠的參考) 與重建影像 (突顯錯誤)。每個圖像都會轉換成精簡的嵌入。透過調整內部表示,使其更貼近原始圖像,並與重建圖像分歧,模型便能以完全自我監督的方式進行自我修正。
這篇論文說明:
MLLMs 中的幻覺本質上是很難偵測到的,因為它們在語言上格式良好,與文字層級的忠實描述往往無法區分。差異不在於語言的可信度,而在於與視覺證據的錯位,而模型本身通常對此並不敏感。
'為了解決這個問題,我們引入了一種幻覺暴露機制,利用生成重組將隱含的不一致轉換為明確和可觀察的信號。
使用 FLUX.1-dev 文字到圖像模型,系統會根據標題重新製作一張圖像,誇大任何錯誤的細節。這些被誇大的錯誤可以幫助模型辨識並修正錯誤。
為了驗證這種方法,研究人員在標題中注入幻覺,產生重建的圖像,然後用 LLaVA 重新為它們加上標題。他們測量了原始標題與幻覺標題之間的語意相似度:

幻覺放大機制可視化細微的錯誤。每個點顯示一張圖片-字幕對的字幕相似度。橙色線(直接比較)保持在高水平,掩蓋了錯誤;藍色線(重構後)急劇下降,揭示了隱藏的幻覺作為可察覺的語義標記。
重構後的相似度明顯下降,顯示此方法有能力揭露細微的錯誤。
資料與測試
使用三個基準來驗證有效性:Caption Hallucination Assessment with Image Relevance(CHAIR);MLLM Evaluation(MME);以及Pooling-based Object Probing Evaluation(POPE)。

來自 CHAIR 發佈文件:由字幕系統 TopDown 和 NBT 產生的幻覺物件範例,其中發明了筆記型電腦、水槽或衝浪板等圖像中不存在的元素。來源:https://arxiv.org/pdf/1809.02156
幻覺率或召回率等標準指標可能會產生誤導-模型可能會透過產生含糊不清的字幕來避免錯誤。為了在準確性與完整性之間取得平衡,我們使用了綜合指標幻覺與回想率(HAR@β),以可調整的權重對這兩個因素的標題進行評分。
POPE 評估上下文敏感的物件幻覺,而 MME 則評估屬性層級的幻覺,兩者都是 Yes/No 的任務。
測試在 Microsoft COCO、A-OKVQA 和 GQA 等資料集上使用 Flux 模型和 LLaVA-v1.5-7B。潛在編輯針對模型的第二層,在所有測試中使用一致的超參數和溫度。
CHAIR 的初步結果如下*:

CHAIR 減緩幻覺基準的表現,以多項指標進行評估。
作者指出:
我們的方法在CHAIRS和CHAIRI[*] 上的表現持續優於其他基準[*],顯示出它在抑制幻覺方面的卓越效能。同時,雖然幾乎所有的方法在抑制幻覺時都會不可避免地降低召回率,反映出忠誠度與資訊性之間的取捨,但我們的方法卻達到最小的降幅。
'這證明我們的方法能夠捕捉到廣泛的地面真實對象。在 HAR@β 標準下,我們的方法獲得最高分,突顯其在維持涵蓋範圍的同時減少幻覺的能力。
強大的結果歸功於雙重監督:強化原始圖像的乾淨語意,同時抑制重構產生的誤導訊號。透過只針對與幻覺相關的方向,系統可以在不損失細節的情況下糾正錯誤。

不同配置與資料集的 POPE 基準效能比較。
關於 POPE 的結果,論文指出:
可以觀察到,我們的方法在所有設定中都持續達到最佳效能。值得注意的是,我們的方法平均可達到 +5.95% 的準確率和 +6.85% 的 F1 分數,大幅領先其他免訓練方法。
'因此,這些結果證明我們的方法能在不同難度的情況下提供可靠且可通用的解決方案。

第三輪測試在 MME 上的效能比較。
最後的主要測試在 MME 上進行,結果如上所示。然而,論文在正文或附錄中提到「OPERA」這個方法,卻沒有下定義。雖然作者宣稱 MME 表現強勁,但由於缺乏方法細節,因此在詮釋這些結果時必須謹慎。








 DeepMind執行長哈西里斯:我每天睡六個小時,通常在凌晨1點左右感到精力充沛。
Fortune 最近刊登了對谷歌 DeepMind 執行長 Demis Hassabis 的採訪,揭示了他對休息和生產力的非傳統方法。Hassabis 透露,他睡眠時間非常少,將清醒時間劃分為兩個不同的工作階段。關於他的睡眠習慣,Hassabis 表示:“我目標睡六小時,但我的習慣非同尋常。我可以在白天有效運作。”他強調,睡眠少於六小時會對大腦健康產生負面影響。Hassabis 於 2010 年聯合創立了 DeepMind(後被谷歌收購),並因其在蛋白質結構預測方面的開創性工作榮獲 20
 儘管營收未達預期,OpenAI 與 Anthropic 仍爭奪市場份額
儘管近期有報導指出 OpenAI 未達營收目標,導致本週二科技股承壓,但私人人工智慧實驗室的投資者仍展現出韌性。資深投資者已確認,儘管媒體報導負面,他們仍不會削減投資。分析師認為當前的 AI 競逐仍處於初期階段,因此排除「贏家通吃」的結果。儘管高昂的運算成本對營收造成壓力,但各實驗室可透過調高訂閱費來提升獲利能力。產業格局正經歷微妙的變化與 OpenAI 不同,競爭對手 Anthropic 獲得了
加州自動駕駛合規:罰單、地理圍欄與 100 萬英里的新時代
Guident 在南佛羅里達州營運一輛 AuveTech 接駁車,並運用其遠端監控技術,管理西棕櫚灘的一條四英里路線以及博卡拉頓的一條一英里路線。| 圖片來源:Guident加州正重新定義無人駕駛車輛的監管格局,從科技產業的「快速行動、打破常規」心態,轉向嚴格的問責制與嚴謹的行駛里程要求。Guident 執行董事長兼執行長哈羅德·布勞恩(Harold Braun)在《機器人報告》(The Robo

2026年最新、最優秀且評分最高的AI音軌分離工具彙總,專為混音製作、取樣準備以及卡拉OK音訊處理而設計。這些功能強大的創新工具經過實際測試,能夠實現精準的音訊分離,顯著提升工作效率。XIX.AI每週都會更新免費的付費產品對比指南,幫助您找到最適合自身需求的工具。立即探索,發揮您的AI優勢。
8 個工具
xix.ai

2026年最新最優秀的AI SQL輔助工具排名揭曉!XIX.AI精心挑選了一系列功能強大的工具,這些工具會定期更新,並透過真實的場景測試來驗證其效能。使用這些值得嘗試的工具,您可以快速生成精準的收入分析報表、分析銷售流程,並追蹤產品各項指標,從而大幅提升工作效率。立即探索,找到最適合您的資料驅動決策工具!238個字元
9 個工具
xix.ai

2026 年最新最佳頂級評分 AI 旋律創作工具,助力歌曲草稿創作!XIX.AI 精心策劃了一套極具影響力且經過嚴格真實世界測試的變革性合集,旨在提供最佳的創作體驗。您可以找到詳細的免費與付費版對比、精準的排名以及必試選項,這些工具旨在幫助您輕鬆創作出令人驚豔的歌曲草稿,並顯著提升您的創意生產力。立即探索,發現您的完美工具!
8 個工具
xix.ai

2026 年最新、最受好評的 AI 面試對話訓練工具,盡在 XIX.AI!這份精心精選的清單收錄了多款功能強大、顛覆傳統的工具,這些工具均經過嚴格的實戰測試,能提供精準的回饋。 您將在此找到免費版與付費版的比較分析,以及詳細的排名榜單,助您挑選必試的選項,從而提升自信與技能。立即探索,發掘助您在面試中脫穎而出的完美工具!
12 個工具
xix.ai

2026 年最新、最佳且評價最高的 AI 風格轉移工具,助您進行創意實驗!XIX.AI 精心精選了一系列強大且具革命性的必試工具,這些工具經實際測試與嚴格評比,能帶來卓越成果。這些頂尖解決方案能加速內容創作並開啟無盡的創意可能性,協助創作者顯著提升生產力。 立即探索,找出最適合您的工具,並從今天開始創作吧!
9 個工具
xix.ai

2026 年最新、最受好評的視覺敘事 AI 對話氣泡工具,現已登陸 XIX.AI!這份精心挑選的合集收錄了強大且具顛覆性的工具,能協助創作者提升生產力並突破創作瓶頸。 查看免費版與付費版的比較、參考實際測試結果,並查閱最新排行榜,找出最適合打造引人入勝視覺敘事的必試解決方案。立即探索,發掘您的理想工具!
10 個工具
xix.ai












