Les modèles de vision comme ChatGPT inventent souvent des éléments manquants dans une image. Une nouvelle approche permet de réduire ces erreurs en générant des versions exagérées des détails hallucinés par le modèle à partir de ses légendes, puis en l'invitant à les réviser. Cette technique ne nécessite pas de recyclage ni de données supplémentaires, ce qui la rend largement applicable à divers modèles et architectures.
Une nouvelle étude chinoise s'attaque au problème épineux des hallucinations dans les images et les vidéos générées par l'IA - des détails qui contredisent clairement l'invitation de l'utilisateur.
Le processus commence de manière classique : le modèle décrit une image. Cette légende est ensuite introduite dans un modèle texte-image pour produire une nouvelle image - toutobjet ou caractéristique supplémentaire dans cette reconstruction révèle directement les hallucinations initiales du modèle. En comparant l'image originale et l'image générée, le système guide le modèle pour qu'il évite de répéter ces erreurs lors de ses prochaines tentatives.
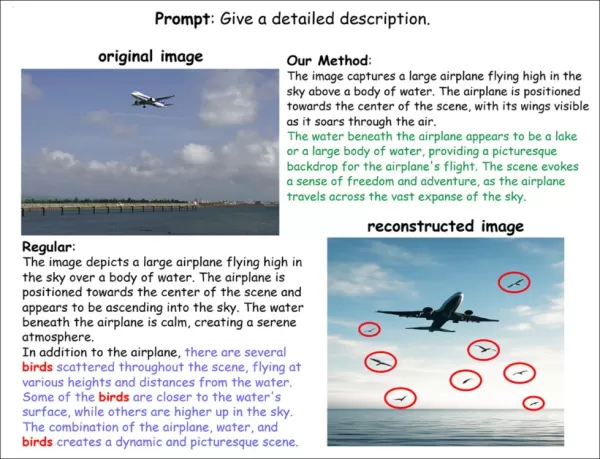
Ce diagramme montre comment la nouvelle technique détecte et minimise les hallucinations des légendes. Un modèle standard ajoute incorrectement des oiseaux à sa description d'une image, et la version reconstruite les insère visuellement (surligné en rouge). La nouvelle méthode permet d'éviter ces fabrications tout en maintenant la précision de la description. Source : https://arxiv.org/pdf/2509.21997
La méthode commence par demander au modèle de décrire des images réelles, en incluant parfois des objets ou des détails qui ne sont pas réellement présents. Ces légendes inexactes génèrent des images synthétiques qui mettent en évidence les erreurs. En comparant les images réelles et synthétiques, le système identifie les schémas internes qui conduisent à des contenus inventés.
Une fois ces modèles d'erreurs reconnus, ils sont stockés pour une utilisation ultérieure. Lors du sous-titrage d'une nouvelle image, le système ajuste les signaux internes du modèle, en l 'éloignant des déclencheurs d'hallucinations connus. Cette correction s'effectue en une seule fois, sans données supplémentaires, sans réentraînement et sans génération d'images pendant les tests.
Le défi de l'enchevêtrement
Dans l'exemple de l'article, l'"enchevêtrement" explique probablement pourquoi des oiseaux ont été ajoutés à une image qui n'en contenait pas.
L'enchevêtrement se produit lorsqu'un modèle associe fortement certains concepts parce qu'ils apparaissent souvent ensemble dans ses données d'apprentissage. Dans le cas présent, le modèle peut avoir fréquemment rencontré des avions avec des oiseaux, créant ainsi une association qui influence à tort la légende.
Si le fait de terminer la formation plus tôt peut réduire l'enchevêtrement (en augmentant la flexibilité du modèle), cela diminue également les détails conceptuels et la résolution. Les développeurs sont confrontés à un compromis permanent : donner la priorité à un modèle flexible et démêlé ou à un modèle plus génératif susceptible d'être associé à des hallucinations ?
Idéalement, les légendes des images sources devraient détailler chaque objet présent, ce qui permettrait au modèle de les stocker en tant qu'entrées distinctes et démêlées. Toutefois, les pratiques de sous-titrage axées sur le référencement et le grattage du web à grande échelle - courant dans la formation de modèles génératifs puissants - ne respectent souvent pas cette norme.
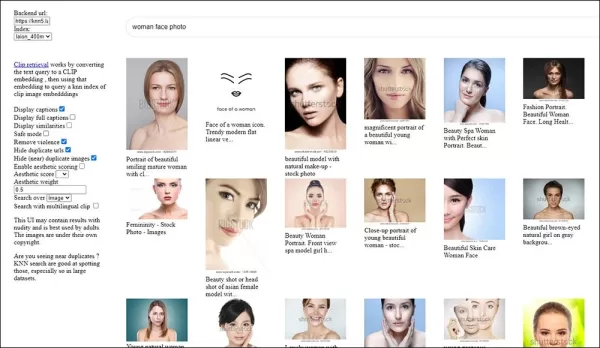
Les légendes faibles réduisent la valeur des images LAION pour l'apprentissage de modèles tels que la diffusion stable. Les étiquettes sont souvent superficielles, vagues ou axées sur le référencement plutôt que descriptives, ce qui empêche le modèle d'apprendre des concepts visuels détaillés tels que les traits du visage. (La source originale était https://rom1504.github.io/, qui n'existe plus aujourd'hui).
Étant donné qu'il n'est pas possible d'apporter une solution fondamentale, les solutions de contournement visant à réduire les hallucinations dans les LLM et les VLM sont devenues un axe de recherche important. La nouvelle méthode chinoise, testée sur différentes architectures et conditions, semble prometteuse pour réduire la "pollution par les hallucinations".
Les auteurs déclarent :
Des expériences approfondies sur de nombreux points de référence montrent que notre méthode réduit considérablement les hallucinations au niveau des objets, des attributs et des relations, tout en préservant largement le rappel et la [richesse] des légendes.
L'article, intitulé Exposing Hallucinations To Suppress Them : VLMs Representation Editing With Generative Anchors, a été rédigé par des chercheurs de l'université des sciences et technologies de Chine et de l'université de Nanjing.
Fonctionnement de la méthode
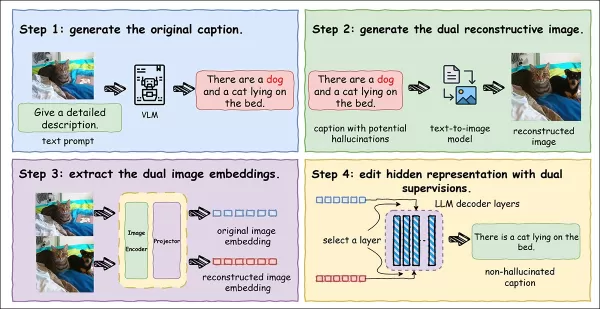
Les chercheurs ont mis au point un pipeline de bout en bout pour exposer et supprimer les hallucinations des légendes :
L'illustration complète du pipeline. Un modèle de langage visuel génère une légende à partir d'une image d'entrée, pouvant inclure des hallucinations. Cette légende est utilisée pour créer une image reconstruite à l'aide d'un modèle texte-image, ce qui rend les erreurs visibles. Les enregistrements des deux images guident les ajustements internes, aidant le modèle à réduire les détails inventés sans perdre la qualité de la légende.
Un modèle de langage visuel commence par légender une image réelle, en inventant éventuellement des objets ou des relations. Cette légende génère ensuite une image reconstruite, révélant toute invention sous la forme d'écarts visuels. La comparaison des deux images transforme les subtiles erreurs de texte en signaux mesurables et corrigeables.
Pour décourager les inventions, le système compare l'image originale (une référence fiable) à l'image reconstituée (mettant en évidence les erreurs). Chaque image est convertie en une représentation compacte. En ajustant les représentations internes pour qu'elles s'alignent plus étroitement sur l'original et divergent de la reconstruction, le modèle s'auto-corrige de manière entièrement auto-supervisée.
L'article explique :
Les hallucinations dans les MLLM sont intrinsèquement difficiles à détecter parce qu'elles sont linguistiquement bien formées et souvent impossibles à distinguer des descriptions fidèles au niveau du texte. L'écart ne réside pas dans la plausibilité de la langue, mais dans le décalage avec les preuves visuelles, auquel le modèle lui-même est généralement insensible.
Pour y remédier, nous introduisons un mécanisme d'exposition aux hallucinations qui s'appuie sur la reconstruction générative pour convertir les incohérences implicites en signaux explicites et observables.
À l'aide du modèle texte-image FLUX.1-dev, le système recrée une image à partir de la légende, en exagérant les détails erronés. Ces erreurs amplifiées aident le modèle à reconnaître et à corriger ses erreurs.
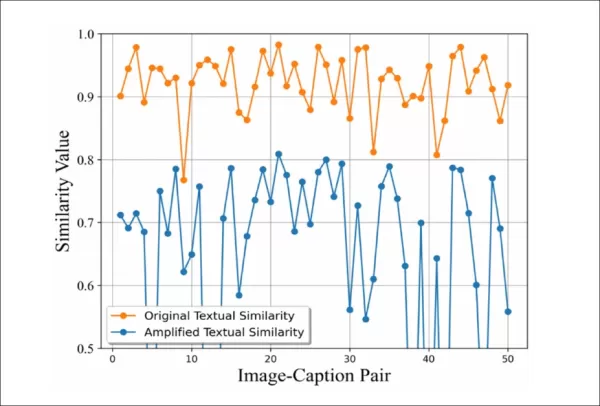
Pour valider l'approche, les chercheurs ont injecté des hallucinations dans les légendes, généré des images reconstruites, puis les ont recréées avec LLaVA. Ils ont mesuré la similarité sémantique entre les légendes originales et les légendes hallucinées :
Le mécanisme d'amplification des hallucinations permet de visualiser les erreurs subtiles. Chaque point indique la similarité des légendes pour une paire image-légende. La ligne orange (comparaison directe) reste élevée, masquant les erreurs ; la ligne bleue (post-reconstruction) chute brusquement, révélant les hallucinations cachées comme des marqueurs sémantiques détectables.
La similarité a diminué de manière significative après la reconstruction, ce qui démontre la capacité de la méthode à révéler des erreurs subtiles.
Données et tests
L'efficacité de la méthode a été validée à l'aide de trois critères de référence : Caption Hallucination Assessment with Image Relevance (CHAIR) ; MLLM Evaluation (MME ) ; et Pooling-based Object Probing Evaluation (POPE).
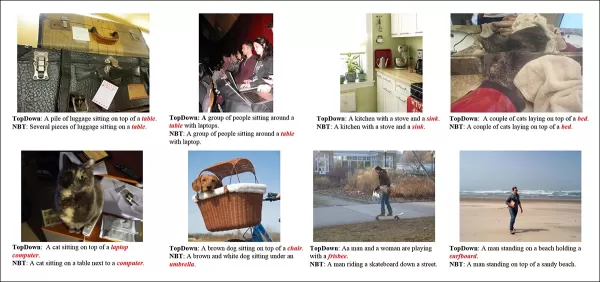
Extrait du document de publication de CHAIR : exemples d'objets hallucinés générés par les systèmes de sous-titrage TopDown et NBT, qui inventent des éléments tels que des ordinateurs portables, des éviers ou des planches de surf qui ne sont pas présents dans l'image. Source : https://arxiv.org/pdf/1809.02156
Les mesures standard telles que le taux d'hallucination ou le rappel peuvent être trompeuses - les modèles peuvent éviter les erreurs en produisant des légendes vagues. Pour équilibrer la précision et l'exhaustivité, la mesure combinée Hallucination et Rappel (HAR@β) a été utilisée, en notant les légendes sur les deux facteurs avec une pondération ajustable.
POPE a évalué les hallucinations d'objets sensibles au contexte, et MME a évalué les hallucinations au niveau de l'attribut, toutes deux sous forme de tâches Oui/Non.
Les tests ont utilisé le modèle Flux et LLaVA-v1.5-7B sur des ensembles de données comprenant Microsoft COCO, A-OKVQA et GQA. L'édition latente a ciblé la deuxième couche des modèles, avec des hyperparamètres et une température cohérents dans tous les tests.
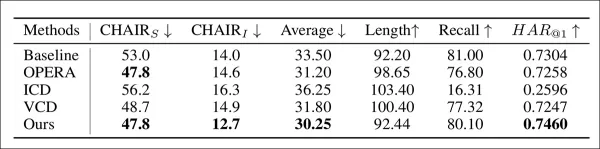
Les premiers résultats de CHAIR sont présentés ci-dessous* :
Performance sur le benchmark CHAIR pour l'atténuation des hallucinations, évaluée avec de multiples métriques.
Les auteurs notent :
Notre méthode surpasse systématiquement les autres méthodes de référence sur CHAIRS et CHAIRI[*], ce qui démontre son efficacité supérieure dans la suppression des hallucinations. Par ailleurs, bien que presque toutes les méthodes réduisent inévitablement le rappel tout en supprimant les hallucinations, ce qui reflète un compromis entre la fidélité et l'informativité, notre approche obtient la baisse la plus faible.
Cela prouve que notre méthode permet de capturer un large éventail d'objets authentiques. Avec la métrique HAR@β, notre méthode obtient le score le plus élevé, soulignant sa capacité à réduire les hallucinations tout en maintenant la couverture.
Les bons résultats sont attribués à la double supervision : renforcer la sémantique propre de l'image originale tout en supprimant les signaux trompeurs de la reconstruction. En ciblant uniquement les directions liées aux hallucinations, le système corrige les erreurs sans perdre de détails.
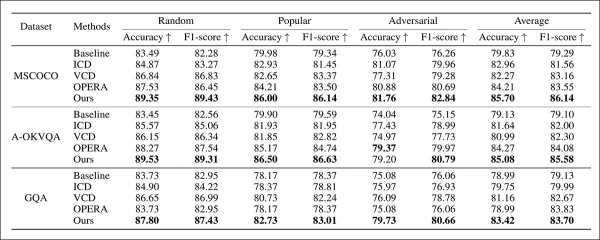
Comparaison des performances sur le benchmark POPE à travers différentes configurations et ensembles de données.
En ce qui concerne les résultats de l'étude POPE, l'article indique ce qui suit :
On peut observer que notre méthode obtient systématiquement les meilleures performances dans toutes les configurations. Notamment, notre méthode peut atteindre une précision de +5,95 % et un score F1 de +6,85 % en moyenne, ce qui surpasse largement les autres approches sans formation.
Ces résultats démontrent donc que notre méthode fournit une solution fiable et généralisable à différents niveaux de difficulté.
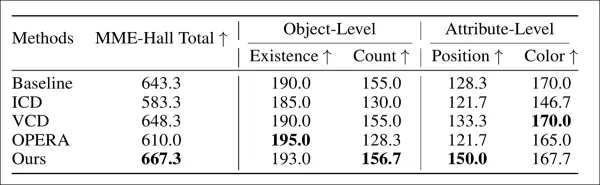
Comparaisons des performances lors du troisième cycle de tests sur MME.
Le dernier test principal a été effectué sur MME, et les résultats sont présentés ci-dessus. Cependant, l'article mentionne la méthode "OPERA" sans la définir dans le texte principal ou dans l'annexe. Alors que les auteurs revendiquent de bonnes performances sur MME, le manque de détails sur la méthode incite à la prudence dans l'interprétation de ces résultats.
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
En cliquant sur "Accepter tous les cookies", vous consentez au stockage de cookies sur votre appareil afin d’améliorer la navigation sur le site, d’analyser l’utilisation du site et de soutenir nos efforts marketing.Politique de confidentialité Avis
Lorsque vous visitez un site web, il peut stocker ou récupérer des informations sur votre navigateur, principalement sous forme de cookies. Ces informations peuvent concerner vous, vos préférences ou votre appareil et sont principalement utilisées pour faire fonctionner le site comme vous vous y attendez. Ces informations n’identifient généralement pas directement vous-même, mais elles peuvent vous offrir une expérience web plus personnalisée. Parce que nous respectons votre droit à la vie privée, vous pouvez choisir de ne pas autoriser certains types de cookies. Cliquez sur les différents titres de catégorie pour en savoir plus et modifier nos paramètres par défaut. Cependant, bloquer certains types de cookies peut affecter votre expérience sur le site et les services que nous sommes en mesure de proposer. Politique de confidentialitéDéclaration
Gérer les préférences
Cookie strictement nécessaire
Toujours actif
Ces cookies sont nécessaires au fonctionnement du site web et ne peuvent pas être désactivés dans nos systèmes. Ils ne sont généralement définis qu’en réponse à des actions que vous effectuez qui équivalent à une demande de services, telles que la configuration de vos préférences de confidentialité, la connexion ou le remplissage de formulaires. Vous pouvez configurer votre navigateur pour bloquer ces cookies ou vous alerter à leur sujet, mais certaines parties du site ne fonctionneront alors plus. Ces cookies ne stockent aucune information permettant d’identifier personnellement.



 Maison
 Cradle et Lundbeck concluent un partenariat dans le domaine des biothérapies et de l'intelligence artificielle
Lundbeck s'appuie sur la plateforme de conception de protéines basée sur l'IA de Cradle pour créer des candidats-médicaments de pointe, dans le but d'accélérer les avancées dans le domaine des traitem
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
 10 outils
 xix.ai
Éducation et apprentissage

 commentaires (0)








 Cradle et Lundbeck concluent un partenariat dans le domaine des biothérapies et de l'intelligence artificielle
Lundbeck s'appuie sur la plateforme de conception de protéines basée sur l'IA de Cradle pour créer des candidats-médicaments de pointe, dans le but d'accélérer les avancées dans le domaine des traitem
 Comment optimiser les Core Web Vitals pour améliorer son référencement naturel
Créez un site web gratuit avec un nom de domaine et un hébergement offertsIntroductionPartie 1 : Lancer votre site web gratuitementÉtape 1 : Créer un compte sur profreehostÉtape 2 : Obtenir votre nom
 Samsung va fournir de la mémoire HBM4 à OpenAI, remettant ainsi en cause la position dominante de NVIDIA dans le domaine de l'IA
Afin de ne plus dépendre de l’infrastructure informatique de NVIDIA, OpenAI développe rapidement ses activités dans le domaine du matériel propriétaire, en s’associant au leader sud-coréen des semi-co


















