


 Дом
QwenLong-L1 решает сложные задачи логического мышления, выходящие за рамки возможностей современных LLM
Alibaba Group представила QwenLong-L1, новую платформу, разработанную для расширения возможностей крупных языковых моделей (LLM) в области анализа исключительно длинных документов. Этот прорыв может стать толчком для создания нового поколения корпоративных приложений, требующих глубокого понимания и тщательного анализа обширных материалов, включая комплексные корпоративные отчеты, подробные финансовые отчеты и сложные юридические соглашения.
Препятствие для рассуждений ИИ с длинными формами
Недавние достижения в области крупных моделей рассуждений (LRM), особенно благодаря обучению с подкреплением (RL), значительно повысили их способности к решению проблем. Исследования показывают, что точная настройка RL наделяет LRM формой «медленного мышления», сходной с человеческим познанием, что позволяет им разрабатывать сложные стратегии для решения запутанных задач.
Однако эти достижения в основном ограничиваются работой с относительно короткими текстовыми фрагментами, обычно около 4000 токенов. Существенным препятствием остается масштабирование этой способности к рассуждению на гораздо более длинные контексты, например 120 000 токенов. Эффективное рассуждение в длинных формах требует твердого понимания всего документа и способности к многоэтапному анализу. «Это ограничение значительно затрудняет практическое использование, связанное с внешними знаниями, например, в глубоких исследованиях, где LRM необходимо собирать и обрабатывать информацию из источников, богатых данными», — отмечают разработчики QwenLong-L1 в своей исследовательской работе.
Команда формулирует эти препятствия в рамках концепции «RL с рассуждениями в длинном контексте». В отличие от рассуждений в коротком контексте, которые часто используют внутренние знания модели, этот подход требует от моделей точного поиска и закрепления релевантных фактов в длинных входных данных. Только тогда они могут построить логические цепочки рассуждений на основе этой извлеченной информации.
Обучение моделей для этого с помощью RL является сложной задачей, которая часто приводит к неэффективному обучению и нестабильной оптимизации. Модели часто не могут сходиться к эффективным решениям или теряют способность исследовать различные пути рассуждений.
QwenLong-L1: структурированная многоэтапная структура
QwenLong-L1 — это структура обучения с подкреплением, созданная для того, чтобы помочь LRM эволюционировать от обработки коротких текстов к надежному обобщению в длинных контекстах. Она улучшает существующие LRM с коротким контекстом посредством целенаправленного поэтапного процесса:
Разминка с контролируемой тонкой настройкой (SFT): сначала модель проходит SFT с использованием примеров рассуждений в длинном контексте. Этот этап создает прочную основу, обучая модель точно закреплять информацию из длинных документов и развивать основные навыки понимания контекста, генерации логических цепочек и извлечения ответов.
Поэтапное RL с использованием учебной программы: здесь модель проходит обучение в несколько этапов, на которых длина целевого документа постепенно увеличивается. Этот пошаговый метод, основанный на учебной программе, помогает модели постепенно адаптировать свои стратегии рассуждений от более коротких к все более длинным текстам, избегая нестабильности, связанной с резким воздействием обширных документов.
Ретроспективная выборка с учетом сложности: на заключительном этапе используются самые сложные примеры из предыдущих этапов обучения. Приоритезация сложных примеров гарантирует, что модель продолжает учиться на сложных задачах и стимулирует ее к поиску более разнообразных и сложных путей рассуждения.
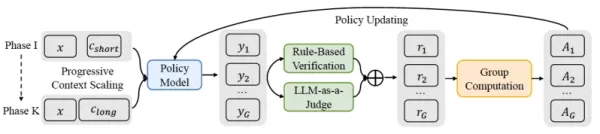
Процесс QwenLong-L1 Источник: arXiv Помимо этого структурированного обучения, QwenLong-L1 использует специальную систему вознаграждений. В то время как при обучении для задач с коротким контекстом часто используются строгие вознаграждения, основанные на правилах (например, за правильный математический ответ), QwenLong-L1 использует гибридный механизм. Он сочетает в себе проверку точности на основе правил с «LLM-as-a-judge», который сравнивает семантическое значение сгенерированного ответа с эталоном. Это позволяет с большей гибкостью оценивать различные способы формулирования правильных ответов в длинных, многозначных документах.
Оценка производительности QwenLong-L1
Команда Alibaba тестировала QwenLong-L1 в основном с помощью документального вопросно-ответного теста (DocQA), задачи, которая очень актуальна для потребностей предприятий, где ИИ должен расшифровывать плотные документы, чтобы отвечать на сложные запросы.
Результаты семи тестов DocQA с длинным контекстом продемонстрировали преимущества QwenLong-L1. Модель QWENLONG-L1-32B (на основе DeepSeek-R1-Distill-Qwen-32B) достигла производительности, сопоставимой с Anthropic's Claude-3.7 Sonnet Thinking, и превзошла такие модели, как OpenAI's o3-mini и Qwen3-235B-A22B. Меньшая модель QWENLONG-L1-14B также превзошла Gemini 2.0 Flash Thinking от Google и Qwen3-32B.
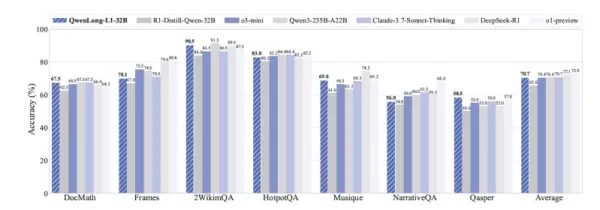
Источник: arXiv Ключевым открытием для практического применения является то, как обучение RL развивает специализированные навыки рассуждения в длинном контексте. В статье подчеркивается, что модели, обученные QwenLong-L1, улучшают «основание» (связывание ответов с конкретными разделами документа), «установку подцелей» (разложение сложных вопросов), «обратный отслеживание» (выявление и исправление ошибок в середине рассуждения) и «верификацию» (повторную проверку своих ответов).
Например, в то время как базовая модель может быть сбита с толку нерелевантными деталями в финансовом отчете или бесконечно зацикливаться на несущественном анализе, модель, обученная QwenLong-L1, продемонстрировала эффективную саморефлексию. Она смогла отфильтровать отвлекающую информацию, вернуться назад от неверных подходов и успешно прийти к правильному выводу.
Такие фреймворки, как QwenLong-L1, могут существенно расширить полезность ИИ для предприятий. Потенциальные области применения охватывают юридические технологии (анализ объемных юридических документов), финансы (проведение глубокой проверки годовых отчетов и финансовой отчетности для получения информации о рисках или инвестициях) и обслуживание клиентов (просмотр длинной истории взаимодействий для предоставления более контекстной поддержки). Исследователи сделали код для фреймворка QwenLong-L1 и веса для обученных моделей общедоступными.
Связанная статья
 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех
Рекомендации по связанным специальным темам
Музыкальная композиция
 Инструменты разделения стемов с использованием ИИ для создания ремиксов, подготовки образцов звука и формирования финальных версий караоке.
2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
 8 инструментов
 xix.ai
Анализ данных
ИИ-копилоты для SQL, предназначенные для создания панелей управления доходами, анализа воронки продаж и отслеживания показателей продуктов.
2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai
Музыкальная композиция
Лучшие инструменты для написания мелодий с помощью ИИ для черновиков песен
2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai
чат-бот
Лучшие инструменты для тренировки разговоров с помощью ИИ для подготовки к собеседованиям
2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai
Дизайн и искусство
Лучшие инструменты для переноса стилей с помощью ИИ для творческих экспериментов
2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai
Создание комиксов
Лучшие инструменты для создания диалоговых пузырей с помощью ИИ для визуального повествования
2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai

 Комментарии (1)
![AlbertHernández]()
Finally, an LLM that doesn't give up after page 50! 📚 As a legal analyst, reading 200-page contracts without losing context is a nightmare. This QwenLong-L1 framework could be a game-changer for enterprise workflows, though I'm still skeptical about the latency costs. Let's hope it's not just another hype cycle. 🤔
Alibaba Group представила QwenLong-L1, новую платформу, разработанную для расширения возможностей крупных языковых моделей (LLM) в области анализа исключительно длинных документов. Этот прорыв может стать толчком для создания нового поколения корпоративных приложений, требующих глубокого понимания и тщательного анализа обширных материалов, включая комплексные корпоративные отчеты, подробные финансовые отчеты и сложные юридические соглашения.
Препятствие для рассуждений ИИ с длинными формами
Недавние достижения в области крупных моделей рассуждений (LRM), особенно благодаря обучению с подкреплением (RL), значительно повысили их способности к решению проблем. Исследования показывают, что точная настройка RL наделяет LRM формой «медленного мышления», сходной с человеческим познанием, что позволяет им разрабатывать сложные стратегии для решения запутанных задач.
Однако эти достижения в основном ограничиваются работой с относительно короткими текстовыми фрагментами, обычно около 4000 токенов. Существенным препятствием остается масштабирование этой способности к рассуждению на гораздо более длинные контексты, например 120 000 токенов. Эффективное рассуждение в длинных формах требует твердого понимания всего документа и способности к многоэтапному анализу. «Это ограничение значительно затрудняет практическое использование, связанное с внешними знаниями, например, в глубоких исследованиях, где LRM необходимо собирать и обрабатывать информацию из источников, богатых данными», — отмечают разработчики QwenLong-L1 в своей исследовательской работе.
Команда формулирует эти препятствия в рамках концепции «RL с рассуждениями в длинном контексте». В отличие от рассуждений в коротком контексте, которые часто используют внутренние знания модели, этот подход требует от моделей точного поиска и закрепления релевантных фактов в длинных входных данных. Только тогда они могут построить логические цепочки рассуждений на основе этой извлеченной информации.
Обучение моделей для этого с помощью RL является сложной задачей, которая часто приводит к неэффективному обучению и нестабильной оптимизации. Модели часто не могут сходиться к эффективным решениям или теряют способность исследовать различные пути рассуждений.
QwenLong-L1: структурированная многоэтапная структура
QwenLong-L1 — это структура обучения с подкреплением, созданная для того, чтобы помочь LRM эволюционировать от обработки коротких текстов к надежному обобщению в длинных контекстах. Она улучшает существующие LRM с коротким контекстом посредством целенаправленного поэтапного процесса:
Разминка с контролируемой тонкой настройкой (SFT): сначала модель проходит SFT с использованием примеров рассуждений в длинном контексте. Этот этап создает прочную основу, обучая модель точно закреплять информацию из длинных документов и развивать основные навыки понимания контекста, генерации логических цепочек и извлечения ответов.
Поэтапное RL с использованием учебной программы: здесь модель проходит обучение в несколько этапов, на которых длина целевого документа постепенно увеличивается. Этот пошаговый метод, основанный на учебной программе, помогает модели постепенно адаптировать свои стратегии рассуждений от более коротких к все более длинным текстам, избегая нестабильности, связанной с резким воздействием обширных документов.
Ретроспективная выборка с учетом сложности: на заключительном этапе используются самые сложные примеры из предыдущих этапов обучения. Приоритезация сложных примеров гарантирует, что модель продолжает учиться на сложных задачах и стимулирует ее к поиску более разнообразных и сложных путей рассуждения.
Помимо этого структурированного обучения, QwenLong-L1 использует специальную систему вознаграждений. В то время как при обучении для задач с коротким контекстом часто используются строгие вознаграждения, основанные на правилах (например, за правильный математический ответ), QwenLong-L1 использует гибридный механизм. Он сочетает в себе проверку точности на основе правил с «LLM-as-a-judge», который сравнивает семантическое значение сгенерированного ответа с эталоном. Это позволяет с большей гибкостью оценивать различные способы формулирования правильных ответов в длинных, многозначных документах.
Оценка производительности QwenLong-L1
Команда Alibaba тестировала QwenLong-L1 в основном с помощью документального вопросно-ответного теста (DocQA), задачи, которая очень актуальна для потребностей предприятий, где ИИ должен расшифровывать плотные документы, чтобы отвечать на сложные запросы.
Результаты семи тестов DocQA с длинным контекстом продемонстрировали преимущества QwenLong-L1. Модель QWENLONG-L1-32B (на основе DeepSeek-R1-Distill-Qwen-32B) достигла производительности, сопоставимой с Anthropic's Claude-3.7 Sonnet Thinking, и превзошла такие модели, как OpenAI's o3-mini и Qwen3-235B-A22B. Меньшая модель QWENLONG-L1-14B также превзошла Gemini 2.0 Flash Thinking от Google и Qwen3-32B.
Ключевым открытием для практического применения является то, как обучение RL развивает специализированные навыки рассуждения в длинном контексте. В статье подчеркивается, что модели, обученные QwenLong-L1, улучшают «основание» (связывание ответов с конкретными разделами документа), «установку подцелей» (разложение сложных вопросов), «обратный отслеживание» (выявление и исправление ошибок в середине рассуждения) и «верификацию» (повторную проверку своих ответов).
Например, в то время как базовая модель может быть сбита с толку нерелевантными деталями в финансовом отчете или бесконечно зацикливаться на несущественном анализе, модель, обученная QwenLong-L1, продемонстрировала эффективную саморефлексию. Она смогла отфильтровать отвлекающую информацию, вернуться назад от неверных подходов и успешно прийти к правильному выводу.
Такие фреймворки, как QwenLong-L1, могут существенно расширить полезность ИИ для предприятий. Потенциальные области применения охватывают юридические технологии (анализ объемных юридических документов), финансы (проведение глубокой проверки годовых отчетов и финансовой отчетности для получения информации о рисках или инвестициях) и обслуживание клиентов (просмотр длинной истории взаимодействий для предоставления более контекстной поддержки). Исследователи сделали код для фреймворка QwenLong-L1 и веса для обученных моделей общедоступными.








 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
 OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех

2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai

2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai

2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai

2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai

2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai

Finally, an LLM that doesn't give up after page 50! 📚 As a legal analyst, reading 200-page contracts without losing context is a nightmare. This QwenLong-L1 framework could be a game-changer for enterprise workflows, though I'm still skeptical about the latency costs. Let's hope it's not just another hype cycle. 🤔












