


 Maison
QwenLong-L1 résout des tâches de raisonnement complexes qui dépassent les capacités des modèles d'apprentissage automatique actuels
Le groupe Alibaba a dévoilé QwenLong-L1, un nouveau cadre conçu pour permettre aux grands modèles linguistiques (LLM) de raisonner à partir de documents exceptionnellement longs. Cette avancée révolutionnaire pourrait donner naissance à une nouvelle génération d'applications d'entreprise qui exigent une compréhension approfondie et une analyse pertinente de documents volumineux, notamment des rapports d'entreprise complets, des états financiers détaillés et des accords juridiques complexes.
L'obstacle du raisonnement IA à long terme
Les progrès récents dans le domaine des grands modèles de raisonnement (LRM), notamment grâce à l'apprentissage par renforcement (RL), ont considérablement amélioré leurs capacités de résolution de problèmes. Des études indiquent que le réglage fin du RL dote les LRM d'une forme de « réflexion lente » similaire à la cognition humaine, leur permettant d'élaborer des stratégies sophistiquées pour s'attaquer à des tâches complexes.
Cependant, ces gains se limitent largement au traitement de passages de texte relativement courts, généralement autour de 4 000 tokens. Un obstacle important subsiste pour étendre cette capacité de raisonnement à des contextes beaucoup plus longs, tels que 120 000 tokens. Un raisonnement efficace sur des textes longs exige une bonne compréhension de l'ensemble du document et une capacité d'analyse en plusieurs étapes. « Cette contrainte entrave considérablement les utilisations pratiques qui font appel à des connaissances externes, comme les recherches approfondies où les LRM doivent collecter et traiter des informations provenant de sources riches en données », notent les développeurs de QwenLong-L1 dans leur article de recherche.
L'équipe encadre ces obstacles sous le concept de « raisonnement RL à long contexte ». Contrairement au raisonnement à court contexte, qui exploite souvent les connaissances internes du modèle, cette approche exige que les modèles trouvent et ancrent avec précision les faits pertinents dans des entrées longues. Ce n'est qu'alors qu'ils peuvent construire des chaînes de raisonnement logiques basées sur ces informations récupérées.
La formation de modèles à cette fin via le RL est difficile, ce qui conduit souvent à un apprentissage inefficace et à une optimisation instable. Les modèles ne parviennent souvent pas à converger vers des solutions efficaces ou perdent leur capacité à explorer diverses voies de raisonnement.
QwenLong-L1 : un cadre structuré en plusieurs étapes
QwenLong-L1 est un cadre d'apprentissage par renforcement conçu pour aider les LRM à évoluer du traitement de textes courts à la généralisation robuste dans des contextes longs. Il améliore les LRM à contexte court existants grâce à un processus délibéré et progressif :
Réchauffement Supervised Fine-Tuning (SFT) : le modèle subit d'abord un SFT à l'aide d'exemples de raisonnement dans un contexte long. Cette phase permet de construire une base solide, en apprenant au modèle à ancrer avec précision les informations provenant de documents longs et à développer des compétences fondamentales en matière de compréhension du contexte, de génération de chaînes logiques et d'extraction de réponses.
RL par étapes guidé par un programme d'études : ici, le modèle s'entraîne à travers plusieurs phases où la longueur du document cible augmente progressivement. Cette méthode étape par étape, basée sur un programme d'études, aide le modèle à adapter progressivement ses stratégies de raisonnement, passant de textes courts à des textes de plus en plus longs, évitant ainsi l'instabilité liée à une exposition soudaine à des documents volumineux.
Échantillonnage rétrospectif tenant compte de la difficulté : la dernière étape intègre les exemples les plus difficiles des phases de formation précédentes. En donnant la priorité aux cas difficiles, elle garantit que le modèle continue à apprendre à partir de problèmes complexes et l'encourage à explorer des voies de raisonnement plus diverses et plus complexes.
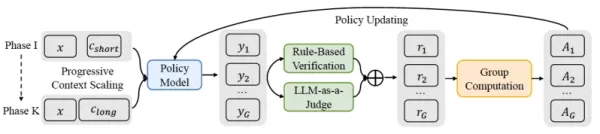
Processus QwenLong-L1 Source : arXiv Au-delà de cette formation structurée, QwenLong-L1 utilise un système de récompense spécialisé. Alors que la formation pour les tâches à contexte court utilise souvent des récompenses strictes basées sur des règles (par exemple, pour une réponse mathématique correcte), QwenLong-L1 utilise un mécanisme hybride. Il combine une vérification basée sur des règles pour la précision avec un « LLM-as-a-judge » qui compare la signification sémantique de la réponse générée à la référence. Cela permet une plus grande flexibilité dans l'évaluation des différentes façons dont les réponses correctes peuvent être formulées dans des documents longs et nuancés.
Évaluation des performances de QwenLong-L1
L'équipe d'Alibaba a testé QwenLong-L1 principalement à l'aide de questions-réponses documentaires (DocQA), une tâche très pertinente pour les besoins des entreprises où l'IA doit déchiffrer des documents denses pour répondre à des requêtes complexes.
Les résultats obtenus sur sept benchmarks DocQA à contexte long ont démontré la puissance de QwenLong-L1. Le modèle QWENLONG-L1-32B (basé sur DeepSeek-R1-Distill-Qwen-32B) a atteint des performances équivalentes à celles de Claude-3.7 Sonnet Thinking d'Anthropic et a surpassé des modèles tels que o3-mini d'OpenAI et Qwen3-235B-A22B. Le modèle QWENLONG-L1-14B, plus petit, a également surpassé Gemini 2.0 Flash Thinking de Google et Qwen3-32B.
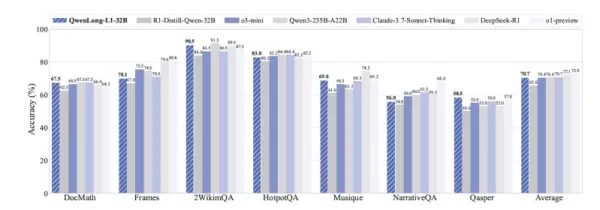
Source : arXiv Une conclusion clé pour une utilisation dans le monde réel est la manière dont l'entraînement RL cultive des comportements de raisonnement spécialisés dans un contexte long. L'article souligne que les modèles entraînés par QwenLong-L1 s'améliorent en matière de « grounding » (liaison des réponses à des sections spécifiques de documents), de « subgoal setting » (décomposition de questions complexes), de « backtracking » (identification et correction d'erreurs de raisonnement) et de « verification » (revérification de leurs réponses).
Par exemple, là où un modèle de base pourrait être dévié par des détails non pertinents dans un rapport financier ou tourner en boucle sur une analyse tangentielle, un modèle formé par QwenLong-L1 a fait preuve d'une auto-réflexion efficace. Il a pu filtrer les informations perturbatrices, revenir sur des approches incorrectes et parvenir à la bonne conclusion.
Des cadres tels que QwenLong-L1 pourraient considérablement élargir l'utilité de l'IA dans les entreprises. Les applications potentielles couvrent la technologie juridique (analyse de documents juridiques volumineux), la finance (réalisation d'une diligence raisonnable approfondie sur les rapports annuels et les documents financiers pour obtenir des informations sur les risques ou les investissements) et le service à la clientèle (examen des longs historiques d'interactions afin de fournir un soutien plus contextuel). Les chercheurs ont rendu publics le code du cadre QwenLong-L1 et les pondérations des modèles entraînés.
Article connexe
 PDG de DeepMind, Hassabis : Je dors six heures par jour et je me sens généralement plein d’énergie vers 1 h du matin.
Fortune a récemment publié une interview avec Demis Hassabis, PDG de Google DeepMind, révélant son approche non conventionnelle du repos et de la productivité. Hassabis a divulgué qu’il dort très peu, structurant ses heures d’éveil en deux blocs de t
OpenAI et Anthropic se disputent des parts de marché malgré des résultats en deçà des attentes
Bien que des informations récentes laissent entendre qu’OpenAI n’aurait pas atteint ses objectifs de chiffre d’affaires, ce qui a pesé sur les valeurs technologiques ce mardi, les investisseurs privés
Conformité des véhicules autonomes en Californie : une nouvelle ère marquée par les amendes, les zones de géolocalisation et 1 million de miles
Guident exploite une navette AuveTech dans le sud de la Floride, gérant un parcours de quatre miles à West Palm Beach et un parcours d’un mile à Boca Raton grâce à sa technologie de surveillance à dis
Recommandations de sujets spéciaux liés
Composition musicale
 Outils de séparation des pistes audio par IA pour la production de remix, la préparation de samples et les masters de karaoké
2026 : Les meilleures et plus récentes outils de séparation des pistes audio par IA, hautement notés, sélectionnés spécialement pour la production de remix, la préparation de samples et l’enregistrement de karaokés. Ces outils puissants et révolutionnaires, éprouvés dans des conditions réelles, permettent une isolation audio précise, ce qui améliore considérablement la productivité. XIX.AI propose un guide de comparaison gratuit mis à jour chaque semaine entre les versions payantes et gratuites, afin de vous aider à trouver la solution idéale adaptée à vos besoins. Découvrez-les dès maintenant pour tirer parti des avantages offerts par l’IA.
 8 outils
 xix.ai
Analyse des données
Copilotes SQL basés sur l’IA pour les tableaux de bord de chiffre d’affaires, l’analyse des funnels et les indicateurs de produits
2026 : Les meilleurs copilotes AI SQL actuels, classés parmi les plus performants ! XIX.AI a sélectionné une collection puissante et révolutionnaire, mise à jour chaque semaine grâce à des tests concrets. Ces outils indispensables vous aident à créer des tableaux de bord financiers précis, à analyser les canaux de vente et à suivre en temps réel les indicateurs produits, ce qui améliore considérablement votre productivité. Découvrez-les dès maintenant pour trouver l’outil idéal pour des décisions basées sur les données ! 238 caractères
9 outils
xix.ai
Composition musicale
Meilleurs outils d’écriture de mélodies par IA pour les ébauches de chansons
2026 Derniers Meilleurs Outils d’Écriture de Mélodie par IA les Mieux Notés pour des Ébauches de Chansons ! XIX.AI a sélectionné une collection hautement puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles, afin d’offrir la meilleure expérience d’écriture. Vous pouvez y trouver des comparaisons détaillées entre versions gratuites et payantes, des classements précis, ainsi que des options incontournables conçues pour vous aider à créer sans effort des ébauches de chansons remarquables et à booster significativement votre productivité créative. Explorez dès maintenant pour découvrir l’outil qui vous correspond parfaitement !
8 outils
xix.ai
chatbot
Meilleurs outils d’entraînement à la conversation par IA pour la préparation aux entretiens
Les derniers outils de formation à la conversation par IA les mieux notés pour 2026 sont disponibles sur XIX.AI ! Cette sélection rigoureuse propose des outils puissants et révolutionnaires, testés rigoureusement dans des conditions réelles pour fournir des retours précis. Vous y trouverez une comparaison entre les versions gratuites et payantes, ainsi que des classements détaillés pour vous aider à choisir l’option incontournable qui renforce votre confiance et vos compétences. Explorez dès maintenant pour découvrir l’outil parfait pour réussir vos entretiens !
12 outils
xix.ai
Conception et art
Les meilleurs outils de transfert de style basés sur l'IA pour des expériences créatives
Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai
Création de bande dessinée
Les meilleurs outils d'IA pour créer des bulles de dialogue destinés à la narration visuelle
Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai

 commentaires (1)
![AlbertHernández]()
Finally, an LLM that doesn't give up after page 50! 📚 As a legal analyst, reading 200-page contracts without losing context is a nightmare. This QwenLong-L1 framework could be a game-changer for enterprise workflows, though I'm still skeptical about the latency costs. Let's hope it's not just another hype cycle. 🤔
Le groupe Alibaba a dévoilé QwenLong-L1, un nouveau cadre conçu pour permettre aux grands modèles linguistiques (LLM) de raisonner à partir de documents exceptionnellement longs. Cette avancée révolutionnaire pourrait donner naissance à une nouvelle génération d'applications d'entreprise qui exigent une compréhension approfondie et une analyse pertinente de documents volumineux, notamment des rapports d'entreprise complets, des états financiers détaillés et des accords juridiques complexes.
L'obstacle du raisonnement IA à long terme
Les progrès récents dans le domaine des grands modèles de raisonnement (LRM), notamment grâce à l'apprentissage par renforcement (RL), ont considérablement amélioré leurs capacités de résolution de problèmes. Des études indiquent que le réglage fin du RL dote les LRM d'une forme de « réflexion lente » similaire à la cognition humaine, leur permettant d'élaborer des stratégies sophistiquées pour s'attaquer à des tâches complexes.
Cependant, ces gains se limitent largement au traitement de passages de texte relativement courts, généralement autour de 4 000 tokens. Un obstacle important subsiste pour étendre cette capacité de raisonnement à des contextes beaucoup plus longs, tels que 120 000 tokens. Un raisonnement efficace sur des textes longs exige une bonne compréhension de l'ensemble du document et une capacité d'analyse en plusieurs étapes. « Cette contrainte entrave considérablement les utilisations pratiques qui font appel à des connaissances externes, comme les recherches approfondies où les LRM doivent collecter et traiter des informations provenant de sources riches en données », notent les développeurs de QwenLong-L1 dans leur article de recherche.
L'équipe encadre ces obstacles sous le concept de « raisonnement RL à long contexte ». Contrairement au raisonnement à court contexte, qui exploite souvent les connaissances internes du modèle, cette approche exige que les modèles trouvent et ancrent avec précision les faits pertinents dans des entrées longues. Ce n'est qu'alors qu'ils peuvent construire des chaînes de raisonnement logiques basées sur ces informations récupérées.
La formation de modèles à cette fin via le RL est difficile, ce qui conduit souvent à un apprentissage inefficace et à une optimisation instable. Les modèles ne parviennent souvent pas à converger vers des solutions efficaces ou perdent leur capacité à explorer diverses voies de raisonnement.
QwenLong-L1 : un cadre structuré en plusieurs étapes
QwenLong-L1 est un cadre d'apprentissage par renforcement conçu pour aider les LRM à évoluer du traitement de textes courts à la généralisation robuste dans des contextes longs. Il améliore les LRM à contexte court existants grâce à un processus délibéré et progressif :
Réchauffement Supervised Fine-Tuning (SFT) : le modèle subit d'abord un SFT à l'aide d'exemples de raisonnement dans un contexte long. Cette phase permet de construire une base solide, en apprenant au modèle à ancrer avec précision les informations provenant de documents longs et à développer des compétences fondamentales en matière de compréhension du contexte, de génération de chaînes logiques et d'extraction de réponses.
RL par étapes guidé par un programme d'études : ici, le modèle s'entraîne à travers plusieurs phases où la longueur du document cible augmente progressivement. Cette méthode étape par étape, basée sur un programme d'études, aide le modèle à adapter progressivement ses stratégies de raisonnement, passant de textes courts à des textes de plus en plus longs, évitant ainsi l'instabilité liée à une exposition soudaine à des documents volumineux.
Échantillonnage rétrospectif tenant compte de la difficulté : la dernière étape intègre les exemples les plus difficiles des phases de formation précédentes. En donnant la priorité aux cas difficiles, elle garantit que le modèle continue à apprendre à partir de problèmes complexes et l'encourage à explorer des voies de raisonnement plus diverses et plus complexes.
Au-delà de cette formation structurée, QwenLong-L1 utilise un système de récompense spécialisé. Alors que la formation pour les tâches à contexte court utilise souvent des récompenses strictes basées sur des règles (par exemple, pour une réponse mathématique correcte), QwenLong-L1 utilise un mécanisme hybride. Il combine une vérification basée sur des règles pour la précision avec un « LLM-as-a-judge » qui compare la signification sémantique de la réponse générée à la référence. Cela permet une plus grande flexibilité dans l'évaluation des différentes façons dont les réponses correctes peuvent être formulées dans des documents longs et nuancés.
Évaluation des performances de QwenLong-L1
L'équipe d'Alibaba a testé QwenLong-L1 principalement à l'aide de questions-réponses documentaires (DocQA), une tâche très pertinente pour les besoins des entreprises où l'IA doit déchiffrer des documents denses pour répondre à des requêtes complexes.
Les résultats obtenus sur sept benchmarks DocQA à contexte long ont démontré la puissance de QwenLong-L1. Le modèle QWENLONG-L1-32B (basé sur DeepSeek-R1-Distill-Qwen-32B) a atteint des performances équivalentes à celles de Claude-3.7 Sonnet Thinking d'Anthropic et a surpassé des modèles tels que o3-mini d'OpenAI et Qwen3-235B-A22B. Le modèle QWENLONG-L1-14B, plus petit, a également surpassé Gemini 2.0 Flash Thinking de Google et Qwen3-32B.
Une conclusion clé pour une utilisation dans le monde réel est la manière dont l'entraînement RL cultive des comportements de raisonnement spécialisés dans un contexte long. L'article souligne que les modèles entraînés par QwenLong-L1 s'améliorent en matière de « grounding » (liaison des réponses à des sections spécifiques de documents), de « subgoal setting » (décomposition de questions complexes), de « backtracking » (identification et correction d'erreurs de raisonnement) et de « verification » (revérification de leurs réponses).
Par exemple, là où un modèle de base pourrait être dévié par des détails non pertinents dans un rapport financier ou tourner en boucle sur une analyse tangentielle, un modèle formé par QwenLong-L1 a fait preuve d'une auto-réflexion efficace. Il a pu filtrer les informations perturbatrices, revenir sur des approches incorrectes et parvenir à la bonne conclusion.
Des cadres tels que QwenLong-L1 pourraient considérablement élargir l'utilité de l'IA dans les entreprises. Les applications potentielles couvrent la technologie juridique (analyse de documents juridiques volumineux), la finance (réalisation d'une diligence raisonnable approfondie sur les rapports annuels et les documents financiers pour obtenir des informations sur les risques ou les investissements) et le service à la clientèle (examen des longs historiques d'interactions afin de fournir un soutien plus contextuel). Les chercheurs ont rendu publics le code du cadre QwenLong-L1 et les pondérations des modèles entraînés.








 PDG de DeepMind, Hassabis : Je dors six heures par jour et je me sens généralement plein d’énergie vers 1 h du matin.
Fortune a récemment publié une interview avec Demis Hassabis, PDG de Google DeepMind, révélant son approche non conventionnelle du repos et de la productivité. Hassabis a divulgué qu’il dort très peu, structurant ses heures d’éveil en deux blocs de t
 OpenAI et Anthropic se disputent des parts de marché malgré des résultats en deçà des attentes
Bien que des informations récentes laissent entendre qu’OpenAI n’aurait pas atteint ses objectifs de chiffre d’affaires, ce qui a pesé sur les valeurs technologiques ce mardi, les investisseurs privés
Conformité des véhicules autonomes en Californie : une nouvelle ère marquée par les amendes, les zones de géolocalisation et 1 million de miles
Guident exploite une navette AuveTech dans le sud de la Floride, gérant un parcours de quatre miles à West Palm Beach et un parcours d’un mile à Boca Raton grâce à sa technologie de surveillance à dis

2026 : Les meilleures et plus récentes outils de séparation des pistes audio par IA, hautement notés, sélectionnés spécialement pour la production de remix, la préparation de samples et l’enregistrement de karaokés. Ces outils puissants et révolutionnaires, éprouvés dans des conditions réelles, permettent une isolation audio précise, ce qui améliore considérablement la productivité. XIX.AI propose un guide de comparaison gratuit mis à jour chaque semaine entre les versions payantes et gratuites, afin de vous aider à trouver la solution idéale adaptée à vos besoins. Découvrez-les dès maintenant pour tirer parti des avantages offerts par l’IA.
8 outils
xix.ai

2026 : Les meilleurs copilotes AI SQL actuels, classés parmi les plus performants ! XIX.AI a sélectionné une collection puissante et révolutionnaire, mise à jour chaque semaine grâce à des tests concrets. Ces outils indispensables vous aident à créer des tableaux de bord financiers précis, à analyser les canaux de vente et à suivre en temps réel les indicateurs produits, ce qui améliore considérablement votre productivité. Découvrez-les dès maintenant pour trouver l’outil idéal pour des décisions basées sur les données ! 238 caractères
9 outils
xix.ai

2026 Derniers Meilleurs Outils d’Écriture de Mélodie par IA les Mieux Notés pour des Ébauches de Chansons ! XIX.AI a sélectionné une collection hautement puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles, afin d’offrir la meilleure expérience d’écriture. Vous pouvez y trouver des comparaisons détaillées entre versions gratuites et payantes, des classements précis, ainsi que des options incontournables conçues pour vous aider à créer sans effort des ébauches de chansons remarquables et à booster significativement votre productivité créative. Explorez dès maintenant pour découvrir l’outil qui vous correspond parfaitement !
8 outils
xix.ai

Les derniers outils de formation à la conversation par IA les mieux notés pour 2026 sont disponibles sur XIX.AI ! Cette sélection rigoureuse propose des outils puissants et révolutionnaires, testés rigoureusement dans des conditions réelles pour fournir des retours précis. Vous y trouverez une comparaison entre les versions gratuites et payantes, ainsi que des classements détaillés pour vous aider à choisir l’option incontournable qui renforce votre confiance et vos compétences. Explorez dès maintenant pour découvrir l’outil parfait pour réussir vos entretiens !
12 outils
xix.ai

Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai

Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai

Finally, an LLM that doesn't give up after page 50! 📚 As a legal analyst, reading 200-page contracts without losing context is a nightmare. This QwenLong-L1 framework could be a game-changer for enterprise workflows, though I'm still skeptical about the latency costs. Let's hope it's not just another hype cycle. 🤔












