


 家
QwenLong-L1、現行LLMの能力を超える複雑な推論タスクを解決
アリババグループは、大規模言語モデル(LLM)が非常に長い文書を横断的に推論できるように設計された新たなフレームワーク「QwenLong-L1」を発表した。この画期的な技術は、包括的な企業報告書、詳細な財務諸表、複雑な法的契約書など、膨大な資料の深い理解と洞察に富んだ分析を必要とする次世代の企業アプリケーションを推進する可能性を秘めている。
長文AI推論の障壁
大規模推論モデル(LRM)の近年の進歩、特に強化学習(RL)を通じたものは、その問題解決能力を劇的に向上させた。研究によれば、RLによる微調整はLRMに人間的な認知に似た「スローシンキング」を可能にし、複雑な課題に対処するための洗練された戦略を構築できるようにする。
しかし、こうした進歩は主に比較的短いテキスト(通常4,000トークン程度)の処理に限定されている。120,000トークンといったはるかに長い文脈へ推論能力を拡張するには、依然として大きな障壁が残されている。 効果的な長文推論には、文書全体の確実な把握と多段階分析能力が求められる。QwenLong-L1開発チームは研究論文で「この制約は、外部知識を必要とする実用的な用途(データ豊富な情報源から情報を収集・処理する深い調査など)を著しく阻害する」と指摘している。
研究チームはこれらの課題を「長文推論RL」の概念で体系化している。モデルの内部知識を活用する短文推論とは異なり、このアプローチではモデルが長大な入力の中から関連事実を正確に発見・特定する必要がある。その上で初めて、取得した情報に基づく論理的推論の連鎖を構築できるのだ。
この目的でRLを用いてモデルを訓練することは困難であり、非効率な学習や不安定な最適化を招くことが多い。モデルは効果的な解に収束できなかったり、多様な推論経路を探索する能力を失ったりする傾向がある。
QwenLong-L1:構造化された多段階フレームワーク
QwenLong-L1は、LRM(長文推論モデル)が短文処理から長文コンテキスト全体への堅牢な一般化へと進化するのを支援するために設計された強化学習フレームワークである。既存の短文コンテキスト向けLRMを、計画的な段階的プロセスを通じて強化する:
ウォームアップ監督下微調整(SFT):モデルはまず長文推論の例を用いたSFTを経る。この段階では強固な基盤を構築し、長文からの情報正確なアンカーリング、文脈理解・論理連鎖生成・回答抽出の中核スキルを習得させる。
カリキュラム誘導型段階的RL:モデルは対象文書長が漸増する複数段階を経て訓練される。この段階的カリキュラム手法により、モデルは短いテキストから次第に長いテキストへ推論戦略を着実に適応させ、大規模文書への急激な曝露による不安定性を回避する。
難易度を考慮した回顧的サンプリング:最終段階では、先行する訓練フェーズから最も困難な例を組み込みます。困難な事例を優先的に取り扱うことで、モデルが難題から継続的に学習し、より多様で複雑な推論経路を探索するよう促します。
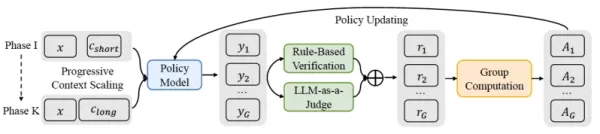
QwenLong-L1プロセス 出典: arXiv この構造化された訓練に加え、QwenLong-L1は特殊な報酬システムを採用している。短文脈タスクの訓練では厳格なルールベース報酬(例:数学解答の正誤判定)が用いられることが多いが、QwenLong-L1はハイブリッド機構を採用。正確性を検証するルールベース手法と、生成解答の意味的意味を基準文と比較する「LLM審判」を組み合わせる。 これにより、長文でニュアンス豊かな文書内において、正解が表現される多様な方法を評価する柔軟性が向上します。
QwenLong-L1の性能評価
アリババチームは、主に文書質問応答(DocQA)を用いてQwenLong-L1をテストしました。これは、AIが複雑なクエリに答えるために密度の高い文書を解読しなければならないという、企業のニーズに非常に関連性の高いタスクです。
7つの長文コンテキストDocQAベンチマークにおける結果は、QwenLong-L1の強みを示した。 QWENLONG-L1-32Bモデル(DeepSeek-R1-Distill-Qwen-32Bベース)は、AnthropicのClaude-3.7 Sonnet Thinkingと同等の性能を達成し、OpenAIのo3-miniやQwen3-235B-A22Bなどのモデルを上回りました。 より小規模なQWENLONG-L1-14Bモデルも、GoogleのGemini 2.0 Flash ThinkingやQwen3-32Bを上回った。
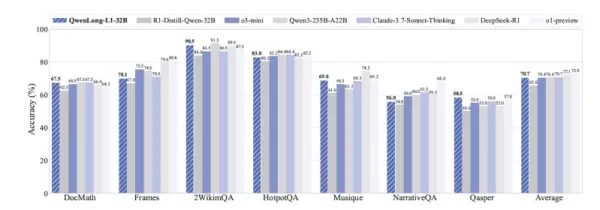
出典: arXiv 実世界での利用における重要な知見は、RLトレーニングが専門的な長文脈推論行動を育成する方法である。 本論文は、QwenLong-L1で訓練されたモデルが「グラウンディング」(回答を特定の文書セクションに紐付ける)、「サブゴール設定」(複雑な質問を分解する)、「バックトラッキング」(推論途中の誤りを特定・修正する)、「検証」(回答の再確認)において改善されることを強調している。
例えば、ベースモデルが財務報告書の無関係な詳細に惑わされたり、関連性の薄い分析で無限ループに陥ったりする場面でも、QwenLong-L1で訓練されたモデルは効果的な自己反省を示した。注意をそらす情報を排除し、誤ったアプローチからバックトラックし、正しい結論に到達できたのである。
QwenLong-L1のようなフレームワークは、AIの企業向け実用性を大幅に拡大する可能性がある。潜在的な応用分野は、リーガルテック(膨大な法的文書の分析)、金融(年次報告書や財務書類に対する深いデューデリジェンスによるリスク・投資インサイトの抽出)、カスタマーサービス(長大なやり取り履歴の検証による文脈に沿ったサポート提供)に及ぶ。研究者らはQwenLong-L1フレームワークのコードと学習済みモデルの重みを公開している。
関連記事
 AppleのスマートグラスはWWDC27でデビューする可能性があり、プライバシー保護を強調している
Bloombergのマーク・ガーマン氏によると、Appleのスマートグラス(コードネームN50)は2027年6月のWWDC27で初公開され、2027年秋に小売店での発売が予定されている。当初は今年後半から2027年初頭にかけての発売が目標だったが、製品のさらなる洗練とプライバシー保護プロトコルの強化を可能にするため、発売時期が延期された。プライバシーはAppleのスマートグラス戦略の中核的な柱である。Metaなどの競合他社をめぐるプライバシー論争から教訓を得て、Appleは堅牢な機能とポリシー
内部詳細が明かされた次世代ジェミニ:計算リソースの逼迫、開発チーム間で優先順位とリソース配分を巡り意見が割れた
報告によると、Googleの次世代Geminiモデルの発売は延期された。開発の優先順位とリソース配分をめぐる社内での意見の相違、限られた計算能力、複雑な承認手続きが重なり、2ヶ月の延期を余儀なくされた。独自開発のTPUチップを所有しているものの、モデルのトレーニング、Google Cloudサービス、多数の消費者向けおよび企業向けAIアプリケーションからの競合する需要により、Googleは計算資源の不足に直面している。上層部は現在、組織再編成を通じてこれらの部門間の対立に対処している。同時に、リ
OpenAI、成長鈍化への懸念を退け、複数の事業部門が加速していると表明
外部からの販売成長の鈍化や社内目標の未達に関する scrutiny に対応し、AI リーダーである OpenAI は 4 月 28 日(火曜日)、自信に満ちた声明を発表した。同社は、消費者向け製品とエンタープライズサービスが急速に進展しており、最近のビジネス減速に関する憶測を直接否定していると明らかにした。同社が「複数の社内目標を逸脱した」とする主張に対し、OpenAI はこれらの報道を「典型的なクリックベイト」と一蹴した。同社は、AI 統合に対する堅調なエンタープライズ需要を強調し、広告施策
関連特集おすすめ
作曲
 曲のドラフト作成に最適なAIメロディ作成ツール
2026年最新版 高評価のAIメロディ作成ツールで曲のドラフト作成!XIX.AIは、厳格な実世界テストを経て最高の作成体験を提供する、革新的な強力なコレクションを厳選しました。詳細な無料版と有料版の比較、正確なランキング、そして素晴らしい曲のドラフトを楽に作成し、創造的な生産性を大幅に向上させるためにぜひ試すべきオプションが見つかります。今すぐ探索して、あなたに最適なツールを見つけましょう!
 8 ツール
 xix.ai
チャットボット
面接練習用のベストなAI会話トレーニングツール
2026年最新版・最高評価のAI会話トレーニングツールが、面接練習に最適です。XIX.AIにてご提供しています!この厳選コレクションには、現実世界での厳格なテストを経て正確なフィードバックを提供する強力なツールが含まれています。無料版と有料版の比較や詳細なランキングをご覧いただき、自信とスキルを高めるための必須オプションをお選びください。今すぐ探索して、面接成功に最適なツールを見つけましょう!
12 ツール
xix.ai
デザインとアート
クリエイティブな実験に最適なAIスタイル転送ツール
2026年版 クリエイティブな実験に最適な、最新・最高評価のAIスタイル転送ツール!XIX.AIは、実地テストと厳格なランキングを通じて卓越した結果をもたらす、強力で画期的な「必試」ツールを厳選しました。これらのトップソリューションは、コンテンツ制作を加速させ、無限の創造的可能性を切り拓くことで、クリエイターの生産性を大幅に向上させます。 今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
9 ツール
xix.ai
漫画制作
ビジュアルストーリーテリングに最適なAI吹き出しツール
2026年版、ビジュアルストーリーテリングに最適な高評価AIダイアログバブルツールがXIX.AIに登場!この厳選コレクションには、クリエイターの生産性を高め、創作上のボトルネックを解消する、画期的な強力ツールが揃っています。 無料版と有料版の比較、実地テストの結果、最新のランキングを確認して、魅力的なビジュアルストーリーを構築するのに最適な、ぜひ試すべきソリューションを見つけましょう。今すぐチェックして、あなたにぴったりのツールを発見してください!
10 ツール
xix.ai
ミーティングアシスタント
AI会議要約ツールのトップ選定:決定事項とフォローアップを明確に把握
2026年版:意思決定の追跡を明確にし、フォローアップを容易にする、高評価のAI会議要約ツールベストセレクション。この厳選リストでは、会議メモの自動化、重要なアクション項目の特定、すべてのプロジェクトにわたるチーム連携の効率化を通じて、生産性を劇的に向上させる、強力で画期的なソリューションをご紹介します。 無料版と有料版の比較、実地テストの結果、毎週更新されるランキングを参考に、最適なツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai
データ分析
最強のAIデータクリーニングツール:欠損値や重複データを迅速に修正
2026年最新かつ最も評価の高いAIデータクリーニングツールをご紹介。欠損値や重複データを迅速に修正できるこれらのツールは、生産性を大幅に向上させる強力なソリューションです。各ツールは信頼性を確保するため、厳格な実環境でのテストを経ています。無料版と有料版の比較情報もご用意しており、あなたのニーズに最も合ったツールを見つけ出せます。今すぐXIX.AIで詳細を確認し、AI活用の強みを最大限に引き出しましょう。
11 ツール
xix.ai

 コメント (1)
0/500
![AlbertHernández]()
Finally, an LLM that doesn't give up after page 50! 📚 As a legal analyst, reading 200-page contracts without losing context is a nightmare. This QwenLong-L1 framework could be a game-changer for enterprise workflows, though I'm still skeptical about the latency costs. Let's hope it's not just another hype cycle. 🤔
アリババグループは、大規模言語モデル(LLM)が非常に長い文書を横断的に推論できるように設計された新たなフレームワーク「QwenLong-L1」を発表した。この画期的な技術は、包括的な企業報告書、詳細な財務諸表、複雑な法的契約書など、膨大な資料の深い理解と洞察に富んだ分析を必要とする次世代の企業アプリケーションを推進する可能性を秘めている。
長文AI推論の障壁
大規模推論モデル(LRM)の近年の進歩、特に強化学習(RL)を通じたものは、その問題解決能力を劇的に向上させた。研究によれば、RLによる微調整はLRMに人間的な認知に似た「スローシンキング」を可能にし、複雑な課題に対処するための洗練された戦略を構築できるようにする。
しかし、こうした進歩は主に比較的短いテキスト(通常4,000トークン程度)の処理に限定されている。120,000トークンといったはるかに長い文脈へ推論能力を拡張するには、依然として大きな障壁が残されている。 効果的な長文推論には、文書全体の確実な把握と多段階分析能力が求められる。QwenLong-L1開発チームは研究論文で「この制約は、外部知識を必要とする実用的な用途(データ豊富な情報源から情報を収集・処理する深い調査など)を著しく阻害する」と指摘している。
研究チームはこれらの課題を「長文推論RL」の概念で体系化している。モデルの内部知識を活用する短文推論とは異なり、このアプローチではモデルが長大な入力の中から関連事実を正確に発見・特定する必要がある。その上で初めて、取得した情報に基づく論理的推論の連鎖を構築できるのだ。
この目的でRLを用いてモデルを訓練することは困難であり、非効率な学習や不安定な最適化を招くことが多い。モデルは効果的な解に収束できなかったり、多様な推論経路を探索する能力を失ったりする傾向がある。
QwenLong-L1:構造化された多段階フレームワーク
QwenLong-L1は、LRM(長文推論モデル)が短文処理から長文コンテキスト全体への堅牢な一般化へと進化するのを支援するために設計された強化学習フレームワークである。既存の短文コンテキスト向けLRMを、計画的な段階的プロセスを通じて強化する:
ウォームアップ監督下微調整(SFT):モデルはまず長文推論の例を用いたSFTを経る。この段階では強固な基盤を構築し、長文からの情報正確なアンカーリング、文脈理解・論理連鎖生成・回答抽出の中核スキルを習得させる。
カリキュラム誘導型段階的RL:モデルは対象文書長が漸増する複数段階を経て訓練される。この段階的カリキュラム手法により、モデルは短いテキストから次第に長いテキストへ推論戦略を着実に適応させ、大規模文書への急激な曝露による不安定性を回避する。
難易度を考慮した回顧的サンプリング:最終段階では、先行する訓練フェーズから最も困難な例を組み込みます。困難な事例を優先的に取り扱うことで、モデルが難題から継続的に学習し、より多様で複雑な推論経路を探索するよう促します。
この構造化された訓練に加え、QwenLong-L1は特殊な報酬システムを採用している。短文脈タスクの訓練では厳格なルールベース報酬(例:数学解答の正誤判定)が用いられることが多いが、QwenLong-L1はハイブリッド機構を採用。正確性を検証するルールベース手法と、生成解答の意味的意味を基準文と比較する「LLM審判」を組み合わせる。 これにより、長文でニュアンス豊かな文書内において、正解が表現される多様な方法を評価する柔軟性が向上します。
QwenLong-L1の性能評価
アリババチームは、主に文書質問応答(DocQA)を用いてQwenLong-L1をテストしました。これは、AIが複雑なクエリに答えるために密度の高い文書を解読しなければならないという、企業のニーズに非常に関連性の高いタスクです。
7つの長文コンテキストDocQAベンチマークにおける結果は、QwenLong-L1の強みを示した。 QWENLONG-L1-32Bモデル(DeepSeek-R1-Distill-Qwen-32Bベース)は、AnthropicのClaude-3.7 Sonnet Thinkingと同等の性能を達成し、OpenAIのo3-miniやQwen3-235B-A22Bなどのモデルを上回りました。 より小規模なQWENLONG-L1-14Bモデルも、GoogleのGemini 2.0 Flash ThinkingやQwen3-32Bを上回った。
実世界での利用における重要な知見は、RLトレーニングが専門的な長文脈推論行動を育成する方法である。 本論文は、QwenLong-L1で訓練されたモデルが「グラウンディング」(回答を特定の文書セクションに紐付ける)、「サブゴール設定」(複雑な質問を分解する)、「バックトラッキング」(推論途中の誤りを特定・修正する)、「検証」(回答の再確認)において改善されることを強調している。
例えば、ベースモデルが財務報告書の無関係な詳細に惑わされたり、関連性の薄い分析で無限ループに陥ったりする場面でも、QwenLong-L1で訓練されたモデルは効果的な自己反省を示した。注意をそらす情報を排除し、誤ったアプローチからバックトラックし、正しい結論に到達できたのである。
QwenLong-L1のようなフレームワークは、AIの企業向け実用性を大幅に拡大する可能性がある。潜在的な応用分野は、リーガルテック(膨大な法的文書の分析)、金融(年次報告書や財務書類に対する深いデューデリジェンスによるリスク・投資インサイトの抽出)、カスタマーサービス(長大なやり取り履歴の検証による文脈に沿ったサポート提供)に及ぶ。研究者らはQwenLong-L1フレームワークのコードと学習済みモデルの重みを公開している。








 AppleのスマートグラスはWWDC27でデビューする可能性があり、プライバシー保護を強調している
Bloombergのマーク・ガーマン氏によると、Appleのスマートグラス(コードネームN50)は2027年6月のWWDC27で初公開され、2027年秋に小売店での発売が予定されている。当初は今年後半から2027年初頭にかけての発売が目標だったが、製品のさらなる洗練とプライバシー保護プロトコルの強化を可能にするため、発売時期が延期された。プライバシーはAppleのスマートグラス戦略の中核的な柱である。Metaなどの競合他社をめぐるプライバシー論争から教訓を得て、Appleは堅牢な機能とポリシー
 内部詳細が明かされた次世代ジェミニ:計算リソースの逼迫、開発チーム間で優先順位とリソース配分を巡り意見が割れた
報告によると、Googleの次世代Geminiモデルの発売は延期された。開発の優先順位とリソース配分をめぐる社内での意見の相違、限られた計算能力、複雑な承認手続きが重なり、2ヶ月の延期を余儀なくされた。独自開発のTPUチップを所有しているものの、モデルのトレーニング、Google Cloudサービス、多数の消費者向けおよび企業向けAIアプリケーションからの競合する需要により、Googleは計算資源の不足に直面している。上層部は現在、組織再編成を通じてこれらの部門間の対立に対処している。同時に、リ
 OpenAI、成長鈍化への懸念を退け、複数の事業部門が加速していると表明
外部からの販売成長の鈍化や社内目標の未達に関する scrutiny に対応し、AI リーダーである OpenAI は 4 月 28 日(火曜日)、自信に満ちた声明を発表した。同社は、消費者向け製品とエンタープライズサービスが急速に進展しており、最近のビジネス減速に関する憶測を直接否定していると明らかにした。同社が「複数の社内目標を逸脱した」とする主張に対し、OpenAI はこれらの報道を「典型的なクリックベイト」と一蹴した。同社は、AI 統合に対する堅調なエンタープライズ需要を強調し、広告施策

2026年最新版 高評価のAIメロディ作成ツールで曲のドラフト作成!XIX.AIは、厳格な実世界テストを経て最高の作成体験を提供する、革新的な強力なコレクションを厳選しました。詳細な無料版と有料版の比較、正確なランキング、そして素晴らしい曲のドラフトを楽に作成し、創造的な生産性を大幅に向上させるためにぜひ試すべきオプションが見つかります。今すぐ探索して、あなたに最適なツールを見つけましょう!
8 ツール
xix.ai

2026年最新版・最高評価のAI会話トレーニングツールが、面接練習に最適です。XIX.AIにてご提供しています!この厳選コレクションには、現実世界での厳格なテストを経て正確なフィードバックを提供する強力なツールが含まれています。無料版と有料版の比較や詳細なランキングをご覧いただき、自信とスキルを高めるための必須オプションをお選びください。今すぐ探索して、面接成功に最適なツールを見つけましょう!
12 ツール
xix.ai

2026年版 クリエイティブな実験に最適な、最新・最高評価のAIスタイル転送ツール!XIX.AIは、実地テストと厳格なランキングを通じて卓越した結果をもたらす、強力で画期的な「必試」ツールを厳選しました。これらのトップソリューションは、コンテンツ制作を加速させ、無限の創造的可能性を切り拓くことで、クリエイターの生産性を大幅に向上させます。 今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
9 ツール
xix.ai

2026年版、ビジュアルストーリーテリングに最適な高評価AIダイアログバブルツールがXIX.AIに登場!この厳選コレクションには、クリエイターの生産性を高め、創作上のボトルネックを解消する、画期的な強力ツールが揃っています。 無料版と有料版の比較、実地テストの結果、最新のランキングを確認して、魅力的なビジュアルストーリーを構築するのに最適な、ぜひ試すべきソリューションを見つけましょう。今すぐチェックして、あなたにぴったりのツールを発見してください!
10 ツール
xix.ai

2026年版:意思決定の追跡を明確にし、フォローアップを容易にする、高評価のAI会議要約ツールベストセレクション。この厳選リストでは、会議メモの自動化、重要なアクション項目の特定、すべてのプロジェクトにわたるチーム連携の効率化を通じて、生産性を劇的に向上させる、強力で画期的なソリューションをご紹介します。 無料版と有料版の比較、実地テストの結果、毎週更新されるランキングを参考に、最適なツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai

2026年最新かつ最も評価の高いAIデータクリーニングツールをご紹介。欠損値や重複データを迅速に修正できるこれらのツールは、生産性を大幅に向上させる強力なソリューションです。各ツールは信頼性を確保するため、厳格な実環境でのテストを経ています。無料版と有料版の比較情報もご用意しており、あなたのニーズに最も合ったツールを見つけ出せます。今すぐXIX.AIで詳細を確認し、AI活用の強みを最大限に引き出しましょう。
11 ツール
xix.ai

Finally, an LLM that doesn't give up after page 50! 📚 As a legal analyst, reading 200-page contracts without losing context is a nightmare. This QwenLong-L1 framework could be a game-changer for enterprise workflows, though I'm still skeptical about the latency costs. Let's hope it's not just another hype cycle. 🤔












