


 Hogar
QwenLong-L1 resuelve tareas de razonamiento complejo que superan las capacidades actuales de los modelos de lenguaje grande (LLM).
El Grupo Alibaba ha presentado QwenLong-L1, un nuevo marco diseñado para permitir que los modelos de lenguaje grandes (LLM) razonen a partir de documentos excepcionalmente largos. Este avance tiene el potencial de impulsar una nueva generación de aplicaciones empresariales que exigen una comprensión profunda y un análisis perspicaz de materiales extensos, incluidos informes corporativos completos, estados financieros detallados y acuerdos legales complejos.
El obstáculo del razonamiento de IA en formatos largos
Los recientes avances en los modelos de razonamiento de gran tamaño (LRM), especialmente a través del aprendizaje por refuerzo (RL), han potenciado drásticamente sus capacidades para resolver problemas. Los estudios indican que el ajuste fino del RL dota a los LRM de una forma de «pensamiento lento» similar a la cognición humana, lo que les permite elaborar estrategias sofisticadas para abordar tareas complejas.
Sin embargo, estas mejoras se limitan en gran medida al trabajo con pasajes de texto relativamente breves, normalmente de alrededor de 4000 tokens. Sigue existiendo un obstáculo importante a la hora de ampliar esta capacidad de razonamiento a contextos mucho más largos, como 120 000 tokens. El razonamiento eficaz en formatos largos exige un conocimiento profundo de todo el documento y la capacidad de realizar análisis en varios pasos. «Esta limitación dificulta considerablemente los usos prácticos que implican conocimientos externos, como la investigación en profundidad, en la que los LRM deben recopilar y procesar información de fuentes ricas en datos», señalan los desarrolladores de QwenLong-L1 en su artículo de investigación.
El equipo enmarca estos obstáculos bajo el concepto de «razonamiento RL de contexto largo». A diferencia del razonamiento de contexto corto, que a menudo aprovecha el conocimiento interno del modelo, este enfoque requiere que los modelos encuentren y fijen con precisión los hechos relevantes dentro de entradas largas. Solo entonces pueden construir cadenas de razonamiento lógico basadas en esta información recuperada.
Entrenar modelos para esto mediante RL es un reto, ya que a menudo conduce a un aprendizaje ineficaz y a una optimización inestable. Los modelos suelen fracasar a la hora de converger en soluciones eficaces o pierden su capacidad para explorar diversas vías de razonamiento.
QwenLong-L1: un marco estructurado y multietapa
QwenLong-L1 es un marco de aprendizaje por refuerzo diseñado para ayudar a los LRM a evolucionar desde el manejo de textos cortos hasta la generalización robusta en contextos largos. Mejora los LRM de contexto corto existentes mediante un proceso deliberado y por fases:
Ajustes supervisados de calentamiento (SFT): el modelo se somete primero a SFT utilizando ejemplos de razonamiento en contextos largos. Esta fase construye una base sólida, enseñando al modelo a anclar con precisión la información de documentos largos y a desarrollar habilidades básicas en la comprensión del contexto, la generación de cadenas lógicas y la extracción de respuestas.
RL por fases guiado por un plan de estudios: aquí, el modelo se entrena a través de múltiples fases en las que la longitud del documento objetivo aumenta progresivamente. Este método paso a paso, basado en un plan de estudios, ayuda al modelo a adaptar de forma constante sus estrategias de razonamiento de textos más cortos a otros cada vez más largos, evitando la inestabilidad de la exposición abrupta a documentos extensos.
Muestreo retrospectivo consciente de la dificultad: La etapa final incorpora los ejemplos más desafiantes de las fases de entrenamiento anteriores. Al dar prioridad a los casos difíciles, se garantiza que el modelo continúe aprendiendo de los problemas difíciles y se le anima a explorar rutas de razonamiento más diversas y complejas.
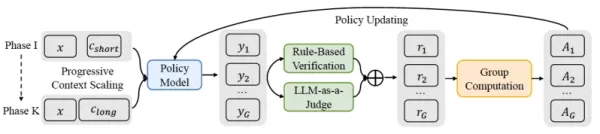
Proceso QwenLong-L1 Fuente: arXiv Más allá de este entrenamiento estructurado, QwenLong-L1 emplea un sistema de recompensas especializado. Mientras que el entrenamiento para tareas de contexto corto suele utilizar recompensas estrictas basadas en reglas (por ejemplo, para una respuesta matemática correcta), QwenLong-L1 utiliza un mecanismo híbrido. Combina la verificación basada en reglas para la precisión con un «LLM como juez» que compara el significado semántico de la respuesta generada con la referencia. Esto permite una mayor flexibilidad a la hora de evaluar las diversas formas en que se pueden formular las respuestas correctas dentro de documentos largos y matizados.
Evaluación del rendimiento de QwenLong-L1
El equipo de Alibaba probó QwenLong-L1 principalmente utilizando la respuesta a preguntas de documentos (DocQA), una tarea muy pertinente para las necesidades de las empresas, en la que la IA debe descifrar documentos densos para responder a consultas complejas.
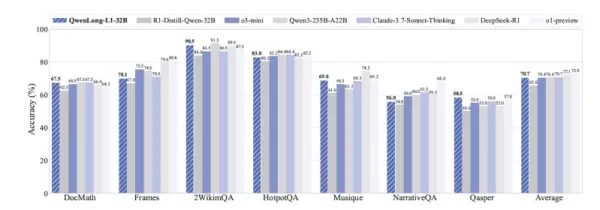
Los resultados de siete pruebas de DocQA de contexto largo demostraron la solidez de QwenLong-L1. El modelo QWENLONG-L1-32B (basado en DeepSeek-R1-Distill-Qwen-32B) alcanzó un rendimiento similar al de Claude-3.7 Sonnet Thinking de Anthropic y superó a modelos como o3-mini de OpenAI y Qwen3-235B-A22B. El modelo QWENLONG-L1-14B, más pequeño, también superó a Gemini 2.0 Flash Thinking de Google y a Qwen3-32B.
Fuente: arXiv Un hallazgo clave para el uso en el mundo real es cómo el entrenamiento RL cultiva comportamientos de razonamiento especializados en contextos largos. El artículo destaca que los modelos entrenados con QwenLong-L1 mejoran en «fundamentación» (vinculación de respuestas a secciones específicas de documentos), «establecimiento de subobjetivos» (descomposición de preguntas complejas), «retroceso» (identificación y corrección de errores en medio del razonamiento) y «verificación» (recomprobación de sus respuestas).
Por ejemplo, mientras que un modelo básico podría descarrilarse por detalles irrelevantes en un informe financiero o dar vueltas sin fin en un análisis tangencial, un modelo entrenado con QwenLong-L1 mostró una autorreflexión eficaz. Podía filtrar la información que distraía, retroceder desde enfoques incorrectos y llegar con éxito a la conclusión correcta.
Marcos como QwenLong-L1 podrían ampliar sustancialmente la utilidad empresarial de la IA. Las posibles aplicaciones abarcan la tecnología jurídica (análisis de voluminosos documentos legales), las finanzas (realización de una profunda diligencia debida en informes anuales y documentos financieros para obtener información sobre riesgos o inversiones) y el servicio al cliente (revisión de largos historiales de interacción para proporcionar un apoyo más contextual). Los investigadores han puesto a disposición del público el código del marco QwenLong-L1 y los pesos de los modelos entrenados.
Artículo relacionado
 Dentro de los detalles revelados sobre el Gemini de próxima generación: Potencia de cálculo limitada, los equipos internos discreparon sobre las prioridades de desarrollo y la asignación de recursos
Los informes indican que el lanzamiento del tan esperado modelo Gemini de próxima generación de Google ha sido pospuesto. Los desacuerdos internos sobre las prioridades de desarrollo y la asignación de recursos, combinados con una capacidad de comput
OpenAI descarta preocupaciones por la desaceleración del crecimiento y afirma que múltiples unidades de negocio están acelerando
En respuesta a la escrutinio externo sobre el desaceleramiento del crecimiento de las ventas y el incumplimiento de las metas internas, el líder en inteligencia artificial, OpenAI, emitió una declaración contundente el martes 28 de abril. La empresa
Copa Super de Alibaba: Qwen3.8-Max hace su debut con herramientas de codificación y oficina mejoradas
Alibaba ha presentado oficialmente Qwen3.8-Max, un modelo base de última generación con 2,4 billones de parámetros. Este importante avance en inteligencia artificial ofrece mejoras sustanciales en áreas clave como la programación y las tareas profesi
Recomendaciones de temas especiales relacionados
composicion musical
 Mejores herramientas de IA para escribir melodías en borradores de canciones
2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
 8 herramientas
 xix.ai
chatbot
Mejores herramientas de entrenamiento de conversación con IA para practicar entrevistas
¡Las mejores herramientas de entrenamiento de conversación con IA para prácticas de entrevistas más recientes y mejor valoradas de 2026 ya están disponibles en XIX.AI! Esta colección seleccionada incluye herramientas poderosas y transformadoras que han pasado por rigurosas pruebas en el mundo real para ofrecer retroalimentación precisa. Encontrarás una comparación entre opciones gratuitas y de pago, así como clasificaciones detalladas para ayudarte a elegir la opción imprescindible que aumente tu confianza y habilidades. ¡Explora ahora para descubrir tu herramienta perfecta para el éxito en las entrevistas!
12 herramientas
xix.ai
Diseño y Arte
Las mejores herramientas de transferencia de estilos con IA para experimentos creativos
¡Las mejores herramientas de transferencia de estilo con IA de 2026, mejor valoradas para experimentos creativos! XIX.AI ha seleccionado una colección de herramientas potentes y revolucionarias que no te puedes perder, capaces de ofrecer resultados excepcionales según pruebas reales y clasificaciones rigurosas. Estas soluciones de primera categoría ayudan a los creativos a aumentar significativamente su productividad, acelerando la creación de contenidos y abriendo un sinfín de posibilidades creativas. ¡Explora ahora mismo para descubrir tu herramienta perfecta y empieza a crear hoy mismo!
9 herramientas
xix.ai
Creación de cómics
Las mejores herramientas de burbujas de diálogo con IA para la narración visual
¡Ya están aquí, en XIX.AI, las mejores herramientas de 2026 con las mejores valoraciones para crear bocadillos de diálogo con IA y contar historias visuales! Esta selección incluye potentes herramientas revolucionarias que ayudan a los creadores a aumentar su productividad y superar los bloqueos creativos. Consulta una comparación entre las versiones gratuitas y de pago, echa un vistazo a las pruebas en condiciones reales y revisa las últimas clasificaciones para encontrar las soluciones imprescindibles, perfectas para crear narrativas visuales cautivadoras. ¡Explora ahora mismo y descubre tu herramienta ideal!
10 herramientas
xix.ai
Asistente de reuniones
Las mejores herramientas de resumen de reuniones con IA: realiza un seguimiento claro de las decisiones y las acciones de seguimiento
Las mejores herramientas de resumen de reuniones con IA de 2026, mejor valoradas para un seguimiento claro de las decisiones y un seguimiento posterior sin esfuerzo. Esta lista seleccionada presenta soluciones potentes y revolucionarias que aumentan drásticamente la productividad al automatizar las notas de las reuniones, identificar las acciones clave y agilizar la coordinación del equipo en todos los proyectos. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones actualizadas semanalmente, para ayudarte a encontrar la herramienta perfecta. ¡Explora ahora mismo y aprovecha las ventajas de la IA!
9 herramientas
xix.ai
Análisis de datos
Mejores herramientas de limpieza de datos con IA: corrige valores faltantes y duplicados rápidamente
2026: Las mejores herramientas de limpieza de datos basadas en IA, mejor calificadas y más actualizadas, para corregir rápidamente valores faltantes y duplicados. Esta lista cuidadosamente seleccionada presenta soluciones potentes que transforman el trabajo y aumentan significativamente la productividad. Cada opción ha sido sometida a pruebas rigurosas en entornos reales para garantizar su fiabilidad. Obtenga una comparación gratuita entre las opciones gratuitas y de pago y descubra la herramienta imprescindible que mejor se adapte a sus necesidades. Explore ahora en XIX.AI para darle un vantaje con la inteligencia artificial.
11 herramientas
xix.ai

 comentario (1)
0/500
![AlbertHernández]()
Finally, an LLM that doesn't give up after page 50! 📚 As a legal analyst, reading 200-page contracts without losing context is a nightmare. This QwenLong-L1 framework could be a game-changer for enterprise workflows, though I'm still skeptical about the latency costs. Let's hope it's not just another hype cycle. 🤔
El Grupo Alibaba ha presentado QwenLong-L1, un nuevo marco diseñado para permitir que los modelos de lenguaje grandes (LLM) razonen a partir de documentos excepcionalmente largos. Este avance tiene el potencial de impulsar una nueva generación de aplicaciones empresariales que exigen una comprensión profunda y un análisis perspicaz de materiales extensos, incluidos informes corporativos completos, estados financieros detallados y acuerdos legales complejos.
El obstáculo del razonamiento de IA en formatos largos
Los recientes avances en los modelos de razonamiento de gran tamaño (LRM), especialmente a través del aprendizaje por refuerzo (RL), han potenciado drásticamente sus capacidades para resolver problemas. Los estudios indican que el ajuste fino del RL dota a los LRM de una forma de «pensamiento lento» similar a la cognición humana, lo que les permite elaborar estrategias sofisticadas para abordar tareas complejas.
Sin embargo, estas mejoras se limitan en gran medida al trabajo con pasajes de texto relativamente breves, normalmente de alrededor de 4000 tokens. Sigue existiendo un obstáculo importante a la hora de ampliar esta capacidad de razonamiento a contextos mucho más largos, como 120 000 tokens. El razonamiento eficaz en formatos largos exige un conocimiento profundo de todo el documento y la capacidad de realizar análisis en varios pasos. «Esta limitación dificulta considerablemente los usos prácticos que implican conocimientos externos, como la investigación en profundidad, en la que los LRM deben recopilar y procesar información de fuentes ricas en datos», señalan los desarrolladores de QwenLong-L1 en su artículo de investigación.
El equipo enmarca estos obstáculos bajo el concepto de «razonamiento RL de contexto largo». A diferencia del razonamiento de contexto corto, que a menudo aprovecha el conocimiento interno del modelo, este enfoque requiere que los modelos encuentren y fijen con precisión los hechos relevantes dentro de entradas largas. Solo entonces pueden construir cadenas de razonamiento lógico basadas en esta información recuperada.
Entrenar modelos para esto mediante RL es un reto, ya que a menudo conduce a un aprendizaje ineficaz y a una optimización inestable. Los modelos suelen fracasar a la hora de converger en soluciones eficaces o pierden su capacidad para explorar diversas vías de razonamiento.
QwenLong-L1: un marco estructurado y multietapa
QwenLong-L1 es un marco de aprendizaje por refuerzo diseñado para ayudar a los LRM a evolucionar desde el manejo de textos cortos hasta la generalización robusta en contextos largos. Mejora los LRM de contexto corto existentes mediante un proceso deliberado y por fases:
Ajustes supervisados de calentamiento (SFT): el modelo se somete primero a SFT utilizando ejemplos de razonamiento en contextos largos. Esta fase construye una base sólida, enseñando al modelo a anclar con precisión la información de documentos largos y a desarrollar habilidades básicas en la comprensión del contexto, la generación de cadenas lógicas y la extracción de respuestas.
RL por fases guiado por un plan de estudios: aquí, el modelo se entrena a través de múltiples fases en las que la longitud del documento objetivo aumenta progresivamente. Este método paso a paso, basado en un plan de estudios, ayuda al modelo a adaptar de forma constante sus estrategias de razonamiento de textos más cortos a otros cada vez más largos, evitando la inestabilidad de la exposición abrupta a documentos extensos.
Muestreo retrospectivo consciente de la dificultad: La etapa final incorpora los ejemplos más desafiantes de las fases de entrenamiento anteriores. Al dar prioridad a los casos difíciles, se garantiza que el modelo continúe aprendiendo de los problemas difíciles y se le anima a explorar rutas de razonamiento más diversas y complejas.
Más allá de este entrenamiento estructurado, QwenLong-L1 emplea un sistema de recompensas especializado. Mientras que el entrenamiento para tareas de contexto corto suele utilizar recompensas estrictas basadas en reglas (por ejemplo, para una respuesta matemática correcta), QwenLong-L1 utiliza un mecanismo híbrido. Combina la verificación basada en reglas para la precisión con un «LLM como juez» que compara el significado semántico de la respuesta generada con la referencia. Esto permite una mayor flexibilidad a la hora de evaluar las diversas formas en que se pueden formular las respuestas correctas dentro de documentos largos y matizados.
Evaluación del rendimiento de QwenLong-L1
El equipo de Alibaba probó QwenLong-L1 principalmente utilizando la respuesta a preguntas de documentos (DocQA), una tarea muy pertinente para las necesidades de las empresas, en la que la IA debe descifrar documentos densos para responder a consultas complejas.
Los resultados de siete pruebas de DocQA de contexto largo demostraron la solidez de QwenLong-L1. El modelo QWENLONG-L1-32B (basado en DeepSeek-R1-Distill-Qwen-32B) alcanzó un rendimiento similar al de Claude-3.7 Sonnet Thinking de Anthropic y superó a modelos como o3-mini de OpenAI y Qwen3-235B-A22B. El modelo QWENLONG-L1-14B, más pequeño, también superó a Gemini 2.0 Flash Thinking de Google y a Qwen3-32B.
Un hallazgo clave para el uso en el mundo real es cómo el entrenamiento RL cultiva comportamientos de razonamiento especializados en contextos largos. El artículo destaca que los modelos entrenados con QwenLong-L1 mejoran en «fundamentación» (vinculación de respuestas a secciones específicas de documentos), «establecimiento de subobjetivos» (descomposición de preguntas complejas), «retroceso» (identificación y corrección de errores en medio del razonamiento) y «verificación» (recomprobación de sus respuestas).
Por ejemplo, mientras que un modelo básico podría descarrilarse por detalles irrelevantes en un informe financiero o dar vueltas sin fin en un análisis tangencial, un modelo entrenado con QwenLong-L1 mostró una autorreflexión eficaz. Podía filtrar la información que distraía, retroceder desde enfoques incorrectos y llegar con éxito a la conclusión correcta.
Marcos como QwenLong-L1 podrían ampliar sustancialmente la utilidad empresarial de la IA. Las posibles aplicaciones abarcan la tecnología jurídica (análisis de voluminosos documentos legales), las finanzas (realización de una profunda diligencia debida en informes anuales y documentos financieros para obtener información sobre riesgos o inversiones) y el servicio al cliente (revisión de largos historiales de interacción para proporcionar un apoyo más contextual). Los investigadores han puesto a disposición del público el código del marco QwenLong-L1 y los pesos de los modelos entrenados.








 Dentro de los detalles revelados sobre el Gemini de próxima generación: Potencia de cálculo limitada, los equipos internos discreparon sobre las prioridades de desarrollo y la asignación de recursos
Los informes indican que el lanzamiento del tan esperado modelo Gemini de próxima generación de Google ha sido pospuesto. Los desacuerdos internos sobre las prioridades de desarrollo y la asignación de recursos, combinados con una capacidad de comput
 OpenAI descarta preocupaciones por la desaceleración del crecimiento y afirma que múltiples unidades de negocio están acelerando
En respuesta a la escrutinio externo sobre el desaceleramiento del crecimiento de las ventas y el incumplimiento de las metas internas, el líder en inteligencia artificial, OpenAI, emitió una declaración contundente el martes 28 de abril. La empresa
 Copa Super de Alibaba: Qwen3.8-Max hace su debut con herramientas de codificación y oficina mejoradas
Alibaba ha presentado oficialmente Qwen3.8-Max, un modelo base de última generación con 2,4 billones de parámetros. Este importante avance en inteligencia artificial ofrece mejoras sustanciales en áreas clave como la programación y las tareas profesi

2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
8 herramientas
xix.ai

¡Las mejores herramientas de entrenamiento de conversación con IA para prácticas de entrevistas más recientes y mejor valoradas de 2026 ya están disponibles en XIX.AI! Esta colección seleccionada incluye herramientas poderosas y transformadoras que han pasado por rigurosas pruebas en el mundo real para ofrecer retroalimentación precisa. Encontrarás una comparación entre opciones gratuitas y de pago, así como clasificaciones detalladas para ayudarte a elegir la opción imprescindible que aumente tu confianza y habilidades. ¡Explora ahora para descubrir tu herramienta perfecta para el éxito en las entrevistas!
12 herramientas
xix.ai

¡Las mejores herramientas de transferencia de estilo con IA de 2026, mejor valoradas para experimentos creativos! XIX.AI ha seleccionado una colección de herramientas potentes y revolucionarias que no te puedes perder, capaces de ofrecer resultados excepcionales según pruebas reales y clasificaciones rigurosas. Estas soluciones de primera categoría ayudan a los creativos a aumentar significativamente su productividad, acelerando la creación de contenidos y abriendo un sinfín de posibilidades creativas. ¡Explora ahora mismo para descubrir tu herramienta perfecta y empieza a crear hoy mismo!
9 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, las mejores herramientas de 2026 con las mejores valoraciones para crear bocadillos de diálogo con IA y contar historias visuales! Esta selección incluye potentes herramientas revolucionarias que ayudan a los creadores a aumentar su productividad y superar los bloqueos creativos. Consulta una comparación entre las versiones gratuitas y de pago, echa un vistazo a las pruebas en condiciones reales y revisa las últimas clasificaciones para encontrar las soluciones imprescindibles, perfectas para crear narrativas visuales cautivadoras. ¡Explora ahora mismo y descubre tu herramienta ideal!
10 herramientas
xix.ai

Las mejores herramientas de resumen de reuniones con IA de 2026, mejor valoradas para un seguimiento claro de las decisiones y un seguimiento posterior sin esfuerzo. Esta lista seleccionada presenta soluciones potentes y revolucionarias que aumentan drásticamente la productividad al automatizar las notas de las reuniones, identificar las acciones clave y agilizar la coordinación del equipo en todos los proyectos. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones actualizadas semanalmente, para ayudarte a encontrar la herramienta perfecta. ¡Explora ahora mismo y aprovecha las ventajas de la IA!
9 herramientas
xix.ai

2026: Las mejores herramientas de limpieza de datos basadas en IA, mejor calificadas y más actualizadas, para corregir rápidamente valores faltantes y duplicados. Esta lista cuidadosamente seleccionada presenta soluciones potentes que transforman el trabajo y aumentan significativamente la productividad. Cada opción ha sido sometida a pruebas rigurosas en entornos reales para garantizar su fiabilidad. Obtenga una comparación gratuita entre las opciones gratuitas y de pago y descubra la herramienta imprescindible que mejor se adapte a sus necesidades. Explore ahora en XIX.AI para darle un vantaje con la inteligencia artificial.
11 herramientas
xix.ai

Finally, an LLM that doesn't give up after page 50! 📚 As a legal analyst, reading 200-page contracts without losing context is a nightmare. This QwenLong-L1 framework could be a game-changer for enterprise workflows, though I'm still skeptical about the latency costs. Let's hope it's not just another hype cycle. 🤔












