


 Lar
QwenLong-L1 resolve tarefas complexas de raciocínio além das capacidades dos LLMs atuais
O Alibaba Group revelou o QwenLong-L1, uma nova estrutura projetada para capacitar modelos de linguagem de grande porte (LLMs) a raciocinar sobre documentos excepcionalmente longos. Essa inovação tem o potencial de impulsionar uma nova geração de aplicativos empresariais que exigem compreensão profunda e análise perspicaz de materiais extensos, incluindo relatórios corporativos abrangentes, demonstrações financeiras detalhadas e contratos jurídicos complexos.
O obstáculo do raciocínio de IA em formatos longos
Os recentes avanços em modelos de raciocínio de grande porte (LRMs), especialmente por meio do aprendizado por reforço (RL), aumentaram drasticamente suas habilidades de resolução de problemas. Estudos indicam que o ajuste fino do RL dota os LRMs de uma forma de “pensamento lento” semelhante à cognição humana, permitindo-lhes elaborar estratégias sofisticadas para lidar com tarefas complexas.
No entanto, esses ganhos estão amplamente restritos ao trabalho com trechos de texto relativamente curtos, geralmente em torno de 4.000 tokens. Um obstáculo significativo permanece na ampliação dessa capacidade de raciocínio para contextos muito mais longos, como 120.000 tokens. O raciocínio eficaz em textos longos exige uma compreensão sólida de todo o documento e a capacidade de análise em várias etapas. “Essa restrição dificulta significativamente os usos práticos que envolvem conhecimento externo, como pesquisas aprofundadas em que os LRMs precisam coletar e processar informações de fontes ricas em dados”, observam os desenvolvedores do QwenLong-L1 em seu artigo de pesquisa.
A equipe enquadra esses obstáculos sob o conceito de “raciocínio RL de contexto longo”. Ao contrário do raciocínio de contexto curto, que muitas vezes aproveita o conhecimento interno do modelo, essa abordagem exige que os modelos encontrem e fixem com precisão fatos relevantes em entradas longas. Só então eles podem construir cadeias de raciocínio lógico com base nessas informações recuperadas.
Treinar modelos para isso por meio de RL é desafiador, frequentemente levando a um aprendizado ineficiente e otimização instável. Os modelos muitas vezes não conseguem convergir para soluções eficazes ou perdem sua capacidade de explorar caminhos de raciocínio variados.
QwenLong-L1: uma estrutura estruturada em várias etapas
O QwenLong-L1 é uma estrutura de aprendizagem por reforço criada para ajudar os LRM a evoluir do tratamento de textos curtos para a generalização robusta em contextos longos. Ele aprimora os LRM de contexto curto existentes por meio de um processo deliberado e em fases:
Aqueecimento com ajuste fino supervisionado (SFT): o modelo primeiro passa por SFT usando exemplos de raciocínio em contextos longos. Essa fase constrói uma base sólida, ensinando o modelo a ancorar com precisão as informações de documentos longos e desenvolver habilidades essenciais na compreensão do contexto, geração de cadeias lógicas e extração de respostas.
RL em fases guiado por currículo: aqui, o modelo é treinado por meio de várias fases em que o comprimento do documento alvo aumenta progressivamente. Esse método passo a passo, baseado em currículo, ajuda o modelo a adaptar de forma constante suas estratégias de raciocínio de textos mais curtos para textos cada vez mais longos, evitando a instabilidade da exposição abrupta a documentos extensos.
Amostragem retrospectiva com reconhecimento de dificuldade: A etapa final incorpora os exemplos mais desafiadores das fases de treinamento anteriores. Ao priorizar instâncias difíceis, ela garante que o modelo continue aprendendo com problemas complexos e seja incentivado a explorar rotas de raciocínio mais diversificadas e complexas.
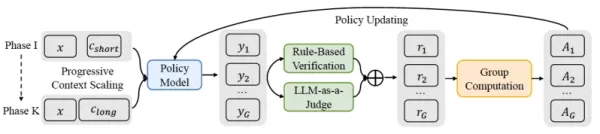
Processo QwenLong-L1 Fonte: arXiv Além desse treinamento estruturado, o QwenLong-L1 emprega um sistema de recompensa especializado. Enquanto o treinamento para tarefas de contexto curto geralmente usa recompensas baseadas em regras rígidas (por exemplo, para uma resposta matemática correta), o QwenLong-L1 usa um mecanismo híbrido. Ele combina a verificação baseada em regras para precisão com um “LLM como juiz” que compara o significado semântico da resposta gerada com a referência. Isso permite maior flexibilidade na avaliação das diversas maneiras pelas quais as respostas corretas podem ser formuladas em documentos longos e cheios de nuances.
Avaliação do desempenho do QwenLong-L1
A equipe da Alibaba testou o QwenLong-L1 principalmente usando perguntas e respostas de documentos (DocQA), uma tarefa altamente pertinente às necessidades empresariais, em que a IA deve decifrar documentos densos para responder a consultas complexas.
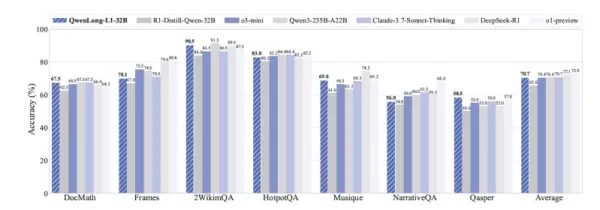
Os resultados em sete benchmarks DocQA de contexto longo demonstraram a força do QwenLong-L1. O modelo QWENLONG-L1-32B (baseado no DeepSeek-R1-Distill-Qwen-32B) alcançou desempenho equivalente ao Claude-3.7 Sonnet Thinking da Anthropic e superou modelos como o o3-mini da OpenAI e o Qwen3-235B-A22B. O modelo QWENLONG-L1-14B, menor, também superou o Gemini 2.0 Flash Thinking, do Google, e o Qwen3-32B.
Fonte: arXiv Uma descoberta importante para o uso no mundo real é como o treinamento RL cultiva comportamentos especializados de raciocínio de contexto longo. O artigo destaca que os modelos treinados com QwenLong-L1 melhoram em “fundamentação” (vinculando respostas a seções específicas de documentos), “definição de submetas” (decompondo perguntas complexas), “retrocesso” (identificando e corrigindo erros no meio do raciocínio) e “verificação” (reverificando suas respostas).
Por exemplo, enquanto um modelo básico pode ser prejudicado por detalhes irrelevantes em um relatório financeiro ou ficar preso em análises tangenciais, um modelo treinado com QwenLong-L1 mostrou uma autorreflexão eficaz. Ele conseguiu filtrar informações que distraíam, refazer o caminho a partir de abordagens incorretas e chegar à conclusão correta.
Estruturas como o QwenLong-L1 podem ampliar substancialmente a utilidade da IA nas empresas. As aplicações potenciais abrangem tecnologia jurídica (análise de documentos jurídicos volumosos), finanças (realização de due diligence aprofundada em relatórios anuais e registros financeiros para obter insights sobre riscos ou investimentos) e atendimento ao cliente (revisão de longos históricos de interação para fornecer suporte mais contextual). Os pesquisadores disponibilizaram publicamente o código da estrutura QwenLong-L1 e os pesos dos modelos treinados.
Artigo relacionado
 Magnata da Tecnologia da Índia Investe US$ 30 Milhões em Concorrente de IA ao Microsoft Office
O empreendedor serial Bhavin Turakhia está investindo US$ 30 milhões de seu próprio capital, apostando que o setor de IA empresarial ainda tem espaço para novos jogadores. Sua mais recente startup, a Neo, opera com uma crença central: o software lega
Ex-Cientista-Chefe da OpenAI, Ilya, apresenta seu primeiro modelo de SSI
A inteligência artificial alcançou mais um grande marco. Após sua saída da OpenAI, o ex-chefe de ciência Ilya Sutskever estabeleceu a Safe Superintelligence Inc. (SSI), que recentemente revelou detalhes sobre seu modelo inaugural. Relatórios de redes
Lovable Leads Atech's Seed Round as AI Ambient Coding Officially Enters the Hardware Field
Em 14 de maio de 2026, a plataforma de desenvolvimento de aplicações de IA Lovable anunciou sua participação na rodada de investimento inicial (seed) de US$ 800.000 para a startup dinamarquesa de hardware Atech. Liderada pela Lovable, a rodada atraiu
Recomendações de tópicos especiais relacionados
chatbot
 Melhores ferramentas de treinamento de conversação com IA para prática de entrevistas
As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
 12 ferramentas
 xix.ai
Design e Arte
As melhores ferramentas de transferência de estilo com IA para experimentos criativos
As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai
Criação de quadrinhos
As melhores ferramentas de balões de diálogo com IA para a narrativa visual
As melhores e mais bem avaliadas ferramentas de balões de diálogo com IA para narrativa visual de 2026 já estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que ajudam os criadores a aumentar a produtividade e superar gargalos criativos. Veja uma comparação entre versões gratuitas e pagas, confira testes reais e verifique os rankings mais recentes para encontrar as soluções imperdíveis, perfeitas para criar narrativas visuais envolventes. Explore agora e descubra sua ferramenta ideal!
10 ferramentas
xix.ai
Assistente de Reunião
As melhores ferramentas de resumo de reuniões com IA: acompanhe decisões e ações de acompanhamento com clareza
As melhores e mais bem avaliadas ferramentas de resumo de reuniões com IA de 2026 para um acompanhamento claro das decisões e acompanhamentos sem esforço. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam drasticamente a produtividade ao automatizar notas de reuniões, identificar ações-chave e otimizar a coordenação da equipe em todos os projetos. Veja uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente para ajudá-lo a encontrar a ferramenta perfeita. Explore agora para aproveitar ao máximo as vantagens da IA!
9 ferramentas
xix.ai
Análise de dados
Melhores ferramentas de limpeza de dados com IA: corrija valores faltantes e duplicatas rapidamente
2026 – Os melhores e mais bem avaliados ferramentas de limpeza de dados com IA, atualizadas para corrigir rapidamente valores faltantes e duplicatas. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam significativamente a produtividade. Cada opção passou por testes rigorosos em condições reais para garantir sua confiabilidade. Acesse uma comparação gratuita entre as versões pagas e gratuitas e descubra a ferramenta indispensável que melhor atende às suas necessidades. Explore agora em XIX.AI para aproveitar todos os benefícios oferecidos pela IA.
11 ferramentas
xix.ai
Design e Arte
Melhores Ferramentas de Ideação Criativa com IA para Artistas: Supere os Bloqueios Visuais
2026 Últimas Melhores Ferramentas de Ideação Criativa com IA Mais Bem Avaliadas para Artistas são selecionadas pela XIX.AI para ajudar os criadores a superar bloqueios visuais e impulsionar a criatividade instantaneamente. Essas poderosas ferramentas transformadoras oferecem testes do mundo real, comparação detalhada entre gratuito e pago e classificações atualizadas semanalmente. Descubra sua ferramenta perfeita para acelerar a criação de conteúdo e desbloquear sua vantagem com IA hoje. Explore agora!
14 ferramentas
xix.ai

 Comentários (1)
![AlbertHernández]()
Finally, an LLM that doesn't give up after page 50! 📚 As a legal analyst, reading 200-page contracts without losing context is a nightmare. This QwenLong-L1 framework could be a game-changer for enterprise workflows, though I'm still skeptical about the latency costs. Let's hope it's not just another hype cycle. 🤔
O Alibaba Group revelou o QwenLong-L1, uma nova estrutura projetada para capacitar modelos de linguagem de grande porte (LLMs) a raciocinar sobre documentos excepcionalmente longos. Essa inovação tem o potencial de impulsionar uma nova geração de aplicativos empresariais que exigem compreensão profunda e análise perspicaz de materiais extensos, incluindo relatórios corporativos abrangentes, demonstrações financeiras detalhadas e contratos jurídicos complexos.
O obstáculo do raciocínio de IA em formatos longos
Os recentes avanços em modelos de raciocínio de grande porte (LRMs), especialmente por meio do aprendizado por reforço (RL), aumentaram drasticamente suas habilidades de resolução de problemas. Estudos indicam que o ajuste fino do RL dota os LRMs de uma forma de “pensamento lento” semelhante à cognição humana, permitindo-lhes elaborar estratégias sofisticadas para lidar com tarefas complexas.
No entanto, esses ganhos estão amplamente restritos ao trabalho com trechos de texto relativamente curtos, geralmente em torno de 4.000 tokens. Um obstáculo significativo permanece na ampliação dessa capacidade de raciocínio para contextos muito mais longos, como 120.000 tokens. O raciocínio eficaz em textos longos exige uma compreensão sólida de todo o documento e a capacidade de análise em várias etapas. “Essa restrição dificulta significativamente os usos práticos que envolvem conhecimento externo, como pesquisas aprofundadas em que os LRMs precisam coletar e processar informações de fontes ricas em dados”, observam os desenvolvedores do QwenLong-L1 em seu artigo de pesquisa.
A equipe enquadra esses obstáculos sob o conceito de “raciocínio RL de contexto longo”. Ao contrário do raciocínio de contexto curto, que muitas vezes aproveita o conhecimento interno do modelo, essa abordagem exige que os modelos encontrem e fixem com precisão fatos relevantes em entradas longas. Só então eles podem construir cadeias de raciocínio lógico com base nessas informações recuperadas.
Treinar modelos para isso por meio de RL é desafiador, frequentemente levando a um aprendizado ineficiente e otimização instável. Os modelos muitas vezes não conseguem convergir para soluções eficazes ou perdem sua capacidade de explorar caminhos de raciocínio variados.
QwenLong-L1: uma estrutura estruturada em várias etapas
O QwenLong-L1 é uma estrutura de aprendizagem por reforço criada para ajudar os LRM a evoluir do tratamento de textos curtos para a generalização robusta em contextos longos. Ele aprimora os LRM de contexto curto existentes por meio de um processo deliberado e em fases:
Aqueecimento com ajuste fino supervisionado (SFT): o modelo primeiro passa por SFT usando exemplos de raciocínio em contextos longos. Essa fase constrói uma base sólida, ensinando o modelo a ancorar com precisão as informações de documentos longos e desenvolver habilidades essenciais na compreensão do contexto, geração de cadeias lógicas e extração de respostas.
RL em fases guiado por currículo: aqui, o modelo é treinado por meio de várias fases em que o comprimento do documento alvo aumenta progressivamente. Esse método passo a passo, baseado em currículo, ajuda o modelo a adaptar de forma constante suas estratégias de raciocínio de textos mais curtos para textos cada vez mais longos, evitando a instabilidade da exposição abrupta a documentos extensos.
Amostragem retrospectiva com reconhecimento de dificuldade: A etapa final incorpora os exemplos mais desafiadores das fases de treinamento anteriores. Ao priorizar instâncias difíceis, ela garante que o modelo continue aprendendo com problemas complexos e seja incentivado a explorar rotas de raciocínio mais diversificadas e complexas.
Além desse treinamento estruturado, o QwenLong-L1 emprega um sistema de recompensa especializado. Enquanto o treinamento para tarefas de contexto curto geralmente usa recompensas baseadas em regras rígidas (por exemplo, para uma resposta matemática correta), o QwenLong-L1 usa um mecanismo híbrido. Ele combina a verificação baseada em regras para precisão com um “LLM como juiz” que compara o significado semântico da resposta gerada com a referência. Isso permite maior flexibilidade na avaliação das diversas maneiras pelas quais as respostas corretas podem ser formuladas em documentos longos e cheios de nuances.
Avaliação do desempenho do QwenLong-L1
A equipe da Alibaba testou o QwenLong-L1 principalmente usando perguntas e respostas de documentos (DocQA), uma tarefa altamente pertinente às necessidades empresariais, em que a IA deve decifrar documentos densos para responder a consultas complexas.
Os resultados em sete benchmarks DocQA de contexto longo demonstraram a força do QwenLong-L1. O modelo QWENLONG-L1-32B (baseado no DeepSeek-R1-Distill-Qwen-32B) alcançou desempenho equivalente ao Claude-3.7 Sonnet Thinking da Anthropic e superou modelos como o o3-mini da OpenAI e o Qwen3-235B-A22B. O modelo QWENLONG-L1-14B, menor, também superou o Gemini 2.0 Flash Thinking, do Google, e o Qwen3-32B.
Uma descoberta importante para o uso no mundo real é como o treinamento RL cultiva comportamentos especializados de raciocínio de contexto longo. O artigo destaca que os modelos treinados com QwenLong-L1 melhoram em “fundamentação” (vinculando respostas a seções específicas de documentos), “definição de submetas” (decompondo perguntas complexas), “retrocesso” (identificando e corrigindo erros no meio do raciocínio) e “verificação” (reverificando suas respostas).
Por exemplo, enquanto um modelo básico pode ser prejudicado por detalhes irrelevantes em um relatório financeiro ou ficar preso em análises tangenciais, um modelo treinado com QwenLong-L1 mostrou uma autorreflexão eficaz. Ele conseguiu filtrar informações que distraíam, refazer o caminho a partir de abordagens incorretas e chegar à conclusão correta.
Estruturas como o QwenLong-L1 podem ampliar substancialmente a utilidade da IA nas empresas. As aplicações potenciais abrangem tecnologia jurídica (análise de documentos jurídicos volumosos), finanças (realização de due diligence aprofundada em relatórios anuais e registros financeiros para obter insights sobre riscos ou investimentos) e atendimento ao cliente (revisão de longos históricos de interação para fornecer suporte mais contextual). Os pesquisadores disponibilizaram publicamente o código da estrutura QwenLong-L1 e os pesos dos modelos treinados.








 Magnata da Tecnologia da Índia Investe US$ 30 Milhões em Concorrente de IA ao Microsoft Office
O empreendedor serial Bhavin Turakhia está investindo US$ 30 milhões de seu próprio capital, apostando que o setor de IA empresarial ainda tem espaço para novos jogadores. Sua mais recente startup, a Neo, opera com uma crença central: o software lega
 Ex-Cientista-Chefe da OpenAI, Ilya, apresenta seu primeiro modelo de SSI
A inteligência artificial alcançou mais um grande marco. Após sua saída da OpenAI, o ex-chefe de ciência Ilya Sutskever estabeleceu a Safe Superintelligence Inc. (SSI), que recentemente revelou detalhes sobre seu modelo inaugural. Relatórios de redes
 Lovable Leads Atech's Seed Round as AI Ambient Coding Officially Enters the Hardware Field
Em 14 de maio de 2026, a plataforma de desenvolvimento de aplicações de IA Lovable anunciou sua participação na rodada de investimento inicial (seed) de US$ 800.000 para a startup dinamarquesa de hardware Atech. Liderada pela Lovable, a rodada atraiu

As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de balões de diálogo com IA para narrativa visual de 2026 já estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que ajudam os criadores a aumentar a produtividade e superar gargalos criativos. Veja uma comparação entre versões gratuitas e pagas, confira testes reais e verifique os rankings mais recentes para encontrar as soluções imperdíveis, perfeitas para criar narrativas visuais envolventes. Explore agora e descubra sua ferramenta ideal!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de resumo de reuniões com IA de 2026 para um acompanhamento claro das decisões e acompanhamentos sem esforço. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam drasticamente a produtividade ao automatizar notas de reuniões, identificar ações-chave e otimizar a coordenação da equipe em todos os projetos. Veja uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente para ajudá-lo a encontrar a ferramenta perfeita. Explore agora para aproveitar ao máximo as vantagens da IA!
9 ferramentas
xix.ai

2026 – Os melhores e mais bem avaliados ferramentas de limpeza de dados com IA, atualizadas para corrigir rapidamente valores faltantes e duplicatas. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam significativamente a produtividade. Cada opção passou por testes rigorosos em condições reais para garantir sua confiabilidade. Acesse uma comparação gratuita entre as versões pagas e gratuitas e descubra a ferramenta indispensável que melhor atende às suas necessidades. Explore agora em XIX.AI para aproveitar todos os benefícios oferecidos pela IA.
11 ferramentas
xix.ai

2026 Últimas Melhores Ferramentas de Ideação Criativa com IA Mais Bem Avaliadas para Artistas são selecionadas pela XIX.AI para ajudar os criadores a superar bloqueios visuais e impulsionar a criatividade instantaneamente. Essas poderosas ferramentas transformadoras oferecem testes do mundo real, comparação detalhada entre gratuito e pago e classificações atualizadas semanalmente. Descubra sua ferramenta perfeita para acelerar a criação de conteúdo e desbloquear sua vantagem com IA hoje. Explore agora!
14 ferramentas
xix.ai

Finally, an LLM that doesn't give up after page 50! 📚 As a legal analyst, reading 200-page contracts without losing context is a nightmare. This QwenLong-L1 framework could be a game-changer for enterprise workflows, though I'm still skeptical about the latency costs. Let's hope it's not just another hype cycle. 🤔












