


 Heim
QwenLong-L1 löst komplexe Denkaufgaben, die über die Fähigkeiten aktueller LLMs hinausgehen
Die Alibaba Group hat QwenLong-L1 vorgestellt, ein neues Framework, das große Sprachmodelle (LLMs) in die Lage versetzt, außergewöhnlich lange Dokumente zu analysieren. Dieser Durchbruch hat das Potenzial, eine neue Generation von Unternehmensanwendungen voranzutreiben, die ein tiefes Verständnis und eine aufschlussreiche Analyse umfangreicher Materialien erfordern, darunter umfassende Unternehmensberichte, detaillierte Finanzberichte und komplexe rechtliche Vereinbarungen.
Das Hindernis der KI-Argumentation in Langform
Die jüngsten Fortschritte bei großen Schlussfolgerungsmodellen (LRMs), insbesondere durch verstärktes Lernen (RL), haben deren Problemlösungsfähigkeiten erheblich verbessert. Studien zeigen, dass RL-Feinabstimmung LRMs mit einer Form des „langsamen Denkens” ausstattet, die der menschlichen Kognition ähnelt und es ihnen ermöglicht, ausgefeilte Strategien für die Bewältigung komplexer Aufgaben zu entwickeln.
Diese Fortschritte beschränken sich jedoch weitgehend auf die Arbeit mit relativ kurzen Textpassagen, in der Regel etwa 4.000 Token. Eine erhebliche Hürde bleibt die Skalierung dieser Schlussfolgerungsfähigkeit auf weitaus längere Kontexte, beispielsweise 120.000 Token. Effektives Langzeit-Schlussfolgern erfordert ein solides Verständnis des gesamten Dokuments und die Fähigkeit zur mehrstufigen Analyse. „Diese Einschränkung behindert erheblich praktische Anwendungen, die externes Wissen erfordern, wie z. B. eingehende Recherchen, bei denen LRM Informationen aus datenreichen Quellen sammeln und verarbeiten müssen”, stellen die Entwickler von QwenLong-L1 in ihrer Forschungsarbeit fest.
Das Team fasst diese Hindernisse unter dem Begriff „Long-Context Reasoning RL“ zusammen. Im Gegensatz zum Kurzkontext-Schlussfolgern, das häufig das interne Wissen des Modells nutzt, erfordert dieser Ansatz, dass Modelle relevante Fakten in langen Eingaben genau finden und verankern. Nur dann können sie auf der Grundlage dieser abgerufenen Informationen logische Schlussfolgerungsketten aufbauen.
Das Training von Modellen für diesen Zweck mittels RL ist eine Herausforderung, die häufig zu ineffizientem Lernen und instabiler Optimierung führt. Modelle scheitern oft daran, zu effektiven Lösungen zu konvergieren, oder verlieren ihre Fähigkeit, verschiedene Argumentationswege zu erkunden.
QwenLong-L1: Ein strukturiertes, mehrstufiges Framework
QwenLong-L1 ist ein Framework für verstärktes Lernen, das entwickelt wurde, um LRMs dabei zu helfen, sich von der Verarbeitung kurzer Texte zu einer robusten Verallgemeinerung über lange Kontexte hinweg weiterzuentwickeln. Es verbessert bestehende LRMs für kurze Kontexte durch einen bewussten, schrittweisen Prozess:
Warm-up Supervised Fine-Tuning (SFT): Das Modell durchläuft zunächst ein SFT unter Verwendung von Beispielen für das Schlussfolgern in langen Kontexten. Diese Phase schafft eine solide Grundlage und lehrt das Modell, Informationen aus langen Dokumenten genau zu verankern und Kernkompetenzen im Kontextverständnis, in der Generierung logischer Ketten und in der Extraktion von Antworten zu entwickeln.
Curriculum-Guided Phased RL: Hier wird das Modell in mehreren Phasen trainiert, in denen die Länge der Zieldokumente schrittweise erhöht wird. Diese schrittweise, lehrplanbasierte Methode hilft dem Modell, seine Argumentationsstrategien stetig von kürzeren zu immer längeren Texten anzupassen, wodurch die Instabilität einer abrupten Konfrontation mit umfangreichen Dokumenten vermieden wird.
Schwierigkeitsbewusstes retrospektives Sampling: Die letzte Phase umfasst die anspruchsvollsten Beispiele aus früheren Trainingsphasen. Durch die Priorisierung schwieriger Fälle wird sichergestellt, dass das Modell weiterhin aus schwierigen Problemen lernt und dazu angeregt wird, vielfältigere und komplexere Schlussfolgerungswege zu erkunden.
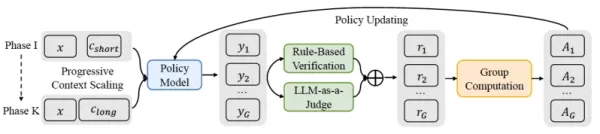
QwenLong-L1-Prozess Quelle: arXiv Über dieses strukturierte Training hinaus verwendet QwenLong-L1 ein spezielles Belohnungssystem. Während beim Training für Aufgaben mit kurzem Kontext oft strenge regelbasierte Belohnungen verwendet werden (z. B. für eine richtige mathematische Antwort), verwendet QwenLong-L1 einen hybriden Mechanismus. Er kombiniert die regelbasierte Überprüfung der Genauigkeit mit einem „LLM-as-a-judge”, das die semantische Bedeutung der generierten Antwort mit der Referenz vergleicht. Dies ermöglicht eine größere Flexibilität bei der Bewertung der vielfältigen Möglichkeiten, wie richtige Antworten in langen, nuancierten Dokumenten formuliert werden können.
Bewertung der Leistung von QwenLong-L1
Das Alibaba-Team testete QwenLong-L1 in erster Linie anhand von Dokumenten-Frage-Antworten (DocQA), einer Aufgabe, die für Unternehmensanforderungen von großer Relevanz ist, bei der KI dichte Dokumente entschlüsseln muss, um komplexe Fragen zu beantworten.
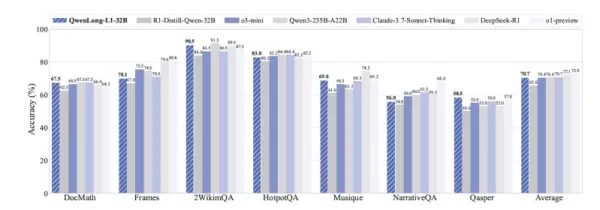
Die Ergebnisse aus sieben DocQA-Benchmarks mit langem Kontext zeigten die Stärke von QwenLong-L1. Das Modell QWENLONG-L1-32B (basierend auf DeepSeek-R1-Distill-Qwen-32B) erreichte eine Leistung, die mit Anthropics Claude-3.7 Sonnet Thinking vergleichbar ist, und übertraf Modelle wie OpenAIs o3-mini und Qwen3-235B-A22B. Das kleinere Modell QWENLONG-L1-14B übertraf ebenfalls Gemini 2.0 Flash Thinking von Google und Qwen3-32B.
Quelle: arXiv Eine wichtige Erkenntnis für den Einsatz in der Praxis ist, wie RL-Training spezialisierte Verhaltensweisen für das Denken in langen Kontexten fördert. Die Studie hebt hervor, dass mit QwenLong-L1 trainierte Modelle sich in den Bereichen „Grounding” (Verknüpfung von Antworten mit bestimmten Dokumentabschnitten), „Subgoal Setting” (Aufschlüsselung komplexer Fragen), „Backtracking” (Identifizierung und Korrektur von Fehlern während des Denkprozesses) und „Verification” (Überprüfung der Antworten) verbessern.
Während ein Basismodell beispielsweise durch irrelevante Details in einem Finanzbericht aus der Bahn geworfen werden oder sich endlos in tangentialen Analysen verlieren könnte, zeigte ein mit QwenLong-L1 trainiertes Modell eine effektive Selbstreflexion. Es konnte ablenkende Informationen herausfiltern, falsche Ansätze zurückverfolgen und erfolgreich zur richtigen Schlussfolgerung gelangen.
Frameworks wie QwenLong-L1 könnten den Nutzen von KI für Unternehmen erheblich erweitern. Mögliche Anwendungsbereiche reichen von der Rechtstechnologie (Analyse umfangreicher Rechtsdokumente) über den Finanzbereich (Durchführung einer gründlichen Due Diligence von Jahresberichten und Finanzunterlagen für Risiko- oder Investitionsanalysen) bis hin zum Kundenservice (Überprüfung langer Interaktionshistorien, um kontextbezogenere Unterstützung zu bieten). Die Forscher haben den Code für das QwenLong-L1-Framework und die Gewichte für die trainierten Modelle öffentlich zugänglich gemacht.
Verwandter Artikel
 DeepMind-CEO Hassabis: Ich schlafe sechs Stunden pro Tag und fühle mich normalerweise gegen 1 Uhr nachts energiegeladen.
Fortune hat kürzlich ein Interview mit Demis Hassabis, dem CEO von Google DeepMind, veröffentlicht, das seinen unkonventionellen Ansatz zu Erholung und Produktivität offenbart. Hassabis gab bekannt, dass er sehr wenig schläft und seine wachen Stunden
OpenAI und Anthropic kämpfen trotz Umsatzrückgängen um Marktanteile
Obwohl jüngste Berichte darauf hindeuten, dass OpenAI seine Umsatzziele verfehlt hat, was an diesem Dienstag Druck auf die Technologieaktien ausübte, zeigen sich private Investoren in KI-Labore weiter
Einhaltung der Vorschriften für autonome Fahrzeuge in Kalifornien: Eine neue Ära von Bußgeldern, Geofences und 1 Million Meilen
Guident betreibt einen AuveTech-Shuttle in Südflorida und verwaltet mithilfe seiner Fernüberwachungstechnologie eine vier Meilen lange Strecke in West Palm Beach sowie eine eine Meile lange Strecke in
Empfehlungen zu verwandten Spezialthemen
Schreiben
 KI-Tools zur Gliederung von Artikeln für das Verfassen langer Texte
2026: Die neuesten, besten und am besten bewerteten KI-Tools zur Erstellung von Gliederungen für lange Texte! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die präzise, strukturierte Gliederungen liefern – getestet unter realen Bedingungen –, um die Effizienz beim Schreiben deutlich zu steigern. XIX.AI gehört zu dieser Eliteauswahl. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen bei der Auswahl des perfekten Tools hilft. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
 9 Tools
 xix.ai
Chatbot
Die besten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprechflüssigkeit
2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
10 Tools
xix.ai
Musikkomposition
KI-Tools zur Stim-Trennung für die Remix-Produktion, die Vorbereitung von Samples und Karaoke-Master
Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai
Datenanalyse
KI-basierte SQL-Copiloten für Umsatz-Dashboards, Kanalanalysen sowie Produktmetriken
2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai
Musikkomposition
Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai
Chatbot
Die besten KI-gestützten Gesprächstrainingstools für Vorstellungsgesprächspraxis
2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

 Kommentare (1)
![AlbertHernández]()
Finally, an LLM that doesn't give up after page 50! 📚 As a legal analyst, reading 200-page contracts without losing context is a nightmare. This QwenLong-L1 framework could be a game-changer for enterprise workflows, though I'm still skeptical about the latency costs. Let's hope it's not just another hype cycle. 🤔
Die Alibaba Group hat QwenLong-L1 vorgestellt, ein neues Framework, das große Sprachmodelle (LLMs) in die Lage versetzt, außergewöhnlich lange Dokumente zu analysieren. Dieser Durchbruch hat das Potenzial, eine neue Generation von Unternehmensanwendungen voranzutreiben, die ein tiefes Verständnis und eine aufschlussreiche Analyse umfangreicher Materialien erfordern, darunter umfassende Unternehmensberichte, detaillierte Finanzberichte und komplexe rechtliche Vereinbarungen.
Das Hindernis der KI-Argumentation in Langform
Die jüngsten Fortschritte bei großen Schlussfolgerungsmodellen (LRMs), insbesondere durch verstärktes Lernen (RL), haben deren Problemlösungsfähigkeiten erheblich verbessert. Studien zeigen, dass RL-Feinabstimmung LRMs mit einer Form des „langsamen Denkens” ausstattet, die der menschlichen Kognition ähnelt und es ihnen ermöglicht, ausgefeilte Strategien für die Bewältigung komplexer Aufgaben zu entwickeln.
Diese Fortschritte beschränken sich jedoch weitgehend auf die Arbeit mit relativ kurzen Textpassagen, in der Regel etwa 4.000 Token. Eine erhebliche Hürde bleibt die Skalierung dieser Schlussfolgerungsfähigkeit auf weitaus längere Kontexte, beispielsweise 120.000 Token. Effektives Langzeit-Schlussfolgern erfordert ein solides Verständnis des gesamten Dokuments und die Fähigkeit zur mehrstufigen Analyse. „Diese Einschränkung behindert erheblich praktische Anwendungen, die externes Wissen erfordern, wie z. B. eingehende Recherchen, bei denen LRM Informationen aus datenreichen Quellen sammeln und verarbeiten müssen”, stellen die Entwickler von QwenLong-L1 in ihrer Forschungsarbeit fest.
Das Team fasst diese Hindernisse unter dem Begriff „Long-Context Reasoning RL“ zusammen. Im Gegensatz zum Kurzkontext-Schlussfolgern, das häufig das interne Wissen des Modells nutzt, erfordert dieser Ansatz, dass Modelle relevante Fakten in langen Eingaben genau finden und verankern. Nur dann können sie auf der Grundlage dieser abgerufenen Informationen logische Schlussfolgerungsketten aufbauen.
Das Training von Modellen für diesen Zweck mittels RL ist eine Herausforderung, die häufig zu ineffizientem Lernen und instabiler Optimierung führt. Modelle scheitern oft daran, zu effektiven Lösungen zu konvergieren, oder verlieren ihre Fähigkeit, verschiedene Argumentationswege zu erkunden.
QwenLong-L1: Ein strukturiertes, mehrstufiges Framework
QwenLong-L1 ist ein Framework für verstärktes Lernen, das entwickelt wurde, um LRMs dabei zu helfen, sich von der Verarbeitung kurzer Texte zu einer robusten Verallgemeinerung über lange Kontexte hinweg weiterzuentwickeln. Es verbessert bestehende LRMs für kurze Kontexte durch einen bewussten, schrittweisen Prozess:
Warm-up Supervised Fine-Tuning (SFT): Das Modell durchläuft zunächst ein SFT unter Verwendung von Beispielen für das Schlussfolgern in langen Kontexten. Diese Phase schafft eine solide Grundlage und lehrt das Modell, Informationen aus langen Dokumenten genau zu verankern und Kernkompetenzen im Kontextverständnis, in der Generierung logischer Ketten und in der Extraktion von Antworten zu entwickeln.
Curriculum-Guided Phased RL: Hier wird das Modell in mehreren Phasen trainiert, in denen die Länge der Zieldokumente schrittweise erhöht wird. Diese schrittweise, lehrplanbasierte Methode hilft dem Modell, seine Argumentationsstrategien stetig von kürzeren zu immer längeren Texten anzupassen, wodurch die Instabilität einer abrupten Konfrontation mit umfangreichen Dokumenten vermieden wird.
Schwierigkeitsbewusstes retrospektives Sampling: Die letzte Phase umfasst die anspruchsvollsten Beispiele aus früheren Trainingsphasen. Durch die Priorisierung schwieriger Fälle wird sichergestellt, dass das Modell weiterhin aus schwierigen Problemen lernt und dazu angeregt wird, vielfältigere und komplexere Schlussfolgerungswege zu erkunden.
Über dieses strukturierte Training hinaus verwendet QwenLong-L1 ein spezielles Belohnungssystem. Während beim Training für Aufgaben mit kurzem Kontext oft strenge regelbasierte Belohnungen verwendet werden (z. B. für eine richtige mathematische Antwort), verwendet QwenLong-L1 einen hybriden Mechanismus. Er kombiniert die regelbasierte Überprüfung der Genauigkeit mit einem „LLM-as-a-judge”, das die semantische Bedeutung der generierten Antwort mit der Referenz vergleicht. Dies ermöglicht eine größere Flexibilität bei der Bewertung der vielfältigen Möglichkeiten, wie richtige Antworten in langen, nuancierten Dokumenten formuliert werden können.
Bewertung der Leistung von QwenLong-L1
Das Alibaba-Team testete QwenLong-L1 in erster Linie anhand von Dokumenten-Frage-Antworten (DocQA), einer Aufgabe, die für Unternehmensanforderungen von großer Relevanz ist, bei der KI dichte Dokumente entschlüsseln muss, um komplexe Fragen zu beantworten.
Die Ergebnisse aus sieben DocQA-Benchmarks mit langem Kontext zeigten die Stärke von QwenLong-L1. Das Modell QWENLONG-L1-32B (basierend auf DeepSeek-R1-Distill-Qwen-32B) erreichte eine Leistung, die mit Anthropics Claude-3.7 Sonnet Thinking vergleichbar ist, und übertraf Modelle wie OpenAIs o3-mini und Qwen3-235B-A22B. Das kleinere Modell QWENLONG-L1-14B übertraf ebenfalls Gemini 2.0 Flash Thinking von Google und Qwen3-32B.
Eine wichtige Erkenntnis für den Einsatz in der Praxis ist, wie RL-Training spezialisierte Verhaltensweisen für das Denken in langen Kontexten fördert. Die Studie hebt hervor, dass mit QwenLong-L1 trainierte Modelle sich in den Bereichen „Grounding” (Verknüpfung von Antworten mit bestimmten Dokumentabschnitten), „Subgoal Setting” (Aufschlüsselung komplexer Fragen), „Backtracking” (Identifizierung und Korrektur von Fehlern während des Denkprozesses) und „Verification” (Überprüfung der Antworten) verbessern.
Während ein Basismodell beispielsweise durch irrelevante Details in einem Finanzbericht aus der Bahn geworfen werden oder sich endlos in tangentialen Analysen verlieren könnte, zeigte ein mit QwenLong-L1 trainiertes Modell eine effektive Selbstreflexion. Es konnte ablenkende Informationen herausfiltern, falsche Ansätze zurückverfolgen und erfolgreich zur richtigen Schlussfolgerung gelangen.
Frameworks wie QwenLong-L1 könnten den Nutzen von KI für Unternehmen erheblich erweitern. Mögliche Anwendungsbereiche reichen von der Rechtstechnologie (Analyse umfangreicher Rechtsdokumente) über den Finanzbereich (Durchführung einer gründlichen Due Diligence von Jahresberichten und Finanzunterlagen für Risiko- oder Investitionsanalysen) bis hin zum Kundenservice (Überprüfung langer Interaktionshistorien, um kontextbezogenere Unterstützung zu bieten). Die Forscher haben den Code für das QwenLong-L1-Framework und die Gewichte für die trainierten Modelle öffentlich zugänglich gemacht.








 DeepMind-CEO Hassabis: Ich schlafe sechs Stunden pro Tag und fühle mich normalerweise gegen 1 Uhr nachts energiegeladen.
Fortune hat kürzlich ein Interview mit Demis Hassabis, dem CEO von Google DeepMind, veröffentlicht, das seinen unkonventionellen Ansatz zu Erholung und Produktivität offenbart. Hassabis gab bekannt, dass er sehr wenig schläft und seine wachen Stunden
 OpenAI und Anthropic kämpfen trotz Umsatzrückgängen um Marktanteile
Obwohl jüngste Berichte darauf hindeuten, dass OpenAI seine Umsatzziele verfehlt hat, was an diesem Dienstag Druck auf die Technologieaktien ausübte, zeigen sich private Investoren in KI-Labore weiter
Einhaltung der Vorschriften für autonome Fahrzeuge in Kalifornien: Eine neue Ära von Bußgeldern, Geofences und 1 Million Meilen
Guident betreibt einen AuveTech-Shuttle in Südflorida und verwaltet mithilfe seiner Fernüberwachungstechnologie eine vier Meilen lange Strecke in West Palm Beach sowie eine eine Meile lange Strecke in

2026: Die neuesten, besten und am besten bewerteten KI-Tools zur Erstellung von Gliederungen für lange Texte! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die präzise, strukturierte Gliederungen liefern – getestet unter realen Bedingungen –, um die Effizienz beim Schreiben deutlich zu steigern. XIX.AI gehört zu dieser Eliteauswahl. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen bei der Auswahl des perfekten Tools hilft. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
9 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

Finally, an LLM that doesn't give up after page 50! 📚 As a legal analyst, reading 200-page contracts without losing context is a nightmare. This QwenLong-L1 framework could be a game-changer for enterprise workflows, though I'm still skeptical about the latency costs. Let's hope it's not just another hype cycle. 🤔












