


 Lar
Modelo mundial de inteligência incorporada em nível de evento, inédito no mundo, põe fim ao aprendizado quadro a quadro para robôs
Em 29 de maio, a equipe da Variable Robot apresentou o WALL-WM, o primeiro modelo de mundo com inteligência incorporada do mundo baseado em “previsão em nível de evento”. Esse modelo rompe com os grandes modelos incorporados convencionais, que aprendem ações quadro a quadro ao longo do tempo, mudando, em vez disso, a unidade de previsão do modelo do mundo para eventos semânticos. Isso marca uma nova etapa na forma como os robôs compreendem e executam tarefas.
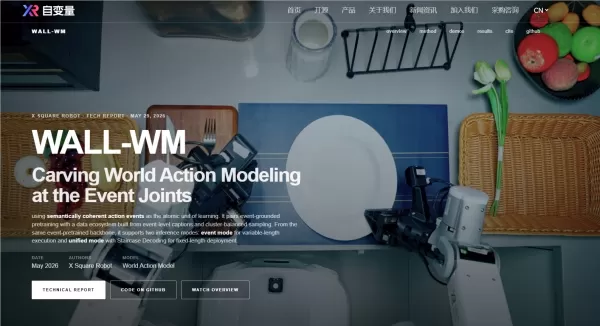
Na indústria atual de inteligência incorporada, os modelos convencionais de visão-linguagem-ação (VLA) normalmente utilizam uma imagem atual e uma instrução para prever um bloco de ação de duração fixa. Essa abordagem de treinamento quadro a quadro frequentemente faz com que os robôs se concentrem em movimentos físicos menores, perdendo de vista o objetivo final da ação. Quando confrontados com cenários como a troca de copos ou mesas, os robôs frequentemente falham devido à falta de generalização. Para resolver esse ponto fraco do setor, a equipe da Variable destacou em seu artigo acadêmico que as informações de texto, visão e ação existem naturalmente em diferentes escalas de tempo e geometrias múltiplas no mundo real. Forçá-las a um único espaço compartilhado pode facilmente prejudicar o prior geométrico pré-treinado.
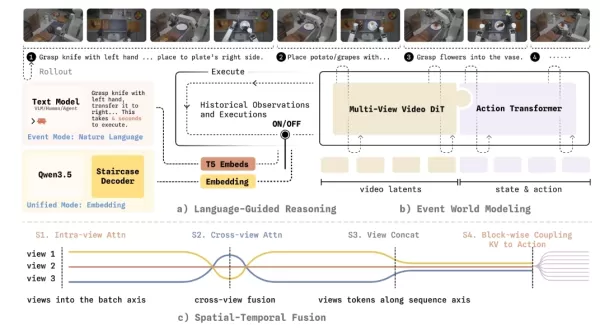
Para enfrentar esse desafio, o modelo de mundo WALL-WM introduz um mecanismo inovador de treinamento e execução centrado em eventos. Ele divide tarefas complexas em junções de eventos semanticamente claras, como alcançar, agarrar e mover. Em operação, o modelo não calcula mais rigidamente o próximo quadro de imagem. Em vez disso, ele primeiro simula como o mundo mudará devido ao próximo evento e, em seguida, traduz com precisão essa mudança visual na trajetória de movimento do braço robótico.
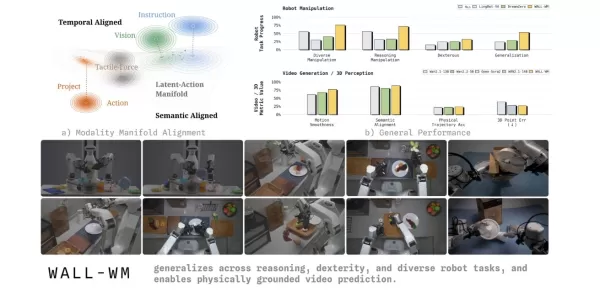
Para garantir que essa nova arquitetura possa ser implantada de forma confiável no mundo físico, a equipe do Variable Robot realizou uma série de reformulações de engenharia de ponta. O sistema suporta a alternância flexível entre o “modo de evento” (com saída de ação de comprimento variável) e o “modo unificado” (com controle de malha fechada em tempo real) nos mesmos pesos de base. Ele também alcança um acoplamento unidirecional entre modelos de vídeo e modelos de ação, evitando que valiosas informações dinâmicas prévias de vídeos da internet sejam prematuramente influenciadas pelos dados de ação. Para a percepção geométrica entre múltiplas câmeras, o modelo introduz máscaras de frustum e máscaras tubulares, forçando a IA a desenvolver uma correspondência geométrica tridimensional verdadeira entre as visões. Para lidar com a latência de decisão, ele emprega uma nova técnica de “decodificação em cadeia de pensamento escalonada” que reduz significativamente o atraso na decodificação, mantendo a interpretabilidade lógica.
Artigo relacionado
 Dentro dos Detalhes Revelados Sobre o Gemini de Próxima Geração: Poder de Cálculo Sobrecarregado, Equipes Internas Discordaram Sobre Prioridades de Desenvolvimento e Alocação de Recursos
Os relatórios indicam que o lançamento do tão aguardado modelo Gemini de próxima geração do Google foi adiado. Desentendimentos internos sobre prioridades de desenvolvimento e alocação de recursos, combinados com capacidade computacional limitada e p
A OpenAI descarta preocupações com a desaceleração do crescimento e afirma que múltiplas unidades de negócio estão acelerando.
Em resposta à escrutínio externo sobre o desaceleramento do crescimento das vendas e o não cumprimento de metas internas, o líder em inteligência artificial, OpenAI, emitiu uma declaração confiante na terça-feira, 28 de abril. A empresa esclareceu qu
Alibaba Super Cup: Qwen3.8-Max estreia com aprimoramento nas ferramentas de programação e escritório
A Alibaba revelou oficialmente o Qwen3.8-Max, um modelo de base de próxima geração com 2,4 trilhão de parâmetros. Este avanço significativo em IA oferece ganhos substanciais de desempenho em áreas principais, como programação e tarefas profissionais
Recomendações de tópicos especiais relacionados
Composição musical
 Melhores Ferramentas de IA para Criação de Melodias para Rascunhos de Músicas
2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
 8 ferramentas
 xix.ai
chatbot
Melhores ferramentas de treinamento de conversação com IA para prática de entrevistas
As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai
Design e Arte
As melhores ferramentas de transferência de estilo com IA para experimentos criativos
As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai
Criação de quadrinhos
As melhores ferramentas de balões de diálogo com IA para a narrativa visual
As melhores e mais bem avaliadas ferramentas de balões de diálogo com IA para narrativa visual de 2026 já estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que ajudam os criadores a aumentar a produtividade e superar gargalos criativos. Veja uma comparação entre versões gratuitas e pagas, confira testes reais e verifique os rankings mais recentes para encontrar as soluções imperdíveis, perfeitas para criar narrativas visuais envolventes. Explore agora e descubra sua ferramenta ideal!
10 ferramentas
xix.ai
Assistente de Reunião
As melhores ferramentas de resumo de reuniões com IA: acompanhe decisões e ações de acompanhamento com clareza
As melhores e mais bem avaliadas ferramentas de resumo de reuniões com IA de 2026 para um acompanhamento claro das decisões e acompanhamentos sem esforço. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam drasticamente a produtividade ao automatizar notas de reuniões, identificar ações-chave e otimizar a coordenação da equipe em todos os projetos. Veja uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente para ajudá-lo a encontrar a ferramenta perfeita. Explore agora para aproveitar ao máximo as vantagens da IA!
9 ferramentas
xix.ai
Análise de dados
Melhores ferramentas de limpeza de dados com IA: corrija valores faltantes e duplicatas rapidamente
2026 – Os melhores e mais bem avaliados ferramentas de limpeza de dados com IA, atualizadas para corrigir rapidamente valores faltantes e duplicatas. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam significativamente a produtividade. Cada opção passou por testes rigorosos em condições reais para garantir sua confiabilidade. Acesse uma comparação gratuita entre as versões pagas e gratuitas e descubra a ferramenta indispensável que melhor atende às suas necessidades. Explore agora em XIX.AI para aproveitar todos os benefícios oferecidos pela IA.
11 ferramentas
xix.ai

 Comentários (1)
![JasonHarris]()
Finally, a model that doesn't just process frames like a slow-motion video player! 🤖 This event-level prediction sounds way more efficient for real-time robot actions. I've been waiting for something that breaks free from the traditional frame-by-frame bottleneck. Can't wait to see how WALL-WM handles unpredictable environments. #AI #Robotics
Em 29 de maio, a equipe da Variable Robot apresentou o WALL-WM, o primeiro modelo de mundo com inteligência incorporada do mundo baseado em “previsão em nível de evento”. Esse modelo rompe com os grandes modelos incorporados convencionais, que aprendem ações quadro a quadro ao longo do tempo, mudando, em vez disso, a unidade de previsão do modelo do mundo para eventos semânticos. Isso marca uma nova etapa na forma como os robôs compreendem e executam tarefas.
Na indústria atual de inteligência incorporada, os modelos convencionais de visão-linguagem-ação (VLA) normalmente utilizam uma imagem atual e uma instrução para prever um bloco de ação de duração fixa. Essa abordagem de treinamento quadro a quadro frequentemente faz com que os robôs se concentrem em movimentos físicos menores, perdendo de vista o objetivo final da ação. Quando confrontados com cenários como a troca de copos ou mesas, os robôs frequentemente falham devido à falta de generalização. Para resolver esse ponto fraco do setor, a equipe da Variable destacou em seu artigo acadêmico que as informações de texto, visão e ação existem naturalmente em diferentes escalas de tempo e geometrias múltiplas no mundo real. Forçá-las a um único espaço compartilhado pode facilmente prejudicar o prior geométrico pré-treinado.
Para enfrentar esse desafio, o modelo de mundo WALL-WM introduz um mecanismo inovador de treinamento e execução centrado em eventos. Ele divide tarefas complexas em junções de eventos semanticamente claras, como alcançar, agarrar e mover. Em operação, o modelo não calcula mais rigidamente o próximo quadro de imagem. Em vez disso, ele primeiro simula como o mundo mudará devido ao próximo evento e, em seguida, traduz com precisão essa mudança visual na trajetória de movimento do braço robótico.
Para garantir que essa nova arquitetura possa ser implantada de forma confiável no mundo físico, a equipe do Variable Robot realizou uma série de reformulações de engenharia de ponta. O sistema suporta a alternância flexível entre o “modo de evento” (com saída de ação de comprimento variável) e o “modo unificado” (com controle de malha fechada em tempo real) nos mesmos pesos de base. Ele também alcança um acoplamento unidirecional entre modelos de vídeo e modelos de ação, evitando que valiosas informações dinâmicas prévias de vídeos da internet sejam prematuramente influenciadas pelos dados de ação. Para a percepção geométrica entre múltiplas câmeras, o modelo introduz máscaras de frustum e máscaras tubulares, forçando a IA a desenvolver uma correspondência geométrica tridimensional verdadeira entre as visões. Para lidar com a latência de decisão, ele emprega uma nova técnica de “decodificação em cadeia de pensamento escalonada” que reduz significativamente o atraso na decodificação, mantendo a interpretabilidade lógica.








 Dentro dos Detalhes Revelados Sobre o Gemini de Próxima Geração: Poder de Cálculo Sobrecarregado, Equipes Internas Discordaram Sobre Prioridades de Desenvolvimento e Alocação de Recursos
Os relatórios indicam que o lançamento do tão aguardado modelo Gemini de próxima geração do Google foi adiado. Desentendimentos internos sobre prioridades de desenvolvimento e alocação de recursos, combinados com capacidade computacional limitada e p
 A OpenAI descarta preocupações com a desaceleração do crescimento e afirma que múltiplas unidades de negócio estão acelerando.
Em resposta à escrutínio externo sobre o desaceleramento do crescimento das vendas e o não cumprimento de metas internas, o líder em inteligência artificial, OpenAI, emitiu uma declaração confiante na terça-feira, 28 de abril. A empresa esclareceu qu
 Alibaba Super Cup: Qwen3.8-Max estreia com aprimoramento nas ferramentas de programação e escritório
A Alibaba revelou oficialmente o Qwen3.8-Max, um modelo de base de próxima geração com 2,4 trilhão de parâmetros. Este avanço significativo em IA oferece ganhos substanciais de desempenho em áreas principais, como programação e tarefas profissionais

2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai

As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de balões de diálogo com IA para narrativa visual de 2026 já estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que ajudam os criadores a aumentar a produtividade e superar gargalos criativos. Veja uma comparação entre versões gratuitas e pagas, confira testes reais e verifique os rankings mais recentes para encontrar as soluções imperdíveis, perfeitas para criar narrativas visuais envolventes. Explore agora e descubra sua ferramenta ideal!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de resumo de reuniões com IA de 2026 para um acompanhamento claro das decisões e acompanhamentos sem esforço. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam drasticamente a produtividade ao automatizar notas de reuniões, identificar ações-chave e otimizar a coordenação da equipe em todos os projetos. Veja uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente para ajudá-lo a encontrar a ferramenta perfeita. Explore agora para aproveitar ao máximo as vantagens da IA!
9 ferramentas
xix.ai

2026 – Os melhores e mais bem avaliados ferramentas de limpeza de dados com IA, atualizadas para corrigir rapidamente valores faltantes e duplicatas. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam significativamente a produtividade. Cada opção passou por testes rigorosos em condições reais para garantir sua confiabilidade. Acesse uma comparação gratuita entre as versões pagas e gratuitas e descubra a ferramenta indispensável que melhor atende às suas necessidades. Explore agora em XIX.AI para aproveitar todos os benefícios oferecidos pela IA.
11 ferramentas
xix.ai

Finally, a model that doesn't just process frames like a slow-motion video player! 🤖 This event-level prediction sounds way more efficient for real-time robot actions. I've been waiting for something that breaks free from the traditional frame-by-frame bottleneck. Can't wait to see how WALL-WM handles unpredictable environments. #AI #Robotics












