


 Hogar
El primer modelo mundial de inteligencia incorporada a nivel de eventos pone fin al aprendizaje fotograma a fotograma para los robots
El 29 de mayo, el equipo de Variable Robot presentó WALL-WM, el primer modelo del mundo de inteligencia incorporada basado en la «predicción a nivel de eventos». Este modelo se aleja de los grandes modelos de inteligencia incorporada convencionales, que aprenden acciones fotograma a fotograma a lo largo del tiempo, y cambia la unidad de predicción del modelo del mundo a eventos semánticos. Esto marca una nueva etapa en la forma en que los robots comprenden y llevan a cabo tareas.
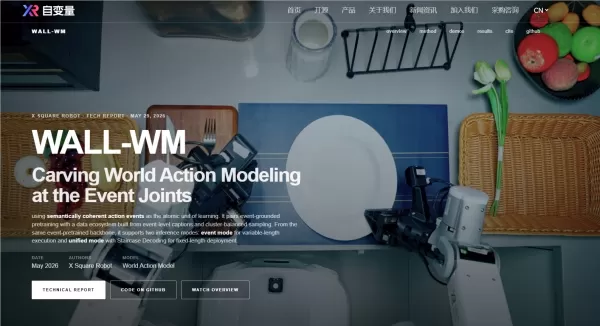
En la industria actual de la inteligencia incorporada, los modelos dominantes de visión-lenguaje-acción (VLA) suelen tomar una imagen y una instrucción actuales para predecir un bloque de acción de longitud fija. Este enfoque de entrenamiento fotograma a fotograma a menudo hace que los robots se centren en movimientos físicos menores, perdiendo de vista el objetivo final de la acción. Cuando se enfrentan a situaciones como el cambio de tazas o mesas, los robots suelen fallar debido a la falta de generalización. Para abordar este punto débil del sector, el equipo de Variable señaló en su artículo académico que la información de texto, visión y acción existe de forma natural en diferentes escalas temporales y geometrías múltiples en el mundo real. Forzarlas a un único espacio compartido puede dañar fácilmente el prior geométrico preentrenado.
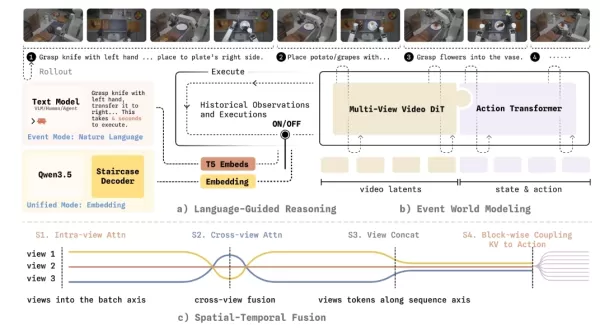
Para hacer frente a este reto, el modelo de mundo WALL-WM introduce un innovador mecanismo de entrenamiento y ejecución centrado en eventos. Desglosa tareas complejas en eventos semánticamente claros, como alcanzar, agarrar y mover. En funcionamiento, el modelo ya no calcula de forma rígida el siguiente fotograma de la imagen. En su lugar, primero simula cómo cambiará el mundo debido al siguiente evento y, a continuación, traduce con precisión ese cambio visual en la trayectoria de movimiento del brazo robótico.
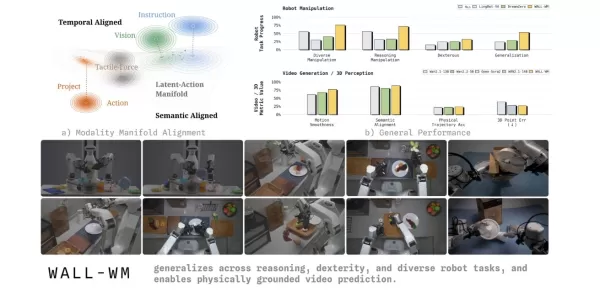
Para garantizar que esta nueva arquitectura pueda implementarse de forma fiable en el mundo físico, el equipo de Variable Robot llevó a cabo una serie de revisiones de ingeniería exhaustivas. El sistema admite el cambio flexible entre el «modo de eventos» (con salida de acciones de longitud variable) y el «modo unificado» (con control de bucle cerrado en tiempo real) sobre los mismos pesos base. También logra un acoplamiento unidireccional entre los modelos de vídeo y los modelos de acción, lo que evita que los valiosos datos dinámicos previos de los vídeos de Internet se vean sesgados prematuramente por los datos de acción. Para la percepción geométrica a través de múltiples cámaras, el modelo introduce máscaras de frustum y máscaras tubulares, lo que obliga a la IA a desarrollar una correspondencia geométrica tridimensional verdadera entre vistas. Para abordar la latencia en la toma de decisiones, emplea una nueva técnica de «decodificación por cadena de pensamiento escalonada» que reduce significativamente el retraso en la decodificación al tiempo que mantiene la interpretabilidad lógica.
Artículo relacionado
 Las gafas inteligentes de Apple podrían debutar en la WWDC27, destacando la protección de la privacidad
El informe de Mark Gurman de Bloomberg indica que las gafas inteligentes de Apple, con el nombre en código N50, están previstas para su presentación en la WWDC27 de junio de 2027, con un lanzamiento al público previsto para el otoño de 2027. Original
Dentro de los detalles revelados sobre el Gemini de próxima generación: Potencia de cálculo limitada, los equipos internos discreparon sobre las prioridades de desarrollo y la asignación de recursos
Los informes indican que el lanzamiento del tan esperado modelo Gemini de próxima generación de Google ha sido pospuesto. Los desacuerdos internos sobre las prioridades de desarrollo y la asignación de recursos, combinados con una capacidad de comput
OpenAI descarta preocupaciones por la desaceleración del crecimiento y afirma que múltiples unidades de negocio están acelerando
En respuesta a la escrutinio externo sobre el desaceleramiento del crecimiento de las ventas y el incumplimiento de las metas internas, el líder en inteligencia artificial, OpenAI, emitió una declaración contundente el martes 28 de abril. La empresa
Recomendaciones de temas especiales relacionados
Análisis de datos
 Copilotos de AI para SQL destinados a paneles de ingresos, análisis de embudos y métricas de productos
¡Los mejores copilotos de SQL basados en IA de 2026, clasificados entre los más destacados! XIX.AI reúne una poderosa colección que evoluciona constantemente, con pruebas en el mundo real actualizadas semanalmente. Estas herramientas indispensables le permiten generar paneles de control de ingresos precisos, analizar los canales de venta y seguir de cerca las métricas de los productos de manera rápida, lo que aumenta significativamente su productividad. ¡Explórelas ahora para encontrar la herramienta perfecta para tomar decisiones basadas en datos! 238 caracteres
 9 herramientas
 xix.ai
composicion musical
Mejores herramientas de IA para escribir melodías en borradores de canciones
2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
8 herramientas
xix.ai
chatbot
Mejores herramientas de entrenamiento de conversación con IA para practicar entrevistas
¡Las mejores herramientas de entrenamiento de conversación con IA para prácticas de entrevistas más recientes y mejor valoradas de 2026 ya están disponibles en XIX.AI! Esta colección seleccionada incluye herramientas poderosas y transformadoras que han pasado por rigurosas pruebas en el mundo real para ofrecer retroalimentación precisa. Encontrarás una comparación entre opciones gratuitas y de pago, así como clasificaciones detalladas para ayudarte a elegir la opción imprescindible que aumente tu confianza y habilidades. ¡Explora ahora para descubrir tu herramienta perfecta para el éxito en las entrevistas!
12 herramientas
xix.ai
Diseño y Arte
Las mejores herramientas de transferencia de estilos con IA para experimentos creativos
¡Las mejores herramientas de transferencia de estilo con IA de 2026, mejor valoradas para experimentos creativos! XIX.AI ha seleccionado una colección de herramientas potentes y revolucionarias que no te puedes perder, capaces de ofrecer resultados excepcionales según pruebas reales y clasificaciones rigurosas. Estas soluciones de primera categoría ayudan a los creativos a aumentar significativamente su productividad, acelerando la creación de contenidos y abriendo un sinfín de posibilidades creativas. ¡Explora ahora mismo para descubrir tu herramienta perfecta y empieza a crear hoy mismo!
9 herramientas
xix.ai
Creación de cómics
Las mejores herramientas de burbujas de diálogo con IA para la narración visual
¡Ya están aquí, en XIX.AI, las mejores herramientas de 2026 con las mejores valoraciones para crear bocadillos de diálogo con IA y contar historias visuales! Esta selección incluye potentes herramientas revolucionarias que ayudan a los creadores a aumentar su productividad y superar los bloqueos creativos. Consulta una comparación entre las versiones gratuitas y de pago, echa un vistazo a las pruebas en condiciones reales y revisa las últimas clasificaciones para encontrar las soluciones imprescindibles, perfectas para crear narrativas visuales cautivadoras. ¡Explora ahora mismo y descubre tu herramienta ideal!
10 herramientas
xix.ai
Asistente de reuniones
Las mejores herramientas de resumen de reuniones con IA: realiza un seguimiento claro de las decisiones y las acciones de seguimiento
Las mejores herramientas de resumen de reuniones con IA de 2026, mejor valoradas para un seguimiento claro de las decisiones y un seguimiento posterior sin esfuerzo. Esta lista seleccionada presenta soluciones potentes y revolucionarias que aumentan drásticamente la productividad al automatizar las notas de las reuniones, identificar las acciones clave y agilizar la coordinación del equipo en todos los proyectos. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones actualizadas semanalmente, para ayudarte a encontrar la herramienta perfecta. ¡Explora ahora mismo y aprovecha las ventajas de la IA!
9 herramientas
xix.ai

 comentario (1)
0/500
![JasonHarris]()
Finally, a model that doesn't just process frames like a slow-motion video player! 🤖 This event-level prediction sounds way more efficient for real-time robot actions. I've been waiting for something that breaks free from the traditional frame-by-frame bottleneck. Can't wait to see how WALL-WM handles unpredictable environments. #AI #Robotics
El 29 de mayo, el equipo de Variable Robot presentó WALL-WM, el primer modelo del mundo de inteligencia incorporada basado en la «predicción a nivel de eventos». Este modelo se aleja de los grandes modelos de inteligencia incorporada convencionales, que aprenden acciones fotograma a fotograma a lo largo del tiempo, y cambia la unidad de predicción del modelo del mundo a eventos semánticos. Esto marca una nueva etapa en la forma en que los robots comprenden y llevan a cabo tareas.
En la industria actual de la inteligencia incorporada, los modelos dominantes de visión-lenguaje-acción (VLA) suelen tomar una imagen y una instrucción actuales para predecir un bloque de acción de longitud fija. Este enfoque de entrenamiento fotograma a fotograma a menudo hace que los robots se centren en movimientos físicos menores, perdiendo de vista el objetivo final de la acción. Cuando se enfrentan a situaciones como el cambio de tazas o mesas, los robots suelen fallar debido a la falta de generalización. Para abordar este punto débil del sector, el equipo de Variable señaló en su artículo académico que la información de texto, visión y acción existe de forma natural en diferentes escalas temporales y geometrías múltiples en el mundo real. Forzarlas a un único espacio compartido puede dañar fácilmente el prior geométrico preentrenado.
Para hacer frente a este reto, el modelo de mundo WALL-WM introduce un innovador mecanismo de entrenamiento y ejecución centrado en eventos. Desglosa tareas complejas en eventos semánticamente claros, como alcanzar, agarrar y mover. En funcionamiento, el modelo ya no calcula de forma rígida el siguiente fotograma de la imagen. En su lugar, primero simula cómo cambiará el mundo debido al siguiente evento y, a continuación, traduce con precisión ese cambio visual en la trayectoria de movimiento del brazo robótico.
Para garantizar que esta nueva arquitectura pueda implementarse de forma fiable en el mundo físico, el equipo de Variable Robot llevó a cabo una serie de revisiones de ingeniería exhaustivas. El sistema admite el cambio flexible entre el «modo de eventos» (con salida de acciones de longitud variable) y el «modo unificado» (con control de bucle cerrado en tiempo real) sobre los mismos pesos base. También logra un acoplamiento unidireccional entre los modelos de vídeo y los modelos de acción, lo que evita que los valiosos datos dinámicos previos de los vídeos de Internet se vean sesgados prematuramente por los datos de acción. Para la percepción geométrica a través de múltiples cámaras, el modelo introduce máscaras de frustum y máscaras tubulares, lo que obliga a la IA a desarrollar una correspondencia geométrica tridimensional verdadera entre vistas. Para abordar la latencia en la toma de decisiones, emplea una nueva técnica de «decodificación por cadena de pensamiento escalonada» que reduce significativamente el retraso en la decodificación al tiempo que mantiene la interpretabilidad lógica.








 Las gafas inteligentes de Apple podrían debutar en la WWDC27, destacando la protección de la privacidad
El informe de Mark Gurman de Bloomberg indica que las gafas inteligentes de Apple, con el nombre en código N50, están previstas para su presentación en la WWDC27 de junio de 2027, con un lanzamiento al público previsto para el otoño de 2027. Original
 Dentro de los detalles revelados sobre el Gemini de próxima generación: Potencia de cálculo limitada, los equipos internos discreparon sobre las prioridades de desarrollo y la asignación de recursos
Los informes indican que el lanzamiento del tan esperado modelo Gemini de próxima generación de Google ha sido pospuesto. Los desacuerdos internos sobre las prioridades de desarrollo y la asignación de recursos, combinados con una capacidad de comput
 OpenAI descarta preocupaciones por la desaceleración del crecimiento y afirma que múltiples unidades de negocio están acelerando
En respuesta a la escrutinio externo sobre el desaceleramiento del crecimiento de las ventas y el incumplimiento de las metas internas, el líder en inteligencia artificial, OpenAI, emitió una declaración contundente el martes 28 de abril. La empresa

¡Los mejores copilotos de SQL basados en IA de 2026, clasificados entre los más destacados! XIX.AI reúne una poderosa colección que evoluciona constantemente, con pruebas en el mundo real actualizadas semanalmente. Estas herramientas indispensables le permiten generar paneles de control de ingresos precisos, analizar los canales de venta y seguir de cerca las métricas de los productos de manera rápida, lo que aumenta significativamente su productividad. ¡Explórelas ahora para encontrar la herramienta perfecta para tomar decisiones basadas en datos! 238 caracteres
9 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
8 herramientas
xix.ai

¡Las mejores herramientas de entrenamiento de conversación con IA para prácticas de entrevistas más recientes y mejor valoradas de 2026 ya están disponibles en XIX.AI! Esta colección seleccionada incluye herramientas poderosas y transformadoras que han pasado por rigurosas pruebas en el mundo real para ofrecer retroalimentación precisa. Encontrarás una comparación entre opciones gratuitas y de pago, así como clasificaciones detalladas para ayudarte a elegir la opción imprescindible que aumente tu confianza y habilidades. ¡Explora ahora para descubrir tu herramienta perfecta para el éxito en las entrevistas!
12 herramientas
xix.ai

¡Las mejores herramientas de transferencia de estilo con IA de 2026, mejor valoradas para experimentos creativos! XIX.AI ha seleccionado una colección de herramientas potentes y revolucionarias que no te puedes perder, capaces de ofrecer resultados excepcionales según pruebas reales y clasificaciones rigurosas. Estas soluciones de primera categoría ayudan a los creativos a aumentar significativamente su productividad, acelerando la creación de contenidos y abriendo un sinfín de posibilidades creativas. ¡Explora ahora mismo para descubrir tu herramienta perfecta y empieza a crear hoy mismo!
9 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, las mejores herramientas de 2026 con las mejores valoraciones para crear bocadillos de diálogo con IA y contar historias visuales! Esta selección incluye potentes herramientas revolucionarias que ayudan a los creadores a aumentar su productividad y superar los bloqueos creativos. Consulta una comparación entre las versiones gratuitas y de pago, echa un vistazo a las pruebas en condiciones reales y revisa las últimas clasificaciones para encontrar las soluciones imprescindibles, perfectas para crear narrativas visuales cautivadoras. ¡Explora ahora mismo y descubre tu herramienta ideal!
10 herramientas
xix.ai

Las mejores herramientas de resumen de reuniones con IA de 2026, mejor valoradas para un seguimiento claro de las decisiones y un seguimiento posterior sin esfuerzo. Esta lista seleccionada presenta soluciones potentes y revolucionarias que aumentan drásticamente la productividad al automatizar las notas de las reuniones, identificar las acciones clave y agilizar la coordinación del equipo en todos los proyectos. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones actualizadas semanalmente, para ayudarte a encontrar la herramienta perfecta. ¡Explora ahora mismo y aprovecha las ventajas de la IA!
9 herramientas
xix.ai

Finally, a model that doesn't just process frames like a slow-motion video player! 🤖 This event-level prediction sounds way more efficient for real-time robot actions. I've been waiting for something that breaks free from the traditional frame-by-frame bottleneck. Can't wait to see how WALL-WM handles unpredictable environments. #AI #Robotics












