


 Maison
Google TurboQuant réduit de 6 fois la taille du cache des modèles de langage à grande échelle (LLM), multiplie leur vitesse par 8, sans nécessiter d'entraînement et sans aucune perte de précision
Le 26 mars, Google Research a annoncé le lancement de TurboQuant, un nouvel algorithme de compression par quantification vectorielle qui combine les technologies PolarQuant et QJL. Cette innovation réduit d’au moins six fois les besoins en mémoire du cache clé-valeur (KV Cache) lors de l’inférence des grands modèles linguistiques (LLM). Sur les GPU Nvidia H100, elle multiplie par huit la vitesse de calcul de l’attention tout en conservant une précision parfaite dans plusieurs benchmarks à contexte long. Cette avancée devrait réduire les coûts de déploiement de l’IA et accélérer l’adoption d’applications à contexte long.
Problèmes liés au cache KV : surcharge mémoire liée aux vecteurs de haute dimension
Lors du traitement de longues séquences, les LLM doivent maintenir un cache de vecteurs de clés et de valeurs. Ces vecteurs de haute dimension permettent des calculs rapides du mécanisme d’attention sans calculs redondants. Cependant, à mesure que la longueur du contexte augmente, la consommation de mémoire du cache KV croît de manière exponentielle, devenant ainsi un goulot d’étranglement majeur qui limite l’efficacité de l’inférence du modèle et l’échelle de déploiement.
Si les méthodes traditionnelles de quantification vectorielle permettent de compresser les données, elles nécessitent un espace de stockage supplémentaire pour les constantes de quantification, telles que les facteurs d’échelle et les points zéro. Ces constantes sont généralement stockées en pleine précision, ce qui ajoute 1 à 2 bits supplémentaires par valeur et annule en partie les avantages de la compression.
Innovation centrale de TurboQuant : compression en deux phases avec PolarQuant + QJL
TurboQuant adopte un cadre de compression en deux phases ne nécessitant aucun apprentissage, qui résout efficacement la surcharge liée à la quantification traditionnelle :
PolarQuant (compression en coordonnées polaires) :
Tout d’abord, les vecteurs sont pivotés de manière aléatoire, puis les coordonnées cartésiennes (X/Y/Z, etc.) sont converties en coordonnées polaires (angle + rayon). Les angles se situant dans une plage fixe et prévisible, cette méthode élimine la surcharge de stockage liée à la normalisation des limites dans la quantification traditionnelle, permettant ainsi une compression plus efficace.
QJL (correction d’erreur sur 1 bit, Johnson-Lindenstrauss quantifié) :
Après la compression PolarQuant, des erreurs résiduelles subsistent. QJL utilise la transformée de Johnson-Lindenstrauss pour réduire la dimensionnalité, puis quantifie à l’aide d’un schéma minimal à 1 bit (signe +1/-1). En employant un estimateur non biaisé spécial, il permet de corriger les erreurs lors du calcul du score d’attention sans surcoût de mémoire supplémentaire, garantissant ainsi que le processus global reste non biaisé.
Combiné à ces techniques, TurboQuant compresse le cache KV à environ 3 bits par valeur tout en conservant l’absence de biais et une grande précision dans l’estimation du produit scalaire.
Performances aux tests de référence : leadership global, idéal pour les contextes longs
L’équipe de Google a mené une validation approfondie sur des modèles open source tels que Gemma et Mistral :
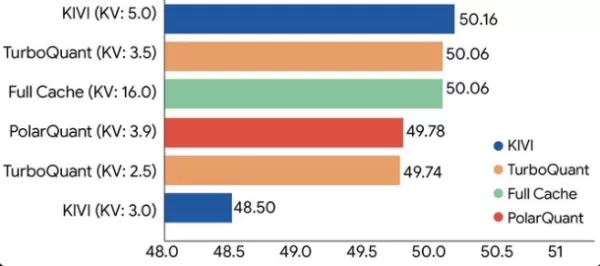
LongBench (couvrant des tâches telles que les questions-réponses sur de longs textes, la génération de code et la synthèse) : TurboQuant égale ou surpasse les références existantes telles que KIVI, démontrant ainsi une supériorité globale.« Needle In A Haystack » et autres tâches de recherche : il atteint des scores en aval parfaits tout en compressant la mémoire KV d’au moins six fois. Résultats des tests sur Nvidia H100 : avec une configuration à 4 bits, la vitesse de calcul des logits d’attention est multipliée par huit au maximum.De plus, sur des ensembles de données vectorielles comme GloVe, le taux de rappel de TurboQuant surpasse celui des méthodes traditionnelles telles que PQ et RabbiQ.
Commentaire d’AIbase : TurboQuant ne nécessite ni réentraînement ni réglage fin du modèle et peut être directement appliqué aux grands modèles de langage (LLM) existants. Il convient à tout scénario reposant sur la quantification vectorielle, y compris la recherche dans les bases de données, les systèmes de recommandation et les moteurs de recherche vectoriels. Cela permet non seulement à un simple GPU grand public de prendre en charge des contextes plus longs (par exemple, des dizaines de milliers de tokens), mais abaisse également considérablement le seuil matériel requis pour les services d’IA de niveau entreprise.
Importance pour le secteur : une nouvelle référence en matière d’efficacité de l’inférence IA
Avec l’explosion des applications à contexte long et multimodales, la mémoire cache KV est devenue une contrainte majeure dans l’infrastructure d’IA. Le cadre de quantification « quasi-optimal et indépendant des données » de TurboQuant ouvre une nouvelle voie vers une inférence efficace. Google Research a indiqué que cette technologie a été détaillée dans des articles présentés lors de l’ICLR 2026 et d’autres conférences, et que le code associé ainsi que les détails de mise en œuvre devraient être progressivement mis en open source.
À l’avenir, TurboQuant devrait être intégré aux frameworks d’inférence courants tels que vLLM et TensorRT, favorisant ainsi davantage la démocratisation et l’évolutivité du déploiement de l’IA.
Article connexe
 PDG de DeepMind, Hassabis : Je dors six heures par jour et je me sens généralement plein d’énergie vers 1 h du matin.
Fortune a récemment publié une interview avec Demis Hassabis, PDG de Google DeepMind, révélant son approche non conventionnelle du repos et de la productivité. Hassabis a divulgué qu’il dort très peu, structurant ses heures d’éveil en deux blocs de t
OpenAI et Anthropic se disputent des parts de marché malgré des résultats en deçà des attentes
Bien que des informations récentes laissent entendre qu’OpenAI n’aurait pas atteint ses objectifs de chiffre d’affaires, ce qui a pesé sur les valeurs technologiques ce mardi, les investisseurs privés
Conformité des véhicules autonomes en Californie : une nouvelle ère marquée par les amendes, les zones de géolocalisation et 1 million de miles
Guident exploite une navette AuveTech dans le sud de la Floride, gérant un parcours de quatre miles à West Palm Beach et un parcours d’un mile à Boca Raton grâce à sa technologie de surveillance à dis
Recommandations de sujets spéciaux liés
en écrivant
 Outils d'IA pour la structuration d'articles destinés à la rédaction de textes longs
2026 : les meilleurs outils d'aide à la rédaction de plans pour les textes longs, sélectionnés parmi les mieux notés ! Cette sélection rigoureuse regroupe des outils puissants et révolutionnaires qui fournissent des plans précis et structurés, validés par des tests concrets, afin d'améliorer considérablement l'efficacité de la rédaction. XIX.AI fait partie de cette sélection d'élite. Consultez notre comparatif entre les versions gratuites et payantes pour vous aider à choisir l'outil idéal. Découvrez-les dès maintenant et tirez parti de l'IA !
 9 outils
 xix.ai
chatbot
Meilleures applications de chat de jeu de rôle par IA pour la pratique des langues, la préparation aux entretiens et la fluidité quotidienne
2026 Dernières Meilleures Applications de Chat IA pour le Jeu de Rôle, les plus bien notées pour la Pratique des Langues, la Préparation aux Entretiens et la Fluidité Quotidienne ! XIX.AI sélectionne une collection puissante et révolutionnaire qui propose une comparaison gratuit vs payant, des tests en conditions réelles et des classements mis à jour chaque semaine. Ces outils à essayer absolument vous aident à améliorer vos compétences en écriture, à surmonter les défis de fluidité et à optimiser l’efficacité de la communication dans tous les scénarios quotidiens. Explorez dès maintenant pour découvrir l’outil parfait pour votre progression linguistique !
10 outils
xix.ai
Composition musicale
Outils de séparation des pistes audio par IA pour la production de remix, la préparation de samples et les masters de karaoké
2026 : Les meilleures et plus récentes outils de séparation des pistes audio par IA, hautement notés, sélectionnés spécialement pour la production de remix, la préparation de samples et l’enregistrement de karaokés. Ces outils puissants et révolutionnaires, éprouvés dans des conditions réelles, permettent une isolation audio précise, ce qui améliore considérablement la productivité. XIX.AI propose un guide de comparaison gratuit mis à jour chaque semaine entre les versions payantes et gratuites, afin de vous aider à trouver la solution idéale adaptée à vos besoins. Découvrez-les dès maintenant pour tirer parti des avantages offerts par l’IA.
8 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l’IA pour les tableaux de bord de chiffre d’affaires, l’analyse des funnels et les indicateurs de produits
2026 : Les meilleurs copilotes AI SQL actuels, classés parmi les plus performants ! XIX.AI a sélectionné une collection puissante et révolutionnaire, mise à jour chaque semaine grâce à des tests concrets. Ces outils indispensables vous aident à créer des tableaux de bord financiers précis, à analyser les canaux de vente et à suivre en temps réel les indicateurs produits, ce qui améliore considérablement votre productivité. Découvrez-les dès maintenant pour trouver l’outil idéal pour des décisions basées sur les données ! 238 caractères
9 outils
xix.ai
Composition musicale
Meilleurs outils d’écriture de mélodies par IA pour les ébauches de chansons
2026 Derniers Meilleurs Outils d’Écriture de Mélodie par IA les Mieux Notés pour des Ébauches de Chansons ! XIX.AI a sélectionné une collection hautement puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles, afin d’offrir la meilleure expérience d’écriture. Vous pouvez y trouver des comparaisons détaillées entre versions gratuites et payantes, des classements précis, ainsi que des options incontournables conçues pour vous aider à créer sans effort des ébauches de chansons remarquables et à booster significativement votre productivité créative. Explorez dès maintenant pour découvrir l’outil qui vous correspond parfaitement !
8 outils
xix.ai
chatbot
Meilleurs outils d’entraînement à la conversation par IA pour la préparation aux entretiens
Les derniers outils de formation à la conversation par IA les mieux notés pour 2026 sont disponibles sur XIX.AI ! Cette sélection rigoureuse propose des outils puissants et révolutionnaires, testés rigoureusement dans des conditions réelles pour fournir des retours précis. Vous y trouverez une comparaison entre les versions gratuites et payantes, ainsi que des classements détaillés pour vous aider à choisir l’option incontournable qui renforce votre confiance et vos compétences. Explorez dès maintenant pour découvrir l’outil parfait pour réussir vos entretiens !
12 outils
xix.ai

 commentaires (0)
Le 26 mars, Google Research a annoncé le lancement de TurboQuant, un nouvel algorithme de compression par quantification vectorielle qui combine les technologies PolarQuant et QJL. Cette innovation réduit d’au moins six fois les besoins en mémoire du cache clé-valeur (KV Cache) lors de l’inférence des grands modèles linguistiques (LLM). Sur les GPU Nvidia H100, elle multiplie par huit la vitesse de calcul de l’attention tout en conservant une précision parfaite dans plusieurs benchmarks à contexte long. Cette avancée devrait réduire les coûts de déploiement de l’IA et accélérer l’adoption d’applications à contexte long.
Problèmes liés au cache KV : surcharge mémoire liée aux vecteurs de haute dimension
Lors du traitement de longues séquences, les LLM doivent maintenir un cache de vecteurs de clés et de valeurs. Ces vecteurs de haute dimension permettent des calculs rapides du mécanisme d’attention sans calculs redondants. Cependant, à mesure que la longueur du contexte augmente, la consommation de mémoire du cache KV croît de manière exponentielle, devenant ainsi un goulot d’étranglement majeur qui limite l’efficacité de l’inférence du modèle et l’échelle de déploiement.
Si les méthodes traditionnelles de quantification vectorielle permettent de compresser les données, elles nécessitent un espace de stockage supplémentaire pour les constantes de quantification, telles que les facteurs d’échelle et les points zéro. Ces constantes sont généralement stockées en pleine précision, ce qui ajoute 1 à 2 bits supplémentaires par valeur et annule en partie les avantages de la compression.
Innovation centrale de TurboQuant : compression en deux phases avec PolarQuant + QJL
TurboQuant adopte un cadre de compression en deux phases ne nécessitant aucun apprentissage, qui résout efficacement la surcharge liée à la quantification traditionnelle :
PolarQuant (compression en coordonnées polaires) :
Tout d’abord, les vecteurs sont pivotés de manière aléatoire, puis les coordonnées cartésiennes (X/Y/Z, etc.) sont converties en coordonnées polaires (angle + rayon). Les angles se situant dans une plage fixe et prévisible, cette méthode élimine la surcharge de stockage liée à la normalisation des limites dans la quantification traditionnelle, permettant ainsi une compression plus efficace.
QJL (correction d’erreur sur 1 bit, Johnson-Lindenstrauss quantifié) :
Après la compression PolarQuant, des erreurs résiduelles subsistent. QJL utilise la transformée de Johnson-Lindenstrauss pour réduire la dimensionnalité, puis quantifie à l’aide d’un schéma minimal à 1 bit (signe +1/-1). En employant un estimateur non biaisé spécial, il permet de corriger les erreurs lors du calcul du score d’attention sans surcoût de mémoire supplémentaire, garantissant ainsi que le processus global reste non biaisé.
Combiné à ces techniques, TurboQuant compresse le cache KV à environ 3 bits par valeur tout en conservant l’absence de biais et une grande précision dans l’estimation du produit scalaire.
Performances aux tests de référence : leadership global, idéal pour les contextes longs
L’équipe de Google a mené une validation approfondie sur des modèles open source tels que Gemma et Mistral :
LongBench (couvrant des tâches telles que les questions-réponses sur de longs textes, la génération de code et la synthèse) : TurboQuant égale ou surpasse les références existantes telles que KIVI, démontrant ainsi une supériorité globale.« Needle In A Haystack » et autres tâches de recherche : il atteint des scores en aval parfaits tout en compressant la mémoire KV d’au moins six fois. Résultats des tests sur Nvidia H100 : avec une configuration à 4 bits, la vitesse de calcul des logits d’attention est multipliée par huit au maximum.De plus, sur des ensembles de données vectorielles comme GloVe, le taux de rappel de TurboQuant surpasse celui des méthodes traditionnelles telles que PQ et RabbiQ.
Commentaire d’AIbase : TurboQuant ne nécessite ni réentraînement ni réglage fin du modèle et peut être directement appliqué aux grands modèles de langage (LLM) existants. Il convient à tout scénario reposant sur la quantification vectorielle, y compris la recherche dans les bases de données, les systèmes de recommandation et les moteurs de recherche vectoriels. Cela permet non seulement à un simple GPU grand public de prendre en charge des contextes plus longs (par exemple, des dizaines de milliers de tokens), mais abaisse également considérablement le seuil matériel requis pour les services d’IA de niveau entreprise.
Importance pour le secteur : une nouvelle référence en matière d’efficacité de l’inférence IA
Avec l’explosion des applications à contexte long et multimodales, la mémoire cache KV est devenue une contrainte majeure dans l’infrastructure d’IA. Le cadre de quantification « quasi-optimal et indépendant des données » de TurboQuant ouvre une nouvelle voie vers une inférence efficace. Google Research a indiqué que cette technologie a été détaillée dans des articles présentés lors de l’ICLR 2026 et d’autres conférences, et que le code associé ainsi que les détails de mise en œuvre devraient être progressivement mis en open source.
À l’avenir, TurboQuant devrait être intégré aux frameworks d’inférence courants tels que vLLM et TensorRT, favorisant ainsi davantage la démocratisation et l’évolutivité du déploiement de l’IA.








 PDG de DeepMind, Hassabis : Je dors six heures par jour et je me sens généralement plein d’énergie vers 1 h du matin.
Fortune a récemment publié une interview avec Demis Hassabis, PDG de Google DeepMind, révélant son approche non conventionnelle du repos et de la productivité. Hassabis a divulgué qu’il dort très peu, structurant ses heures d’éveil en deux blocs de t
 OpenAI et Anthropic se disputent des parts de marché malgré des résultats en deçà des attentes
Bien que des informations récentes laissent entendre qu’OpenAI n’aurait pas atteint ses objectifs de chiffre d’affaires, ce qui a pesé sur les valeurs technologiques ce mardi, les investisseurs privés
Conformité des véhicules autonomes en Californie : une nouvelle ère marquée par les amendes, les zones de géolocalisation et 1 million de miles
Guident exploite une navette AuveTech dans le sud de la Floride, gérant un parcours de quatre miles à West Palm Beach et un parcours d’un mile à Boca Raton grâce à sa technologie de surveillance à dis

2026 : les meilleurs outils d'aide à la rédaction de plans pour les textes longs, sélectionnés parmi les mieux notés ! Cette sélection rigoureuse regroupe des outils puissants et révolutionnaires qui fournissent des plans précis et structurés, validés par des tests concrets, afin d'améliorer considérablement l'efficacité de la rédaction. XIX.AI fait partie de cette sélection d'élite. Consultez notre comparatif entre les versions gratuites et payantes pour vous aider à choisir l'outil idéal. Découvrez-les dès maintenant et tirez parti de l'IA !
9 outils
xix.ai

2026 Dernières Meilleures Applications de Chat IA pour le Jeu de Rôle, les plus bien notées pour la Pratique des Langues, la Préparation aux Entretiens et la Fluidité Quotidienne ! XIX.AI sélectionne une collection puissante et révolutionnaire qui propose une comparaison gratuit vs payant, des tests en conditions réelles et des classements mis à jour chaque semaine. Ces outils à essayer absolument vous aident à améliorer vos compétences en écriture, à surmonter les défis de fluidité et à optimiser l’efficacité de la communication dans tous les scénarios quotidiens. Explorez dès maintenant pour découvrir l’outil parfait pour votre progression linguistique !
10 outils
xix.ai

2026 : Les meilleures et plus récentes outils de séparation des pistes audio par IA, hautement notés, sélectionnés spécialement pour la production de remix, la préparation de samples et l’enregistrement de karaokés. Ces outils puissants et révolutionnaires, éprouvés dans des conditions réelles, permettent une isolation audio précise, ce qui améliore considérablement la productivité. XIX.AI propose un guide de comparaison gratuit mis à jour chaque semaine entre les versions payantes et gratuites, afin de vous aider à trouver la solution idéale adaptée à vos besoins. Découvrez-les dès maintenant pour tirer parti des avantages offerts par l’IA.
8 outils
xix.ai

2026 : Les meilleurs copilotes AI SQL actuels, classés parmi les plus performants ! XIX.AI a sélectionné une collection puissante et révolutionnaire, mise à jour chaque semaine grâce à des tests concrets. Ces outils indispensables vous aident à créer des tableaux de bord financiers précis, à analyser les canaux de vente et à suivre en temps réel les indicateurs produits, ce qui améliore considérablement votre productivité. Découvrez-les dès maintenant pour trouver l’outil idéal pour des décisions basées sur les données ! 238 caractères
9 outils
xix.ai

2026 Derniers Meilleurs Outils d’Écriture de Mélodie par IA les Mieux Notés pour des Ébauches de Chansons ! XIX.AI a sélectionné une collection hautement puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles, afin d’offrir la meilleure expérience d’écriture. Vous pouvez y trouver des comparaisons détaillées entre versions gratuites et payantes, des classements précis, ainsi que des options incontournables conçues pour vous aider à créer sans effort des ébauches de chansons remarquables et à booster significativement votre productivité créative. Explorez dès maintenant pour découvrir l’outil qui vous correspond parfaitement !
8 outils
xix.ai

Les derniers outils de formation à la conversation par IA les mieux notés pour 2026 sont disponibles sur XIX.AI ! Cette sélection rigoureuse propose des outils puissants et révolutionnaires, testés rigoureusement dans des conditions réelles pour fournir des retours précis. Vous y trouverez une comparaison entre les versions gratuites et payantes, ainsi que des classements détaillés pour vous aider à choisir l’option incontournable qui renforce votre confiance et vos compétences. Explorez dès maintenant pour découvrir l’outil parfait pour réussir vos entretiens !
12 outils
xix.ai












