


 家
GoogleのTurboQuantは、LLMのキャッシュを6倍に圧縮し、速度を8倍に向上させ、トレーニング不要で精度の低下もゼロを実現
3月26日、Google Researchは、PolarQuantとQJLの技術を組み合わせた新しいベクトル量子化圧縮アルゴリズム「TurboQuant」のリリースを発表しました。この革新的な技術により、大規模言語モデル(LLM)の推論におけるキーバリューキャッシュ(KVキャッシュ)のメモリ要件が、少なくとも6分の1に削減されます。 NVIDIA H100 GPU上では、複数のロングコンテキストベンチマークにおいて精度の損失をゼロに保ちつつ、アテンション演算速度を最大8倍向上させます。この画期的な技術により、AIの導入コストが削減され、ロングコンテキストアプリケーションの普及が加速すると期待されています。
KVキャッシュの課題:高次元ベクトルメモリのオーバーヘッド
長いシーケンスを処理する際、LLMはキーベクトルと値ベクトルのキャッシュを維持する必要があります。これらの高次元ベクトルにより、冗長な計算を伴わずにアテンションメカニズムの高速な計算が可能になります。しかし、コンテキストの長さが増加するにつれて、KVキャッシュのメモリ消費量は指数関数的に増加し、モデルの推論効率や導入規模を制限する主要なボトルネックとなります。
従来のベクトル量子化手法ではデータを圧縮できますが、スケーリング係数やゼロ点などの量子化定数を格納するための追加のストレージが必要となります。これらの定数は通常、完全精度で格納されるため、値ごとに1~2ビットが追加され、圧縮によるメリットが部分的に相殺されてしまいます。
TurboQuantの核心となる革新:PolarQuant + QJLによる2段階圧縮
TurboQuantは、従来の量子化に伴うオーバーヘッドを効果的に解消する、トレーニング不要の2段階圧縮フレームワークを採用しています:
PolarQuant(極座標圧縮):
まず、ベクトルをランダムに回転させ、次に直交座標(X/Y/Zなど)を極座標(角度+半径)に変換します。角度は固定的で予測可能な範囲内に収まるため、この手法により、従来の量子化で必要とされる境界正規化のための保存オーバーヘッドが排除され、より効率的な圧縮が可能になります。
QJL(1ビット誤差補正、量子化ジョンソン・リンデンシュトラウス):
PolarQuantによる圧縮後も、残留誤差が残ります。 QJLは、次元削減のためにジョンソン・リンデンシュトラウス変換を用い、その後、最小限の1ビット方式(+1/-1の符号)で量子化を行います。特殊な不偏推定器を採用することで、追加のメモリオーバーヘッドなしにアテンションスコアの計算中に誤差補正を実現し、プロセス全体が不偏であることを保証します。
これらを組み合わせることで、TurboQuantは内積推定における不偏性と高精度を維持しつつ、KVキャッシュを値あたり約3ビットまで圧縮します。
ベンチマークテストの性能:総合的なトップクラス、長いコンテキストに最適
Googleチームは、GemmaやMistralなどのオープンソースモデルに対して広範な検証を実施しました:
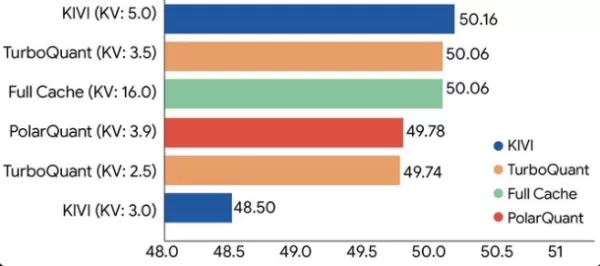
LongBench(長文QA、コード生成、要約などのタスクを網羅):TurboQuantはKIVIなどの既存のベースラインに匹敵、あるいはそれを上回り、包括的な優位性を示しました。Needle In A Haystack およびその他の検索タスク:KVメモリを少なくとも6倍圧縮しながら、ダウンストリームスコアで満点を達成しました。Nvidia H100のテスト結果:4ビット構成では、アテンションロジットの計算速度が最大8倍向上しました。さらに、GloVeのようなベクトルデータセットにおいて、TurboQuantのリコール率はPQやRabbiQといった従来の手法を上回っています。
AIbaseのコメント:TurboQuantはモデルの再学習や微調整を必要とせず、既存の大規模言語モデル(LLM)に直接適用可能です。データベース検索、レコメンデーションシステム、ベクトル検索エンジンなど、ベクトル量子化に依存するあらゆるシナリオに適しています。 これにより、単一のコンシューマー向けGPUでより長いコンテキスト(例:数万トークン)に対応できるだけでなく、エンタープライズレベルのAIサービスのハードウェア要件も大幅に引き下げられます。
業界における意義:AI推論効率の新たなベンチマーク
長文コンテキストやマルチモーダルアプリケーションの爆発的な増加に伴い、KVキャッシュメモリはAIインフラにおける中核的な制約要因となっています。TurboQuantの「ほぼ最適で、データに依存しない」量子化フレームワークは、効率的な推論に向けた新たな道を開きます。 Google Researchによると、この技術についてはICLR 2026やその他の会議で発表された論文で詳細が述べられており、関連するコードや実装の詳細は順次オープンソース化される見込みです。
将来的には、TurboQuantがvLLMやTensorRTといった主流の推論フレームワークに統合され、AI導入の普及とスケーラビリティがさらに促進されることが期待される。
関連記事
 AppleのスマートグラスはWWDC27でデビューする可能性があり、プライバシー保護を強調している
Bloombergのマーク・ガーマン氏によると、Appleのスマートグラス(コードネームN50)は2027年6月のWWDC27で初公開され、2027年秋に小売店での発売が予定されている。当初は今年後半から2027年初頭にかけての発売が目標だったが、製品のさらなる洗練とプライバシー保護プロトコルの強化を可能にするため、発売時期が延期された。プライバシーはAppleのスマートグラス戦略の中核的な柱である。Metaなどの競合他社をめぐるプライバシー論争から教訓を得て、Appleは堅牢な機能とポリシー
内部詳細が明かされた次世代ジェミニ:計算リソースの逼迫、開発チーム間で優先順位とリソース配分を巡り意見が割れた
報告によると、Googleの次世代Geminiモデルの発売は延期された。開発の優先順位とリソース配分をめぐる社内での意見の相違、限られた計算能力、複雑な承認手続きが重なり、2ヶ月の延期を余儀なくされた。独自開発のTPUチップを所有しているものの、モデルのトレーニング、Google Cloudサービス、多数の消費者向けおよび企業向けAIアプリケーションからの競合する需要により、Googleは計算資源の不足に直面している。上層部は現在、組織再編成を通じてこれらの部門間の対立に対処している。同時に、リ
OpenAI、成長鈍化への懸念を退け、複数の事業部門が加速していると表明
外部からの販売成長の鈍化や社内目標の未達に関する scrutiny に対応し、AI リーダーである OpenAI は 4 月 28 日(火曜日)、自信に満ちた声明を発表した。同社は、消費者向け製品とエンタープライズサービスが急速に進展しており、最近のビジネス減速に関する憶測を直接否定していると明らかにした。同社が「複数の社内目標を逸脱した」とする主張に対し、OpenAI はこれらの報道を「典型的なクリックベイト」と一蹴した。同社は、AI 統合に対する堅調なエンタープライズ需要を強調し、広告施策
関連特集おすすめ
データ分析
 収益ダッシュボード、ファネル分析、および製品指標向けのAI SQLコピロット
2026年最新かつ最も優れたAI SQLコピロットが最高評価でランクイン!XIX.AIは、毎週更新される実際の環境でのテストに対応した、強力で革新的なツール群を厳選しています。これらの必見ツールを使えば、正確な収益ダッシュボードの作成や販売プロセスの分析、製品指標の迅速な追跡が可能となり、生産性を大幅に向上させることができます。今すぐチェックして、データに基づいた意思決定に最適なツールを見つけましょう!238文字
 9 ツール
 xix.ai
作曲
曲のドラフト作成に最適なAIメロディ作成ツール
2026年最新版 高評価のAIメロディ作成ツールで曲のドラフト作成!XIX.AIは、厳格な実世界テストを経て最高の作成体験を提供する、革新的な強力なコレクションを厳選しました。詳細な無料版と有料版の比較、正確なランキング、そして素晴らしい曲のドラフトを楽に作成し、創造的な生産性を大幅に向上させるためにぜひ試すべきオプションが見つかります。今すぐ探索して、あなたに最適なツールを見つけましょう!
8 ツール
xix.ai
チャットボット
面接練習用のベストなAI会話トレーニングツール
2026年最新版・最高評価のAI会話トレーニングツールが、面接練習に最適です。XIX.AIにてご提供しています!この厳選コレクションには、現実世界での厳格なテストを経て正確なフィードバックを提供する強力なツールが含まれています。無料版と有料版の比較や詳細なランキングをご覧いただき、自信とスキルを高めるための必須オプションをお選びください。今すぐ探索して、面接成功に最適なツールを見つけましょう!
12 ツール
xix.ai
デザインとアート
クリエイティブな実験に最適なAIスタイル転送ツール
2026年版 クリエイティブな実験に最適な、最新・最高評価のAIスタイル転送ツール!XIX.AIは、実地テストと厳格なランキングを通じて卓越した結果をもたらす、強力で画期的な「必試」ツールを厳選しました。これらのトップソリューションは、コンテンツ制作を加速させ、無限の創造的可能性を切り拓くことで、クリエイターの生産性を大幅に向上させます。 今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
9 ツール
xix.ai
漫画制作
ビジュアルストーリーテリングに最適なAI吹き出しツール
2026年版、ビジュアルストーリーテリングに最適な高評価AIダイアログバブルツールがXIX.AIに登場!この厳選コレクションには、クリエイターの生産性を高め、創作上のボトルネックを解消する、画期的な強力ツールが揃っています。 無料版と有料版の比較、実地テストの結果、最新のランキングを確認して、魅力的なビジュアルストーリーを構築するのに最適な、ぜひ試すべきソリューションを見つけましょう。今すぐチェックして、あなたにぴったりのツールを発見してください!
10 ツール
xix.ai
ミーティングアシスタント
AI会議要約ツールのトップ選定:決定事項とフォローアップを明確に把握
2026年版:意思決定の追跡を明確にし、フォローアップを容易にする、高評価のAI会議要約ツールベストセレクション。この厳選リストでは、会議メモの自動化、重要なアクション項目の特定、すべてのプロジェクトにわたるチーム連携の効率化を通じて、生産性を劇的に向上させる、強力で画期的なソリューションをご紹介します。 無料版と有料版の比較、実地テストの結果、毎週更新されるランキングを参考に、最適なツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai

 コメント (0)
0/500
3月26日、Google Researchは、PolarQuantとQJLの技術を組み合わせた新しいベクトル量子化圧縮アルゴリズム「TurboQuant」のリリースを発表しました。この革新的な技術により、大規模言語モデル(LLM)の推論におけるキーバリューキャッシュ(KVキャッシュ)のメモリ要件が、少なくとも6分の1に削減されます。 NVIDIA H100 GPU上では、複数のロングコンテキストベンチマークにおいて精度の損失をゼロに保ちつつ、アテンション演算速度を最大8倍向上させます。この画期的な技術により、AIの導入コストが削減され、ロングコンテキストアプリケーションの普及が加速すると期待されています。
KVキャッシュの課題:高次元ベクトルメモリのオーバーヘッド
長いシーケンスを処理する際、LLMはキーベクトルと値ベクトルのキャッシュを維持する必要があります。これらの高次元ベクトルにより、冗長な計算を伴わずにアテンションメカニズムの高速な計算が可能になります。しかし、コンテキストの長さが増加するにつれて、KVキャッシュのメモリ消費量は指数関数的に増加し、モデルの推論効率や導入規模を制限する主要なボトルネックとなります。
従来のベクトル量子化手法ではデータを圧縮できますが、スケーリング係数やゼロ点などの量子化定数を格納するための追加のストレージが必要となります。これらの定数は通常、完全精度で格納されるため、値ごとに1~2ビットが追加され、圧縮によるメリットが部分的に相殺されてしまいます。
TurboQuantの核心となる革新:PolarQuant + QJLによる2段階圧縮
TurboQuantは、従来の量子化に伴うオーバーヘッドを効果的に解消する、トレーニング不要の2段階圧縮フレームワークを採用しています:
PolarQuant(極座標圧縮):
まず、ベクトルをランダムに回転させ、次に直交座標(X/Y/Zなど)を極座標(角度+半径)に変換します。角度は固定的で予測可能な範囲内に収まるため、この手法により、従来の量子化で必要とされる境界正規化のための保存オーバーヘッドが排除され、より効率的な圧縮が可能になります。
QJL(1ビット誤差補正、量子化ジョンソン・リンデンシュトラウス):
PolarQuantによる圧縮後も、残留誤差が残ります。 QJLは、次元削減のためにジョンソン・リンデンシュトラウス変換を用い、その後、最小限の1ビット方式(+1/-1の符号)で量子化を行います。特殊な不偏推定器を採用することで、追加のメモリオーバーヘッドなしにアテンションスコアの計算中に誤差補正を実現し、プロセス全体が不偏であることを保証します。
これらを組み合わせることで、TurboQuantは内積推定における不偏性と高精度を維持しつつ、KVキャッシュを値あたり約3ビットまで圧縮します。
ベンチマークテストの性能:総合的なトップクラス、長いコンテキストに最適
Googleチームは、GemmaやMistralなどのオープンソースモデルに対して広範な検証を実施しました:
LongBench(長文QA、コード生成、要約などのタスクを網羅):TurboQuantはKIVIなどの既存のベースラインに匹敵、あるいはそれを上回り、包括的な優位性を示しました。Needle In A Haystack およびその他の検索タスク:KVメモリを少なくとも6倍圧縮しながら、ダウンストリームスコアで満点を達成しました。Nvidia H100のテスト結果:4ビット構成では、アテンションロジットの計算速度が最大8倍向上しました。さらに、GloVeのようなベクトルデータセットにおいて、TurboQuantのリコール率はPQやRabbiQといった従来の手法を上回っています。
AIbaseのコメント:TurboQuantはモデルの再学習や微調整を必要とせず、既存の大規模言語モデル(LLM)に直接適用可能です。データベース検索、レコメンデーションシステム、ベクトル検索エンジンなど、ベクトル量子化に依存するあらゆるシナリオに適しています。 これにより、単一のコンシューマー向けGPUでより長いコンテキスト(例:数万トークン)に対応できるだけでなく、エンタープライズレベルのAIサービスのハードウェア要件も大幅に引き下げられます。
業界における意義:AI推論効率の新たなベンチマーク
長文コンテキストやマルチモーダルアプリケーションの爆発的な増加に伴い、KVキャッシュメモリはAIインフラにおける中核的な制約要因となっています。TurboQuantの「ほぼ最適で、データに依存しない」量子化フレームワークは、効率的な推論に向けた新たな道を開きます。 Google Researchによると、この技術についてはICLR 2026やその他の会議で発表された論文で詳細が述べられており、関連するコードや実装の詳細は順次オープンソース化される見込みです。
将来的には、TurboQuantがvLLMやTensorRTといった主流の推論フレームワークに統合され、AI導入の普及とスケーラビリティがさらに促進されることが期待される。








 AppleのスマートグラスはWWDC27でデビューする可能性があり、プライバシー保護を強調している
Bloombergのマーク・ガーマン氏によると、Appleのスマートグラス(コードネームN50)は2027年6月のWWDC27で初公開され、2027年秋に小売店での発売が予定されている。当初は今年後半から2027年初頭にかけての発売が目標だったが、製品のさらなる洗練とプライバシー保護プロトコルの強化を可能にするため、発売時期が延期された。プライバシーはAppleのスマートグラス戦略の中核的な柱である。Metaなどの競合他社をめぐるプライバシー論争から教訓を得て、Appleは堅牢な機能とポリシー
 内部詳細が明かされた次世代ジェミニ:計算リソースの逼迫、開発チーム間で優先順位とリソース配分を巡り意見が割れた
報告によると、Googleの次世代Geminiモデルの発売は延期された。開発の優先順位とリソース配分をめぐる社内での意見の相違、限られた計算能力、複雑な承認手続きが重なり、2ヶ月の延期を余儀なくされた。独自開発のTPUチップを所有しているものの、モデルのトレーニング、Google Cloudサービス、多数の消費者向けおよび企業向けAIアプリケーションからの競合する需要により、Googleは計算資源の不足に直面している。上層部は現在、組織再編成を通じてこれらの部門間の対立に対処している。同時に、リ
 OpenAI、成長鈍化への懸念を退け、複数の事業部門が加速していると表明
外部からの販売成長の鈍化や社内目標の未達に関する scrutiny に対応し、AI リーダーである OpenAI は 4 月 28 日(火曜日)、自信に満ちた声明を発表した。同社は、消費者向け製品とエンタープライズサービスが急速に進展しており、最近のビジネス減速に関する憶測を直接否定していると明らかにした。同社が「複数の社内目標を逸脱した」とする主張に対し、OpenAI はこれらの報道を「典型的なクリックベイト」と一蹴した。同社は、AI 統合に対する堅調なエンタープライズ需要を強調し、広告施策

2026年最新かつ最も優れたAI SQLコピロットが最高評価でランクイン!XIX.AIは、毎週更新される実際の環境でのテストに対応した、強力で革新的なツール群を厳選しています。これらの必見ツールを使えば、正確な収益ダッシュボードの作成や販売プロセスの分析、製品指標の迅速な追跡が可能となり、生産性を大幅に向上させることができます。今すぐチェックして、データに基づいた意思決定に最適なツールを見つけましょう!238文字
9 ツール
xix.ai

2026年最新版 高評価のAIメロディ作成ツールで曲のドラフト作成!XIX.AIは、厳格な実世界テストを経て最高の作成体験を提供する、革新的な強力なコレクションを厳選しました。詳細な無料版と有料版の比較、正確なランキング、そして素晴らしい曲のドラフトを楽に作成し、創造的な生産性を大幅に向上させるためにぜひ試すべきオプションが見つかります。今すぐ探索して、あなたに最適なツールを見つけましょう!
8 ツール
xix.ai

2026年最新版・最高評価のAI会話トレーニングツールが、面接練習に最適です。XIX.AIにてご提供しています!この厳選コレクションには、現実世界での厳格なテストを経て正確なフィードバックを提供する強力なツールが含まれています。無料版と有料版の比較や詳細なランキングをご覧いただき、自信とスキルを高めるための必須オプションをお選びください。今すぐ探索して、面接成功に最適なツールを見つけましょう!
12 ツール
xix.ai

2026年版 クリエイティブな実験に最適な、最新・最高評価のAIスタイル転送ツール!XIX.AIは、実地テストと厳格なランキングを通じて卓越した結果をもたらす、強力で画期的な「必試」ツールを厳選しました。これらのトップソリューションは、コンテンツ制作を加速させ、無限の創造的可能性を切り拓くことで、クリエイターの生産性を大幅に向上させます。 今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
9 ツール
xix.ai

2026年版、ビジュアルストーリーテリングに最適な高評価AIダイアログバブルツールがXIX.AIに登場!この厳選コレクションには、クリエイターの生産性を高め、創作上のボトルネックを解消する、画期的な強力ツールが揃っています。 無料版と有料版の比較、実地テストの結果、最新のランキングを確認して、魅力的なビジュアルストーリーを構築するのに最適な、ぜひ試すべきソリューションを見つけましょう。今すぐチェックして、あなたにぴったりのツールを発見してください!
10 ツール
xix.ai

2026年版:意思決定の追跡を明確にし、フォローアップを容易にする、高評価のAI会議要約ツールベストセレクション。この厳選リストでは、会議メモの自動化、重要なアクション項目の特定、すべてのプロジェクトにわたるチーム連携の効率化を通じて、生産性を劇的に向上させる、強力で画期的なソリューションをご紹介します。 無料版と有料版の比較、実地テストの結果、毎週更新されるランキングを参考に、最適なツールを見つけてください。今すぐチェックして、AIの力を最大限に活用しましょう!
9 ツール
xix.ai












