


 Hogar
Google TurboQuant comprime la caché de los modelos de lenguaje a gran escala (LLM) seis veces más y multiplica por ocho la velocidad, sin necesidad de entrenamiento y sin pérdida de precisión alguna
El 26 de marzo, Google Research anunció el lanzamiento de TurboQuant, un nuevo algoritmo de compresión por cuantificación vectorial que combina las tecnologías PolarQuant y QJL. Esta innovación reduce al menos seis veces los requisitos de memoria de la caché de clave-valor (KV Cache) en la inferencia de modelos de lenguaje a gran escala (LLM). En las GPU Nvidia H100, mejora la velocidad de cálculo de la atención hasta ocho veces, al tiempo que mantiene una pérdida de precisión nula en múltiples pruebas de rendimiento con contextos largos. Se espera que este avance reduzca los costes de implementación de la IA y acelere la adopción de aplicaciones con contextos largos.
Puntos débiles de la caché KV: sobrecarga de memoria de vectores de alta dimensión
Al procesar secuencias largas, los LLM deben mantener una caché de vectores de clave y valor. Estos vectores de alta dimensión permiten realizar cálculos rápidos del mecanismo de atención sin computaciones redundantes. Sin embargo, a medida que aumenta la longitud del contexto, el consumo de memoria de la caché KV crece exponencialmente, convirtiéndose en un importante cuello de botella que limita la eficiencia de la inferencia del modelo y la escala de implementación.
Aunque los métodos tradicionales de cuantificación vectorial pueden comprimir datos, requieren almacenamiento adicional para las constantes de cuantificación, como los factores de escala y los puntos cero. Estas constantes suelen almacenarse con precisión completa, lo que añade entre 1 y 2 bits adicionales por valor y contrarresta parcialmente los beneficios de la compresión.
Innovación principal de TurboQuant: compresión en dos fases con PolarQuant + QJL
TurboQuant adopta un marco de compresión en dos fases que no requiere entrenamiento y que aborda de manera eficaz la sobrecarga de la cuantificación tradicional:
PolarQuant (compresión en coordenadas polares):
En primer lugar, los vectores se giran aleatoriamente; a continuación, las coordenadas cartesianas (X/Y/Z, etc.) se convierten a forma polar (ángulo + radio). Dado que los ángulos se encuentran dentro de un rango fijo y predecible, este método elimina la sobrecarga de almacenamiento necesaria para la normalización de límites en la cuantificación tradicional, lo que permite una compresión más eficiente.
QJL (corrección de errores de 1 bit, Johnson-Lindenstrauss cuantificado):
Tras la compresión con PolarQuant, persisten errores residuales. QJL utiliza la transformada de Johnson-Lindenstrauss para la reducción de dimensionalidad y, a continuación, cuantifica mediante un esquema mínimo de 1 bit (signo +1/-1). Al emplear un estimador especial no sesgado, logra la corrección de errores durante el cálculo de la puntuación de atención sin una sobrecarga de memoria adicional, lo que garantiza que el proceso global siga siendo imparcial.
En conjunto, TurboQuant comprime la caché KV a aproximadamente 3 bits por valor, al tiempo que mantiene la imparcialidad y una alta precisión en la estimación del producto interno.
Rendimiento en pruebas de referencia: liderazgo generalizado, ideal para contextos largos
El equipo de Google llevó a cabo una validación exhaustiva en modelos de código abierto como Gemma y Mistral:
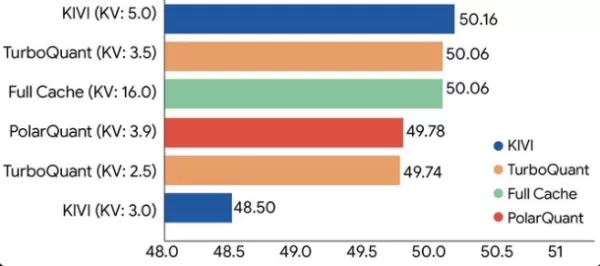
LongBench (que abarca tareas como preguntas y respuestas con textos largos, generación de código y resumen): TurboQuant iguala o supera las referencias existentes, como KIVI, demostrando un liderazgo general.«Needle In A Haystack» y otras tareas de recuperación: alcanza puntuaciones perfectas en las tareas posteriores al tiempo que comprime la memoria KV al menos seis veces. Resultados de las pruebas con Nvidia H100: con una configuración de 4 bits, la velocidad de cálculo de los logits de atención mejora hasta ocho veces.Además, en conjuntos de datos vectoriales como GloVe, la tasa de recuperación de TurboQuant supera a la de métodos tradicionales como PQ y RabbiQ.
Comentario de AIbase: TurboQuant no requiere reentrenamiento ni ajuste fino del modelo y puede aplicarse directamente a los LLM existentes. Es adecuado para cualquier escenario que se base en la cuantificación vectorial, incluyendo la recuperación de bases de datos, los sistemas de recomendación y los motores de búsqueda vectorial. Esto no solo permite que una única GPU de consumo pueda gestionar contextos más largos (por ejemplo, decenas de miles de tokens), sino que también reduce significativamente el umbral de hardware necesario para los servicios de IA a nivel empresarial.
Importancia para el sector: un nuevo punto de referencia para la eficiencia de la inferencia de IA
Con la explosión de las aplicaciones de contexto largo y multimodales, la memoria de caché KV se ha convertido en una limitación fundamental de la infraestructura de IA. El marco de cuantificación «casi óptimo e independiente de los datos» de TurboQuant abre una nueva vía para una inferencia eficiente. Google Research ha señalado que esta tecnología se ha detallado en artículos presentados en ICLR 2026 y otras conferencias, y se espera que el código y los detalles de implementación relacionados se publiquen gradualmente como código abierto.
Se prevé que, en el futuro, TurboQuant se integre en marcos de inferencia generalizados, como vLLM y TensorRT, lo que impulsará aún más la democratización y la escalabilidad del despliegue de la IA.
Artículo relacionado
 Las gafas inteligentes de Apple podrían debutar en la WWDC27, destacando la protección de la privacidad
El informe de Mark Gurman de Bloomberg indica que las gafas inteligentes de Apple, con el nombre en código N50, están previstas para su presentación en la WWDC27 de junio de 2027, con un lanzamiento al público previsto para el otoño de 2027. Original
Dentro de los detalles revelados sobre el Gemini de próxima generación: Potencia de cálculo limitada, los equipos internos discreparon sobre las prioridades de desarrollo y la asignación de recursos
Los informes indican que el lanzamiento del tan esperado modelo Gemini de próxima generación de Google ha sido pospuesto. Los desacuerdos internos sobre las prioridades de desarrollo y la asignación de recursos, combinados con una capacidad de comput
OpenAI descarta preocupaciones por la desaceleración del crecimiento y afirma que múltiples unidades de negocio están acelerando
En respuesta a la escrutinio externo sobre el desaceleramiento del crecimiento de las ventas y el incumplimiento de las metas internas, el líder en inteligencia artificial, OpenAI, emitió una declaración contundente el martes 28 de abril. La empresa
Recomendaciones de temas especiales relacionados
composicion musical
 Mejores herramientas de IA para escribir melodías en borradores de canciones
2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
 8 herramientas
 xix.ai
chatbot
Mejores herramientas de entrenamiento de conversación con IA para practicar entrevistas
¡Las mejores herramientas de entrenamiento de conversación con IA para prácticas de entrevistas más recientes y mejor valoradas de 2026 ya están disponibles en XIX.AI! Esta colección seleccionada incluye herramientas poderosas y transformadoras que han pasado por rigurosas pruebas en el mundo real para ofrecer retroalimentación precisa. Encontrarás una comparación entre opciones gratuitas y de pago, así como clasificaciones detalladas para ayudarte a elegir la opción imprescindible que aumente tu confianza y habilidades. ¡Explora ahora para descubrir tu herramienta perfecta para el éxito en las entrevistas!
12 herramientas
xix.ai
Diseño y Arte
Las mejores herramientas de transferencia de estilos con IA para experimentos creativos
¡Las mejores herramientas de transferencia de estilo con IA de 2026, mejor valoradas para experimentos creativos! XIX.AI ha seleccionado una colección de herramientas potentes y revolucionarias que no te puedes perder, capaces de ofrecer resultados excepcionales según pruebas reales y clasificaciones rigurosas. Estas soluciones de primera categoría ayudan a los creativos a aumentar significativamente su productividad, acelerando la creación de contenidos y abriendo un sinfín de posibilidades creativas. ¡Explora ahora mismo para descubrir tu herramienta perfecta y empieza a crear hoy mismo!
9 herramientas
xix.ai
Creación de cómics
Las mejores herramientas de burbujas de diálogo con IA para la narración visual
¡Ya están aquí, en XIX.AI, las mejores herramientas de 2026 con las mejores valoraciones para crear bocadillos de diálogo con IA y contar historias visuales! Esta selección incluye potentes herramientas revolucionarias que ayudan a los creadores a aumentar su productividad y superar los bloqueos creativos. Consulta una comparación entre las versiones gratuitas y de pago, echa un vistazo a las pruebas en condiciones reales y revisa las últimas clasificaciones para encontrar las soluciones imprescindibles, perfectas para crear narrativas visuales cautivadoras. ¡Explora ahora mismo y descubre tu herramienta ideal!
10 herramientas
xix.ai
Asistente de reuniones
Las mejores herramientas de resumen de reuniones con IA: realiza un seguimiento claro de las decisiones y las acciones de seguimiento
Las mejores herramientas de resumen de reuniones con IA de 2026, mejor valoradas para un seguimiento claro de las decisiones y un seguimiento posterior sin esfuerzo. Esta lista seleccionada presenta soluciones potentes y revolucionarias que aumentan drásticamente la productividad al automatizar las notas de las reuniones, identificar las acciones clave y agilizar la coordinación del equipo en todos los proyectos. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones actualizadas semanalmente, para ayudarte a encontrar la herramienta perfecta. ¡Explora ahora mismo y aprovecha las ventajas de la IA!
9 herramientas
xix.ai
Análisis de datos
Mejores herramientas de limpieza de datos con IA: corrige valores faltantes y duplicados rápidamente
2026: Las mejores herramientas de limpieza de datos basadas en IA, mejor calificadas y más actualizadas, para corregir rápidamente valores faltantes y duplicados. Esta lista cuidadosamente seleccionada presenta soluciones potentes que transforman el trabajo y aumentan significativamente la productividad. Cada opción ha sido sometida a pruebas rigurosas en entornos reales para garantizar su fiabilidad. Obtenga una comparación gratuita entre las opciones gratuitas y de pago y descubra la herramienta imprescindible que mejor se adapte a sus necesidades. Explore ahora en XIX.AI para darle un vantaje con la inteligencia artificial.
11 herramientas
xix.ai

 comentario (0)
0/500
El 26 de marzo, Google Research anunció el lanzamiento de TurboQuant, un nuevo algoritmo de compresión por cuantificación vectorial que combina las tecnologías PolarQuant y QJL. Esta innovación reduce al menos seis veces los requisitos de memoria de la caché de clave-valor (KV Cache) en la inferencia de modelos de lenguaje a gran escala (LLM). En las GPU Nvidia H100, mejora la velocidad de cálculo de la atención hasta ocho veces, al tiempo que mantiene una pérdida de precisión nula en múltiples pruebas de rendimiento con contextos largos. Se espera que este avance reduzca los costes de implementación de la IA y acelere la adopción de aplicaciones con contextos largos.
Puntos débiles de la caché KV: sobrecarga de memoria de vectores de alta dimensión
Al procesar secuencias largas, los LLM deben mantener una caché de vectores de clave y valor. Estos vectores de alta dimensión permiten realizar cálculos rápidos del mecanismo de atención sin computaciones redundantes. Sin embargo, a medida que aumenta la longitud del contexto, el consumo de memoria de la caché KV crece exponencialmente, convirtiéndose en un importante cuello de botella que limita la eficiencia de la inferencia del modelo y la escala de implementación.
Aunque los métodos tradicionales de cuantificación vectorial pueden comprimir datos, requieren almacenamiento adicional para las constantes de cuantificación, como los factores de escala y los puntos cero. Estas constantes suelen almacenarse con precisión completa, lo que añade entre 1 y 2 bits adicionales por valor y contrarresta parcialmente los beneficios de la compresión.
Innovación principal de TurboQuant: compresión en dos fases con PolarQuant + QJL
TurboQuant adopta un marco de compresión en dos fases que no requiere entrenamiento y que aborda de manera eficaz la sobrecarga de la cuantificación tradicional:
PolarQuant (compresión en coordenadas polares):
En primer lugar, los vectores se giran aleatoriamente; a continuación, las coordenadas cartesianas (X/Y/Z, etc.) se convierten a forma polar (ángulo + radio). Dado que los ángulos se encuentran dentro de un rango fijo y predecible, este método elimina la sobrecarga de almacenamiento necesaria para la normalización de límites en la cuantificación tradicional, lo que permite una compresión más eficiente.
QJL (corrección de errores de 1 bit, Johnson-Lindenstrauss cuantificado):
Tras la compresión con PolarQuant, persisten errores residuales. QJL utiliza la transformada de Johnson-Lindenstrauss para la reducción de dimensionalidad y, a continuación, cuantifica mediante un esquema mínimo de 1 bit (signo +1/-1). Al emplear un estimador especial no sesgado, logra la corrección de errores durante el cálculo de la puntuación de atención sin una sobrecarga de memoria adicional, lo que garantiza que el proceso global siga siendo imparcial.
En conjunto, TurboQuant comprime la caché KV a aproximadamente 3 bits por valor, al tiempo que mantiene la imparcialidad y una alta precisión en la estimación del producto interno.
Rendimiento en pruebas de referencia: liderazgo generalizado, ideal para contextos largos
El equipo de Google llevó a cabo una validación exhaustiva en modelos de código abierto como Gemma y Mistral:
LongBench (que abarca tareas como preguntas y respuestas con textos largos, generación de código y resumen): TurboQuant iguala o supera las referencias existentes, como KIVI, demostrando un liderazgo general.«Needle In A Haystack» y otras tareas de recuperación: alcanza puntuaciones perfectas en las tareas posteriores al tiempo que comprime la memoria KV al menos seis veces. Resultados de las pruebas con Nvidia H100: con una configuración de 4 bits, la velocidad de cálculo de los logits de atención mejora hasta ocho veces.Además, en conjuntos de datos vectoriales como GloVe, la tasa de recuperación de TurboQuant supera a la de métodos tradicionales como PQ y RabbiQ.
Comentario de AIbase: TurboQuant no requiere reentrenamiento ni ajuste fino del modelo y puede aplicarse directamente a los LLM existentes. Es adecuado para cualquier escenario que se base en la cuantificación vectorial, incluyendo la recuperación de bases de datos, los sistemas de recomendación y los motores de búsqueda vectorial. Esto no solo permite que una única GPU de consumo pueda gestionar contextos más largos (por ejemplo, decenas de miles de tokens), sino que también reduce significativamente el umbral de hardware necesario para los servicios de IA a nivel empresarial.
Importancia para el sector: un nuevo punto de referencia para la eficiencia de la inferencia de IA
Con la explosión de las aplicaciones de contexto largo y multimodales, la memoria de caché KV se ha convertido en una limitación fundamental de la infraestructura de IA. El marco de cuantificación «casi óptimo e independiente de los datos» de TurboQuant abre una nueva vía para una inferencia eficiente. Google Research ha señalado que esta tecnología se ha detallado en artículos presentados en ICLR 2026 y otras conferencias, y se espera que el código y los detalles de implementación relacionados se publiquen gradualmente como código abierto.
Se prevé que, en el futuro, TurboQuant se integre en marcos de inferencia generalizados, como vLLM y TensorRT, lo que impulsará aún más la democratización y la escalabilidad del despliegue de la IA.








 Las gafas inteligentes de Apple podrían debutar en la WWDC27, destacando la protección de la privacidad
El informe de Mark Gurman de Bloomberg indica que las gafas inteligentes de Apple, con el nombre en código N50, están previstas para su presentación en la WWDC27 de junio de 2027, con un lanzamiento al público previsto para el otoño de 2027. Original
 Dentro de los detalles revelados sobre el Gemini de próxima generación: Potencia de cálculo limitada, los equipos internos discreparon sobre las prioridades de desarrollo y la asignación de recursos
Los informes indican que el lanzamiento del tan esperado modelo Gemini de próxima generación de Google ha sido pospuesto. Los desacuerdos internos sobre las prioridades de desarrollo y la asignación de recursos, combinados con una capacidad de comput
 OpenAI descarta preocupaciones por la desaceleración del crecimiento y afirma que múltiples unidades de negocio están acelerando
En respuesta a la escrutinio externo sobre el desaceleramiento del crecimiento de las ventas y el incumplimiento de las metas internas, el líder en inteligencia artificial, OpenAI, emitió una declaración contundente el martes 28 de abril. La empresa

2026 Últimas Mejores Herramientas de Escritura de Melodías con IA Mejor Valoradas para Borradores de Canciones. XIX.AI ha curado una colección altamente poderosa y transformadora que ha pasado por rigurosas pruebas en el mundo real para ofrecer la mejor experiencia de escritura. Puedes encontrar comparaciones detalladas entre versiones gratuitas y de pago, clasificaciones precisas y opciones imperdibles diseñadas para ayudarte a crear borradores de canciones impresionantes sin esfuerzo y aumentar significativamente tu productividad creativa. ¡Explora ahora para descubrir tu herramienta perfecta!
8 herramientas
xix.ai

¡Las mejores herramientas de entrenamiento de conversación con IA para prácticas de entrevistas más recientes y mejor valoradas de 2026 ya están disponibles en XIX.AI! Esta colección seleccionada incluye herramientas poderosas y transformadoras que han pasado por rigurosas pruebas en el mundo real para ofrecer retroalimentación precisa. Encontrarás una comparación entre opciones gratuitas y de pago, así como clasificaciones detalladas para ayudarte a elegir la opción imprescindible que aumente tu confianza y habilidades. ¡Explora ahora para descubrir tu herramienta perfecta para el éxito en las entrevistas!
12 herramientas
xix.ai

¡Las mejores herramientas de transferencia de estilo con IA de 2026, mejor valoradas para experimentos creativos! XIX.AI ha seleccionado una colección de herramientas potentes y revolucionarias que no te puedes perder, capaces de ofrecer resultados excepcionales según pruebas reales y clasificaciones rigurosas. Estas soluciones de primera categoría ayudan a los creativos a aumentar significativamente su productividad, acelerando la creación de contenidos y abriendo un sinfín de posibilidades creativas. ¡Explora ahora mismo para descubrir tu herramienta perfecta y empieza a crear hoy mismo!
9 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, las mejores herramientas de 2026 con las mejores valoraciones para crear bocadillos de diálogo con IA y contar historias visuales! Esta selección incluye potentes herramientas revolucionarias que ayudan a los creadores a aumentar su productividad y superar los bloqueos creativos. Consulta una comparación entre las versiones gratuitas y de pago, echa un vistazo a las pruebas en condiciones reales y revisa las últimas clasificaciones para encontrar las soluciones imprescindibles, perfectas para crear narrativas visuales cautivadoras. ¡Explora ahora mismo y descubre tu herramienta ideal!
10 herramientas
xix.ai

Las mejores herramientas de resumen de reuniones con IA de 2026, mejor valoradas para un seguimiento claro de las decisiones y un seguimiento posterior sin esfuerzo. Esta lista seleccionada presenta soluciones potentes y revolucionarias que aumentan drásticamente la productividad al automatizar las notas de las reuniones, identificar las acciones clave y agilizar la coordinación del equipo en todos los proyectos. Consigue una comparación entre las versiones gratuitas y de pago, junto con pruebas en condiciones reales y clasificaciones actualizadas semanalmente, para ayudarte a encontrar la herramienta perfecta. ¡Explora ahora mismo y aprovecha las ventajas de la IA!
9 herramientas
xix.ai

2026: Las mejores herramientas de limpieza de datos basadas en IA, mejor calificadas y más actualizadas, para corregir rápidamente valores faltantes y duplicados. Esta lista cuidadosamente seleccionada presenta soluciones potentes que transforman el trabajo y aumentan significativamente la productividad. Cada opción ha sido sometida a pruebas rigurosas en entornos reales para garantizar su fiabilidad. Obtenga una comparación gratuita entre las opciones gratuitas y de pago y descubra la herramienta imprescindible que mejor se adapte a sus necesidades. Explore ahora en XIX.AI para darle un vantaje con la inteligencia artificial.
11 herramientas
xix.ai












