


 Lar
O Google TurboQuant comprime o cache do LLM em 6 vezes, aumenta a velocidade em 8 vezes, sem necessidade de treinamento e sem perda de precisão
Em 26 de março, o Google Research anunciou o lançamento do TurboQuant, um novo algoritmo de compressão por quantização vetorial que combina as tecnologias PolarQuant e QJL. Essa inovação reduz em pelo menos seis vezes os requisitos de memória do cache de chave-valor (KV Cache) na inferência de grandes modelos de linguagem (LLM). Em GPUs Nvidia H100, ele melhora a velocidade de computação de atenção em até oito vezes, mantendo perda zero de precisão em vários benchmarks de contexto longo. Espera-se que essa inovação reduza os custos de implantação de IA e acelere a adoção de aplicativos de contexto longo.
Desafios do KV Cache: sobrecarga de memória de vetores de alta dimensão
Ao processar sequências longas, os LLMs precisam manter um cache de vetores de chave e valor. Esses vetores de alta dimensão permitem cálculos rápidos do mecanismo de atenção sem computações redundantes. No entanto, à medida que o comprimento do contexto aumenta, o consumo de memória do KV Cache cresce exponencialmente, tornando-se um grande gargalo que limita a eficiência da inferência do modelo e a escala de implantação.
Embora os métodos tradicionais de quantização de vetores possam comprimir dados, eles exigem armazenamento adicional para constantes de quantização, como fatores de escala e pontos zero. Essas constantes são normalmente armazenadas em precisão total, adicionando 1 a 2 bits extras por valor e compensando parcialmente os benefícios da compressão.
Inovação central do TurboQuant: compressão em duas fases com PolarQuant + QJL
O TurboQuant adota uma estrutura de compressão em duas fases, sem necessidade de treinamento, que resolve de forma eficaz a sobrecarga da quantização tradicional:
PolarQuant (Compressão em Coordenadas Polares):
Primeiro, os vetores são girados aleatoriamente; em seguida, as coordenadas cartesianas (X/Y/Z, etc.) são convertidas para a forma polar (ângulo + raio). Como os ângulos se enquadram em um intervalo fixo e previsível, esse método elimina a sobrecarga de armazenamento necessária para a normalização de limites na quantização tradicional, permitindo uma compressão mais eficiente.
QJL (Correção de Erro de 1 bit, Johnson-Lindenstrauss Quantizado):
Após a compressão com PolarQuant, ainda permanecem erros residuais. O QJL utiliza a transformação de Johnson-Lindenstrauss para redução de dimensionalidade e, em seguida, quantiza usando um esquema mínimo de 1 bit (sinal +1/-1). Ao empregar um estimador especial não viesado, ele realiza a correção de erros durante o cálculo da pontuação de atenção sem sobrecarga adicional de memória, garantindo que o processo geral permaneça não viesado.
Combinado, o TurboQuant comprime o cache KV para aproximadamente 3 bits por valor, mantendo a imparcialidade e a alta precisão na estimativa do produto escalar.
Desempenho em testes de benchmark: liderança abrangente, ideal para contextos longos
A equipe do Google realizou uma validação extensa em modelos de código aberto, como o Gemma e o Mistral:
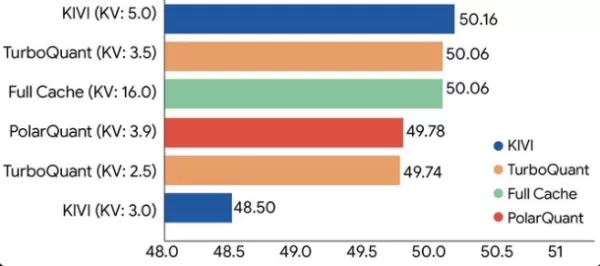
LongBench (abrangendo tarefas como perguntas e respostas com textos longos, geração de código e resumo): o TurboQuant iguala ou supera referências existentes, como o KIVI, demonstrando liderança abrangente.Needle In A Haystack e outras tarefas de recuperação: alcança pontuações perfeitas nas tarefas subsequentes ao comprimir a memória KV em pelo menos seis vezes. Resultados dos testes com a Nvidia H100: com uma configuração de 4 bits, a velocidade de cálculo dos logits de atenção melhora em até oito vezes.Além disso, em conjuntos de dados vetoriais como o GloVe, a taxa de recall do TurboQuant supera métodos tradicionais, como PQ e RabbiQ.
Comentário da AIbase: O TurboQuant não requer retreinamento ou ajuste fino do modelo e pode ser aplicado diretamente a LLMs existentes. É adequado para qualquer cenário que dependa de quantização vetorial, incluindo recuperação de bancos de dados, sistemas de recomendação e mecanismos de busca vetorial. Isso não apenas permite que uma única GPU de nível de consumidor suporte contextos mais longos (por exemplo, dezenas de milhares de tokens), mas também reduz significativamente o limite de hardware para serviços de IA de nível empresarial.
Importância para o setor: um novo padrão de referência para a eficiência da inferência de IA
Com a explosão de aplicações de contexto longo e multimodais, a memória de cache KV tornou-se uma restrição central na infraestrutura de IA. A estrutura de quantização “quase ótima e independente de dados” do TurboQuant abre um novo caminho para a inferência eficiente. O Google Research afirmou que essa tecnologia foi detalhada em artigos apresentados na ICLR 2026 e em outras conferências, com o código relacionado e os detalhes de implementação previstos para serem gradualmente disponibilizados como código aberto.
No futuro, espera-se que o TurboQuant seja integrado a estruturas de inferência convencionais, como vLLM e TensorRT, promovendo ainda mais a democratização e a escalabilidade da implantação da IA.
Artigo relacionado
 Dentro dos Detalhes Revelados Sobre o Gemini de Próxima Geração: Poder de Cálculo Sobrecarregado, Equipes Internas Discordaram Sobre Prioridades de Desenvolvimento e Alocação de Recursos
Os relatórios indicam que o lançamento do tão aguardado modelo Gemini de próxima geração do Google foi adiado. Desentendimentos internos sobre prioridades de desenvolvimento e alocação de recursos, combinados com capacidade computacional limitada e p
A OpenAI descarta preocupações com a desaceleração do crescimento e afirma que múltiplas unidades de negócio estão acelerando.
Em resposta à escrutínio externo sobre o desaceleramento do crescimento das vendas e o não cumprimento de metas internas, o líder em inteligência artificial, OpenAI, emitiu uma declaração confiante na terça-feira, 28 de abril. A empresa esclareceu qu
Alibaba Super Cup: Qwen3.8-Max estreia com aprimoramento nas ferramentas de programação e escritório
A Alibaba revelou oficialmente o Qwen3.8-Max, um modelo de base de próxima geração com 2,4 trilhão de parâmetros. Este avanço significativo em IA oferece ganhos substanciais de desempenho em áreas principais, como programação e tarefas profissionais
Recomendações de tópicos especiais relacionados
Composição musical
 Melhores Ferramentas de IA para Criação de Melodias para Rascunhos de Músicas
2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
 8 ferramentas
 xix.ai
chatbot
Melhores ferramentas de treinamento de conversação com IA para prática de entrevistas
As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai
Design e Arte
As melhores ferramentas de transferência de estilo com IA para experimentos criativos
As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai
Criação de quadrinhos
As melhores ferramentas de balões de diálogo com IA para a narrativa visual
As melhores e mais bem avaliadas ferramentas de balões de diálogo com IA para narrativa visual de 2026 já estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que ajudam os criadores a aumentar a produtividade e superar gargalos criativos. Veja uma comparação entre versões gratuitas e pagas, confira testes reais e verifique os rankings mais recentes para encontrar as soluções imperdíveis, perfeitas para criar narrativas visuais envolventes. Explore agora e descubra sua ferramenta ideal!
10 ferramentas
xix.ai
Assistente de Reunião
As melhores ferramentas de resumo de reuniões com IA: acompanhe decisões e ações de acompanhamento com clareza
As melhores e mais bem avaliadas ferramentas de resumo de reuniões com IA de 2026 para um acompanhamento claro das decisões e acompanhamentos sem esforço. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam drasticamente a produtividade ao automatizar notas de reuniões, identificar ações-chave e otimizar a coordenação da equipe em todos os projetos. Veja uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente para ajudá-lo a encontrar a ferramenta perfeita. Explore agora para aproveitar ao máximo as vantagens da IA!
9 ferramentas
xix.ai
Análise de dados
Melhores ferramentas de limpeza de dados com IA: corrija valores faltantes e duplicatas rapidamente
2026 – Os melhores e mais bem avaliados ferramentas de limpeza de dados com IA, atualizadas para corrigir rapidamente valores faltantes e duplicatas. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam significativamente a produtividade. Cada opção passou por testes rigorosos em condições reais para garantir sua confiabilidade. Acesse uma comparação gratuita entre as versões pagas e gratuitas e descubra a ferramenta indispensável que melhor atende às suas necessidades. Explore agora em XIX.AI para aproveitar todos os benefícios oferecidos pela IA.
11 ferramentas
xix.ai

 Comentários (0)
Em 26 de março, o Google Research anunciou o lançamento do TurboQuant, um novo algoritmo de compressão por quantização vetorial que combina as tecnologias PolarQuant e QJL. Essa inovação reduz em pelo menos seis vezes os requisitos de memória do cache de chave-valor (KV Cache) na inferência de grandes modelos de linguagem (LLM). Em GPUs Nvidia H100, ele melhora a velocidade de computação de atenção em até oito vezes, mantendo perda zero de precisão em vários benchmarks de contexto longo. Espera-se que essa inovação reduza os custos de implantação de IA e acelere a adoção de aplicativos de contexto longo.
Desafios do KV Cache: sobrecarga de memória de vetores de alta dimensão
Ao processar sequências longas, os LLMs precisam manter um cache de vetores de chave e valor. Esses vetores de alta dimensão permitem cálculos rápidos do mecanismo de atenção sem computações redundantes. No entanto, à medida que o comprimento do contexto aumenta, o consumo de memória do KV Cache cresce exponencialmente, tornando-se um grande gargalo que limita a eficiência da inferência do modelo e a escala de implantação.
Embora os métodos tradicionais de quantização de vetores possam comprimir dados, eles exigem armazenamento adicional para constantes de quantização, como fatores de escala e pontos zero. Essas constantes são normalmente armazenadas em precisão total, adicionando 1 a 2 bits extras por valor e compensando parcialmente os benefícios da compressão.
Inovação central do TurboQuant: compressão em duas fases com PolarQuant + QJL
O TurboQuant adota uma estrutura de compressão em duas fases, sem necessidade de treinamento, que resolve de forma eficaz a sobrecarga da quantização tradicional:
PolarQuant (Compressão em Coordenadas Polares):
Primeiro, os vetores são girados aleatoriamente; em seguida, as coordenadas cartesianas (X/Y/Z, etc.) são convertidas para a forma polar (ângulo + raio). Como os ângulos se enquadram em um intervalo fixo e previsível, esse método elimina a sobrecarga de armazenamento necessária para a normalização de limites na quantização tradicional, permitindo uma compressão mais eficiente.
QJL (Correção de Erro de 1 bit, Johnson-Lindenstrauss Quantizado):
Após a compressão com PolarQuant, ainda permanecem erros residuais. O QJL utiliza a transformação de Johnson-Lindenstrauss para redução de dimensionalidade e, em seguida, quantiza usando um esquema mínimo de 1 bit (sinal +1/-1). Ao empregar um estimador especial não viesado, ele realiza a correção de erros durante o cálculo da pontuação de atenção sem sobrecarga adicional de memória, garantindo que o processo geral permaneça não viesado.
Combinado, o TurboQuant comprime o cache KV para aproximadamente 3 bits por valor, mantendo a imparcialidade e a alta precisão na estimativa do produto escalar.
Desempenho em testes de benchmark: liderança abrangente, ideal para contextos longos
A equipe do Google realizou uma validação extensa em modelos de código aberto, como o Gemma e o Mistral:
LongBench (abrangendo tarefas como perguntas e respostas com textos longos, geração de código e resumo): o TurboQuant iguala ou supera referências existentes, como o KIVI, demonstrando liderança abrangente.Needle In A Haystack e outras tarefas de recuperação: alcança pontuações perfeitas nas tarefas subsequentes ao comprimir a memória KV em pelo menos seis vezes. Resultados dos testes com a Nvidia H100: com uma configuração de 4 bits, a velocidade de cálculo dos logits de atenção melhora em até oito vezes.Além disso, em conjuntos de dados vetoriais como o GloVe, a taxa de recall do TurboQuant supera métodos tradicionais, como PQ e RabbiQ.
Comentário da AIbase: O TurboQuant não requer retreinamento ou ajuste fino do modelo e pode ser aplicado diretamente a LLMs existentes. É adequado para qualquer cenário que dependa de quantização vetorial, incluindo recuperação de bancos de dados, sistemas de recomendação e mecanismos de busca vetorial. Isso não apenas permite que uma única GPU de nível de consumidor suporte contextos mais longos (por exemplo, dezenas de milhares de tokens), mas também reduz significativamente o limite de hardware para serviços de IA de nível empresarial.
Importância para o setor: um novo padrão de referência para a eficiência da inferência de IA
Com a explosão de aplicações de contexto longo e multimodais, a memória de cache KV tornou-se uma restrição central na infraestrutura de IA. A estrutura de quantização “quase ótima e independente de dados” do TurboQuant abre um novo caminho para a inferência eficiente. O Google Research afirmou que essa tecnologia foi detalhada em artigos apresentados na ICLR 2026 e em outras conferências, com o código relacionado e os detalhes de implementação previstos para serem gradualmente disponibilizados como código aberto.
No futuro, espera-se que o TurboQuant seja integrado a estruturas de inferência convencionais, como vLLM e TensorRT, promovendo ainda mais a democratização e a escalabilidade da implantação da IA.








 Dentro dos Detalhes Revelados Sobre o Gemini de Próxima Geração: Poder de Cálculo Sobrecarregado, Equipes Internas Discordaram Sobre Prioridades de Desenvolvimento e Alocação de Recursos
Os relatórios indicam que o lançamento do tão aguardado modelo Gemini de próxima geração do Google foi adiado. Desentendimentos internos sobre prioridades de desenvolvimento e alocação de recursos, combinados com capacidade computacional limitada e p
 A OpenAI descarta preocupações com a desaceleração do crescimento e afirma que múltiplas unidades de negócio estão acelerando.
Em resposta à escrutínio externo sobre o desaceleramento do crescimento das vendas e o não cumprimento de metas internas, o líder em inteligência artificial, OpenAI, emitiu uma declaração confiante na terça-feira, 28 de abril. A empresa esclareceu qu
 Alibaba Super Cup: Qwen3.8-Max estreia com aprimoramento nas ferramentas de programação e escritório
A Alibaba revelou oficialmente o Qwen3.8-Max, um modelo de base de próxima geração com 2,4 trilhão de parâmetros. Este avanço significativo em IA oferece ganhos substanciais de desempenho em áreas principais, como programação e tarefas profissionais

2026 Últimas Melhores Ferramentas de Escrita de Melodias por IA Mais Bem Avaliadas para Rascunhos de Músicas! A XIX.AI reuniu uma coleção altamente poderosa e transformadora, que passou por rigorosos testes no mundo real para oferecer a melhor experiência de escrita. Você pode encontrar comparações detalhadas entre as versões gratuita e paga, classificações precisas e opções imperdíveis projetadas para ajudá-lo a criar rascunhos de músicas impressionantes sem esforço e aumentar significativamente sua produtividade criativa. Explore agora para descobrir a ferramenta perfeita para você!
8 ferramentas
xix.ai

As melhores ferramentas de treinamento de conversação com IA mais recentes e altamente avaliadas para 2026, ideais para prática de entrevistas, estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e transformadoras, submetidas a rigorosos testes do mundo real para fornecer feedback preciso. Você encontrará uma comparação entre opções gratuitas e pagas, além de classificações detalhadas, para ajudá-lo a escolher a opção imperdível que aumenta sua confiança e habilidades. Explore agora para descobrir a ferramenta perfeita para o sucesso nas entrevistas!
12 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de transferência de estilo com IA de 2026 para experimentos criativos! A XIX.AI selecionou uma coleção poderosa e revolucionária de ferramentas imperdíveis, que oferecem resultados excepcionais por meio de testes reais e classificações rigorosas. Essas soluções de ponta ajudam os profissionais criativos a aumentar significativamente a produtividade, acelerando a criação de conteúdo e revelando possibilidades criativas infinitas. Explore agora para descobrir a ferramenta perfeita para você e comece a criar hoje mesmo!
9 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de balões de diálogo com IA para narrativa visual de 2026 já estão disponíveis no XIX.AI! Esta coleção selecionada apresenta ferramentas poderosas e revolucionárias que ajudam os criadores a aumentar a produtividade e superar gargalos criativos. Veja uma comparação entre versões gratuitas e pagas, confira testes reais e verifique os rankings mais recentes para encontrar as soluções imperdíveis, perfeitas para criar narrativas visuais envolventes. Explore agora e descubra sua ferramenta ideal!
10 ferramentas
xix.ai

As melhores e mais bem avaliadas ferramentas de resumo de reuniões com IA de 2026 para um acompanhamento claro das decisões e acompanhamentos sem esforço. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam drasticamente a produtividade ao automatizar notas de reuniões, identificar ações-chave e otimizar a coordenação da equipe em todos os projetos. Veja uma comparação entre versões gratuitas e pagas, além de testes práticos e rankings atualizados semanalmente para ajudá-lo a encontrar a ferramenta perfeita. Explore agora para aproveitar ao máximo as vantagens da IA!
9 ferramentas
xix.ai

2026 – Os melhores e mais bem avaliados ferramentas de limpeza de dados com IA, atualizadas para corrigir rapidamente valores faltantes e duplicatas. Esta lista selecionada apresenta soluções poderosas e revolucionárias que aumentam significativamente a produtividade. Cada opção passou por testes rigorosos em condições reais para garantir sua confiabilidade. Acesse uma comparação gratuita entre as versões pagas e gratuitas e descubra a ferramenta indispensável que melhor atende às suas necessidades. Explore agora em XIX.AI para aproveitar todos os benefícios oferecidos pela IA.
11 ferramentas
xix.ai












