


 Heim
Google TurboQuant komprimiert den LLM-Cache um das Sechsfache, steigert die Geschwindigkeit um das Achtfache – ganz ohne Training und ohne Präzisionsverlust
Am 26. März kündigte Google Research die Einführung von TurboQuant an, einem neuen Kompressionsalgorithmus auf Basis der Vektorquantisierung, der die Technologien PolarQuant und QJL kombiniert. Diese Innovation reduziert den Speicherbedarf des Key-Value-Caches (KV-Cache) bei der Inferenz großer Sprachmodelle (LLM) um mindestens das Sechsfache. Auf Nvidia H100-GPUs verbessert er die Rechengeschwindigkeit bei Attention-Berechnungen um das bis zu Achtfache, ohne dass es dabei in mehreren Benchmarks mit langen Kontexten zu Präzisionsverlusten kommt. Dieser Durchbruch dürfte die Kosten für den Einsatz von KI senken und die Einführung von Anwendungen mit langen Kontexten beschleunigen.
Schwachstellen des KV-Caches: Speicher-Overhead durch hochdimensionale Vektoren
Bei der Verarbeitung langer Sequenzen müssen LLMs einen Cache aus Schlüssel- und Wertvektoren vorhalten. Diese hochdimensionalen Vektoren ermöglichen schnelle Berechnungen des Attention-Mechanismus ohne redundante Rechenoperationen. Mit zunehmender Kontextlänge steigt der Speicherverbrauch des KV-Caches jedoch exponentiell an und wird zu einem erheblichen Engpass, der die Effizienz der Modellinferenz und den Umfang der Bereitstellung einschränkt.
Zwar können herkömmliche Vektorquantisierungsmethoden Daten komprimieren, doch benötigen sie zusätzlichen Speicherplatz für Quantisierungskonstanten wie Skalierungsfaktoren und Nullpunkte. Diese Konstanten werden in der Regel in voller Präzision gespeichert, was pro Wert zusätzliche 1–2 Bit erfordert und die Vorteile der Komprimierung teilweise zunichte macht.
Kerninnovation von TurboQuant: Zweiphasen-Komprimierung mit PolarQuant + QJL
TurboQuant nutzt ein zweiphasiges, trainingsfreies Komprimierungsframework, das den Overhead herkömmlicher Quantisierung effektiv beseitigt:
PolarQuant (Komprimierung in Polarkoordinaten):
Zunächst werden Vektoren zufällig gedreht, anschließend werden kartesische Koordinaten (X/Y/Z usw.) in die Polarkoordinatenform (Winkel + Radius) umgewandelt. Da die Winkel innerhalb eines festen, vorhersehbaren Bereichs liegen, entfällt bei dieser Methode der Speicheraufwand, der bei der herkömmlichen Quantisierung für die Grenzwertnormalisierung erforderlich ist, was eine effizientere Komprimierung ermöglicht.
QJL (1-Bit-Fehlerkorrektur, quantisiertes Johnson-Lindenstrauss-Verfahren):
Nach der PolarQuant-Komprimierung bleiben Restfehler bestehen. QJL nutzt die Johnson-Lindenstrauss-Transformation zur Dimensionsreduktion und quantisiert anschließend mit einem minimalen 1-Bit-Schema (+1/-1 Vorzeichen). Durch den Einsatz eines speziellen unverzerrten Schätzers wird eine Fehlerkorrektur bei der Berechnung des Aufmerksamkeitswerts ohne zusätzlichen Speicheraufwand erreicht, wodurch sichergestellt wird, dass der gesamte Prozess unverzerrt bleibt.
Insgesamt komprimiert TurboQuant den KV-Cache auf etwa 3 Bit pro Wert und gewährleistet dabei Unverzerrtheit sowie hohe Genauigkeit bei der Schätzung des Skalarprodukts.
Leistung im Benchmark-Test: Umfassende Führungsposition, ideal für lange Kontexte
Das Google-Team führte umfangreiche Validierungen an Open-Source-Modellen wie Gemma und Mistral durch:
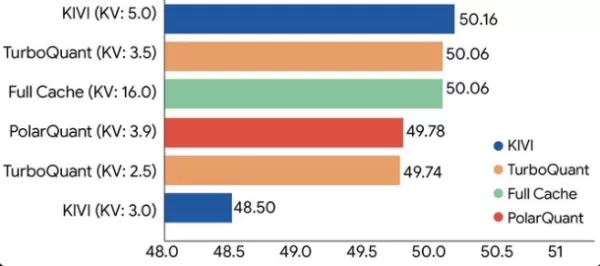
LongBench (mit Aufgaben wie Fragen und Antworten zu langen Texten, Codegenerierung und Zusammenfassung): TurboQuant erreicht oder übertrifft bestehende Baseline-Modelle wie KIVI und demonstriert damit umfassende Führungsposition.„Needle In A Haystack“ und andere Retrieval-Aufgaben: Erzielt perfekte Downstream-Ergebnisse bei einer mindestens sechsfachen Komprimierung des KV-Speichers. Nvidia H100-Testergebnisse: Bei einer 4-Bit-Konfiguration verbessert sich die Rechengeschwindigkeit für Attention-Logits um das bis zu Achtfache.Zudem übertrifft die Recall-Rate von TurboQuant bei Vektordatensätzen wie GloVe herkömmliche Methoden wie PQ und RabbiQ.
Kommentar von AIbase: TurboQuant erfordert kein erneutes Training oder Feintuning des Modells und kann direkt auf bestehende LLMs angewendet werden. Es eignet sich für jedes Szenario, das auf Vektorquantisierung basiert, einschließlich Datenbankabfrage, Empfehlungssysteme und Vektorsuchmaschinen. Dies ermöglicht nicht nur, dass eine einzige GPU für Endverbraucher längere Kontexte (z. B. Zehntausende von Tokens) verarbeiten kann, sondern senkt auch die Hardware-Hürde für KI-Dienste auf Unternehmensebene erheblich.
Bedeutung für die Branche: Ein neuer Maßstab für die Effizienz der KI-Inferenz
Angesichts der explosionsartigen Zunahme von Anwendungen mit langen Kontexten und multimodalen Anwendungen ist der KV-Cache-Speicher zu einer zentralen Einschränkung in der KI-Infrastruktur geworden. Das „nahezu optimale, datenunabhängige“ Quantisierungs-Framework von TurboQuant eröffnet einen neuen Weg für effiziente Inferenz. Google Research gab bekannt, dass diese Technologie in Beiträgen auf der ICLR 2026 und anderen Konferenzen ausführlich beschrieben wurde; der zugehörige Code und die Implementierungsdetails sollen nach und nach als Open Source veröffentlicht werden.
Es wird erwartet, dass TurboQuant künftig in gängige Inferenz-Frameworks wie vLLM und TensorRT integriert wird, was die Demokratisierung und Skalierbarkeit des KI-Einsatzes weiter vorantreiben wird.
Verwandter Artikel
 Apple Smart Glasses könnten auf der WWDC27 vorgestellt werden und dabei den Schutz der Privatsphäre in den Mittelpunkt stellen
Bloombergs Mark Gurman berichtet, dass Apples Smart Glasses mit dem Codenamen N50 im Juni 2027 auf der WWDC27 vorgestellt werden sollen, wobei ein Verkaufsstart im Herbst 2027 erwartet wird. Ursprünglich für Ende dieses Jahres und Anfang 2027 geplant
Inside Details Exposed About Next-Gen Gemini: Strained Computing Power, Internal Teams Disagreed on Development Priorities and Resource Allocation
Berichten zufolge wurde der Start des hocherwarteten Next-Generation-Gemini-Modells von Google verschoben. Interne Uneinigkeiten über Entwicklungsprioritäten und Ressourcenallokation, kombiniert mit begrenzter Rechenkapazität und komplexen Genehmigun
OpenAI entkräftet Bedenken bezüglich des verlangsamen Wachstums und erklärt, dass mehrere Geschäftsbereiche ihre Expansion beschleunigen
Als Reaktion auf externe Kritik bezüglich des nachlassenden Umsatzwachstums und verpasster interner Zielvorgaben gab der KI-Pionier OpenAI am Dienstag, den 28. April, eine selbstbewusste Erklärung ab. Das Unternehmen präzisierte, dass seine Verbrauch
Empfehlungen zu verwandten Spezialthemen
Musikkomposition
 Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
 8 Tools
 xix.ai
Chatbot
Die besten KI-gestützten Gesprächstrainingstools für Vorstellungsgesprächspraxis
2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai
Design & Kunst
Die besten KI-Tools für den Stiltransfer für kreative Experimente
Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai
Comic-Erstellung
Die besten KI-Tools für Sprechblasen zum visuellen Geschichtenerzählen
Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai
Besprechungsassistent
Die besten Tools zur Zusammenfassung von KI-Meetings: Entscheidungen und Folgemaßnahmen übersichtlich nachverfolgen
Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai
Datenanalyse
Die besten Tools für die KI-gestützte Datenreinigung: Fehlende Werte und Duplikate schnell beheben
2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai

 Kommentare (0)
Am 26. März kündigte Google Research die Einführung von TurboQuant an, einem neuen Kompressionsalgorithmus auf Basis der Vektorquantisierung, der die Technologien PolarQuant und QJL kombiniert. Diese Innovation reduziert den Speicherbedarf des Key-Value-Caches (KV-Cache) bei der Inferenz großer Sprachmodelle (LLM) um mindestens das Sechsfache. Auf Nvidia H100-GPUs verbessert er die Rechengeschwindigkeit bei Attention-Berechnungen um das bis zu Achtfache, ohne dass es dabei in mehreren Benchmarks mit langen Kontexten zu Präzisionsverlusten kommt. Dieser Durchbruch dürfte die Kosten für den Einsatz von KI senken und die Einführung von Anwendungen mit langen Kontexten beschleunigen.
Schwachstellen des KV-Caches: Speicher-Overhead durch hochdimensionale Vektoren
Bei der Verarbeitung langer Sequenzen müssen LLMs einen Cache aus Schlüssel- und Wertvektoren vorhalten. Diese hochdimensionalen Vektoren ermöglichen schnelle Berechnungen des Attention-Mechanismus ohne redundante Rechenoperationen. Mit zunehmender Kontextlänge steigt der Speicherverbrauch des KV-Caches jedoch exponentiell an und wird zu einem erheblichen Engpass, der die Effizienz der Modellinferenz und den Umfang der Bereitstellung einschränkt.
Zwar können herkömmliche Vektorquantisierungsmethoden Daten komprimieren, doch benötigen sie zusätzlichen Speicherplatz für Quantisierungskonstanten wie Skalierungsfaktoren und Nullpunkte. Diese Konstanten werden in der Regel in voller Präzision gespeichert, was pro Wert zusätzliche 1–2 Bit erfordert und die Vorteile der Komprimierung teilweise zunichte macht.
Kerninnovation von TurboQuant: Zweiphasen-Komprimierung mit PolarQuant + QJL
TurboQuant nutzt ein zweiphasiges, trainingsfreies Komprimierungsframework, das den Overhead herkömmlicher Quantisierung effektiv beseitigt:
PolarQuant (Komprimierung in Polarkoordinaten):
Zunächst werden Vektoren zufällig gedreht, anschließend werden kartesische Koordinaten (X/Y/Z usw.) in die Polarkoordinatenform (Winkel + Radius) umgewandelt. Da die Winkel innerhalb eines festen, vorhersehbaren Bereichs liegen, entfällt bei dieser Methode der Speicheraufwand, der bei der herkömmlichen Quantisierung für die Grenzwertnormalisierung erforderlich ist, was eine effizientere Komprimierung ermöglicht.
QJL (1-Bit-Fehlerkorrektur, quantisiertes Johnson-Lindenstrauss-Verfahren):
Nach der PolarQuant-Komprimierung bleiben Restfehler bestehen. QJL nutzt die Johnson-Lindenstrauss-Transformation zur Dimensionsreduktion und quantisiert anschließend mit einem minimalen 1-Bit-Schema (+1/-1 Vorzeichen). Durch den Einsatz eines speziellen unverzerrten Schätzers wird eine Fehlerkorrektur bei der Berechnung des Aufmerksamkeitswerts ohne zusätzlichen Speicheraufwand erreicht, wodurch sichergestellt wird, dass der gesamte Prozess unverzerrt bleibt.
Insgesamt komprimiert TurboQuant den KV-Cache auf etwa 3 Bit pro Wert und gewährleistet dabei Unverzerrtheit sowie hohe Genauigkeit bei der Schätzung des Skalarprodukts.
Leistung im Benchmark-Test: Umfassende Führungsposition, ideal für lange Kontexte
Das Google-Team führte umfangreiche Validierungen an Open-Source-Modellen wie Gemma und Mistral durch:
LongBench (mit Aufgaben wie Fragen und Antworten zu langen Texten, Codegenerierung und Zusammenfassung): TurboQuant erreicht oder übertrifft bestehende Baseline-Modelle wie KIVI und demonstriert damit umfassende Führungsposition.„Needle In A Haystack“ und andere Retrieval-Aufgaben: Erzielt perfekte Downstream-Ergebnisse bei einer mindestens sechsfachen Komprimierung des KV-Speichers. Nvidia H100-Testergebnisse: Bei einer 4-Bit-Konfiguration verbessert sich die Rechengeschwindigkeit für Attention-Logits um das bis zu Achtfache.Zudem übertrifft die Recall-Rate von TurboQuant bei Vektordatensätzen wie GloVe herkömmliche Methoden wie PQ und RabbiQ.
Kommentar von AIbase: TurboQuant erfordert kein erneutes Training oder Feintuning des Modells und kann direkt auf bestehende LLMs angewendet werden. Es eignet sich für jedes Szenario, das auf Vektorquantisierung basiert, einschließlich Datenbankabfrage, Empfehlungssysteme und Vektorsuchmaschinen. Dies ermöglicht nicht nur, dass eine einzige GPU für Endverbraucher längere Kontexte (z. B. Zehntausende von Tokens) verarbeiten kann, sondern senkt auch die Hardware-Hürde für KI-Dienste auf Unternehmensebene erheblich.
Bedeutung für die Branche: Ein neuer Maßstab für die Effizienz der KI-Inferenz
Angesichts der explosionsartigen Zunahme von Anwendungen mit langen Kontexten und multimodalen Anwendungen ist der KV-Cache-Speicher zu einer zentralen Einschränkung in der KI-Infrastruktur geworden. Das „nahezu optimale, datenunabhängige“ Quantisierungs-Framework von TurboQuant eröffnet einen neuen Weg für effiziente Inferenz. Google Research gab bekannt, dass diese Technologie in Beiträgen auf der ICLR 2026 und anderen Konferenzen ausführlich beschrieben wurde; der zugehörige Code und die Implementierungsdetails sollen nach und nach als Open Source veröffentlicht werden.
Es wird erwartet, dass TurboQuant künftig in gängige Inferenz-Frameworks wie vLLM und TensorRT integriert wird, was die Demokratisierung und Skalierbarkeit des KI-Einsatzes weiter vorantreiben wird.








 Apple Smart Glasses könnten auf der WWDC27 vorgestellt werden und dabei den Schutz der Privatsphäre in den Mittelpunkt stellen
Bloombergs Mark Gurman berichtet, dass Apples Smart Glasses mit dem Codenamen N50 im Juni 2027 auf der WWDC27 vorgestellt werden sollen, wobei ein Verkaufsstart im Herbst 2027 erwartet wird. Ursprünglich für Ende dieses Jahres und Anfang 2027 geplant
 Inside Details Exposed About Next-Gen Gemini: Strained Computing Power, Internal Teams Disagreed on Development Priorities and Resource Allocation
Berichten zufolge wurde der Start des hocherwarteten Next-Generation-Gemini-Modells von Google verschoben. Interne Uneinigkeiten über Entwicklungsprioritäten und Ressourcenallokation, kombiniert mit begrenzter Rechenkapazität und komplexen Genehmigun
 OpenAI entkräftet Bedenken bezüglich des verlangsamen Wachstums und erklärt, dass mehrere Geschäftsbereiche ihre Expansion beschleunigen
Als Reaktion auf externe Kritik bezüglich des nachlassenden Umsatzwachstums und verpasster interner Zielvorgaben gab der KI-Pionier OpenAI am Dienstag, den 28. April, eine selbstbewusste Erklärung ab. Das Unternehmen präzisierte, dass seine Verbrauch

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai












