


 Дом
Google TurboQuant в 6 раз сжимает кэш LLM, в 8 раз повышает скорость, не требует обучения и не приводит к потере точности
26 марта подразделение Google Research объявило о запуске TurboQuant — нового алгоритма сжатия на основе векторной квантизации, сочетающего в себе технологии PolarQuant и QJL. Эта инновация позволяет как минимум в шесть раз снизить требования к объему памяти, необходимому для кэша «ключ-значение» (KV Cache) при инференсе крупных языковых моделей (LLM). На графических процессорах Nvidia H100 он повышает скорость вычисления внимания (attention) до восьми раз, сохраняя при этом нулевую потерю точности в нескольких тестах с длинным контекстом. Ожидается, что этот прорыв снизит затраты на внедрение ИИ и ускорит распространение приложений с длинным контекстом.
Проблемы кэша «ключ-значение»: накладные расходы на память для высокоразмерных векторов
При обработке длинных последовательностей LLM должны поддерживать кэш векторов ключей и значений. Эти высокоразмерные векторы обеспечивают быстрые вычисления механизма внимания без избыточных вычислений. Однако по мере увеличения длины контекста потребление памяти KV Cache растет экспоненциально, становясь основным узким местом, ограничивающим эффективность инференса модели и масштаб внедрения.
Хотя традиционные методы векторной квантования позволяют сжимать данные, они требуют дополнительного места для хранения констант квантования, таких как коэффициенты масштабирования и нулевые точки. Эти константы обычно хранятся с полной точностью, что добавляет 1–2 бита на каждое значение и частично нивелирует преимущества сжатия.
Основная инновация TurboQuant: двухфазное сжатие с использованием PolarQuant + QJL
TurboQuant использует двухфазную архитектуру сжатия, не требующую обучения, которая эффективно устраняет накладные расходы, связанные с традиционным квантованием:
PolarQuant (сжатие в полярных координатах):
Сначала векторы подвергаются случайному повороту, затем декартовы координаты (X/Y/Z и т. д.) преобразуются в полярную форму (угол + радиус). Поскольку углы находятся в фиксированном, предсказуемом диапазоне, этот метод устраняет накладные расходы на хранение, необходимые для нормализации границ при традиционном квантовании, что позволяет обеспечить более эффективное сжатие.
QJL (1-битное исправление ошибок, квантованный алгоритм Джонсона-Линденстрауса):
После сжатия с помощью PolarQuant остаются остаточные ошибки. QJL использует преобразование Джонсона-Линденстрауса для уменьшения размерности, а затем квантует с помощью минимальной 1-битовой схемы (знак +1/-1). Благодаря применению специальной несмещённой оценки метод обеспечивает коррекцию ошибок при вычислении оценки внимания без дополнительных затрат памяти, гарантируя, что весь процесс остаётся несмещённым.
В совокупности TurboQuant сжимает кэш KV примерно до 3 битов на значение, сохраняя при этом несмещенность и высокую точность оценки внутреннего произведения.
Результаты тестирования: всестороннее лидерство, идеально подходит для длинных контекстов
Команда Google провела обширную валидацию на моделях с открытым исходным кодом, таких как Gemma и Mistral:
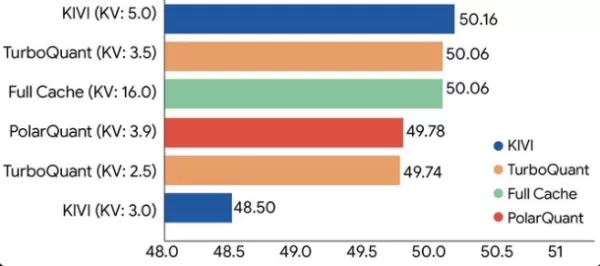
LongBench (охватывающий такие задачи, как вопросы и ответы с длинными текстами, генерация кода и резюмирование): TurboQuant соответствует или превосходит существующие базовые модели, такие как KIVI, демонстрируя всестороннее лидерство.«Игла в стоге сена» и другие задачи поиска: достигает идеальных результатов на последующих этапах обработки, одновременно сжимая память KV как минимум в шесть раз. Результаты тестирования на Nvidia H100: при 4-битовой конфигурации скорость вычисления логитов внимания повышается до восьми раз.Кроме того, на векторных наборах данных, таких как GloVe, коэффициент восстановления TurboQuant превосходит традиционные методы, такие как PQ и RabbiQ.
Комментарий AIbase: TurboQuant не требует переобучения или тонкой настройки модели и может напрямую применяться к существующим LLM. Он подходит для любых сценариев, основанных на векторном квантовании, включая поиск в базах данных, системы рекомендаций и векторные поисковые системы. Это не только позволяет одному графическому процессору потребительского уровня обрабатывать более длинные контексты (например, десятки тысяч токенов), но и значительно снижает аппаратный порог для ИИ-сервисов корпоративного уровня.
Значение для отрасли: новый эталон эффективности инференции ИИ
С бурным ростом числа приложений с длинными контекстами и мультимодальных приложений память кэша «ключ-значение» (KV Cache) стала основным ограничивающим фактором в инфраструктуре ИИ. «Почти оптимальная, независимая от данных» архитектура квантования TurboQuant открывает новый путь к эффективному вычислению. Google Research сообщила, что эта технология подробно описана в статьях, представленных на конференции ICLR 2026 и других мероприятиях, а соответствующий код и детали реализации, как ожидается, будут постепенно переведены в открытый доступ.
Ожидается, что в будущем TurboQuant будет интегрирован в основные фреймворки для вычислений, такие как vLLM и TensorRT, что еще больше будет способствовать демократизации и масштабируемости внедрения ИИ.
Связанная статья
 Умные очки Apple могут быть представлены на WWDC27 с акцентом на защиту конфиденциальности
Журналист Bloomberg Марк Гурман сообщает, что умные очки Apple под кодовым названием N50 должны дебютировать на WWDC27 в июне 2027 года, а их розничные продажи ожидаются осенью 2027 года. Изначально выпуск устройства планировался на конец этого года
Внутри раскрыты подробности о Gemini следующего поколения: ограниченные вычислительные мощности, внутренние команды не сошлись в вопросах приоритетов разработки и распределения ресурсов
В отчётах указывается, что запуск долгожданной модели Gemini следующего поколения от Google был перенесён. Внутренние разногласия по вопросам приоритетов разработки и распределения ресурсов, в сочетании с ограниченной вычислительной мощностью и сложн
OpenAI отклоняет опасения по поводу замедления роста, заявляя о ускорении работы нескольких бизнес-подразделений
В ответ на внешнюю критику, связанную с замедлением роста продаж и невыполнением внутренних плановых показателей, лидер в области искусственного интеллекта компания OpenAI опубликовала во вторник, 28 апреля, уверенное заявление. Компания уточнила, чт
Рекомендации по связанным специальным темам
Анализ данных
 ИИ-копилоты для SQL, предназначенные для создания панелей управления доходами, анализа воронки продаж и отслеживания показателей продуктов.
2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
 9 инструментов
 xix.ai
Музыкальная композиция
Лучшие инструменты для написания мелодий с помощью ИИ для черновиков песен
2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai
чат-бот
Лучшие инструменты для тренировки разговоров с помощью ИИ для подготовки к собеседованиям
2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai
Дизайн и искусство
Лучшие инструменты для переноса стилей с помощью ИИ для творческих экспериментов
2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai
Создание комиксов
Лучшие инструменты для создания диалоговых пузырей с помощью ИИ для визуального повествования
2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai
Помощник по встречам
Лучшие инструменты для составления отчетов о встречах с использованием ИИ: четкое отслеживание решений и последующих действий
2026: Последние версии лучших инструментов для составления отчетов о встречах с помощью ИИ, обеспечивающих четкое отслеживание решений и удобное выполнение последующих действий. В этом тщательно подобранном списке представлены мощные, революционные решения, которые значительно повышают продуктивность за счет автоматизации ведения протоколов встреч, выявления ключевых задач и оптимизации координации работы команды по всем проектам. Получите сравнение бесплатных и платных версий, а также результаты реальных тестов и еженедельно обновляемые рейтинги, которые помогут вам найти идеальный инструмент. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть потенциал искусственного интеллекта!
9 инструментов
xix.ai

 Комментарии (0)
26 марта подразделение Google Research объявило о запуске TurboQuant — нового алгоритма сжатия на основе векторной квантизации, сочетающего в себе технологии PolarQuant и QJL. Эта инновация позволяет как минимум в шесть раз снизить требования к объему памяти, необходимому для кэша «ключ-значение» (KV Cache) при инференсе крупных языковых моделей (LLM). На графических процессорах Nvidia H100 он повышает скорость вычисления внимания (attention) до восьми раз, сохраняя при этом нулевую потерю точности в нескольких тестах с длинным контекстом. Ожидается, что этот прорыв снизит затраты на внедрение ИИ и ускорит распространение приложений с длинным контекстом.
Проблемы кэша «ключ-значение»: накладные расходы на память для высокоразмерных векторов
При обработке длинных последовательностей LLM должны поддерживать кэш векторов ключей и значений. Эти высокоразмерные векторы обеспечивают быстрые вычисления механизма внимания без избыточных вычислений. Однако по мере увеличения длины контекста потребление памяти KV Cache растет экспоненциально, становясь основным узким местом, ограничивающим эффективность инференса модели и масштаб внедрения.
Хотя традиционные методы векторной квантования позволяют сжимать данные, они требуют дополнительного места для хранения констант квантования, таких как коэффициенты масштабирования и нулевые точки. Эти константы обычно хранятся с полной точностью, что добавляет 1–2 бита на каждое значение и частично нивелирует преимущества сжатия.
Основная инновация TurboQuant: двухфазное сжатие с использованием PolarQuant + QJL
TurboQuant использует двухфазную архитектуру сжатия, не требующую обучения, которая эффективно устраняет накладные расходы, связанные с традиционным квантованием:
PolarQuant (сжатие в полярных координатах):
Сначала векторы подвергаются случайному повороту, затем декартовы координаты (X/Y/Z и т. д.) преобразуются в полярную форму (угол + радиус). Поскольку углы находятся в фиксированном, предсказуемом диапазоне, этот метод устраняет накладные расходы на хранение, необходимые для нормализации границ при традиционном квантовании, что позволяет обеспечить более эффективное сжатие.
QJL (1-битное исправление ошибок, квантованный алгоритм Джонсона-Линденстрауса):
После сжатия с помощью PolarQuant остаются остаточные ошибки. QJL использует преобразование Джонсона-Линденстрауса для уменьшения размерности, а затем квантует с помощью минимальной 1-битовой схемы (знак +1/-1). Благодаря применению специальной несмещённой оценки метод обеспечивает коррекцию ошибок при вычислении оценки внимания без дополнительных затрат памяти, гарантируя, что весь процесс остаётся несмещённым.
В совокупности TurboQuant сжимает кэш KV примерно до 3 битов на значение, сохраняя при этом несмещенность и высокую точность оценки внутреннего произведения.
Результаты тестирования: всестороннее лидерство, идеально подходит для длинных контекстов
Команда Google провела обширную валидацию на моделях с открытым исходным кодом, таких как Gemma и Mistral:
LongBench (охватывающий такие задачи, как вопросы и ответы с длинными текстами, генерация кода и резюмирование): TurboQuant соответствует или превосходит существующие базовые модели, такие как KIVI, демонстрируя всестороннее лидерство.«Игла в стоге сена» и другие задачи поиска: достигает идеальных результатов на последующих этапах обработки, одновременно сжимая память KV как минимум в шесть раз. Результаты тестирования на Nvidia H100: при 4-битовой конфигурации скорость вычисления логитов внимания повышается до восьми раз.Кроме того, на векторных наборах данных, таких как GloVe, коэффициент восстановления TurboQuant превосходит традиционные методы, такие как PQ и RabbiQ.
Комментарий AIbase: TurboQuant не требует переобучения или тонкой настройки модели и может напрямую применяться к существующим LLM. Он подходит для любых сценариев, основанных на векторном квантовании, включая поиск в базах данных, системы рекомендаций и векторные поисковые системы. Это не только позволяет одному графическому процессору потребительского уровня обрабатывать более длинные контексты (например, десятки тысяч токенов), но и значительно снижает аппаратный порог для ИИ-сервисов корпоративного уровня.
Значение для отрасли: новый эталон эффективности инференции ИИ
С бурным ростом числа приложений с длинными контекстами и мультимодальных приложений память кэша «ключ-значение» (KV Cache) стала основным ограничивающим фактором в инфраструктуре ИИ. «Почти оптимальная, независимая от данных» архитектура квантования TurboQuant открывает новый путь к эффективному вычислению. Google Research сообщила, что эта технология подробно описана в статьях, представленных на конференции ICLR 2026 и других мероприятиях, а соответствующий код и детали реализации, как ожидается, будут постепенно переведены в открытый доступ.
Ожидается, что в будущем TurboQuant будет интегрирован в основные фреймворки для вычислений, такие как vLLM и TensorRT, что еще больше будет способствовать демократизации и масштабируемости внедрения ИИ.








 Умные очки Apple могут быть представлены на WWDC27 с акцентом на защиту конфиденциальности
Журналист Bloomberg Марк Гурман сообщает, что умные очки Apple под кодовым названием N50 должны дебютировать на WWDC27 в июне 2027 года, а их розничные продажи ожидаются осенью 2027 года. Изначально выпуск устройства планировался на конец этого года
 Внутри раскрыты подробности о Gemini следующего поколения: ограниченные вычислительные мощности, внутренние команды не сошлись в вопросах приоритетов разработки и распределения ресурсов
В отчётах указывается, что запуск долгожданной модели Gemini следующего поколения от Google был перенесён. Внутренние разногласия по вопросам приоритетов разработки и распределения ресурсов, в сочетании с ограниченной вычислительной мощностью и сложн
 OpenAI отклоняет опасения по поводу замедления роста, заявляя о ускорении работы нескольких бизнес-подразделений
В ответ на внешнюю критику, связанную с замедлением роста продаж и невыполнением внутренних плановых показателей, лидер в области искусственного интеллекта компания OpenAI опубликовала во вторник, 28 апреля, уверенное заявление. Компания уточнила, чт

2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai

2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai

2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai

2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai

2026: Последние версии лучших инструментов для составления отчетов о встречах с помощью ИИ, обеспечивающих четкое отслеживание решений и удобное выполнение последующих действий. В этом тщательно подобранном списке представлены мощные, революционные решения, которые значительно повышают продуктивность за счет автоматизации ведения протоколов встреч, выявления ключевых задач и оптимизации координации работы команды по всем проектам. Получите сравнение бесплатных и платных версий, а также результаты реальных тестов и еженедельно обновляемые рейтинги, которые помогут вам найти идеальный инструмент. Ознакомьтесь с ними прямо сейчас, чтобы раскрыть потенциал искусственного интеллекта!
9 инструментов
xix.ai












