


 Heim
Meta verteidigt LLAMA 4 Release, zitiert Fehler als Ursache für Berichte mit gemischter Qualität
Am Wochenende überraschte Meta, das Kraftpaket hinter Facebook, Instagram, WhatsApp und Quest VR, alle mit der Vorstellung ihres neuesten KI-Sprachmodells, Llama 4. Nicht nur eines, sondern drei neue Versionen wurden eingeführt, jede mit verbesserten Fähigkeiten dank der "Mixture-of-Experts"-Architektur und einem neuartigen Trainingsansatz namens MetaP, der feste Hyperparameter verwendet. Darüber hinaus verfügen alle drei Modelle über erweiterte Kontextfenster, die es ihnen ermöglichen, mehr Informationen in einer einzigen Interaktion zu verarbeiten.
Trotz der Aufregung um die Veröffentlichung war die Reaktion der KI-Community bestenfalls verhalten. Am Samstag stellte Meta zwei dieser Modelle, Llama 4 Scout und Llama 4 Maverick, zum Download und zur Nutzung bereit, aber die Resonanz war alles andere als enthusiastisch.
Llama 4 löst Verwirrung und Kritik unter KI-Nutzern aus
Ein unbestätigter Beitrag im 1point3acres-Forum, einer beliebten chinesischsprachigen Community in Nordamerika, fand seinen Weg in das r/LocalLlama-Subreddit auf Reddit. Der Beitrag, angeblich von einem Forscher der GenAI-Organisation von Meta, behauptete, dass Llama 4 bei internen Benchmarks von Drittanbietern schlecht abgeschnitten habe. Es wurde angedeutet, dass die Führung von Meta die Ergebnisse manipuliert habe, indem sie Testsets während des Post-Trainings vermischte, um verschiedene Metriken zu erfüllen und ein positives Ergebnis zu präsentieren. Die Authentizität dieser Behauptung wurde mit Skepsis aufgenommen, und Meta hat bisher nicht auf Anfragen von VentureBeat reagiert.
Doch die Zweifel an der Leistung von Llama 4 hörten damit nicht auf. Auf X äußerte der Nutzer @cto_junior Unglauben über die Leistung des Modells und verwies auf einen unabhängigen Test, bei dem Llama 4 Maverick im aider-Polyglot-Benchmark, der Programmieraufgaben testet, nur 16 % erreichte. Dieser Wert liegt deutlich unter dem älterer, ähnlich großer Modelle wie DeepSeek V3 und Claude 3.7 Sonnet.
KI-Doktor und Autor Andriy Burkov nutzte ebenfalls X, um das beworbene 10-Millionen-Token-Kontextfenster von Llama 4 Scout in Frage zu stellen und erklärte, es sei "virtuell", da das Modell nicht mit Prompts trainiert wurde, die länger als 256k Token sind. Er warnte, dass längere Prompts wahrscheinlich zu minderwertigen Ergebnissen führen würden.
Im r/LocalLlama-Subreddit äußerte der Nutzer Dr_Karminski Enttäuschung über Llama 4 und verglich dessen schlechte Leistung mit dem nicht-räsonierenden V3-Modell von DeepSeek bei Aufgaben wie der Simulation von Ballbewegungen in einem Heptagon.
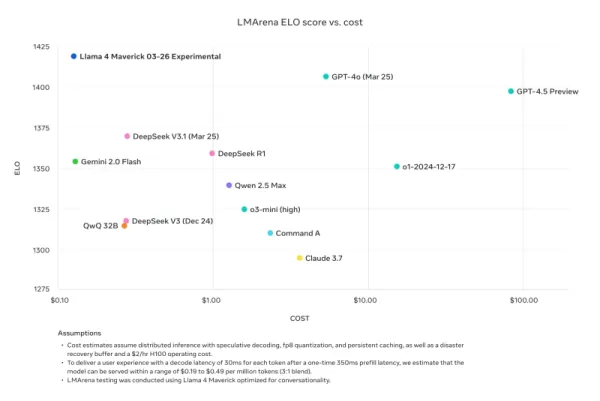
Nathan Lambert, ein ehemaliger Meta-Forscher und aktueller Senior Research Scientist bei AI2, kritisierte Metas Benchmark-Vergleiche in seinem Interconnects-Substack-Blog. Er wies darauf hin, dass das in Metas Werbematerialien verwendete Llama 4 Maverick-Modell nicht dasselbe war wie das öffentlich freigegebene, sondern für Konversation optimiert wurde. Lambert bemerkte den Widerspruch und sagte: „Hinterlistig. Die untenstehenden Ergebnisse sind gefälscht, und es ist ein großer Affront gegen die Community von Meta, nicht das Modell zu veröffentlichen, das sie für ihre große Marketingkampagne verwendet haben.“ Er fügte hinzu, dass das beworbene Modell „den technischen Ruf der Veröffentlichung ruiniert, weil sein Charakter jugendlich ist“, während das tatsächlich auf anderen Plattformen verfügbare Modell „ziemlich klug ist und einen angemessenen Ton hat“.
Meta reagiert, bestreitet „Training mit Testsets“ und verweist auf Fehler in der Implementierung aufgrund der schnellen Einführung
Als Reaktion auf die Kritik und Anschuldigungen ging Ahmad Al-Dahle, Vizepräsident und Leiter von GenAI bei Meta, auf X, um die Bedenken anzusprechen. Er zeigte sich begeistert von der Beteiligung der Community an Llama 4, räumte jedoch Berichte über uneinheitliche Qualität bei verschiedenen Diensten ein. Er führte diese Probleme auf die schnelle Einführung und die Zeit zurück, die für die Stabilisierung öffentlicher Implementierungen benötigt wird. Al-Dahle wies die Vorwürfe des Trainings mit Testsets entschieden zurück und betonte, dass die variable Qualität auf Implementierungsfehler und nicht auf Fehlverhalten zurückzuführen sei. Er bekräftigte Metas Glauben an die bedeutenden Fortschritte der Llama 4-Modelle und ihr Engagement, mit der Community zusammenzuarbeiten, um ihr Potenzial zu verwirklichen.
Die Antwort konnte die Frustrationen der Community jedoch kaum lindern, da viele weiterhin von schlechter Leistung berichteten und mehr technische Dokumentation über die Trainingsprozesse der Modelle forderten. Diese Veröffentlichung hatte mehr Probleme als frühere Llama-Versionen, was Fragen zu ihrer Entwicklung und Einführung aufwirft.
Das Timing dieser Veröffentlichung ist bemerkenswert, da sie auf den Abgang von Joelle Pineau folgt, der Vizepräsidentin für Forschung bei Meta, die letzte Woche auf LinkedIn ihren Ausstieg mit Dank für ihre Zeit im Unternehmen bekannt gab. Pineau hatte am Wochenende auch die Llama 4-Modellfamilie beworben.
Da Llama 4 weiterhin von anderen Inferenzanbietern mit gemischten Ergebnissen übernommen wird, ist klar, dass die anfängliche Veröffentlichung nicht der Erfolg war, den Meta sich erhofft haben könnte. Die bevorstehende Meta LlamaCon am 29. April, das erste Treffen für Drittentwickler der Modellfamilie, wird wahrscheinlich ein Brennpunkt für Diskussionen und Debatten sein. Wir werden die Entwicklungen genau im Auge behalten, also bleiben Sie dran.
Verwandter Artikel
 Frontier AI Labs weigert sich, Eindämmungsstrategien für außer Kontrolle geratene Modelle offenzulegen
Jüngste Untersuchungen zeigen, dass nur sehr wenige führende KI-Forschungslabore Maßnahmenpläne zur Eindämmung veröffentlicht oder vorgeführt haben. Ein solcher Eindämmungsplan legt die Vorgehensweise
Glaubt Mark Zuckerberg wirklich, dass KI für alle ist?
Lädt den Player…Meta hat diese Woche Glimmer vorgestellt, ein Open-Weight-KI-Modell, das jeder herunterladen und auf persönlicher Hardware ausführen kann – ein scharfer Kontrast zu Muse Spark, dem leistungsfähigeren Modell des Unternehmens, das weit
Facebook bringt eine KI-Begleit-App für Creator auf den Markt
Facebook gab am Mittwoch bekannt, dass es sein „Creator Studio“ in eine eigenständige KI-Begleit-App umwandelt, die es Content-Erstellern ermöglicht, ihre Reichweite auf der Plattform zu vergrößern.Mi
Empfehlungen zu verwandten Spezialthemen
Schreiben
 KI-Tools zur Gliederung von Artikeln für das Verfassen langer Texte
2026: Die neuesten, besten und am besten bewerteten KI-Tools zur Erstellung von Gliederungen für lange Texte! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die präzise, strukturierte Gliederungen liefern – getestet unter realen Bedingungen –, um die Effizienz beim Schreiben deutlich zu steigern. XIX.AI gehört zu dieser Eliteauswahl. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen bei der Auswahl des perfekten Tools hilft. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
 9 Tools
 xix.ai
Chatbot
Die besten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprechflüssigkeit
2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
10 Tools
xix.ai
Musikkomposition
KI-Tools zur Stim-Trennung für die Remix-Produktion, die Vorbereitung von Samples und Karaoke-Master
Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai
Datenanalyse
KI-basierte SQL-Copiloten für Umsatz-Dashboards, Kanalanalysen sowie Produktmetriken
2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai
Musikkomposition
Die besten KI-Tools zum Komponieren von Melodien für Songentwürfe
2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai
Chatbot
Die besten KI-gestützten Gesprächstrainingstools für Vorstellungsgesprächspraxis
2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

 Kommentare (11)
![PaulGonzalez]()
Meta hat mal wieder die AI-Welt aufgemischt! Llama 4 klingt nach einem riesigen Schritt, aber die Meldungen über gemischte Qualität wegen Bugs sind irgendwie enttäuschend. 🤔 Finde es trotzdem cool, dass sie so transparent sind und die Probleme direkt ansprechen – das ist bei Tech-Giganten nicht immer selbstverständlich. Hoffentlich kriegen sie die Fehler schnell in den Griff, sonst könnte das Vertrauen in die Modelle leiden. Die MoE-Architektur an sich ist ja mega spannend!
![WalterHarris]()
Hmm, Meta's Llama 4-Release sorgt also für gemischte Qualitätsberichte und sie schieben es auf Bugs? Interessant. Kann es nicht einfach sein, dass das MoE-Design in der Praxis schwieriger zu beherrschen ist, als in der Theorie versprochen? Die Eile, mit der die großen Tech-Konzerne KI pushen, macht mich nachdenklich. Kommen diese 'Verbesserungen' überhaupt bei den normalen Anwendern an, wo es wirklich zählt? Irgendwie ein klassisches 'Release jetzt, Patch später'-Szenario... 🤔
![HenryBrown]()
Meta qui sort encore un modèle en catimini avec des bugs... Original cette stratégie de 'test en production' sur des millions d'utilisateurs 🙄 Ça me rappelle les mises à jour foireuses d'Instagram ! #BetaTestGéant
![JohnWilson]()
Meta's Llama 4 drop was wild! Three versions with that fancy Mixture-of-Experts setup? Sounds powerful, but those bugs they mentioned make me wonder if it’s ready for prime time. Anyone tried it yet? 🧐
![HarryRoberts]()
Wow, Llama 4 sounds like a beast with that Mixture-of-Experts setup! But bugs causing mixed quality? Kinda feels like Meta rushed this out to beat the competition. Hope they patch it up soon! 🦙
![ArthurJones]()
Wow, Llama 4 sounds like a beast with that Mixture-of-Experts setup! But bugs causing mixed quality? That’s a bit concerning for a big player like Meta. Hope they iron it out soon, I’m curious to see how it stacks up against other models! 🦙
Am Wochenende überraschte Meta, das Kraftpaket hinter Facebook, Instagram, WhatsApp und Quest VR, alle mit der Vorstellung ihres neuesten KI-Sprachmodells, Llama 4. Nicht nur eines, sondern drei neue Versionen wurden eingeführt, jede mit verbesserten Fähigkeiten dank der "Mixture-of-Experts"-Architektur und einem neuartigen Trainingsansatz namens MetaP, der feste Hyperparameter verwendet. Darüber hinaus verfügen alle drei Modelle über erweiterte Kontextfenster, die es ihnen ermöglichen, mehr Informationen in einer einzigen Interaktion zu verarbeiten.
Trotz der Aufregung um die Veröffentlichung war die Reaktion der KI-Community bestenfalls verhalten. Am Samstag stellte Meta zwei dieser Modelle, Llama 4 Scout und Llama 4 Maverick, zum Download und zur Nutzung bereit, aber die Resonanz war alles andere als enthusiastisch.
Llama 4 löst Verwirrung und Kritik unter KI-Nutzern aus
Ein unbestätigter Beitrag im 1point3acres-Forum, einer beliebten chinesischsprachigen Community in Nordamerika, fand seinen Weg in das r/LocalLlama-Subreddit auf Reddit. Der Beitrag, angeblich von einem Forscher der GenAI-Organisation von Meta, behauptete, dass Llama 4 bei internen Benchmarks von Drittanbietern schlecht abgeschnitten habe. Es wurde angedeutet, dass die Führung von Meta die Ergebnisse manipuliert habe, indem sie Testsets während des Post-Trainings vermischte, um verschiedene Metriken zu erfüllen und ein positives Ergebnis zu präsentieren. Die Authentizität dieser Behauptung wurde mit Skepsis aufgenommen, und Meta hat bisher nicht auf Anfragen von VentureBeat reagiert.
Doch die Zweifel an der Leistung von Llama 4 hörten damit nicht auf. Auf X äußerte der Nutzer @cto_junior Unglauben über die Leistung des Modells und verwies auf einen unabhängigen Test, bei dem Llama 4 Maverick im aider-Polyglot-Benchmark, der Programmieraufgaben testet, nur 16 % erreichte. Dieser Wert liegt deutlich unter dem älterer, ähnlich großer Modelle wie DeepSeek V3 und Claude 3.7 Sonnet.
KI-Doktor und Autor Andriy Burkov nutzte ebenfalls X, um das beworbene 10-Millionen-Token-Kontextfenster von Llama 4 Scout in Frage zu stellen und erklärte, es sei "virtuell", da das Modell nicht mit Prompts trainiert wurde, die länger als 256k Token sind. Er warnte, dass längere Prompts wahrscheinlich zu minderwertigen Ergebnissen führen würden.
Im r/LocalLlama-Subreddit äußerte der Nutzer Dr_Karminski Enttäuschung über Llama 4 und verglich dessen schlechte Leistung mit dem nicht-räsonierenden V3-Modell von DeepSeek bei Aufgaben wie der Simulation von Ballbewegungen in einem Heptagon.
Nathan Lambert, ein ehemaliger Meta-Forscher und aktueller Senior Research Scientist bei AI2, kritisierte Metas Benchmark-Vergleiche in seinem Interconnects-Substack-Blog. Er wies darauf hin, dass das in Metas Werbematerialien verwendete Llama 4 Maverick-Modell nicht dasselbe war wie das öffentlich freigegebene, sondern für Konversation optimiert wurde. Lambert bemerkte den Widerspruch und sagte: „Hinterlistig. Die untenstehenden Ergebnisse sind gefälscht, und es ist ein großer Affront gegen die Community von Meta, nicht das Modell zu veröffentlichen, das sie für ihre große Marketingkampagne verwendet haben.“ Er fügte hinzu, dass das beworbene Modell „den technischen Ruf der Veröffentlichung ruiniert, weil sein Charakter jugendlich ist“, während das tatsächlich auf anderen Plattformen verfügbare Modell „ziemlich klug ist und einen angemessenen Ton hat“.
Meta reagiert, bestreitet „Training mit Testsets“ und verweist auf Fehler in der Implementierung aufgrund der schnellen Einführung
Als Reaktion auf die Kritik und Anschuldigungen ging Ahmad Al-Dahle, Vizepräsident und Leiter von GenAI bei Meta, auf X, um die Bedenken anzusprechen. Er zeigte sich begeistert von der Beteiligung der Community an Llama 4, räumte jedoch Berichte über uneinheitliche Qualität bei verschiedenen Diensten ein. Er führte diese Probleme auf die schnelle Einführung und die Zeit zurück, die für die Stabilisierung öffentlicher Implementierungen benötigt wird. Al-Dahle wies die Vorwürfe des Trainings mit Testsets entschieden zurück und betonte, dass die variable Qualität auf Implementierungsfehler und nicht auf Fehlverhalten zurückzuführen sei. Er bekräftigte Metas Glauben an die bedeutenden Fortschritte der Llama 4-Modelle und ihr Engagement, mit der Community zusammenzuarbeiten, um ihr Potenzial zu verwirklichen.
Die Antwort konnte die Frustrationen der Community jedoch kaum lindern, da viele weiterhin von schlechter Leistung berichteten und mehr technische Dokumentation über die Trainingsprozesse der Modelle forderten. Diese Veröffentlichung hatte mehr Probleme als frühere Llama-Versionen, was Fragen zu ihrer Entwicklung und Einführung aufwirft.
Das Timing dieser Veröffentlichung ist bemerkenswert, da sie auf den Abgang von Joelle Pineau folgt, der Vizepräsidentin für Forschung bei Meta, die letzte Woche auf LinkedIn ihren Ausstieg mit Dank für ihre Zeit im Unternehmen bekannt gab. Pineau hatte am Wochenende auch die Llama 4-Modellfamilie beworben.
Da Llama 4 weiterhin von anderen Inferenzanbietern mit gemischten Ergebnissen übernommen wird, ist klar, dass die anfängliche Veröffentlichung nicht der Erfolg war, den Meta sich erhofft haben könnte. Die bevorstehende Meta LlamaCon am 29. April, das erste Treffen für Drittentwickler der Modellfamilie, wird wahrscheinlich ein Brennpunkt für Diskussionen und Debatten sein. Wir werden die Entwicklungen genau im Auge behalten, also bleiben Sie dran.








 Frontier AI Labs weigert sich, Eindämmungsstrategien für außer Kontrolle geratene Modelle offenzulegen
Jüngste Untersuchungen zeigen, dass nur sehr wenige führende KI-Forschungslabore Maßnahmenpläne zur Eindämmung veröffentlicht oder vorgeführt haben. Ein solcher Eindämmungsplan legt die Vorgehensweise
 Glaubt Mark Zuckerberg wirklich, dass KI für alle ist?
Lädt den Player…Meta hat diese Woche Glimmer vorgestellt, ein Open-Weight-KI-Modell, das jeder herunterladen und auf persönlicher Hardware ausführen kann – ein scharfer Kontrast zu Muse Spark, dem leistungsfähigeren Modell des Unternehmens, das weit
 Facebook bringt eine KI-Begleit-App für Creator auf den Markt
Facebook gab am Mittwoch bekannt, dass es sein „Creator Studio“ in eine eigenständige KI-Begleit-App umwandelt, die es Content-Erstellern ermöglicht, ihre Reichweite auf der Plattform zu vergrößern.Mi

2026: Die neuesten, besten und am besten bewerteten KI-Tools zur Erstellung von Gliederungen für lange Texte! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die präzise, strukturierte Gliederungen liefern – getestet unter realen Bedingungen –, um die Effizienz beim Schreiben deutlich zu steigern. XIX.AI gehört zu dieser Eliteauswahl. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, der Ihnen bei der Auswahl des perfekten Tools hilft. Entdecken Sie die Tools jetzt und sichern Sie sich Ihren KI-Vorteil!
9 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Rollenspiel-Chat-Apps für Sprachpraxis, Vorstellungsgesprächsvorbereitung und tägliche Sprachflüssigkeit! XIX.AI kuratiert eine leistungsstarke, spielfeldverändernde Sammlung, die kostenlose gegen kostenpflichtige Vergleiche, reale Tests und wöchentlich aktualisierte Rankings bietet. Diese unbedingt auszuprobierenden Tools helfen Ihnen, Ihre Schreibfähigkeiten zu verbessern, Hürden der Sprachflüssigkeit zu überwinden und die Kommunikationseffizienz in allen alltäglichen Szenarien zu steigern. Entdecken Sie jetzt Ihr perfektes Werkzeug für Ihre Sprachentwicklung!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Stem-Trennung des Jahres 2026 – speziell ausgewählt für Remix-Produktionen, die Vorbereitung von Samples und Karaoke-Masters. Diese leistungsstarken, bahnbrechenden Tools haben sich in der Praxis bewährt und bieten präzise Audioisolierung, wodurch die Produktivität erheblich gesteigert wird. XIX.AI stellt einen wöchentlich aktualisierten Vergleichsleitfaden zwischen kostenlosen und kostenpflichtigen Lösungen bereit, der Ihnen hilft, die für Ihre Anforderungen passende Lösung zu finden, die Sie unbedingt ausprobieren sollten. Entdecken Sie ihn jetzt und sichern Sie sich Ihren KI-Vorteil.
8 Tools
xix.ai

2026: Die neuesten und besten AI-SQL-Copiloten – alle in der Rangliste ganz oben! XIX.AI sammelt eine leistungsstarke Auswahl an Tools, die wöchentlich mit aktualisierten Tests aus der Praxis erweitert wird. Mit diesen unverzichtbaren Werkzeugen können Sie präzise Umsatzübersichten erstellen, Verkaufsprozesse analysieren sowie Produktmetriken schnell überwachen und so Ihre Produktivität erheblich steigern. Entdecken Sie jetzt das perfekte Tool für datenbasierte Entscheidungsfindung! 238 Zeichen
9 Tools
xix.ai

2026 Neueste Besten Top-Bewerteten KI-Melodie-Schreibtools für Songentwürfe! XIX.AI hat eine hochleistungsfähige, bahnbrechende Kollektion zusammengestellt, die strengen Praxistests unterzogen wurde, um das beste Schreiberlebnis zu liefern. Sie finden detaillierte kostenlose versus kostenpflichtige Vergleiche, präzise Ranglisten und unbedingt auszuprobierende Optionen, die darauf ausgelegt sind, Ihnen zu helfen, beeindruckende Songentwürfe mühelos zu erstellen und Ihre kreative Produktivität erheblich zu steigern. Entdecken Sie jetzt Ihr perfektes Tool!
8 Tools
xix.ai

2026 Neueste Besten Top-bewerteten KI-Konversationstrainer-Tools für Vorstellungsgesprächspraxis sind hier auf XIX.AI! Diese kuratierte Sammlung enthält leistungsstarke, bahnbrechende Tools, die strengen Praxistests unterzogen wurden, um präzises Feedback zu liefern. Sie finden einen Vergleich zwischen kostenlosen und kostenpflichtigen Optionen sowie detaillierte Rankings, die Ihnen helfen, die empfehlenswerte Option zu wählen, die Ihr Selbstvertrauen und Ihre Fähigkeiten verbessert. Entdecken Sie jetzt Ihr perfektes Tool für den Erfolg im Vorstellungsgespräch!
12 Tools
xix.ai

Meta hat mal wieder die AI-Welt aufgemischt! Llama 4 klingt nach einem riesigen Schritt, aber die Meldungen über gemischte Qualität wegen Bugs sind irgendwie enttäuschend. 🤔 Finde es trotzdem cool, dass sie so transparent sind und die Probleme direkt ansprechen – das ist bei Tech-Giganten nicht immer selbstverständlich. Hoffentlich kriegen sie die Fehler schnell in den Griff, sonst könnte das Vertrauen in die Modelle leiden. Die MoE-Architektur an sich ist ja mega spannend!
Hmm, Meta's Llama 4-Release sorgt also für gemischte Qualitätsberichte und sie schieben es auf Bugs? Interessant. Kann es nicht einfach sein, dass das MoE-Design in der Praxis schwieriger zu beherrschen ist, als in der Theorie versprochen? Die Eile, mit der die großen Tech-Konzerne KI pushen, macht mich nachdenklich. Kommen diese 'Verbesserungen' überhaupt bei den normalen Anwendern an, wo es wirklich zählt? Irgendwie ein klassisches 'Release jetzt, Patch später'-Szenario... 🤔
Meta qui sort encore un modèle en catimini avec des bugs... Original cette stratégie de 'test en production' sur des millions d'utilisateurs 🙄 Ça me rappelle les mises à jour foireuses d'Instagram ! #BetaTestGéant
Meta's Llama 4 drop was wild! Three versions with that fancy Mixture-of-Experts setup? Sounds powerful, but those bugs they mentioned make me wonder if it’s ready for prime time. Anyone tried it yet? 🧐
Wow, Llama 4 sounds like a beast with that Mixture-of-Experts setup! But bugs causing mixed quality? Kinda feels like Meta rushed this out to beat the competition. Hope they patch it up soon! 🦙
Wow, Llama 4 sounds like a beast with that Mixture-of-Experts setup! But bugs causing mixed quality? That’s a bit concerning for a big player like Meta. Hope they iron it out soon, I’m curious to see how it stacks up against other models! 🦙












