


 首页
Meta的AI模型基准:误导性?
Meta 在周末发布了他们的新 AI 模型 Maverick,它已经在 LM Arena 上掀起波澜,夺得了第二名的位置。你知道的,那个地方是人类扮演法官和陪审团的角色,比较不同的 AI 模型并挑选他们喜欢的。不过,等等,有个转折!结果发现,在 LM Arena 上展示风采的 Maverick 版本,与开发者可以下载和使用的版本并不完全相同。
一些敏锐的 AI 研究者在 X(是的,那个以前叫 Twitter 的平台)上发现,Meta 将 LM Arena 版本称为“实验性聊天版本”。如果你去 Llama 网站上看,有一张图表透露了细节,称测试使用的是“为对话优化设计的 Llama 4 Maverick”。我们之前讨论过这个,但 LM Arena 并不是衡量 AI 性能的黄金标准。大多数 AI 公司不会为了在这个测试中得分更高而专门调整模型——或者至少,他们不会承认这样做。
问题是,当你调整一个模型以在基准测试中表现出色,但随后向公众发布一个不同的“普通”版本时,开发者很难弄清楚这个模型在现实场景中的实际表现如何。而且,这有点误导,对吧?基准测试虽然有缺陷,但应该为我们提供模型在不同任务中能做什么和不能做什么的清晰图景。
X 上的研究者很快就注意到,你可以下载的 Maverick 和 LM Arena 上的版本之间存在一些重大差异。Arena 版本似乎特别喜欢使用表情符号,而且回答总是冗长而拖沓。
好吧,Llama 4 确实有点过头了,哈哈,这是什么啰嗦之城 pic.twitter.com/y3GvhbVz65
— Nathan Lambert (@natolambert) 2025年4月6日
出于某种原因,Arena 中的 Llama 4 模型使用了更多的表情符号
在 together.ai 上,它似乎表现更好:pic.twitter.com/f74ODX4zTt
— Tech Dev Notes (@techdevnotes) 2025年4月6日
我们已经联系了 Meta 和运行 LM Arena 的 Chatbot Arena 团队,看看他们对此有什么说法。敬请期待!
相关文章
 Meta 的 Muse 在早期移动发布中超越 ChatGPT
新数据显示,Meta 最新的 AI 应用 Muse 可能成为这家社交巨头的下一个重大成功。根据 Appfigures 最近的估算,Muse 在前 12 天内的移动设备下载次数超过了 ChatGPT 在发布后 12 天内的下载量。(该数据仅涵盖美国和加拿大市场。)该公司还发现,Muse 的日活跃用户数超过了 ChatGPT 在同一阶段的用户数。在此之前,由于两款应用的发布策略不同,直接比较这两款应用一直具有挑战性。ChatGPT 在全球范围内发布,但仅在 iOS 平台上提供;而 Muse 在苹果
Meta 的 Muse 登陆 Mac,使 AI 能够在你的电脑上执行操作
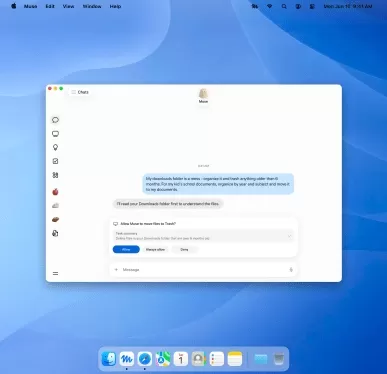
Meta 的最新 AI 助手 Muse 现已在 Mac 上上线。在 macOS 上,Muse 与您的文件、消息、日历、笔记和邮件集成,直接在原生应用中运行。此次桌面版发布紧随 Muse 本月早些时候在移动端和网页端的推出,当时它迅速攀升至美国 App Store 排行榜首位。Muse for Mac 来了!!您的智能助手现在可以直接在电脑上处理事务——文件、消息、日历、笔记,一应俱全。 您可以控制它可以访问的内容,并且在执行任何敏感操作前,它都会先征求您的同意。 将其添加到程序坞
扎克伯格将Meta的企业级AI愿景扩展至智能体领域
六月,Meta 推出了一款面向企业的新 AI 智能体,旨在协助处理客户服务、技术支持和日常运营。然而,首席执行官马克·扎克伯格在周三的第二季度财报电话会议上向投资者透露,该公司的企业 AI 战略远不止于这一初步产品。“我们认为企业领域存在巨大的机遇,包括提供 API、商业智能体、直接计算资源销售以及其他针对大型客户定制的服务,”扎克伯格表示。这些举措有助于使收入来源多样化,摆脱对广告这一主要收入来源以及贡献较小份额的订阅收入的依赖。最初,Meta 将通过提供跨消息平台和其他渠道运行的 AI
相关专题推荐
设计与艺术
 顶级AI插画工具:更快地创作编辑类场景和封面插图
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
 10 个工具
 xix.ai
教育与学习
备考首选的顶尖AI辅导老师:练习数学、科学和英语
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
金融
用于个人财务管理的 AI 预算规划工具
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
健康养生
AI睡眠追踪助手:通过养成更好的睡前习惯来促进身体恢复
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
数据分析
用于产品和收入分析的 AI SQL 辅助工具
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
教育与学习
最佳的、兼具教学功能的AI作业助手:学习概念,而不仅仅是答案
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

 评论 (37)
0/500
![RalphGarcia]()
メタのAIベンチマークって怪しくない?🤔 人間が好みで評価するランダムなランキングより、実用的なテストの方が信用できると思う。結局ベンチマークゲームに夢中になる企業より、実際に役立つAIを作ってる会社の方が価値あるよね。 #AIベンチマーク
![ScottWalker]()
Meta's Maverick hitting second on LM Arena? Impressive, but I'm skeptical about those benchmarks. Feels like a hype train—wonder if it’s more flash than substance. 🤔 Anyone tested it in real-world tasks yet?
![KennethMartin]()
Meta's Maverick AI model is impressive, snagging second place on LM Arena! But are the benchmarks really telling the whole story? It's cool to see AI models go head-to-head, but I'm not sure if it's all fair play. Makes you wonder, right? 🤔 Maybe we need a more transparent way to judge these models!
![WalterThomas]()
मेटा का नया AI मॉडल, मैवरिक, LM एरिना में दूसरे स्थान पर पहुंचा! यह प्रभावशाली है, लेकिन क्या बेंचमार्क वास्तव में पूरी कहानी बता रहे हैं? AI मॉडल्स को आपस में प्रतिस्पर्धा करते देखना मजेदार है, लेकिन मुझे नहीं पता कि यह निष्पक्ष है या नहीं। आपको सोचने पर मजबूर करता है, है ना? 🤔 शायद हमें इन मॉडल्स को जज करने का एक और पारदर्शी तरीका चाहिए!
![JohnYoung]()
메타의 새로운 AI 모델, 마브릭이 LM Arena에서 2위를 차지하다니 대단해요! 하지만 벤치마크가 정말 모든 것을 말해주고 있는지 궁금해요. AI 모델 간의 경쟁은 재미있지만, 공정한지 확신할 수 없네요. 더 투명한 평가 방법이 필요할 것 같아요 🤔
![JohnHernández]()
Meta's Maverick AI model snagging second place on LM Arena is pretty cool, but the benchmarks might be a bit off! 🤔 It's fun to see these models go head-to-head, but I'm not sure if the results are totally fair. Worth keeping an eye on! 👀
Meta 在周末发布了他们的新 AI 模型 Maverick,它已经在 LM Arena 上掀起波澜,夺得了第二名的位置。你知道的,那个地方是人类扮演法官和陪审团的角色,比较不同的 AI 模型并挑选他们喜欢的。不过,等等,有个转折!结果发现,在 LM Arena 上展示风采的 Maverick 版本,与开发者可以下载和使用的版本并不完全相同。
一些敏锐的 AI 研究者在 X(是的,那个以前叫 Twitter 的平台)上发现,Meta 将 LM Arena 版本称为“实验性聊天版本”。如果你去 Llama 网站上看,有一张图表透露了细节,称测试使用的是“为对话优化设计的 Llama 4 Maverick”。我们之前讨论过这个,但 LM Arena 并不是衡量 AI 性能的黄金标准。大多数 AI 公司不会为了在这个测试中得分更高而专门调整模型——或者至少,他们不会承认这样做。
问题是,当你调整一个模型以在基准测试中表现出色,但随后向公众发布一个不同的“普通”版本时,开发者很难弄清楚这个模型在现实场景中的实际表现如何。而且,这有点误导,对吧?基准测试虽然有缺陷,但应该为我们提供模型在不同任务中能做什么和不能做什么的清晰图景。
X 上的研究者很快就注意到,你可以下载的 Maverick 和 LM Arena 上的版本之间存在一些重大差异。Arena 版本似乎特别喜欢使用表情符号,而且回答总是冗长而拖沓。
好吧,Llama 4 确实有点过头了,哈哈,这是什么啰嗦之城 pic.twitter.com/y3GvhbVz65
— Nathan Lambert (@natolambert) 2025年4月6日
出于某种原因,Arena 中的 Llama 4 模型使用了更多的表情符号
— Tech Dev Notes (@techdevnotes) 2025年4月6日
在 together.ai 上,它似乎表现更好:pic.twitter.com/f74ODX4zTt
我们已经联系了 Meta 和运行 LM Arena 的 Chatbot Arena 团队,看看他们对此有什么说法。敬请期待!








 Meta 的 Muse 在早期移动发布中超越 ChatGPT
新数据显示,Meta 最新的 AI 应用 Muse 可能成为这家社交巨头的下一个重大成功。根据 Appfigures 最近的估算,Muse 在前 12 天内的移动设备下载次数超过了 ChatGPT 在发布后 12 天内的下载量。(该数据仅涵盖美国和加拿大市场。)该公司还发现,Muse 的日活跃用户数超过了 ChatGPT 在同一阶段的用户数。在此之前,由于两款应用的发布策略不同,直接比较这两款应用一直具有挑战性。ChatGPT 在全球范围内发布,但仅在 iOS 平台上提供;而 Muse 在苹果
 Meta 的 Muse 登陆 Mac,使 AI 能够在你的电脑上执行操作
Meta 的最新 AI 助手 Muse 现已在 Mac 上上线。在 macOS 上,Muse 与您的文件、消息、日历、笔记和邮件集成,直接在原生应用中运行。此次桌面版发布紧随 Muse 本月早些时候在移动端和网页端的推出,当时它迅速攀升至美国 App Store 排行榜首位。Muse for Mac 来了!!您的智能助手现在可以直接在电脑上处理事务——文件、消息、日历、笔记,一应俱全。 您可以控制它可以访问的内容,并且在执行任何敏感操作前,它都会先征求您的同意。 将其添加到程序坞
 扎克伯格将Meta的企业级AI愿景扩展至智能体领域
六月,Meta 推出了一款面向企业的新 AI 智能体,旨在协助处理客户服务、技术支持和日常运营。然而,首席执行官马克·扎克伯格在周三的第二季度财报电话会议上向投资者透露,该公司的企业 AI 战略远不止于这一初步产品。“我们认为企业领域存在巨大的机遇,包括提供 API、商业智能体、直接计算资源销售以及其他针对大型客户定制的服务,”扎克伯格表示。这些举措有助于使收入来源多样化,摆脱对广告这一主要收入来源以及贡献较小份额的订阅收入的依赖。最初,Meta 将通过提供跨消息平台和其他渠道运行的 AI

2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
10 个工具
xix.ai

2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai

2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai

2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai

2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai

2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

メタのAIベンチマークって怪しくない?🤔 人間が好みで評価するランダムなランキングより、実用的なテストの方が信用できると思う。結局ベンチマークゲームに夢中になる企業より、実際に役立つAIを作ってる会社の方が価値あるよね。 #AIベンチマーク
Meta's Maverick hitting second on LM Arena? Impressive, but I'm skeptical about those benchmarks. Feels like a hype train—wonder if it’s more flash than substance. 🤔 Anyone tested it in real-world tasks yet?
Meta's Maverick AI model is impressive, snagging second place on LM Arena! But are the benchmarks really telling the whole story? It's cool to see AI models go head-to-head, but I'm not sure if it's all fair play. Makes you wonder, right? 🤔 Maybe we need a more transparent way to judge these models!
मेटा का नया AI मॉडल, मैवरिक, LM एरिना में दूसरे स्थान पर पहुंचा! यह प्रभावशाली है, लेकिन क्या बेंचमार्क वास्तव में पूरी कहानी बता रहे हैं? AI मॉडल्स को आपस में प्रतिस्पर्धा करते देखना मजेदार है, लेकिन मुझे नहीं पता कि यह निष्पक्ष है या नहीं। आपको सोचने पर मजबूर करता है, है ना? 🤔 शायद हमें इन मॉडल्स को जज करने का एक और पारदर्शी तरीका चाहिए!
메타의 새로운 AI 모델, 마브릭이 LM Arena에서 2위를 차지하다니 대단해요! 하지만 벤치마크가 정말 모든 것을 말해주고 있는지 궁금해요. AI 모델 간의 경쟁은 재미있지만, 공정한지 확신할 수 없네요. 더 투명한 평가 방법이 필요할 것 같아요 🤔
Meta's Maverick AI model snagging second place on LM Arena is pretty cool, but the benchmarks might be a bit off! 🤔 It's fun to see these models go head-to-head, but I'm not sure if the results are totally fair. Worth keeping an eye on! 👀












