


 首页
秘密追踪数据揭露人工智能模型被盗事件
一种新方法能在数秒内对ChatGPT等模型进行隐形水印处理,无需重新训练,既不会在标准输出中留下痕迹,又能抵御所有实际的去除尝试。
水印技术与"版权诱饵"的关键区别在于:无论可见或隐形的水印,通常都设计为贯穿整个集合(如图像数据集)的持续性威慑手段,以防范随意复制。
而虚构条目则是将一小段文本(通常为单词或定义)植入大型通用集合中,旨在证明盗用行为。其原理在于:当作品被直接盗用或作为衍生作品基础时,原创者预先植入的独特虚构事实便能轻易揭露盗版。
在为大型语言模型(LLMs)和视觉语言模型(VLMs)添加水印时,输出内容包含标记的程度通常分为两类:确保所有或大部分输出携带明显或隐藏的水印;或嵌入可被追溯以证明盗用的"秘密令牌"——该令牌不会出现在模型的常规输出中。
证据的分量
中国、意大利和新加坡研究人员的新合作项目正探索后者方案。该研究旨在为开源模型提供披露机制,防止其未经授权的商业化或超出原始许可条款的使用。
例如,模型原始许可可能允许任何人在共享修改成果时沿用同等宽松条款获利——但企业可能试图将调整成果(如微调版本)私有化以获取不正当优势。
该领域多数研究聚焦于检测闭源模型、仅提供API接口的模型,或仅有优化(量化)权重的模型中的滥用行为。由于难以获取模型架构,这些模型更难通过新论文的方法进行高效编辑。
这种对开源版本的关注或许源于中国研究界的特点——过去一年中国AI产出以慷慨发布完整权重*模型为标志,其开放程度堪比限制更严格的西方同类模型。
名为EditMark的新方法具有显著优势:既无需通过微调添加"中毒"数据,也无需包含该数据从头训练。
这带来多重优势:首先,训练集中任何"暴露端倪"的数据一旦被发现并公开,攻击者便可直接针对其发起攻击,从而使其失效。但要攻击EditMark,恶意行为者需同时掌握目标模型层级与具体方法——这种情况极不可能发生。
其次,该方法快速且成本低廉,仅需数秒(而非数天或数周)即可应用于训练模型,避免了随模型和数据规模增长而不断攀升的微调高成本。
最后,相较于微调或早期编辑方法,该方案对模型正常运行的干扰显著降低。
在测试中,通过在模型权重中嵌入具有多个可能答案的数学查询,EditMark实现了100%的提取率。
作者指出:
"全面实验证明EditMark在大型语言模型水印嵌入中表现卓越。其效率惊人:仅需20秒即可嵌入32位水印,且提取成功率达100%。
值得注意的是,水印嵌入耗时不足微调所需时间的1/300(微调平均耗时6,875秒),彰显了EditMark以前所未有的速度和可靠性实现高容量水印的能力。
'此外,大量实验验证了EditMark的鲁棒性、隐蔽性和保真度。'
新论文题为《EditMark:基于模型编辑的大型语言模型水印技术》,由中国科学技术大学、锡耶纳大学及新加坡CFAR/IHPC/A*STAR的八位学者联合发表。
方法
EditMark方法包含四个组件:生成器、编码器、编辑器和解 码 器:
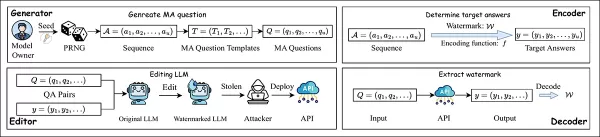
EditMark管道通过编辑模型嵌入水印,使其在回答特定数学问题时编码隐藏的标识信息。来源:https://arxiv.org/pdf/2510.16367
生成器利用伪随机种子生成多选数学问题;编码器根据水印选择答案,并通过专用编辑流程将答案嵌入模型。当编辑后的模型被发布或滥用时,通过提出相同问题并解码响应模式即可提取水印。
编辑器通过修改模型权重,使模型在被问及特定种子问题时始终输出目标答案,从而将水印直接嵌入模型行为。解码器则通过向可疑模型输入相同问题,将其答案还原为隐藏签名来恢复水印。
威胁模型
本文威胁模型假设水印操作在白盒环境下进行。尽管这在安全研究中常引发担忧,但本方法旨在保护拥有完全访问权限的模型所有者,因此此场景属合理范畴。
攻击者在获取模型后同样拥有白盒访问权限,可对其进行修改(如通过修剪或微调)。此场景常见于开源软件发布。但攻击者无法知晓水印提取流程或模式,只能通过实验或泄露信息进行推断。
生成器通过GPT-4o实现模板多样化(如下所示),并采用伪随机种子确保每道题目唯一性,从而生成逻辑与事实均成立的数学问题(含多个正确答案)。该机制通过答案排列实现已知水印的确定性嵌入,同时最大限度减少题目重叠以避免编辑纠缠:
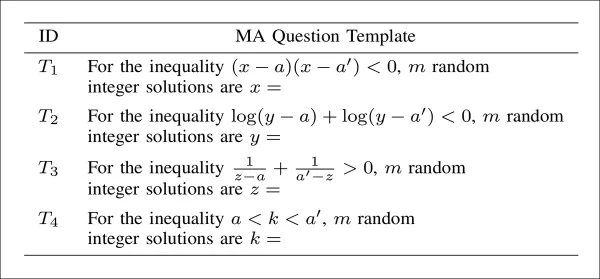
GPT‑4o生成的水印嵌入题库模板,每题均通过种子不等式生成多个有效整数答案。
编码器将每个二进制水印片段转换为特定数学题解集中的唯一整数排列。通过字典序排列理论,编码器将水印块的十进制值映射至特定排序的答案组合,确保水印以确定性方式嵌入模型行为。
关于编辑器,最初用于水印的AlphaEdit模型编辑方法既缺乏精度又缺乏韧性,常无法生成所需答案。其修改内容极易被修剪或噪声破坏。
为解决此问题,作者提出多轮编辑策略:在单一MLP层逐步调整模型权重,直至响应与目标答案一致。为增强编辑抗篡改性,训练过程中注入高斯噪声模拟攻击:
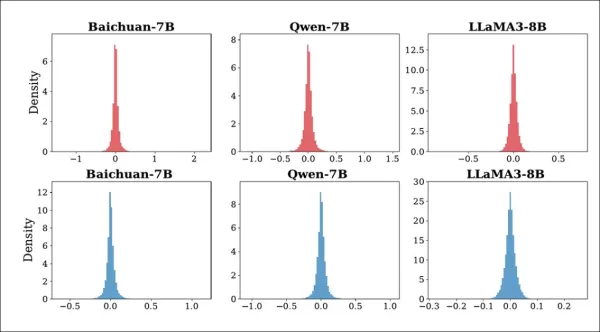
Baichuan-7B、Qwen-7B和LLaMA3-8B模型在攻击前后K1层权重变化分布。上排展示随机噪声注入效果,下排展示模型剪枝效果。所有变化值均接近零,表明攻击未显著扰乱模型内部行为。
当编辑精度达到要求时,评分系统将终止过程;正则化机制则确保更新在多轮迭代中保持稳定。
解码器向模型提出与水印嵌入时相同的特殊问题,通过解析其回答推断隐藏ID。由于答案模式遵循秘密规则,无需剖析模型内部即可恢复该ID。
数据与测试
为评估EditMark,测试了五种大型语言模型:GPT2-XL、GPT-J-6B、LLaMA-3-8B、百川-7B及Qwen-7B。采用前述AlphaEdit嵌入水印,以提取成功率(ESR)和嵌入时间(ET)作为评估指标。
基准测试选取了Model Watermark(后门技术)、KIMark,以及本项目改造的BadEdit框架(原为后门注入设计)。
作者分别编辑了LLaMA-3-8B的第15层、GPT2-XL与GPT-J-6B的第17层,以及Qwen-7B和Baichuan-7B的第14层。
实验在四块NVIDIA RTX 4090 GPU(每块24GB显存)上进行,嵌入32位、64位和128位长度的水印。所用问题模板详述如下:
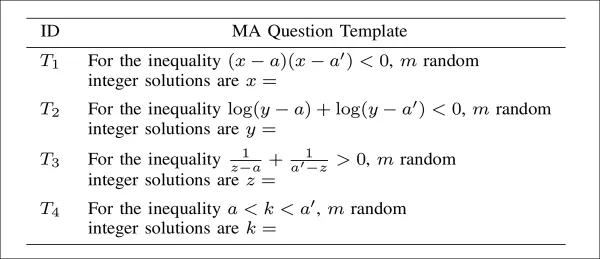
用于生成多选题(MA)水印的模板。每道题目基于不同类型的数学不等式,变量采用随机数填充。模型需返回整数解列表,答案排序用于编码或解码水印位。四种模板涵盖二次、对数、有理及区间形式,均由GPT-4o生成。
为降低随机性影响,在不同水印容量的测试中应用了1至20的种子值。
研究人员首先在大型语言模型上测试嵌入水印的ESR(提取成功率)与时间成本:
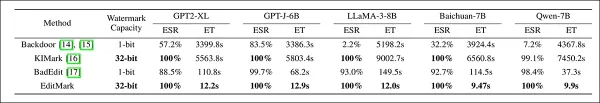
在五种大型语言模型上,EditMark与三种现有水印方法的对比。报告了提取成功率(ESR)和嵌入时间(ET,单位秒)。EditMark始终保持100%成功率,同时将嵌入时间缩短数个数量级,在不同规模和架构的模型中,其准确性和效率均超越所有基准方案。
针对这些结果,作者指出:
"[EditMark]在所有评估的LLM上均实现100%ESR,且嵌入32位水印耗时不足20秒。尤其在百川-7B和Qwen-7B上平均嵌入时间低于10秒,充分展现了EditMark的高效性。"
对于128位水印(该方案下最高可行值),EditMark保持了"不可擦除性":
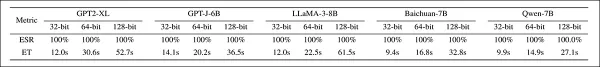
EditMark在五种语言模型中,针对32、64、128位水印长度的提取成功率与嵌入时间。所有情况下均保持完美成功率,嵌入时间随水印尺寸增加,但即使在128位时仍低于一分钟。
随后,通过多项基准测试验证了系统保持水印保真度的能力:
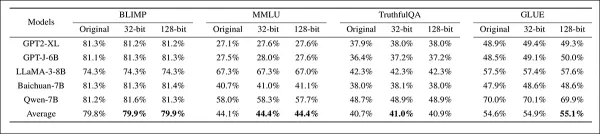
在五个模型上对四个基准测试进行水印保真度评估,对比未修改模型与嵌入32位及128位水印的模型。各配置下性能保持稳定,平均得分仅有轻微波动,表明水印嵌入对基准测试准确度的影响有限。
EditMark的抗攻击性经六种常见攻击策略验证。模型先采用五种不同种子嵌入128位水印,如下图所示,微调仅导致多数模型提取成功率(ESR)轻微下降:
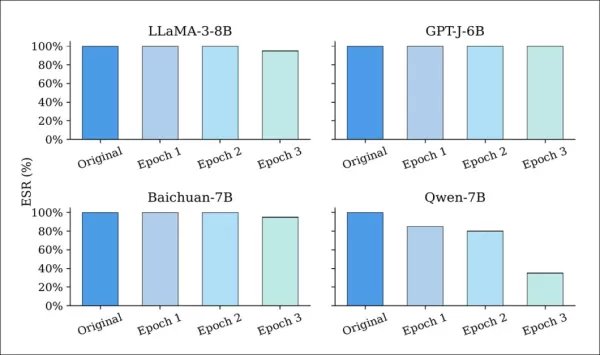
水印大型语言模型在1至3个训练周期前后提取成功率(ESR)对比。多数模型始终保持高ESR,但Qwen-7B出现显著下降,表明其对参数更新更易产生脆弱性。
即使经过多轮迭代,多数模型ESR仍维持在90%以上,表明EditMark能有效抵御基于LoRA训练的参数漂移。
量化攻击虽降低模型精度,但多数水印仍完好无损:
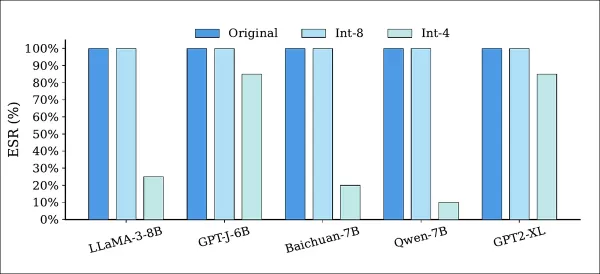
采用Int-8和Int-4精度量化前后,加水印模型的提取成功率(ESR)。所有模型在Int-8量化下ESR保持不变,而Int-4量化导致部分降解,表明精度降低可削弱水印效果但无法完全消除。
如上所示,Int-8量化在所有模型中均保持100%ESR,而Int-4量化虽对ESR造成中度影响,却引入了不可接受的性能损失。
论文指出,此类攻击场景对攻击者价值有限,因其仅能获得性能退化的破解模型。
针对噪声与剪枝攻击的测试评估了四个基准框架:MMLU、BLIMP、TruthfulQA和GLUE。随着扰动强度增加,这些攻击导致ESR持续下降:
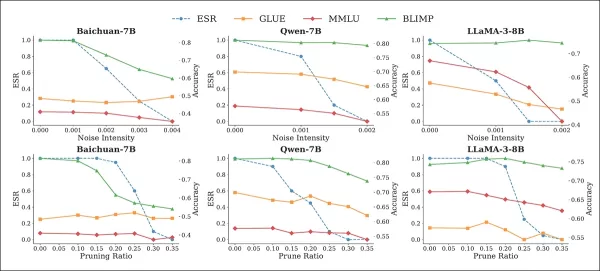
噪声(顶部行)与剪枝(底部行)攻击对ESR的影响,以及水印模型的基准性能。随着扰动增强ESR下降,基准准确率同步恶化——尤其在高噪声强度和高剪枝率下,凸显了水印移除与模型实用性之间的(惯常)矛盾。
然而这些攻击也导致任务性能急剧下降:当应用噪声或剪枝时,百川-7B在BLIMP测试中的性能下滑27-31%。
同时评估了模型编辑与自适应攻击:
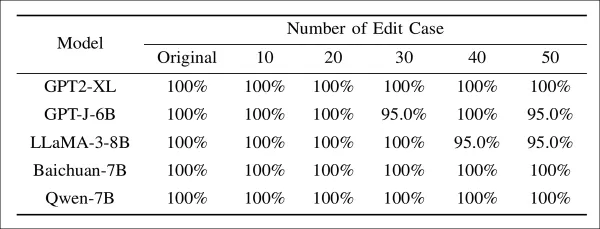
不同程度模型编辑对水印模型提取成功率的影响。即使对已知水印层进行多达五十次编辑,所有模型的ESR仍保持在95%以上,表明直接修改参数对水印去除影响有限。
其中EditMark即使在精确嵌入层被攻击时,仍保持超过95%的ESR。
结论
在人工智能时代之前成效有限的数字版权管理(DRM)、隐形水印等安全措施,应用于机器学习系统时面临挑战。当前宿主架构的刻意简化特性,加之缺乏合适工具,使得注入的水印相对脆弱。
令人印象深刻的是,该系统在开源模型分发领域展现出强大抗攻击性——在攻击者具备先验知识的情况下,仅极端罕见攻击场景能突破其防御。然而训练后编辑导致的性能微幅下降(尽管实验中影响甚微),可能令潜在采用者有所顾虑——尤其考虑到回归API中心化控制模型几乎能完全规避此类攻击。
* 本站曾指出,中国发布的"开放权重"数据集未必完全符合开源标准,因其常保留数据,阻碍训练管道的精确复现。该议题值得深入探讨人工智能模型发布的政治生态。
*本站 曾指出,中国发布的"开放权重"模型未必完全符合开源标准,因其常隐瞒数据导致训练管道无法精确复现。此议题涉及东西方人工智能模型发布背后的政治博弈,超出本文讨论范围。
首次发布于2025年10月27日星期一
相关文章
 Base44 推出专有 AI 模型,以增强其 Vibe Coding 平台的安全性
Base44,这个一年前仅成立六个月、团队规模仅为八人的初创公司,被Wix以8000万美元收购,如今已开始部署其专有AI模型,帮助用户使用自然语言构建应用程序。这一进展正值AI社区争论前沿模型是否适用于所有用例,以及依赖外部模型的企业能否保持长期竞争优势之时。总部位于湾区的Base44的最新战略旨在解决这两方面的担忧。尽管其定制大语言模型(LLM)刚刚推出,Base44的目标是最终超越前沿模型。创始人Maor Shlomo指出,“作为我们整个技术栈的一部分来训练并拥有该模型,使我们能够在延迟
Multiverse Computing推出免费压缩生成式AI模型
大型语言模型面临着一个重大挑战:其庞大的体量。西班牙初创公司Multiverse Computing正通过创建压缩模型来解决这一问题,旨在弥合尖端人工智能能力与企业实际可负担实施能力之间的差距。其核心创新在于CompactifAI压缩技术——这项受量子计算原理启发的技术已被这家巴斯克公司用于优化OpenAI的模型。从今天起,开发者可在Hugging Face平台免费获取Multiverse增强版H
秘密追踪数据揭露人工智能模型被盗事件
一种新方法能在数秒内对ChatGPT等模型进行隐形水印处理,无需重新训练,既不会在标准输出中留下痕迹,又能抵御所有实际的去除尝试。 水印技术与"版权诱饵"的关键区别在于:无论可见或隐形的水印,通常都设计为贯穿整个集合(如图像数据集)的持续性威慑手段,以防范随意复制。而虚构条目则是将一小段文本(通常为单词或定义)植入大型通用集合中,旨在证明盗用行为。其原理在于:当作品被直接盗用或作为衍生作品基础时,
相关专题推荐
音乐创作
 最佳用于歌曲草稿的 AI 旋律创作工具
2026 年最新最佳顶级评分 AI 旋律创作工具,助力歌曲草稿创作!XIX.AI 精心策划了一套极具影响力且经过严格真实世界测试的变革性合集,旨在提供最佳的创作体验。您可以找到详细的免费与付费版对比、精准的排名以及必试选项,这些工具旨在帮助您轻松创作出令人惊艳的歌曲草稿,并显著提升您的创意生产力。立即探索,发现您的完美工具!
 8 个工具
 xix.ai
聊天机器人
最佳AI对话训练工具,助你备战面试
2026年最新、最受好评的AI面试模拟训练工具现已登陆XIX.AI!这份精心精选的合集收录了功能强大、具有革命性意义的工具,它们均经过严格的实际测试,能够提供精准的反馈。 您将看到免费版与付费版的对比分析以及详细排名,助您挑选出必试之选,从而提升自信并精进技能。立即探索,发现助您面试成功的完美工具!
12 个工具
xix.ai
设计与艺术
最适合创意实验的AI风格转换工具
2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai
漫画创作
最适合视觉叙事的AI对话气泡工具
2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai
会议助理
顶级AI会议摘要工具:清晰追踪决策与后续跟进
2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai
数据分析
最佳人工智能数据清洗工具:快速处理缺失值与重复数据
2026年最新、最优秀且评分最高的AI数据清洗工具,可快速处理缺失值与重复数据问题。这份精心挑选的清单展示了那些功能强大、能带来颠覆性变革的解决方案,可显著提升工作效率。所有候选工具都经过了严格的实际应用测试,以确保其稳定性。您可以获取免费版与付费版的对比信息,找出最符合您需求的必备工具。即刻访问XIX.AI,开启您的AI优势之旅。
11 个工具
xix.ai

 评论 (3)
0/500
![JackSanchez]()
這技術真有意思!能在不重訓練的情況下給AI模型加水印,還幾乎無法移除,感覺對保護原創者權益很有幫助。不過會不會反而被濫用來追蹤用戶啊?有點擔心隱私問題⋯⋯😅
![BenJackson]()
Wow, dieses Thema mit unsichtbaren Wasserzeichen für KI-Modelle klingt wie etwas aus einem Spionagefilm! 🤯 Der Unterschied zu ‚Copyright-Baiting‘ ist echt wichtig – es geht ja um langfristigen Schutz, nicht nur ums Fangen. Aber was, wenn dieses Werkzeug selbst missbraucht wird? Irgendwie bemerkenswert, was technisch möglich ist, und ein bisschen gruselig zugleich.
![AnthonyPerez]()
Increíble técnica, pero ¿qué tan seguro es que no afecte el rendimiento del modelo en tareas reales? 🤔 Me preocupa que estas medidas puedan usarse también para restringir el acceso a IA de código abierto. ¿Y si una empresa alega falsamente protección de marca de agua? ¡El debate ético apenas comienza!
一种新方法能在数秒内对ChatGPT等模型进行隐形水印处理,无需重新训练,既不会在标准输出中留下痕迹,又能抵御所有实际的去除尝试。
水印技术与"版权诱饵"的关键区别在于:无论可见或隐形的水印,通常都设计为贯穿整个集合(如图像数据集)的持续性威慑手段,以防范随意复制。
而虚构条目则是将一小段文本(通常为单词或定义)植入大型通用集合中,旨在证明盗用行为。其原理在于:当作品被直接盗用或作为衍生作品基础时,原创者预先植入的独特虚构事实便能轻易揭露盗版。
在为大型语言模型(LLMs)和视觉语言模型(VLMs)添加水印时,输出内容包含标记的程度通常分为两类:确保所有或大部分输出携带明显或隐藏的水印;或嵌入可被追溯以证明盗用的"秘密令牌"——该令牌不会出现在模型的常规输出中。
证据的分量
中国、意大利和新加坡研究人员的新合作项目正探索后者方案。该研究旨在为开源模型提供披露机制,防止其未经授权的商业化或超出原始许可条款的使用。
例如,模型原始许可可能允许任何人在共享修改成果时沿用同等宽松条款获利——但企业可能试图将调整成果(如微调版本)私有化以获取不正当优势。
该领域多数研究聚焦于检测闭源模型、仅提供API接口的模型,或仅有优化(量化)权重的模型中的滥用行为。由于难以获取模型架构,这些模型更难通过新论文的方法进行高效编辑。
这种对开源版本的关注或许源于中国研究界的特点——过去一年中国AI产出以慷慨发布完整权重*模型为标志,其开放程度堪比限制更严格的西方同类模型。
名为EditMark的新方法具有显著优势:既无需通过微调添加"中毒"数据,也无需包含该数据从头训练。
这带来多重优势:首先,训练集中任何"暴露端倪"的数据一旦被发现并公开,攻击者便可直接针对其发起攻击,从而使其失效。但要攻击EditMark,恶意行为者需同时掌握目标模型层级与具体方法——这种情况极不可能发生。
其次,该方法快速且成本低廉,仅需数秒(而非数天或数周)即可应用于训练模型,避免了随模型和数据规模增长而不断攀升的微调高成本。
最后,相较于微调或早期编辑方法,该方案对模型正常运行的干扰显著降低。
在测试中,通过在模型权重中嵌入具有多个可能答案的数学查询,EditMark实现了100%的提取率。
作者指出:
"全面实验证明EditMark在大型语言模型水印嵌入中表现卓越。其效率惊人:仅需20秒即可嵌入32位水印,且提取成功率达100%。
值得注意的是,水印嵌入耗时不足微调所需时间的1/300(微调平均耗时6,875秒),彰显了EditMark以前所未有的速度和可靠性实现高容量水印的能力。
'此外,大量实验验证了EditMark的鲁棒性、隐蔽性和保真度。'
新论文题为《EditMark:基于模型编辑的大型语言模型水印技术》,由中国科学技术大学、锡耶纳大学及新加坡CFAR/IHPC/A*STAR的八位学者联合发表。
方法
EditMark方法包含四个组件:生成器、编码器、编辑器和解 码 器:

EditMark管道通过编辑模型嵌入水印,使其在回答特定数学问题时编码隐藏的标识信息。来源:https://arxiv.org/pdf/2510.16367
生成器利用伪随机种子生成多选数学问题;编码器根据水印选择答案,并通过专用编辑流程将答案嵌入模型。当编辑后的模型被发布或滥用时,通过提出相同问题并解码响应模式即可提取水印。
编辑器通过修改模型权重,使模型在被问及特定种子问题时始终输出目标答案,从而将水印直接嵌入模型行为。解码器则通过向可疑模型输入相同问题,将其答案还原为隐藏签名来恢复水印。
威胁模型
本文威胁模型假设水印操作在白盒环境下进行。尽管这在安全研究中常引发担忧,但本方法旨在保护拥有完全访问权限的模型所有者,因此此场景属合理范畴。
攻击者在获取模型后同样拥有白盒访问权限,可对其进行修改(如通过修剪或微调)。此场景常见于开源软件发布。但攻击者无法知晓水印提取流程或模式,只能通过实验或泄露信息进行推断。
生成器通过GPT-4o实现模板多样化(如下所示),并采用伪随机种子确保每道题目唯一性,从而生成逻辑与事实均成立的数学问题(含多个正确答案)。该机制通过答案排列实现已知水印的确定性嵌入,同时最大限度减少题目重叠以避免编辑纠缠:

GPT‑4o生成的水印嵌入题库模板,每题均通过种子不等式生成多个有效整数答案。
编码器将每个二进制水印片段转换为特定数学题解集中的唯一整数排列。通过字典序排列理论,编码器将水印块的十进制值映射至特定排序的答案组合,确保水印以确定性方式嵌入模型行为。
关于编辑器,最初用于水印的AlphaEdit模型编辑方法既缺乏精度又缺乏韧性,常无法生成所需答案。其修改内容极易被修剪或噪声破坏。
为解决此问题,作者提出多轮编辑策略:在单一MLP层逐步调整模型权重,直至响应与目标答案一致。为增强编辑抗篡改性,训练过程中注入高斯噪声模拟攻击:

Baichuan-7B、Qwen-7B和LLaMA3-8B模型在攻击前后K1层权重变化分布。上排展示随机噪声注入效果,下排展示模型剪枝效果。所有变化值均接近零,表明攻击未显著扰乱模型内部行为。
当编辑精度达到要求时,评分系统将终止过程;正则化机制则确保更新在多轮迭代中保持稳定。
解码器向模型提出与水印嵌入时相同的特殊问题,通过解析其回答推断隐藏ID。由于答案模式遵循秘密规则,无需剖析模型内部即可恢复该ID。
数据与测试
为评估EditMark,测试了五种大型语言模型:GPT2-XL、GPT-J-6B、LLaMA-3-8B、百川-7B及Qwen-7B。采用前述AlphaEdit嵌入水印,以提取成功率(ESR)和嵌入时间(ET)作为评估指标。
基准测试选取了Model Watermark(后门技术)、KIMark,以及本项目改造的BadEdit框架(原为后门注入设计)。
作者分别编辑了LLaMA-3-8B的第15层、GPT2-XL与GPT-J-6B的第17层,以及Qwen-7B和Baichuan-7B的第14层。
实验在四块NVIDIA RTX 4090 GPU(每块24GB显存)上进行,嵌入32位、64位和128位长度的水印。所用问题模板详述如下:

用于生成多选题(MA)水印的模板。每道题目基于不同类型的数学不等式,变量采用随机数填充。模型需返回整数解列表,答案排序用于编码或解码水印位。四种模板涵盖二次、对数、有理及区间形式,均由GPT-4o生成。
为降低随机性影响,在不同水印容量的测试中应用了1至20的种子值。
研究人员首先在大型语言模型上测试嵌入水印的ESR(提取成功率)与时间成本:

在五种大型语言模型上,EditMark与三种现有水印方法的对比。报告了提取成功率(ESR)和嵌入时间(ET,单位秒)。EditMark始终保持100%成功率,同时将嵌入时间缩短数个数量级,在不同规模和架构的模型中,其准确性和效率均超越所有基准方案。
针对这些结果,作者指出:
"[EditMark]在所有评估的LLM上均实现100%ESR,且嵌入32位水印耗时不足20秒。尤其在百川-7B和Qwen-7B上平均嵌入时间低于10秒,充分展现了EditMark的高效性。"
对于128位水印(该方案下最高可行值),EditMark保持了"不可擦除性":

EditMark在五种语言模型中,针对32、64、128位水印长度的提取成功率与嵌入时间。所有情况下均保持完美成功率,嵌入时间随水印尺寸增加,但即使在128位时仍低于一分钟。
随后,通过多项基准测试验证了系统保持水印保真度的能力:

在五个模型上对四个基准测试进行水印保真度评估,对比未修改模型与嵌入32位及128位水印的模型。各配置下性能保持稳定,平均得分仅有轻微波动,表明水印嵌入对基准测试准确度的影响有限。
EditMark的抗攻击性经六种常见攻击策略验证。模型先采用五种不同种子嵌入128位水印,如下图所示,微调仅导致多数模型提取成功率(ESR)轻微下降:

水印大型语言模型在1至3个训练周期前后提取成功率(ESR)对比。多数模型始终保持高ESR,但Qwen-7B出现显著下降,表明其对参数更新更易产生脆弱性。
即使经过多轮迭代,多数模型ESR仍维持在90%以上,表明EditMark能有效抵御基于LoRA训练的参数漂移。
量化攻击虽降低模型精度,但多数水印仍完好无损:

采用Int-8和Int-4精度量化前后,加水印模型的提取成功率(ESR)。所有模型在Int-8量化下ESR保持不变,而Int-4量化导致部分降解,表明精度降低可削弱水印效果但无法完全消除。
如上所示,Int-8量化在所有模型中均保持100%ESR,而Int-4量化虽对ESR造成中度影响,却引入了不可接受的性能损失。
论文指出,此类攻击场景对攻击者价值有限,因其仅能获得性能退化的破解模型。
针对噪声与剪枝攻击的测试评估了四个基准框架:MMLU、BLIMP、TruthfulQA和GLUE。随着扰动强度增加,这些攻击导致ESR持续下降:

噪声(顶部行)与剪枝(底部行)攻击对ESR的影响,以及水印模型的基准性能。随着扰动增强ESR下降,基准准确率同步恶化——尤其在高噪声强度和高剪枝率下,凸显了水印移除与模型实用性之间的(惯常)矛盾。
然而这些攻击也导致任务性能急剧下降:当应用噪声或剪枝时,百川-7B在BLIMP测试中的性能下滑27-31%。
同时评估了模型编辑与自适应攻击:

不同程度模型编辑对水印模型提取成功率的影响。即使对已知水印层进行多达五十次编辑,所有模型的ESR仍保持在95%以上,表明直接修改参数对水印去除影响有限。
其中EditMark即使在精确嵌入层被攻击时,仍保持超过95%的ESR。
结论
在人工智能时代之前成效有限的数字版权管理(DRM)、隐形水印等安全措施,应用于机器学习系统时面临挑战。当前宿主架构的刻意简化特性,加之缺乏合适工具,使得注入的水印相对脆弱。
令人印象深刻的是,该系统在开源模型分发领域展现出强大抗攻击性——在攻击者具备先验知识的情况下,仅极端罕见攻击场景能突破其防御。然而训练后编辑导致的性能微幅下降(尽管实验中影响甚微),可能令潜在采用者有所顾虑——尤其考虑到回归API中心化控制模型几乎能完全规避此类攻击。
* 本站曾指出,中国发布的"开放权重"数据集未必完全符合开源标准,因其常保留数据,阻碍训练管道的精确复现。该议题值得深入探讨人工智能模型发布的政治生态。
*本站 曾指出,中国发布的"开放权重"模型未必完全符合开源标准,因其常隐瞒数据导致训练管道无法精确复现。此议题涉及东西方人工智能模型发布背后的政治博弈,超出本文讨论范围。
首次发布于2025年10月27日星期一








 Base44 推出专有 AI 模型,以增强其 Vibe Coding 平台的安全性
Base44,这个一年前仅成立六个月、团队规模仅为八人的初创公司,被Wix以8000万美元收购,如今已开始部署其专有AI模型,帮助用户使用自然语言构建应用程序。这一进展正值AI社区争论前沿模型是否适用于所有用例,以及依赖外部模型的企业能否保持长期竞争优势之时。总部位于湾区的Base44的最新战略旨在解决这两方面的担忧。尽管其定制大语言模型(LLM)刚刚推出,Base44的目标是最终超越前沿模型。创始人Maor Shlomo指出,“作为我们整个技术栈的一部分来训练并拥有该模型,使我们能够在延迟
 Multiverse Computing推出免费压缩生成式AI模型
大型语言模型面临着一个重大挑战:其庞大的体量。西班牙初创公司Multiverse Computing正通过创建压缩模型来解决这一问题,旨在弥合尖端人工智能能力与企业实际可负担实施能力之间的差距。其核心创新在于CompactifAI压缩技术——这项受量子计算原理启发的技术已被这家巴斯克公司用于优化OpenAI的模型。从今天起,开发者可在Hugging Face平台免费获取Multiverse增强版H
 秘密追踪数据揭露人工智能模型被盗事件
一种新方法能在数秒内对ChatGPT等模型进行隐形水印处理,无需重新训练,既不会在标准输出中留下痕迹,又能抵御所有实际的去除尝试。 水印技术与"版权诱饵"的关键区别在于:无论可见或隐形的水印,通常都设计为贯穿整个集合(如图像数据集)的持续性威慑手段,以防范随意复制。而虚构条目则是将一小段文本(通常为单词或定义)植入大型通用集合中,旨在证明盗用行为。其原理在于:当作品被直接盗用或作为衍生作品基础时,

2026 年最新最佳顶级评分 AI 旋律创作工具,助力歌曲草稿创作!XIX.AI 精心策划了一套极具影响力且经过严格真实世界测试的变革性合集,旨在提供最佳的创作体验。您可以找到详细的免费与付费版对比、精准的排名以及必试选项,这些工具旨在帮助您轻松创作出令人惊艳的歌曲草稿,并显著提升您的创意生产力。立即探索,发现您的完美工具!
8 个工具
xix.ai

2026年最新、最受好评的AI面试模拟训练工具现已登陆XIX.AI!这份精心精选的合集收录了功能强大、具有革命性意义的工具,它们均经过严格的实际测试,能够提供精准的反馈。 您将看到免费版与付费版的对比分析以及详细排名,助您挑选出必试之选,从而提升自信并精进技能。立即探索,发现助您面试成功的完美工具!
12 个工具
xix.ai

2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai

2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai

2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai

2026年最新、最优秀且评分最高的AI数据清洗工具,可快速处理缺失值与重复数据问题。这份精心挑选的清单展示了那些功能强大、能带来颠覆性变革的解决方案,可显著提升工作效率。所有候选工具都经过了严格的实际应用测试,以确保其稳定性。您可以获取免费版与付费版的对比信息,找出最符合您需求的必备工具。即刻访问XIX.AI,开启您的AI优势之旅。
11 个工具
xix.ai

這技術真有意思!能在不重訓練的情況下給AI模型加水印,還幾乎無法移除,感覺對保護原創者權益很有幫助。不過會不會反而被濫用來追蹤用戶啊?有點擔心隱私問題⋯⋯😅
Wow, dieses Thema mit unsichtbaren Wasserzeichen für KI-Modelle klingt wie etwas aus einem Spionagefilm! 🤯 Der Unterschied zu ‚Copyright-Baiting‘ ist echt wichtig – es geht ja um langfristigen Schutz, nicht nur ums Fangen. Aber was, wenn dieses Werkzeug selbst missbraucht wird? Irgendwie bemerkenswert, was technisch möglich ist, und ein bisschen gruselig zugleich.
Increíble técnica, pero ¿qué tan seguro es que no afecte el rendimiento del modelo en tareas reales? 🤔 Me preocupa que estas medidas puedan usarse también para restringir el acceso a IA de código abierto. ¿Y si una empresa alega falsamente protección de marca de agua? ¡El debate ético apenas comienza!












