


 집
비밀 추적 데이터, AI 모델 도용 사건 폭로
새로운 방법은 재훈련 없이도 ChatGPT와 같은 모델에 몇 초 만에 보이지 않는 워터마크를 적용할 수 있으며, 표준 출력물에 흔적을 남기지 않고 모든 실질적인 제거 시도를 견딥니다.
워터마킹과 '저작권 유인(copyright-baiting)'의 핵심 차이점은 워터마크(가시적이든 숨겨진 것이든)는 일반적으로 이미지 데이터셋과 같은 컬렉션 전체에 걸쳐 나타나도록 설계되어 무분별한 복사를 지속적으로 억제한다는 점입니다.
반면, 허위 항목은 대규모 일반 컬렉션 내에 배치된 작은 텍스트 조각(주로 단어나 정의)으로, 도용을 입증하기 위한 목적입니다. 핵심은 전체 저작물이 무단으로 복제되거나(직접적 복제 또는 파생 저작물 기반) 원작자가 심어둔 고유한 허위 사실이 존재할 경우 도용을 쉽게 드러낸다는 점입니다.
대규모 언어 모델(LLM) 및 비전 언어 모델(VLM)에 워터마킹을 적용할 때, 출력물에 이러한 마커가 포함되는 정도는 일반적으로 두 가지 범주로 나뉩니다: 모든 또는 대부분의 출력물에 명백하거나 숨겨진 워터마크를 포함하도록 보장하는 경우; 또는 모델의 일반 출력물에는 나타나지 않으면서도 도용을 증명하기 위해 복구 가능한 '비밀 토큰'을 임베딩하는 경우입니다.
증거의 무게
후자의 접근법은 중국, 이탈리아, 싱가포르 연구진 간의 새로운 협업에서 탐구되었습니다. 이 연구는 오픈소스 모델에 대한 공개 방법을 제공하여 무단 상업화나 원본 라이선스 조건을 벗어난 사용을 방지하는 것을 목표로 합니다.
예를 들어, 모델의 원래 라이선스는 누구나 동일한 관대한 조건으로 수정 사항을 공유하는 한 수익을 창출할 수 있도록 허용할 수 있습니다. 그러나 기업은 불공정한 이점을 창출하기 위해 조정 사항(예: 미세 조정된 버전)을 비공개로 유지하려고 시도할 수 있습니다.
이 분야의 대부분의 연구는 폐쇄형 소스, API 전용 모델 또는 최적화된(양자화된) 가중치만 제공되는 모델에서 오용을 탐지하는 데 집중되어 있습니다. 이러한 모델들은 모델 아키텍처에 대한 접근이 제한되어 있어 본 논문의 접근법으로 효율적으로 수정하기 어렵습니다.
FOSS 공개에 대한 이러한 초점은 중국 연구계의 특성상 예상된 바일 수 있다. 지난 1년간 중국의 AI 성과는 제한적인 서양 모델과 경쟁할 만한 관대한 전체 가중치* 모델 공개로 특징지어졌기 때문이다.
EditMark라는 새로운 접근법은 '오염된' 데이터를 추가하기 위한 미세 조정이나 해당 데이터를 포함하여 처음부터 훈련할 필요가 없다는 점에서 두드러집니다.
이는 여러 장점을 제공합니다: 첫째, 훈련 세트에 포함된 '단서가 되는' 데이터는 발견 및 공개되면 공격자가 직접 표적으로 삼을 수 있기 때문에 무효화됩니다. 그러나 EditMark를 공격하려면 악의적인 행위자가 표적 모델 레이어와 사용된 방법을 알아야 하는데, 이는 발생 가능성이 낮은 시나리오입니다.
둘째, 이 방법은 빠르고 저렴하며, 훈련된 모델에 적용하는 데 단 몇 초(며칠 또는 몇 주가 아닌)만 소요되어 모델 및 데이터 크기에 따라 증가하는 높은 비용의 미세 조정을 피할 수 있습니다.
마지막으로, 이 접근법은 모델의 정상적인 운영에 미치는 방해가 미세 조정이나 기존 편집 방법에 비해 현저히 적습니다.
테스트에서 EditMark는 모델 가중치에 여러 가능한 답이 있는 수학적 쿼리를 포함시켜 100% 추출률을 달성했습니다.
저자들은 다음과 같이 밝혔습니다:
'포괄적인 실험을 통해 EditMark가 대규모 언어 모델(LLM) 워터마킹에서 탁월한 성능을 입증했습니다. 32비트 워터마크를 20초 미만에 삽입하면서도 100% 추출 성공률(ESR)을 달성하는 놀라운 효율성을 보여줍니다.
특히 워터마크 삽입 시간이 파인 튜닝(평균 6,875초 소요)에 비해 1/300 미만으로 단축되어, EditMark가 전례 없는 속도와 신뢰성으로 대용량 워터마크를 구현할 수 있음을 입증합니다.
'또한 광범위한 실험을 통해 EditMark의 견고성, 은닉성 및 충실도가 입증되었습니다.'
이 새로운 논문은 'EditMark: 모델 편집 기반의 대규모 언어 모델 워터마킹(EditMark: Watermarking Large Language Models based on Model Editing )'이라는 제목으로, 중국과학기술대학, 시에나 대학, 싱가포르 CFAR/IHPC/A*STAR의 8명의 저자가 공동 집필했습니다.
방법
EditMark 접근법은 생성기( Generator), 인코더( Encoder), 편집기(Editor), 디코더(Decoder)의 네 가지 구성 요소로 이루어집니다:
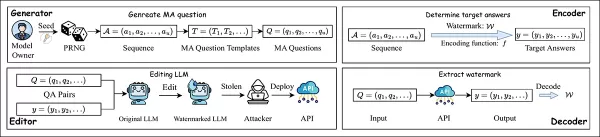
EditMark 파이프라인은 모델을 편집하여 특정 수학 문제를 답하는 방식으로 워터마크를 삽입하며, 이 과정에서 숨겨진 식별 정보를 인코딩합니다. 출처: https://arxiv.org/pdf/2510.16367
생성기는 의사 난수 시드를 사용하여 다중 선택형 수학 문제를 생성합니다. 인코더는 워터마크에 기반하여 답안을 선택한 후, 특수 편집 과정을 통해 모델에 이를 임베딩합니다. 편집된 모델이 공개되거나 오용될 경우, 동일한 질문을 제시하고 응답 패턴을 디코딩함으로써 워터마크를 추출할 수 있습니다.
에디터는 모델 가중치를 수정하여 시드 질문에 대해 모델이 일관되게 목표 답변을 생성하도록 하여 워터마크를 모델 동작에 직접 내장합니다. 디코더는 의심 모델에 동일한 질문을 입력하고 그 답변을 숨겨진 서명으로 역변환하여 워터마크를 복구합니다.
위협 모델
본 논문의 위협 모델은 워터마킹이 화이트박스 환경에서 수행된다고 가정합니다. 이는 보안 연구에서 흔히 우려되는 사항이지만, 본 방법은 자신의 작업물에 대한 완전한 접근 권한을 가진 소유자를 보호하는 것을 목표로 하므로 여기서는 정상적인 가정입니다.
공격자 역시 모델 획득 후 화이트박스 접근 권한을 가진 것으로 가정됩니다. 즉, 모델을 수정(예: 프루닝 또는 파인 튜닝)할 수 있습니다. 이는 FOSS(자유 및 오픈소스 소프트웨어) 배포 시 전형적인 시나리오입니다. 그러나 공격자는 워터마크 추출 과정이나 스키마를 알지 못하며, 실험이나 유출을 통해서만 이를 추론할 수 있습니다.
생성기는 논리적·사실적으로 타당한 수학 문제를 생성하며, 다수의 정답을 포함합니다. GPT‑4o를 활용해 템플릿을 다양화하고(아래 예시 참조), 의사 난수 시드를 사용해 각 문제가 고유하도록 보장합니다. 이를 통해 알려진 워터마크를 정답 순열을 통해 결정론적으로 삽입할 수 있으며, 문제 중복을 최소화하여 편집 얽힘을 방지합니다:
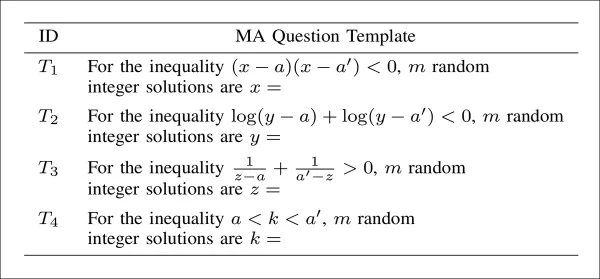
워터마크 삽입을 위해 GPT-4o가 생성한 문제 템플릿. 각 템플릿은 시드화된 부등식에서 여러 유효한 정수 답을 도출하도록 구조화됨.
인코더는 각 이진 워터마크 세그먼트를 주어진 수학 문제의 해답 집합에서 정수의 고유한 순열로 변환합니다. 사전순 순열 이론을 활용하여 인코더는 각 워터마크 청크의 십진수 값을 특정 순서의 해답 선택으로 매핑함으로써 워터마크가 모델 동작에 결정론적으로 내장되도록 보장합니다.
에디터와 관련하여, 워터마킹에 사용된 기존 AlphaEdit 모델 편집 방식은 정밀도와 내구성이 모두 부족하여 요구되는 답을 생성하지 못하는 경우가 많습니다. 이 방식이 가한 변경 사항은 정제(pruning)나 노이즈에 의해 쉽게 무력화됩니다.
이를 해결하기 위해 저자들은 단일 MLP 계층에서 모델 가중치를 점진적으로 조정하여 응답이 원하는 답과 일치할 때까지 다단계 편집 전략을 개발했습니다. 편집을 변조로부터 강화하기 위해 훈련 중 가우시안 노이즈를 주입하여 공격을 시뮬레이션합니다:
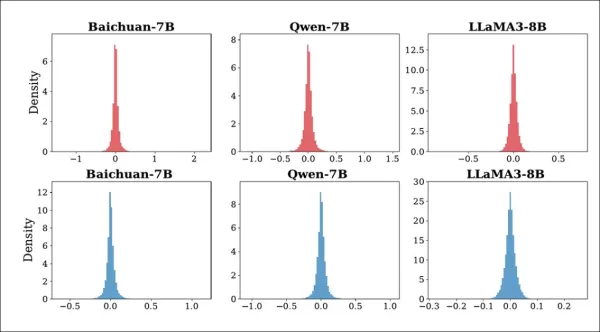
공격 전후 Baichuan-7B, Qwen-7B, LLaMA3-8B의 K1 변화 분포. 상단 행은 무작위 노이즈 주입 효과, 하단 행은 모델 프루닝 효과를 보여줍니다. 모든 변화가 0에 근접하여 공격이 모델 내부 동작을 크게 방해하지 않음을 시사합니다.
점수 체계는 편집 정확도가 충분히 높아지면 프로세스를 중단하며, 정규화는 여러 라운드에 걸쳐 업데이트가 안정적으로 유지되도록 보장합니다.
디코더는 워터마킹 시 사용된 것과 동일한 특수 질문을 모델에 제시한 후, 답변을 읽어 숨겨진 ID를 추론합니다. 답변 패턴이 비밀 규칙을 따르기 때문에, 이 ID는 모델 내부 구조를 검사하지 않고도 복구할 수 있습니다.
데이터 및 테스트
EditMark 평가를 위해 다섯 가지 LLM을 테스트했습니다: GPT2-XL; GPT-J-6B; LLaMA-3-8B; Baichuan-7B; Qwen-7B. 앞서 언급한 AlphaEdit를 워터마크 임베딩에 사용했으며, 추출 성공률(ESR)과 임베딩 시간(ET)을 지표로 삼았습니다.
기준선으로 저자들은 Model Watermark(백도어), KIMark, 그리고 본 프로젝트에 적용된 백도어 주입용으로 설계된 프레임워크인 BadEdit를 선택했습니다.
저자들은 LLaMA-3-8B의 15번째 레이어, GPT2-XL 및 GPT-J-6B의 17번째 레이어, Qwen-7B 및 Baichuan-7B의 14번째 레이어를 편집했습니다.
실험은 32비트, 64비트, 128비트 길이의 워터마크를 삽입하여 4개의 NVIDIA RTX 4090 GPU(각각 24GB VRAM)에서 수행되었습니다. 사용된 질문 템플릿은 아래와 같습니다:
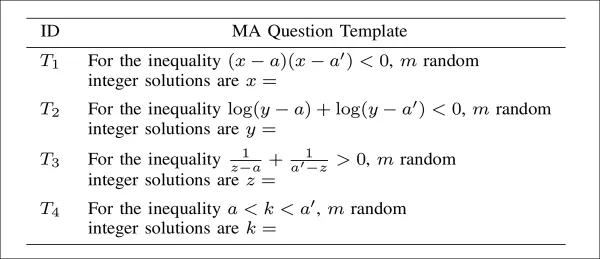
워터마킹용 다중 답변(MA) 문제 생성에 사용된 템플릿. 각 문제는 서로 다른 유형의 수학적 부등식을 기반으로 하며, 변수에는 임의의 값이 삽입됩니다. 모델은 정수 해의 목록을 반환하도록 요청받으며, 답변의 순서는 워터마크 비트 인코딩 또는 디코딩에 사용됩니다. 네 가지 템플릿은 2차, 로그, 유리수, 구간 기반 형태를 다루며, 모두 GPT-4o를 사용하여 생성되었습니다.
무작위성 영향을 줄이기 위해, 다양한 워터마킹 용량에 걸쳐 테스트 시 1부터 20까지의 시드(seed)를 적용했습니다.
연구진은 초기 단계에서 LLM 전반에 걸쳐 워터마크 삽입의 ESR(추출 성공률)과 시간 비용을 모두 테스트했습니다:
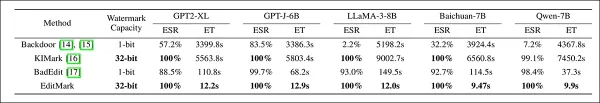
다섯 가지 대규모 언어 모델에서 EditMark와 기존 세 가지 워터마킹 기법의 비교. 추출 성공률(ESR)과 임베딩 시간(ET, 초 단위)을 보고합니다. EditMark는 일관되게 100% 성공률을 달성하면서 임베딩 시간을 수십 배 단축시켜, 다양한 규모와 아키텍처의 모델 전반에서 정확도와 효율성 모두에서 모든 기준선을 능가합니다.
이러한 결과에 대해 저자들은 다음과 같이 언급합니다:
'[EditMark]은 평가된 모든 LLM에서 32비트 워터마크를 삽입하는 데 100% ESR을 달성하며 20초 미만의 시간이 소요됩니다. 특히 Baichuan-7B와 Qwen-7B의 평균 삽입 시간은 10초 미만으로 EditMark의 높은 효율성을 입증합니다.'
해당 방식에서 가능한 최대 값인 128비트 워터마크의 경우, EditMark는 '지워지지 않음'을 유지했습니다:
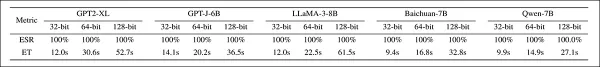
5개 언어 모델에서 32비트, 64비트, 128비트 워터마크 길이에 따른 EditMark의 추출 성공률 및 임베딩 시간. 모든 경우 완벽한 성공률을 유지하며, 임베딩 시간은 워터마크 크기에 따라 증가하나 128비트에서도 1분 미만으로 유지됩니다.
다음으로, 시스템의 워터마크 충실도 유지 능력을 여러 벤치마크에서 테스트했습니다:
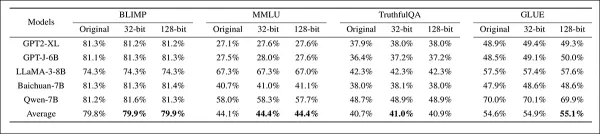
다섯 모델에 걸쳐 네 가지 벤치마크에서 워터마크 충실도 평가. 수정되지 않은 모델과 32비트 및 128비트 용량으로 워터마크 처리된 모델 비교. 구성 전반에 걸쳐 성능은 안정적으로 유지되었으며, 평균 점수에서 미미한 변동만 관찰되어 워터마크 삽입이 벤치마크 정확도에 미치는 영향이 제한적임을 나타냄.
EditMark의 내구성은 여섯 가지 일반적인 공격 전략에 대해 테스트되었습니다. 모델은 먼저 다섯 가지 다른 시드를 사용하여 128비트 워터마크로 임베딩되었습니다. 아래와 같이 보여지는 것처럼, 대부분의 모델에서 미세 조정(fine-tuning)은 추출 성공률(ESR)에 약간의 저하만을 초래했습니다:
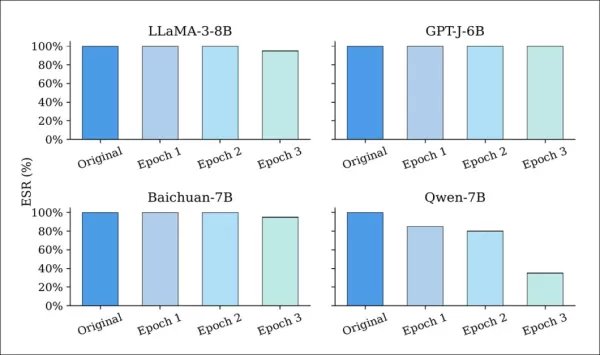
1~3 에포크 동안 미세 조정 전후 워터마크 적용 LLM의 추출 성공률(ESR). 대부분의 모델은 전반적으로 높은 ESR을 유지했으나, Qwen-7B는 현저한 하락을 보여 매개변수 업데이트에 대한 취약성이 더 큼을 시사합니다.
여러 에포크 후에도 대부분의 모델은 90% 이상의 ESR을 유지하여 EditMark가 LoRA 기반 훈련의 매개변수 드리프트에 저항함을 보여주었다.
양자화 공격은 모델 정밀도를 저하시켰으나 대부분의 워터마크는 무사했습니다:
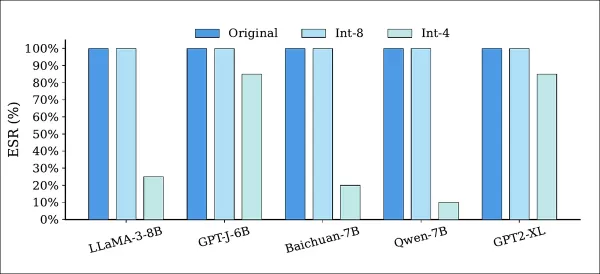
Int-8 및 Int-4 정밀도를 사용한 양자화 전후 워터마크 적용 모델의 추출 성공률(ESR). 모든 모델에서 Int-8 양자화 시 ESR은 변함없었으나, Int-4 양자화는 부분적 저하를 초래하여 낮은 정밀도가 워터마크를 약화시킬 수는 있으나 완전히 제거하지는 못함을 나타냄.
위에서 보듯이 Int-8 양자화는 모든 모델에서 100% ESR을 유지한 반면, Int-4 양자화는 ESR에 중간 정도의 영향을 미쳤으나 허용할 수 없는 성능 저하를 초래했습니다.
본 논문은 해킹된 모델이 성능 저하를 동반한다는 점에서 공격자에게 제한된 잠재력만을 제공한다고 지적합니다.
노이즈 및 프루닝 테스트는 MMLU, BLIMP, TruthfulQA, GLUE 네 가지 벤치마크 프레임워크를 평가했습니다. 이러한 공격은 교란이 심화될수록 ESR을 감소시켰습니다:
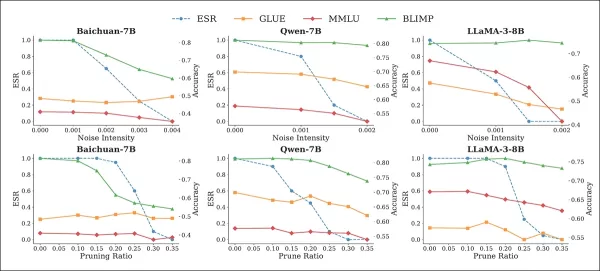
노이즈(상단 행) 및 프루닝(하단 행) 공격이 ESR과 워터마크 적용 모델의 벤치마크 성능에 미치는 영향. 교란 증가에 따라 ESR이 하락함에 따라 벤치마크 정확도도 저하되었으며, 특히 높은 노이즈 강도와 프루닝 비율에서 두드러졌습니다. 이는 워터마크 제거와 모델 유용성 사이의 (관례적인) 긴장 관계를 부각시킵니다.
그러나 이는 작업 성능의 급격한 저하를 동반했으며, Baichuan-7B는 노이즈나 프루닝이 적용될 때 BLIMP에서 27-31%의 성능 하락을 경험했습니다.
모델 편집 및 적응형 공격도 평가되었습니다:
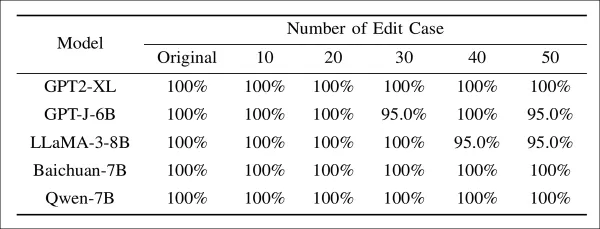
다양한 수준의 모델 편집을 적용한 워터마크 모델의 추출 성공률. 알려진 워터마크 레이어에 최대 50회의 편집을 가했음에도 모든 모델에서 ESR은 95% 이상을 유지하여, 직접적인 매개변수 수정이 워터마크 제거에 미치는 영향이 제한적임을 나타냅니다.
여기서 EditMark는 정확한 임베딩 레이어를 표적으로 삼았을 때에도 95% 이상의 ESR을 유지했습니다.
결론
DRM, 비밀 워터마크 및 기타 보안 조치는 AI 이전 시대에 제한된 성공을 거두었으며, 머신러닝 시스템에 적용하기 어렵습니다. 현재 호스트 아키텍처의 의도적으로 단순화된 특성과 적합한 도구의 부재가 결합되어 주입된 워터마크는 상대적으로 취약합니다.
공격자의 사전 지식을 고려할 때, 가장 발생 가능성이 낮은 공격 시나리오를 제외한 모든 공격을 견디는 FOSS 모델 배포를 목표로 하는 시스템을 보는 것은 인상적입니다. 그러나 훈련 후 편집으로 인한 성능 저하는 이 실험에서 미미하지만, 잠재적 도입자들에게 주저하게 만들 수 있습니다. 특히 API 중심 제어 모델로 되돌리면 이러한 공격을 거의 완전히 피할 수 있기 때문입니다.
* 이 사이트는 중국의 '공개 가중치' 공개가 데이터가 종종 숨겨져 훈련 파이프라인의 정확한 재현을 방해하기 때문에 완전한 FOSS로 인정받기 어려울 수 있다고 주장해왔다. 이 주
* 본 사이트는 중국의 '오픈 웨이트' 공개가 데이터가 종종 공개되지 않아 훈련 파이프라인의 정확한 재현을 방해하므로 완전한 FOSS로 인정받기 어렵다고 주장해왔다. 이 주제는 동서양 간 AI 모델 공개의 정치적 측면에 대한 심층적 검토를 요구하나, 이는 본 글의 범위를 벗어난다.
최초 게시일: 2025년 10월 27일 월요일
관련 기사
 Base44, 방어력을 강화하는 고유 AI 모델을 vibe 코딩 플랫폼에 공개
Base44은 1년 전, 팀이 8명으로 구성되고 설립된 지 불과 6개월 된 상태였을 때 Wix로부터 8,000만 달러에 인수된 vibe 코딩 플랫폼으로, 이제 자연어를 사용하여 애플리케이션을 구축할 수 있도록 자체 AI 모델을 배포하기 시작했습니다.이러한 developments는 최첨단 모델이 모든 사용 사례에 최적인지, 그리고 외부 모델에 의존하는 기업들이 장기적인 방어력을 유지할 수 있는지에 대해 AI 커뮤니티가 논쟁을 벌이는 시점에 이루
멀티버스 컴퓨팅, 무료 압축 생성형 AI 모델 출시
대규모 언어 모델은 상당한 과제에 직면해 있습니다: 바로 그 방대한 규모입니다. 스페인 스타트업 멀티버스 컴퓨팅(Multiverse Computing)은 최첨단 AI의 성능과 기업이 실질적으로 도입할 수 있는 수준 사이의 격차를 해소하기 위해 설계된 압축 모델을 개발함으로써 이 문제를 해결하고 있습니다.핵심 혁신은 양자 컴퓨팅 원리에서 영감을 받은 압축 기
인공지능 시스템, 터무니없는 과학 논문을 승인하도록 속아넘어갔다
새로운 연구에 따르면, 인공지능 시스템이 이제 다른 인공지능 모델들이 진품으로 오인하는 사기성 과학 논문을 생성할 수 있게 되었다. 이러한 조작된 연구들은 기존에 효과적이었던 탐지 방법을 우회하며, 연구 생태계가 봇이 다른 봇을 속이는 악순환으로 붕괴될 위험성을 부각시키고 있다. 아이러니하게도 AI 혁신의 최전선에 있는 학술 연구 분야가 AI에 의해 촉발된
관련 특별 주제 추천
음악 작곡
 리믹스 제작, 샘플링 준비, 카라오케 마스터 파일 제작을 위한 AI 스템 분리 도구
2026년 최신형으로 선정된 최고 평점의 AI 스템 분리 도구들은 리믹스 제작, 샘플링 준비, 카라오케 녹음에 특화되어 있습니다. 이 강력하고 혁신적인 도구들은 실제 환경에서의 테스트를 거쳐 정밀한 오디오 분리 기능을 제공함으로써 작업 효율성을 크게 향상시켜 줍니다. XIX.AI는 매주 업데이트되는 무료 버전과 유료 버전의 비교 가이드를 제공하여 사용자의 니즈에 가장 적합한 도구를 찾는 데 도움을 줍니다. 지금 바로 확인하여 AI 기술의 잠재력을 최대한 활용해 보세요.
 8 도구
 xix.ai
데이터 분석
수익 대시보드, 퍼널 분석, 그리고 제품 지표를 위한 AI SQL 코파일럿
2026년 최신 최고의 AI SQL 코파일럿들이 최상위 순위에 올랐습니다! XIX.AI는 매주 업데이트되는 실제 환경 테스트를 위해 강력하고 혁신적인 도구들을 선별하여 제공합니다. 반드시 사용해 보아야 할 이 도구들은 정확한 수익 대시보드를 생성하고, 판매 과정을 분석하며, 제품 관련 지표를 신속하게 추적할 수 있도록 도와 생산성을 크게 향상시켜 줍니다. 데이터 기반 의사결정을 위한 완벽한 도구를 찾아보세요! 238자
9 도구
xix.ai
음악 작곡
노래 초안을 위한 최고의 AI 멜로디 작곡 도구
2026년 최신 최고 인기 AI 멜로디 작곡 도구! XIX.AI는 엄격한 실전 테스트를 거쳐 최고의 작곡 경험을 제공하는 강력한 게임 체인저 컬렉션을 엄선했습니다. 무료와 유료 버전의 상세 비교, 정확한 순위, 그리고 놀라운 노래 초안을 손쉽게 만들고 창의적 생산성을 크게 높일 수 있는 필수 추천 옵션들을 확인할 수 있습니다. 지금 바로 탐색하여 완벽한 도구를 발견하세요!
8 도구
xix.ai
챗봇
면접 연습을 위한 최고의 AI 대화 트레이너 도구
2026년 최신 최고의 평점 높은 AI 대화 트레이너 도구들이 XIX.AI에서 만나보세요! 면접 연습을 위한 이 엄선된 컬렉션은 강력한, 게임 체인저 도구들을 포함하고 있으며, 엄격한 실제 세계 테스트를 거쳐 정확한 피드백을 제공합니다. 무료 대 유료 비교와 상세한 순위표를 찾을 수 있어 자신감과 기술을 향상시킬 수 있는 꼭 시도해봐야 할 옵션을 선택하는 데 도움이 됩니다. 지금 탐색하여 면접 성공을 위한 완벽한 도구를 발견하세요!
12 도구
xix.ai
디자인과 예술
창의적인 실험을 위한 최고의 AI 스타일 변환 도구
2026년 최신, 최고 평점을 받은 창의적 실험을 위한 AI 스타일 변환 도구! XIX.AI는 실제 테스트와 엄격한 평가를 통해 탁월한 결과를 보여주는, 강력하고 판도를 바꿀 만한 ‘꼭 사용해 봐야 할’ 도구들을 엄선했습니다. 이 최고의 솔루션들은 콘텐츠 제작 속도를 높이고 무한한 창의적 가능성을 열어줌으로써 크리에이터들의 생산성을 크게 높여줍니다. 지금 바로 탐색하여 나에게 딱 맞는 도구를 찾아보고, 오늘 바로 창작을 시작해 보세요!
9 도구
xix.ai
만화 창작
시각적 스토리텔링을 위한 최고의 AI 대화 풍선 도구
2026년 시각적 스토리텔링을 위한 최신 최고 평점의 AI 대화 풍선 도구가 XIX.AI에 소개됩니다! 이 엄선된 모음집에는 크리에이터들이 생산성을 높이고 창의적인 난관을 극복하는 데 도움을 주는, 강력하고 획기적인 도구들이 포함되어 있습니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 실제 테스트 결과를 살펴보며, 최신 순위를 통해 매력적인 시각적 이야기를 만드는 데 꼭 필요한 솔루션을 찾아보세요. 지금 바로 탐색하여 여러분에게 딱 맞는 도구를 발견해 보세요!
10 도구
xix.ai

 의견 (3)
0/500
![JackSanchez]()
這技術真有意思!能在不重訓練的情況下給AI模型加水印,還幾乎無法移除,感覺對保護原創者權益很有幫助。不過會不會反而被濫用來追蹤用戶啊?有點擔心隱私問題⋯⋯😅
![BenJackson]()
Wow, dieses Thema mit unsichtbaren Wasserzeichen für KI-Modelle klingt wie etwas aus einem Spionagefilm! 🤯 Der Unterschied zu ‚Copyright-Baiting‘ ist echt wichtig – es geht ja um langfristigen Schutz, nicht nur ums Fangen. Aber was, wenn dieses Werkzeug selbst missbraucht wird? Irgendwie bemerkenswert, was technisch möglich ist, und ein bisschen gruselig zugleich.
![AnthonyPerez]()
Increíble técnica, pero ¿qué tan seguro es que no afecte el rendimiento del modelo en tareas reales? 🤔 Me preocupa que estas medidas puedan usarse también para restringir el acceso a IA de código abierto. ¿Y si una empresa alega falsamente protección de marca de agua? ¡El debate ético apenas comienza!
새로운 방법은 재훈련 없이도 ChatGPT와 같은 모델에 몇 초 만에 보이지 않는 워터마크를 적용할 수 있으며, 표준 출력물에 흔적을 남기지 않고 모든 실질적인 제거 시도를 견딥니다.
워터마킹과 '저작권 유인(copyright-baiting)'의 핵심 차이점은 워터마크(가시적이든 숨겨진 것이든)는 일반적으로 이미지 데이터셋과 같은 컬렉션 전체에 걸쳐 나타나도록 설계되어 무분별한 복사를 지속적으로 억제한다는 점입니다.
반면, 허위 항목은 대규모 일반 컬렉션 내에 배치된 작은 텍스트 조각(주로 단어나 정의)으로, 도용을 입증하기 위한 목적입니다. 핵심은 전체 저작물이 무단으로 복제되거나(직접적 복제 또는 파생 저작물 기반) 원작자가 심어둔 고유한 허위 사실이 존재할 경우 도용을 쉽게 드러낸다는 점입니다.
대규모 언어 모델(LLM) 및 비전 언어 모델(VLM)에 워터마킹을 적용할 때, 출력물에 이러한 마커가 포함되는 정도는 일반적으로 두 가지 범주로 나뉩니다: 모든 또는 대부분의 출력물에 명백하거나 숨겨진 워터마크를 포함하도록 보장하는 경우; 또는 모델의 일반 출력물에는 나타나지 않으면서도 도용을 증명하기 위해 복구 가능한 '비밀 토큰'을 임베딩하는 경우입니다.
증거의 무게
후자의 접근법은 중국, 이탈리아, 싱가포르 연구진 간의 새로운 협업에서 탐구되었습니다. 이 연구는 오픈소스 모델에 대한 공개 방법을 제공하여 무단 상업화나 원본 라이선스 조건을 벗어난 사용을 방지하는 것을 목표로 합니다.
예를 들어, 모델의 원래 라이선스는 누구나 동일한 관대한 조건으로 수정 사항을 공유하는 한 수익을 창출할 수 있도록 허용할 수 있습니다. 그러나 기업은 불공정한 이점을 창출하기 위해 조정 사항(예: 미세 조정된 버전)을 비공개로 유지하려고 시도할 수 있습니다.
이 분야의 대부분의 연구는 폐쇄형 소스, API 전용 모델 또는 최적화된(양자화된) 가중치만 제공되는 모델에서 오용을 탐지하는 데 집중되어 있습니다. 이러한 모델들은 모델 아키텍처에 대한 접근이 제한되어 있어 본 논문의 접근법으로 효율적으로 수정하기 어렵습니다.
FOSS 공개에 대한 이러한 초점은 중국 연구계의 특성상 예상된 바일 수 있다. 지난 1년간 중국의 AI 성과는 제한적인 서양 모델과 경쟁할 만한 관대한 전체 가중치* 모델 공개로 특징지어졌기 때문이다.
EditMark라는 새로운 접근법은 '오염된' 데이터를 추가하기 위한 미세 조정이나 해당 데이터를 포함하여 처음부터 훈련할 필요가 없다는 점에서 두드러집니다.
이는 여러 장점을 제공합니다: 첫째, 훈련 세트에 포함된 '단서가 되는' 데이터는 발견 및 공개되면 공격자가 직접 표적으로 삼을 수 있기 때문에 무효화됩니다. 그러나 EditMark를 공격하려면 악의적인 행위자가 표적 모델 레이어와 사용된 방법을 알아야 하는데, 이는 발생 가능성이 낮은 시나리오입니다.
둘째, 이 방법은 빠르고 저렴하며, 훈련된 모델에 적용하는 데 단 몇 초(며칠 또는 몇 주가 아닌)만 소요되어 모델 및 데이터 크기에 따라 증가하는 높은 비용의 미세 조정을 피할 수 있습니다.
마지막으로, 이 접근법은 모델의 정상적인 운영에 미치는 방해가 미세 조정이나 기존 편집 방법에 비해 현저히 적습니다.
테스트에서 EditMark는 모델 가중치에 여러 가능한 답이 있는 수학적 쿼리를 포함시켜 100% 추출률을 달성했습니다.
저자들은 다음과 같이 밝혔습니다:
'포괄적인 실험을 통해 EditMark가 대규모 언어 모델(LLM) 워터마킹에서 탁월한 성능을 입증했습니다. 32비트 워터마크를 20초 미만에 삽입하면서도 100% 추출 성공률(ESR)을 달성하는 놀라운 효율성을 보여줍니다.
특히 워터마크 삽입 시간이 파인 튜닝(평균 6,875초 소요)에 비해 1/300 미만으로 단축되어, EditMark가 전례 없는 속도와 신뢰성으로 대용량 워터마크를 구현할 수 있음을 입증합니다.
'또한 광범위한 실험을 통해 EditMark의 견고성, 은닉성 및 충실도가 입증되었습니다.'
이 새로운 논문은 'EditMark: 모델 편집 기반의 대규모 언어 모델 워터마킹(EditMark: Watermarking Large Language Models based on Model Editing )'이라는 제목으로, 중국과학기술대학, 시에나 대학, 싱가포르 CFAR/IHPC/A*STAR의 8명의 저자가 공동 집필했습니다.
방법
EditMark 접근법은 생성기( Generator), 인코더( Encoder), 편집기(Editor), 디코더(Decoder)의 네 가지 구성 요소로 이루어집니다:

EditMark 파이프라인은 모델을 편집하여 특정 수학 문제를 답하는 방식으로 워터마크를 삽입하며, 이 과정에서 숨겨진 식별 정보를 인코딩합니다. 출처: https://arxiv.org/pdf/2510.16367
생성기는 의사 난수 시드를 사용하여 다중 선택형 수학 문제를 생성합니다. 인코더는 워터마크에 기반하여 답안을 선택한 후, 특수 편집 과정을 통해 모델에 이를 임베딩합니다. 편집된 모델이 공개되거나 오용될 경우, 동일한 질문을 제시하고 응답 패턴을 디코딩함으로써 워터마크를 추출할 수 있습니다.
에디터는 모델 가중치를 수정하여 시드 질문에 대해 모델이 일관되게 목표 답변을 생성하도록 하여 워터마크를 모델 동작에 직접 내장합니다. 디코더는 의심 모델에 동일한 질문을 입력하고 그 답변을 숨겨진 서명으로 역변환하여 워터마크를 복구합니다.
위협 모델
본 논문의 위협 모델은 워터마킹이 화이트박스 환경에서 수행된다고 가정합니다. 이는 보안 연구에서 흔히 우려되는 사항이지만, 본 방법은 자신의 작업물에 대한 완전한 접근 권한을 가진 소유자를 보호하는 것을 목표로 하므로 여기서는 정상적인 가정입니다.
공격자 역시 모델 획득 후 화이트박스 접근 권한을 가진 것으로 가정됩니다. 즉, 모델을 수정(예: 프루닝 또는 파인 튜닝)할 수 있습니다. 이는 FOSS(자유 및 오픈소스 소프트웨어) 배포 시 전형적인 시나리오입니다. 그러나 공격자는 워터마크 추출 과정이나 스키마를 알지 못하며, 실험이나 유출을 통해서만 이를 추론할 수 있습니다.
생성기는 논리적·사실적으로 타당한 수학 문제를 생성하며, 다수의 정답을 포함합니다. GPT‑4o를 활용해 템플릿을 다양화하고(아래 예시 참조), 의사 난수 시드를 사용해 각 문제가 고유하도록 보장합니다. 이를 통해 알려진 워터마크를 정답 순열을 통해 결정론적으로 삽입할 수 있으며, 문제 중복을 최소화하여 편집 얽힘을 방지합니다:

워터마크 삽입을 위해 GPT-4o가 생성한 문제 템플릿. 각 템플릿은 시드화된 부등식에서 여러 유효한 정수 답을 도출하도록 구조화됨.
인코더는 각 이진 워터마크 세그먼트를 주어진 수학 문제의 해답 집합에서 정수의 고유한 순열로 변환합니다. 사전순 순열 이론을 활용하여 인코더는 각 워터마크 청크의 십진수 값을 특정 순서의 해답 선택으로 매핑함으로써 워터마크가 모델 동작에 결정론적으로 내장되도록 보장합니다.
에디터와 관련하여, 워터마킹에 사용된 기존 AlphaEdit 모델 편집 방식은 정밀도와 내구성이 모두 부족하여 요구되는 답을 생성하지 못하는 경우가 많습니다. 이 방식이 가한 변경 사항은 정제(pruning)나 노이즈에 의해 쉽게 무력화됩니다.
이를 해결하기 위해 저자들은 단일 MLP 계층에서 모델 가중치를 점진적으로 조정하여 응답이 원하는 답과 일치할 때까지 다단계 편집 전략을 개발했습니다. 편집을 변조로부터 강화하기 위해 훈련 중 가우시안 노이즈를 주입하여 공격을 시뮬레이션합니다:

공격 전후 Baichuan-7B, Qwen-7B, LLaMA3-8B의 K1 변화 분포. 상단 행은 무작위 노이즈 주입 효과, 하단 행은 모델 프루닝 효과를 보여줍니다. 모든 변화가 0에 근접하여 공격이 모델 내부 동작을 크게 방해하지 않음을 시사합니다.
점수 체계는 편집 정확도가 충분히 높아지면 프로세스를 중단하며, 정규화는 여러 라운드에 걸쳐 업데이트가 안정적으로 유지되도록 보장합니다.
디코더는 워터마킹 시 사용된 것과 동일한 특수 질문을 모델에 제시한 후, 답변을 읽어 숨겨진 ID를 추론합니다. 답변 패턴이 비밀 규칙을 따르기 때문에, 이 ID는 모델 내부 구조를 검사하지 않고도 복구할 수 있습니다.
데이터 및 테스트
EditMark 평가를 위해 다섯 가지 LLM을 테스트했습니다: GPT2-XL; GPT-J-6B; LLaMA-3-8B; Baichuan-7B; Qwen-7B. 앞서 언급한 AlphaEdit를 워터마크 임베딩에 사용했으며, 추출 성공률(ESR)과 임베딩 시간(ET)을 지표로 삼았습니다.
기준선으로 저자들은 Model Watermark(백도어), KIMark, 그리고 본 프로젝트에 적용된 백도어 주입용으로 설계된 프레임워크인 BadEdit를 선택했습니다.
저자들은 LLaMA-3-8B의 15번째 레이어, GPT2-XL 및 GPT-J-6B의 17번째 레이어, Qwen-7B 및 Baichuan-7B의 14번째 레이어를 편집했습니다.
실험은 32비트, 64비트, 128비트 길이의 워터마크를 삽입하여 4개의 NVIDIA RTX 4090 GPU(각각 24GB VRAM)에서 수행되었습니다. 사용된 질문 템플릿은 아래와 같습니다:

워터마킹용 다중 답변(MA) 문제 생성에 사용된 템플릿. 각 문제는 서로 다른 유형의 수학적 부등식을 기반으로 하며, 변수에는 임의의 값이 삽입됩니다. 모델은 정수 해의 목록을 반환하도록 요청받으며, 답변의 순서는 워터마크 비트 인코딩 또는 디코딩에 사용됩니다. 네 가지 템플릿은 2차, 로그, 유리수, 구간 기반 형태를 다루며, 모두 GPT-4o를 사용하여 생성되었습니다.
무작위성 영향을 줄이기 위해, 다양한 워터마킹 용량에 걸쳐 테스트 시 1부터 20까지의 시드(seed)를 적용했습니다.
연구진은 초기 단계에서 LLM 전반에 걸쳐 워터마크 삽입의 ESR(추출 성공률)과 시간 비용을 모두 테스트했습니다:

다섯 가지 대규모 언어 모델에서 EditMark와 기존 세 가지 워터마킹 기법의 비교. 추출 성공률(ESR)과 임베딩 시간(ET, 초 단위)을 보고합니다. EditMark는 일관되게 100% 성공률을 달성하면서 임베딩 시간을 수십 배 단축시켜, 다양한 규모와 아키텍처의 모델 전반에서 정확도와 효율성 모두에서 모든 기준선을 능가합니다.
이러한 결과에 대해 저자들은 다음과 같이 언급합니다:
'[EditMark]은 평가된 모든 LLM에서 32비트 워터마크를 삽입하는 데 100% ESR을 달성하며 20초 미만의 시간이 소요됩니다. 특히 Baichuan-7B와 Qwen-7B의 평균 삽입 시간은 10초 미만으로 EditMark의 높은 효율성을 입증합니다.'
해당 방식에서 가능한 최대 값인 128비트 워터마크의 경우, EditMark는 '지워지지 않음'을 유지했습니다:

5개 언어 모델에서 32비트, 64비트, 128비트 워터마크 길이에 따른 EditMark의 추출 성공률 및 임베딩 시간. 모든 경우 완벽한 성공률을 유지하며, 임베딩 시간은 워터마크 크기에 따라 증가하나 128비트에서도 1분 미만으로 유지됩니다.
다음으로, 시스템의 워터마크 충실도 유지 능력을 여러 벤치마크에서 테스트했습니다:

다섯 모델에 걸쳐 네 가지 벤치마크에서 워터마크 충실도 평가. 수정되지 않은 모델과 32비트 및 128비트 용량으로 워터마크 처리된 모델 비교. 구성 전반에 걸쳐 성능은 안정적으로 유지되었으며, 평균 점수에서 미미한 변동만 관찰되어 워터마크 삽입이 벤치마크 정확도에 미치는 영향이 제한적임을 나타냄.
EditMark의 내구성은 여섯 가지 일반적인 공격 전략에 대해 테스트되었습니다. 모델은 먼저 다섯 가지 다른 시드를 사용하여 128비트 워터마크로 임베딩되었습니다. 아래와 같이 보여지는 것처럼, 대부분의 모델에서 미세 조정(fine-tuning)은 추출 성공률(ESR)에 약간의 저하만을 초래했습니다:

1~3 에포크 동안 미세 조정 전후 워터마크 적용 LLM의 추출 성공률(ESR). 대부분의 모델은 전반적으로 높은 ESR을 유지했으나, Qwen-7B는 현저한 하락을 보여 매개변수 업데이트에 대한 취약성이 더 큼을 시사합니다.
여러 에포크 후에도 대부분의 모델은 90% 이상의 ESR을 유지하여 EditMark가 LoRA 기반 훈련의 매개변수 드리프트에 저항함을 보여주었다.
양자화 공격은 모델 정밀도를 저하시켰으나 대부분의 워터마크는 무사했습니다:

Int-8 및 Int-4 정밀도를 사용한 양자화 전후 워터마크 적용 모델의 추출 성공률(ESR). 모든 모델에서 Int-8 양자화 시 ESR은 변함없었으나, Int-4 양자화는 부분적 저하를 초래하여 낮은 정밀도가 워터마크를 약화시킬 수는 있으나 완전히 제거하지는 못함을 나타냄.
위에서 보듯이 Int-8 양자화는 모든 모델에서 100% ESR을 유지한 반면, Int-4 양자화는 ESR에 중간 정도의 영향을 미쳤으나 허용할 수 없는 성능 저하를 초래했습니다.
본 논문은 해킹된 모델이 성능 저하를 동반한다는 점에서 공격자에게 제한된 잠재력만을 제공한다고 지적합니다.
노이즈 및 프루닝 테스트는 MMLU, BLIMP, TruthfulQA, GLUE 네 가지 벤치마크 프레임워크를 평가했습니다. 이러한 공격은 교란이 심화될수록 ESR을 감소시켰습니다:

노이즈(상단 행) 및 프루닝(하단 행) 공격이 ESR과 워터마크 적용 모델의 벤치마크 성능에 미치는 영향. 교란 증가에 따라 ESR이 하락함에 따라 벤치마크 정확도도 저하되었으며, 특히 높은 노이즈 강도와 프루닝 비율에서 두드러졌습니다. 이는 워터마크 제거와 모델 유용성 사이의 (관례적인) 긴장 관계를 부각시킵니다.
그러나 이는 작업 성능의 급격한 저하를 동반했으며, Baichuan-7B는 노이즈나 프루닝이 적용될 때 BLIMP에서 27-31%의 성능 하락을 경험했습니다.
모델 편집 및 적응형 공격도 평가되었습니다:

다양한 수준의 모델 편집을 적용한 워터마크 모델의 추출 성공률. 알려진 워터마크 레이어에 최대 50회의 편집을 가했음에도 모든 모델에서 ESR은 95% 이상을 유지하여, 직접적인 매개변수 수정이 워터마크 제거에 미치는 영향이 제한적임을 나타냅니다.
여기서 EditMark는 정확한 임베딩 레이어를 표적으로 삼았을 때에도 95% 이상의 ESR을 유지했습니다.
결론
DRM, 비밀 워터마크 및 기타 보안 조치는 AI 이전 시대에 제한된 성공을 거두었으며, 머신러닝 시스템에 적용하기 어렵습니다. 현재 호스트 아키텍처의 의도적으로 단순화된 특성과 적합한 도구의 부재가 결합되어 주입된 워터마크는 상대적으로 취약합니다.
공격자의 사전 지식을 고려할 때, 가장 발생 가능성이 낮은 공격 시나리오를 제외한 모든 공격을 견디는 FOSS 모델 배포를 목표로 하는 시스템을 보는 것은 인상적입니다. 그러나 훈련 후 편집으로 인한 성능 저하는 이 실험에서 미미하지만, 잠재적 도입자들에게 주저하게 만들 수 있습니다. 특히 API 중심 제어 모델로 되돌리면 이러한 공격을 거의 완전히 피할 수 있기 때문입니다.
* 이 사이트는 중국의 '공개 가중치' 공개가 데이터가 종종 숨겨져 훈련 파이프라인의 정확한 재현을 방해하기 때문에 완전한 FOSS로 인정받기 어려울 수 있다고 주장해왔다. 이 주
* 본 사이트는 중국의 '오픈 웨이트' 공개가 데이터가 종종 공개되지 않아 훈련 파이프라인의 정확한 재현을 방해하므로 완전한 FOSS로 인정받기 어렵다고 주장해왔다. 이 주제는 동서양 간 AI 모델 공개의 정치적 측면에 대한 심층적 검토를 요구하나, 이는 본 글의 범위를 벗어난다.
최초 게시일: 2025년 10월 27일 월요일








 Base44, 방어력을 강화하는 고유 AI 모델을 vibe 코딩 플랫폼에 공개
Base44은 1년 전, 팀이 8명으로 구성되고 설립된 지 불과 6개월 된 상태였을 때 Wix로부터 8,000만 달러에 인수된 vibe 코딩 플랫폼으로, 이제 자연어를 사용하여 애플리케이션을 구축할 수 있도록 자체 AI 모델을 배포하기 시작했습니다.이러한 developments는 최첨단 모델이 모든 사용 사례에 최적인지, 그리고 외부 모델에 의존하는 기업들이 장기적인 방어력을 유지할 수 있는지에 대해 AI 커뮤니티가 논쟁을 벌이는 시점에 이루
 멀티버스 컴퓨팅, 무료 압축 생성형 AI 모델 출시
대규모 언어 모델은 상당한 과제에 직면해 있습니다: 바로 그 방대한 규모입니다. 스페인 스타트업 멀티버스 컴퓨팅(Multiverse Computing)은 최첨단 AI의 성능과 기업이 실질적으로 도입할 수 있는 수준 사이의 격차를 해소하기 위해 설계된 압축 모델을 개발함으로써 이 문제를 해결하고 있습니다.핵심 혁신은 양자 컴퓨팅 원리에서 영감을 받은 압축 기
 인공지능 시스템, 터무니없는 과학 논문을 승인하도록 속아넘어갔다
새로운 연구에 따르면, 인공지능 시스템이 이제 다른 인공지능 모델들이 진품으로 오인하는 사기성 과학 논문을 생성할 수 있게 되었다. 이러한 조작된 연구들은 기존에 효과적이었던 탐지 방법을 우회하며, 연구 생태계가 봇이 다른 봇을 속이는 악순환으로 붕괴될 위험성을 부각시키고 있다. 아이러니하게도 AI 혁신의 최전선에 있는 학술 연구 분야가 AI에 의해 촉발된

2026년 최신형으로 선정된 최고 평점의 AI 스템 분리 도구들은 리믹스 제작, 샘플링 준비, 카라오케 녹음에 특화되어 있습니다. 이 강력하고 혁신적인 도구들은 실제 환경에서의 테스트를 거쳐 정밀한 오디오 분리 기능을 제공함으로써 작업 효율성을 크게 향상시켜 줍니다. XIX.AI는 매주 업데이트되는 무료 버전과 유료 버전의 비교 가이드를 제공하여 사용자의 니즈에 가장 적합한 도구를 찾는 데 도움을 줍니다. 지금 바로 확인하여 AI 기술의 잠재력을 최대한 활용해 보세요.
8 도구
xix.ai

2026년 최신 최고의 AI SQL 코파일럿들이 최상위 순위에 올랐습니다! XIX.AI는 매주 업데이트되는 실제 환경 테스트를 위해 강력하고 혁신적인 도구들을 선별하여 제공합니다. 반드시 사용해 보아야 할 이 도구들은 정확한 수익 대시보드를 생성하고, 판매 과정을 분석하며, 제품 관련 지표를 신속하게 추적할 수 있도록 도와 생산성을 크게 향상시켜 줍니다. 데이터 기반 의사결정을 위한 완벽한 도구를 찾아보세요! 238자
9 도구
xix.ai

2026년 최신 최고 인기 AI 멜로디 작곡 도구! XIX.AI는 엄격한 실전 테스트를 거쳐 최고의 작곡 경험을 제공하는 강력한 게임 체인저 컬렉션을 엄선했습니다. 무료와 유료 버전의 상세 비교, 정확한 순위, 그리고 놀라운 노래 초안을 손쉽게 만들고 창의적 생산성을 크게 높일 수 있는 필수 추천 옵션들을 확인할 수 있습니다. 지금 바로 탐색하여 완벽한 도구를 발견하세요!
8 도구
xix.ai

2026년 최신 최고의 평점 높은 AI 대화 트레이너 도구들이 XIX.AI에서 만나보세요! 면접 연습을 위한 이 엄선된 컬렉션은 강력한, 게임 체인저 도구들을 포함하고 있으며, 엄격한 실제 세계 테스트를 거쳐 정확한 피드백을 제공합니다. 무료 대 유료 비교와 상세한 순위표를 찾을 수 있어 자신감과 기술을 향상시킬 수 있는 꼭 시도해봐야 할 옵션을 선택하는 데 도움이 됩니다. 지금 탐색하여 면접 성공을 위한 완벽한 도구를 발견하세요!
12 도구
xix.ai

2026년 최신, 최고 평점을 받은 창의적 실험을 위한 AI 스타일 변환 도구! XIX.AI는 실제 테스트와 엄격한 평가를 통해 탁월한 결과를 보여주는, 강력하고 판도를 바꿀 만한 ‘꼭 사용해 봐야 할’ 도구들을 엄선했습니다. 이 최고의 솔루션들은 콘텐츠 제작 속도를 높이고 무한한 창의적 가능성을 열어줌으로써 크리에이터들의 생산성을 크게 높여줍니다. 지금 바로 탐색하여 나에게 딱 맞는 도구를 찾아보고, 오늘 바로 창작을 시작해 보세요!
9 도구
xix.ai

2026년 시각적 스토리텔링을 위한 최신 최고 평점의 AI 대화 풍선 도구가 XIX.AI에 소개됩니다! 이 엄선된 모음집에는 크리에이터들이 생산성을 높이고 창의적인 난관을 극복하는 데 도움을 주는, 강력하고 획기적인 도구들이 포함되어 있습니다. 무료 버전과 유료 버전의 비교 정보를 확인하고, 실제 테스트 결과를 살펴보며, 최신 순위를 통해 매력적인 시각적 이야기를 만드는 데 꼭 필요한 솔루션을 찾아보세요. 지금 바로 탐색하여 여러분에게 딱 맞는 도구를 발견해 보세요!
10 도구
xix.ai

這技術真有意思!能在不重訓練的情況下給AI模型加水印,還幾乎無法移除,感覺對保護原創者權益很有幫助。不過會不會反而被濫用來追蹤用戶啊?有點擔心隱私問題⋯⋯😅
Wow, dieses Thema mit unsichtbaren Wasserzeichen für KI-Modelle klingt wie etwas aus einem Spionagefilm! 🤯 Der Unterschied zu ‚Copyright-Baiting‘ ist echt wichtig – es geht ja um langfristigen Schutz, nicht nur ums Fangen. Aber was, wenn dieses Werkzeug selbst missbraucht wird? Irgendwie bemerkenswert, was technisch möglich ist, und ein bisschen gruselig zugleich.
Increíble técnica, pero ¿qué tan seguro es que no afecte el rendimiento del modelo en tareas reales? 🤔 Me preocupa que estas medidas puedan usarse también para restringir el acceso a IA de código abierto. ¿Y si una empresa alega falsamente protección de marca de agua? ¡El debate ético apenas comienza!












