


 首页
Deep Cogito发布四款开源混合推理模型,具备自我提升的直觉能力
由前谷歌工程师创立的旧金山人工智能初创公司Deep Cogito,近日发布了四款新型"半开放式"大型语言模型(LLMs)。这些模型致力于攻克关键挑战:在持续学习过程中提升推理效率,并逐步实现自主能力增强。
该系列模型统称为Cogito v2家族,参数规模从700亿至6710亿不等。开发者和企业可通过混合许可协议获取这些模型,包含宽松许可与完全开放许可两种形式。本次发布的模型包括:
- Cogito v2-70B(密集型)
- Cogito v2-109B(专家混合模型)
- Cogito v2-405B(全连接网络)
- Cogito v2-671B(专家混合模型)
密集型与专家混合型模型各具特色。密集型变体(70B和405B)对每个输入激活全部参数,确保预测结果可预测且易于在不同硬件环境部署。
它们适用于低延迟任务、微调场景及GPU资源受限的环境。相比之下,MoE模型(109B和671B)采用稀疏路由机制,每次查询仅激活特定子集的"专家"子网络。这种设计支持大幅扩展模型规模,同时避免计算成本的线性增长。
因此,MoE模型在高性能推理和复杂推理研究中表现卓越,以更低的运行成本实现顶级准确率。在Cogito v2系列中,671B MoE模型作为旗舰产品,凭借其规模和高效路由能力,在基准测试中与领先的开源模型持平或超越——且推理链通常更短。
企业用户现可通过Hugging Face获取模型,本地部署则支持Unsloth平台。无法自建服务器的用户可通过Together AI、Baseten及RunPod获取API接口。
671B模型还提供FP8量化版本(8位浮点精度)。通过将参数精度从16位降至8位,该版本实现了更快速、更经济且更易部署的硬件支持,通常能保持95%至99%的原始性能。但在需要高精度的任务(如特定数学或推理问题)中,准确率可能略有下降。
所有四款Cogito v2模型均为混合推理系统:既能即时作答,亦可在必要时进行内部反思后再作回应。
这种反思不仅是推理时的特性——它本身就是训练过程的组成部分。
模型经过训练能够内化推理路径。它们得出解决方案的步骤——即内部"思维过程"——会被提炼回模型的基础权重中。
随着时间推移,它们学会了区分有效的推理路径与无关的推理路径。
正如 Deep Cogito 博客所述,研究人员不鼓励模型通过"更多地徘徊"来寻找答案。相反,他们鼓励模型培养对最高效推理路径的更强直觉。
Deep Cogito 指出,其成果是实现更快速、更高效的推理,即使在标准操作模式下也能带来广泛的性能提升。
通往自我进化AI之路
尽管在更广泛的人工智能领域相对较新,Deep Cogito 其实已研发其技术一年有余。
该公司于2025年4月以开源形式推出基于Meta Llama 3.2的模型。这些初始模型在2024年11月获得Benchmark领投的1300万美元种子轮融资后,展现出令人鼓舞的成果。Benchmark合伙人Eric Vishria随后加入公司董事会。
据VentureBeat此前报道,Cogito v1系列最小规模模型(30亿和80亿参数)在多项基准测试中持续超越同类Llama 3模型,优势往往显著。
Deep Cogito首席执行官兼联合创始人德里尚·阿罗拉(前谷歌大型语言模型首席工程师)阐述公司愿景:构建能通过迭代精进推理能力的模型,其进化机制类似AlphaGo通过自我对弈实现的自我提升。
该方法的核心是迭代蒸馏与增强(IDA),通过模型自身不断进化的洞察力取代静态训练提示。
理解机器直觉
Cogito v2版本大幅扩展了这种自我改进循环。其基础理念很简单:推理能力应融入模型核心智能,而非仅在推理阶段激活。
为此,该公司构建了模型在训练过程中生成推理链,并从自身中间思维过程学习的系统。
内部基准测试证实了显著提升:旗舰级671B MoE模型在推理任务上超越DeepSeek R1,其推理链平均长度缩短60%,却能匹敌甚至超越后者最新的0528模型。
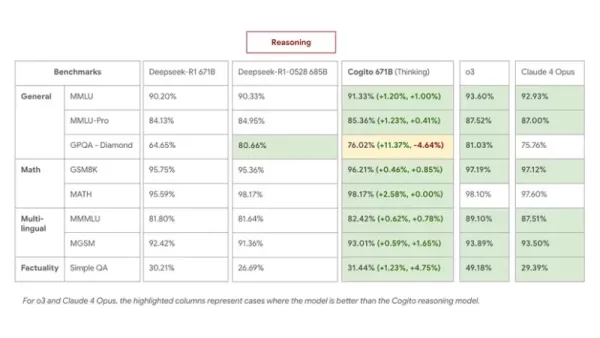
在MMLU、GSM8K和MGSM等基准测试中,Cogito 671B MoE模型与Qwen1.5-72B、DeepSeek v3等顶尖开源模型表现相当,其性能已逼近Claude 4 Opus和o3等闭源模型。
关键发现包括:
- 推理模式下,Cogito 671B MoE在多语言问答和常识领域与DeepSeek R1 0528持平,并在策略规划与逻辑演绎方面实现超越。
- 在标准(非推理)模式下,其性能超越DeepSeek v3 0324,证明即使不进行扩展推理步骤,蒸馏出的直觉仍能显著提升性能。
- 更少的推理步骤带来实际效益:复杂查询的推理成本降低,响应速度加快。
阿罗拉将此比喻为"盲目搜索目的地与已知方向"的差异。
他在X平台发文解释道:"由于Cogito模型在推理过程中能更精准地把握搜索轨迹,其推理链比DeepSeek R1缩短了60%。"
Deep Cogito模型的卓越之处:机器直觉的实践
Cogito v2内部测试案例印证了该能力。某数学题中,用户询问时速80英里的列车能否在2.5小时内行驶240英里。
多数模型会进行繁琐的分步计算且易出错,而Cogito 671B仅通过简短的内部推演,计算出240÷80=3小时,准确得出列车无法准时抵达的结论。其内部处理令牌数不足100个,远低于DeepSeek R1处理相同问题的200多个令牌。
在关于美国最高法院判例适用性的法律推理案例中,Cogito的推理模式采用清晰的两步逻辑:首先判定假设案例是否符合先例,随后论证结论依据。这种精细的解释性推理仍是多数大型语言模型面临的挑战。
该模型在处理模糊性方面也表现出进步。面对多跳问题(如确定亲属关系:"爱丽丝是鲍勃的母亲,鲍勃是查理的父亲。爱丽丝与查理是什么关系?"),Cogito v2模型能准确识别"祖母"——即使措辞稍有变化,其他开源模型常在此处出错。
实现规模化效率
值得注意的是,Deep Cogito报告称其八个Cogito模型(含v1系列)的总训练成本低于350万美元——仅为某些前沿模型九位数预算的零头。
该预算涵盖了大量数据生成、合成强化、基础设施以及 1,000 多次训练实验。
阿罗拉将这种成本效益归功于一个核心原则:构建更智能的模型取决于更强的基础理解("先验知识"),而非简单地喂给它们更多数据。
通过教导模型规避冗余或误导性的推理路径,Cogito v2在不增加推理时间或成本的前提下实现了强健性能——这对以延迟和成本为关键考量因素的API服务或边缘设备部署具有决定性优势。
展望未来:Deep Cogito的发展路线图
Cogito v2是迭代进程中的阶段性成果,而非终极产品。阿罗拉将公司方法比作"爬坡式进化":运行模型→学习推理过程→提炼经验→循环迭代。每次模型发布都基于前代成果持续进化。
Deep Cogito 坚持将所有现有及未来模型开源。其工作已获得 Benchmark 投资人 Eric Vishria 和 South Park Commons 投资人 Aditya Agarwal 等投资者的支持。
基础设施合作伙伴包括Hugging Face、Together AI、RunPod、Baseten、Meta旗下Llama团队及Unsloth。
开发者、研究人员及企业用户现可获取这些模型,用于本地部署、多模态对比及领域特定的微调。
对开源人工智能社区而言,Cogito v2不仅是基准测试的里程碑,更开创了智能构建的新范式:其核心不在于更努力地思考,而在于学习如何更高效地思考。
相关文章
 Lovable Leads Atech's Seed Round as AI Ambient Coding Officially Enters the Hardware Field
2026年5月14日,AI应用开发平台Lovable宣布参与丹麦硬件初创公司Atech的80万美元种子轮融资。该轮由Lovable领投,吸引了包括a16z Scout Fund、Sequoia Scout Fund以及Nordic Makers在内的顶级风险投资机构。此次投资标志着Lovable将“Vibe Coding”概念从纯软件开发战略扩展至硬件工程领域。Atech旨在通过AI驱动的交互式平台简化复杂的硬件原型制作。用户购买基础硬件套件,并通过AI聊天机器人以自然语言描述其设计概念;系统
Anthropic 将 Claude AI 编码工具扩展至日本,以推动海外增长
Anthropic,一家美国知名的人工智能公司,正加强其全球推广力度。周三,该公司在东京举办了一场大型开发者活动“Code with Claude”,吸引了近500名软件工程师参加。该举措旨在积极将Claude AI工具及相关产品引入日本市场,强调其自主编码能力在提升企业生产力方面的核心优势。强调自动化代码生成在活动中,Anthropic展示了其先进的自主编码系统,该系统能够独立处理复杂的编程任务并优化现有代码结构。随着全球对高效开发工具的需求不断增长,Anthropic希望通过此类活动加强
印度软件巨头缩减招聘,承诺随着 AI 代理规模扩大不裁员
随着人工智能重塑传统的劳动密集型商业模式,印度领先的软件外包公司塔塔咨询服务公司(TCS)公布了其战略应对措施。在周二的年度股东大会上,董事长概述了人机协作的愿景,并澄清了公司在人工智能时代的人力资源战略。不裁员,但招聘将放缓TCS董事长明确表示,公司没有因采用人工智能而裁员的计划,尽管整体招聘速度将放缓。虽然TCS此前减少了超过10,000名员工,但官员们强调,公司现在更倾向于通过自然流失来优化其人员结构,而非突然裁员。高层管理人员指出,以前由人类处理的重复性、机械性任务正不可避免地转向
相关专题推荐
设计与艺术
 最适合创意实验的AI风格转换工具
2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
 9 个工具
 xix.ai
漫画创作
最适合视觉叙事的AI对话气泡工具
2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai
会议助理
顶级AI会议摘要工具:清晰追踪决策与后续跟进
2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai
数据分析
最佳人工智能数据清洗工具:快速处理缺失值与重复数据
2026年最新、最优秀且评分最高的AI数据清洗工具,可快速处理缺失值与重复数据问题。这份精心挑选的清单展示了那些功能强大、能带来颠覆性变革的解决方案,可显著提升工作效率。所有候选工具都经过了严格的实际应用测试,以确保其稳定性。您可以获取免费版与付费版的对比信息,找出最符合您需求的必备工具。即刻访问XIX.AI,开启您的AI优势之旅。
11 个工具
xix.ai
设计与艺术
最佳AI创意构思工具,助力艺术家突破视觉瓶颈
2026 年最新最佳顶级评分 AI 创意构思工具由 XIX.AI 精心策划,旨在帮助创作者突破视觉瓶颈并即时提升创造力。这些强大的变革性工具提供真实世界测试、详细的免费与付费对比以及每周更新的排名。发现您的完美工具,加速内容创作,并立即释放您的 AI 优势。立即探索!
14 个工具
xix.ai
音乐创作
适用于 TikTok 背景音乐、Reels 音频和创作者宣传音乐的 AI 节拍生成器
2026年最新最全的AI节拍生成器,适用于TikTok背景音乐、Reels音频及创作者宣传音乐!XIX.AI精心筛选了一系列广受好评、功能强大的革命性工具,这些工具均经过实际测试,可为各类内容创作需求提供完美的音乐。 您将在此找到详尽的免费版与付费版对比数据、每周更新的排行榜,以及不容错过的精选工具,助您激发创意并提升工作效率。立即探索,发现最适合您的工具!
11 个工具
xix.ai

 评论 (3)
0/500
![LarryMitchell]()
Interesting move by Deep Cogito. But 'open-ish' sounds like a marketing term—how open is it really? Also, self-improving intuition sounds spooky. Are we building AI that can rewrite its own reasoning without oversight? 🤔
![JamesCarter]()
Interesting approach, but 'open-ish' sounds like a marketing gimmick. If the weights aren't fully open, how can the community truly verify their 'self-improving' claims? Feels like another startup trying to have its cake and eat it too. The intuition part is fascinating, though. 🤔
![WillieJones]()
¿Modelos auto-mejorables? Parece prometedor, pero siempre me pregunto: ¿cómo verifican que la intuición emergente no genere sesgos peligrosos o alucinaciones más sofisticadas? 🤔 Sería bueno ver más transparencia en los datos de entrenamiento.
由前谷歌工程师创立的旧金山人工智能初创公司Deep Cogito,近日发布了四款新型"半开放式"大型语言模型(LLMs)。这些模型致力于攻克关键挑战:在持续学习过程中提升推理效率,并逐步实现自主能力增强。
该系列模型统称为Cogito v2家族,参数规模从700亿至6710亿不等。开发者和企业可通过混合许可协议获取这些模型,包含宽松许可与完全开放许可两种形式。本次发布的模型包括:
- Cogito v2-70B(密集型)
- Cogito v2-109B(专家混合模型)
- Cogito v2-405B(全连接网络)
- Cogito v2-671B(专家混合模型)
密集型与专家混合型模型各具特色。密集型变体(70B和405B)对每个输入激活全部参数,确保预测结果可预测且易于在不同硬件环境部署。
它们适用于低延迟任务、微调场景及GPU资源受限的环境。相比之下,MoE模型(109B和671B)采用稀疏路由机制,每次查询仅激活特定子集的"专家"子网络。这种设计支持大幅扩展模型规模,同时避免计算成本的线性增长。
因此,MoE模型在高性能推理和复杂推理研究中表现卓越,以更低的运行成本实现顶级准确率。在Cogito v2系列中,671B MoE模型作为旗舰产品,凭借其规模和高效路由能力,在基准测试中与领先的开源模型持平或超越——且推理链通常更短。
企业用户现可通过Hugging Face获取模型,本地部署则支持Unsloth平台。无法自建服务器的用户可通过Together AI、Baseten及RunPod获取API接口。
671B模型还提供FP8量化版本(8位浮点精度)。通过将参数精度从16位降至8位,该版本实现了更快速、更经济且更易部署的硬件支持,通常能保持95%至99%的原始性能。但在需要高精度的任务(如特定数学或推理问题)中,准确率可能略有下降。
所有四款Cogito v2模型均为混合推理系统:既能即时作答,亦可在必要时进行内部反思后再作回应。
这种反思不仅是推理时的特性——它本身就是训练过程的组成部分。
模型经过训练能够内化推理路径。它们得出解决方案的步骤——即内部"思维过程"——会被提炼回模型的基础权重中。
随着时间推移,它们学会了区分有效的推理路径与无关的推理路径。
正如 Deep Cogito 博客所述,研究人员不鼓励模型通过"更多地徘徊"来寻找答案。相反,他们鼓励模型培养对最高效推理路径的更强直觉。
Deep Cogito 指出,其成果是实现更快速、更高效的推理,即使在标准操作模式下也能带来广泛的性能提升。
通往自我进化AI之路
尽管在更广泛的人工智能领域相对较新,Deep Cogito 其实已研发其技术一年有余。
该公司于2025年4月以开源形式推出基于Meta Llama 3.2的模型。这些初始模型在2024年11月获得Benchmark领投的1300万美元种子轮融资后,展现出令人鼓舞的成果。Benchmark合伙人Eric Vishria随后加入公司董事会。
据VentureBeat此前报道,Cogito v1系列最小规模模型(30亿和80亿参数)在多项基准测试中持续超越同类Llama 3模型,优势往往显著。
Deep Cogito首席执行官兼联合创始人德里尚·阿罗拉(前谷歌大型语言模型首席工程师)阐述公司愿景:构建能通过迭代精进推理能力的模型,其进化机制类似AlphaGo通过自我对弈实现的自我提升。
该方法的核心是迭代蒸馏与增强(IDA),通过模型自身不断进化的洞察力取代静态训练提示。
理解机器直觉
Cogito v2版本大幅扩展了这种自我改进循环。其基础理念很简单:推理能力应融入模型核心智能,而非仅在推理阶段激活。
为此,该公司构建了模型在训练过程中生成推理链,并从自身中间思维过程学习的系统。
内部基准测试证实了显著提升:旗舰级671B MoE模型在推理任务上超越DeepSeek R1,其推理链平均长度缩短60%,却能匹敌甚至超越后者最新的0528模型。
在MMLU、GSM8K和MGSM等基准测试中,Cogito 671B MoE模型与Qwen1.5-72B、DeepSeek v3等顶尖开源模型表现相当,其性能已逼近Claude 4 Opus和o3等闭源模型。
关键发现包括:
- 推理模式下,Cogito 671B MoE在多语言问答和常识领域与DeepSeek R1 0528持平,并在策略规划与逻辑演绎方面实现超越。
- 在标准(非推理)模式下,其性能超越DeepSeek v3 0324,证明即使不进行扩展推理步骤,蒸馏出的直觉仍能显著提升性能。
- 更少的推理步骤带来实际效益:复杂查询的推理成本降低,响应速度加快。
阿罗拉将此比喻为"盲目搜索目的地与已知方向"的差异。
他在X平台发文解释道:"由于Cogito模型在推理过程中能更精准地把握搜索轨迹,其推理链比DeepSeek R1缩短了60%。"
Deep Cogito模型的卓越之处:机器直觉的实践
Cogito v2内部测试案例印证了该能力。某数学题中,用户询问时速80英里的列车能否在2.5小时内行驶240英里。
多数模型会进行繁琐的分步计算且易出错,而Cogito 671B仅通过简短的内部推演,计算出240÷80=3小时,准确得出列车无法准时抵达的结论。其内部处理令牌数不足100个,远低于DeepSeek R1处理相同问题的200多个令牌。
在关于美国最高法院判例适用性的法律推理案例中,Cogito的推理模式采用清晰的两步逻辑:首先判定假设案例是否符合先例,随后论证结论依据。这种精细的解释性推理仍是多数大型语言模型面临的挑战。
该模型在处理模糊性方面也表现出进步。面对多跳问题(如确定亲属关系:"爱丽丝是鲍勃的母亲,鲍勃是查理的父亲。爱丽丝与查理是什么关系?"),Cogito v2模型能准确识别"祖母"——即使措辞稍有变化,其他开源模型常在此处出错。
实现规模化效率
值得注意的是,Deep Cogito报告称其八个Cogito模型(含v1系列)的总训练成本低于350万美元——仅为某些前沿模型九位数预算的零头。
该预算涵盖了大量数据生成、合成强化、基础设施以及 1,000 多次训练实验。
阿罗拉将这种成本效益归功于一个核心原则:构建更智能的模型取决于更强的基础理解("先验知识"),而非简单地喂给它们更多数据。
通过教导模型规避冗余或误导性的推理路径,Cogito v2在不增加推理时间或成本的前提下实现了强健性能——这对以延迟和成本为关键考量因素的API服务或边缘设备部署具有决定性优势。
展望未来:Deep Cogito的发展路线图
Cogito v2是迭代进程中的阶段性成果,而非终极产品。阿罗拉将公司方法比作"爬坡式进化":运行模型→学习推理过程→提炼经验→循环迭代。每次模型发布都基于前代成果持续进化。
Deep Cogito 坚持将所有现有及未来模型开源。其工作已获得 Benchmark 投资人 Eric Vishria 和 South Park Commons 投资人 Aditya Agarwal 等投资者的支持。
基础设施合作伙伴包括Hugging Face、Together AI、RunPod、Baseten、Meta旗下Llama团队及Unsloth。
开发者、研究人员及企业用户现可获取这些模型,用于本地部署、多模态对比及领域特定的微调。
对开源人工智能社区而言,Cogito v2不仅是基准测试的里程碑,更开创了智能构建的新范式:其核心不在于更努力地思考,而在于学习如何更高效地思考。








 Lovable Leads Atech's Seed Round as AI Ambient Coding Officially Enters the Hardware Field
2026年5月14日,AI应用开发平台Lovable宣布参与丹麦硬件初创公司Atech的80万美元种子轮融资。该轮由Lovable领投,吸引了包括a16z Scout Fund、Sequoia Scout Fund以及Nordic Makers在内的顶级风险投资机构。此次投资标志着Lovable将“Vibe Coding”概念从纯软件开发战略扩展至硬件工程领域。Atech旨在通过AI驱动的交互式平台简化复杂的硬件原型制作。用户购买基础硬件套件,并通过AI聊天机器人以自然语言描述其设计概念;系统
 Anthropic 将 Claude AI 编码工具扩展至日本,以推动海外增长
Anthropic,一家美国知名的人工智能公司,正加强其全球推广力度。周三,该公司在东京举办了一场大型开发者活动“Code with Claude”,吸引了近500名软件工程师参加。该举措旨在积极将Claude AI工具及相关产品引入日本市场,强调其自主编码能力在提升企业生产力方面的核心优势。强调自动化代码生成在活动中,Anthropic展示了其先进的自主编码系统,该系统能够独立处理复杂的编程任务并优化现有代码结构。随着全球对高效开发工具的需求不断增长,Anthropic希望通过此类活动加强
 印度软件巨头缩减招聘,承诺随着 AI 代理规模扩大不裁员
随着人工智能重塑传统的劳动密集型商业模式,印度领先的软件外包公司塔塔咨询服务公司(TCS)公布了其战略应对措施。在周二的年度股东大会上,董事长概述了人机协作的愿景,并澄清了公司在人工智能时代的人力资源战略。不裁员,但招聘将放缓TCS董事长明确表示,公司没有因采用人工智能而裁员的计划,尽管整体招聘速度将放缓。虽然TCS此前减少了超过10,000名员工,但官员们强调,公司现在更倾向于通过自然流失来优化其人员结构,而非突然裁员。高层管理人员指出,以前由人类处理的重复性、机械性任务正不可避免地转向

2026年最新最佳、评价最高的AI风格转换工具,助您开展创意实验!XIX.AI精心甄选了一系列功能强大、颠覆性的必试工具,这些工具经过实际测试和严格排名,可带来卓越的效果。这些顶级解决方案通过加速内容创作并释放无限创意潜能,帮助创作者显著提升工作效率。 立即探索,找到最适合您的工具,今天就开始创作吧!
9 个工具
xix.ai

2026年最新、最受欢迎的视觉叙事AI对话气泡工具现已登陆XIX.AI!这份精心精选的合集汇集了功能强大、具有颠覆性的工具,可帮助创作者提升工作效率并突破创作瓶颈。 获取免费版与付费版的对比分析,查看实际测试结果,并查阅最新排行榜,找到最适合打造引人入胜的视觉叙事的必试解决方案。立即探索,发现您的理想工具!
10 个工具
xix.ai

2026年最新高评分最佳AI会议摘要工具,助您清晰追踪决策并轻松跟进。这份精心筛选的清单展示了功能强大、具有颠覆性的解决方案,它们通过自动化会议记录、识别关键行动项以及简化所有项目中的团队协调,显著提升工作效率。 获取免费版与付费版的对比分析,以及实际测试报告和每周更新的排行榜,助您找到最适合的工具。立即探索,释放您的AI优势!
9 个工具
xix.ai

2026年最新、最优秀且评分最高的AI数据清洗工具,可快速处理缺失值与重复数据问题。这份精心挑选的清单展示了那些功能强大、能带来颠覆性变革的解决方案,可显著提升工作效率。所有候选工具都经过了严格的实际应用测试,以确保其稳定性。您可以获取免费版与付费版的对比信息,找出最符合您需求的必备工具。即刻访问XIX.AI,开启您的AI优势之旅。
11 个工具
xix.ai
2026 年最新最佳顶级评分 AI 创意构思工具由 XIX.AI 精心策划,旨在帮助创作者突破视觉瓶颈并即时提升创造力。这些强大的变革性工具提供真实世界测试、详细的免费与付费对比以及每周更新的排名。发现您的完美工具,加速内容创作,并立即释放您的 AI 优势。立即探索!
14 个工具
xix.ai
2026年最新最全的AI节拍生成器,适用于TikTok背景音乐、Reels音频及创作者宣传音乐!XIX.AI精心筛选了一系列广受好评、功能强大的革命性工具,这些工具均经过实际测试,可为各类内容创作需求提供完美的音乐。 您将在此找到详尽的免费版与付费版对比数据、每周更新的排行榜,以及不容错过的精选工具,助您激发创意并提升工作效率。立即探索,发现最适合您的工具!
11 个工具
xix.ai

Interesting move by Deep Cogito. But 'open-ish' sounds like a marketing term—how open is it really? Also, self-improving intuition sounds spooky. Are we building AI that can rewrite its own reasoning without oversight? 🤔
Interesting approach, but 'open-ish' sounds like a marketing gimmick. If the weights aren't fully open, how can the community truly verify their 'self-improving' claims? Feels like another startup trying to have its cake and eat it too. The intuition part is fascinating, though. 🤔
¿Modelos auto-mejorables? Parece prometedor, pero siempre me pregunto: ¿cómo verifican que la intuición emergente no genere sesgos peligrosos o alucinaciones más sofisticadas? 🤔 Sería bueno ver más transparencia en los datos de entrenamiento.












