


 首頁
Deep Cogito 推出四款開源混合推理模型,具備自我提升的直覺能力
由前谷歌工程師創立的舊金山人工智慧研究新創公司Deep Cogito,近日發布四款新型「半開放式」大型語言模型(LLMs)。這些模型致力解決關鍵挑戰:學習隨時間推移更有效地進行推理,並逐步提升自主能力。
這組被統稱為Cogito v2家族的模型,參數規模從700億至6,710億不等。開發者與企業可透過混合授權模式取得使用權,包含寬鬆授權與完全開放授權。本次發布包含:
- Cogito v2-70B (Dense)
- Cogito v2-109B(專家混合模型)
- Cogito v2-405B(密集型)
- Cogito v2-671B (混合專家模型)
密集型與專家混合模型各具特色。密集型變體(70B與405B)對每項輸入皆啟用所有參數,使其預測結果更可預測,且更易部署於各類硬體環境。
此類模型適用於低延遲任務、微調及GPU資源受限的環境。相對地,MoE模型(109B與671B)採用稀疏路由機制,每則查詢僅激活特定子集的「專家」子網路。此設計能大幅擴展模型總體積,卻無需成比例增加運算成本。
因此,MoE 模型在高效能推論與複雜推理研究領域表現卓越,以較低執行時間成本實現頂尖準確度。在 Cogito v2 產品線中,671B MoE 模型作為旗艦產品,憑藉其規模與高效路由機制,在基準測試中媲美或超越領先的開放模型——且常以更短的推理鏈達成。
企業用戶現可透過 Hugging Face 存取模型,本地部署則可使用 Unsloth。無法自行託管的用戶可透過 Together AI、Baseten 及 RunPod 取得 API 存取權限。
671B模型另提供FP8量化版本(8位元浮點)。透過將參數精度從16位元降至8位元,此版本實現更快速、經濟且易於部署的硬體解決方案,通常能維持原始效能的95%至99%。然在需高精度的任務(如特定數學或推理問題)中,準確度可能略有下降。
四款Cogito v2模型皆屬混合推理系統:既能即時回應,亦能在必要時進行內部反思後再作答。
此反思機制不僅是推論階段的功能,更是訓練過程的內在組成部分。
模型經訓練後能將推理路徑內化,其推導解法的步驟——即內部「思考過程」——會被提煉回歸至模型的基礎權重中。
隨著時間推移,它們學會區分有效的推理路徑與無關的思路。
正如 Deep Cogito 部落格所述,研究人員不鼓勵模型「多繞彎路」尋找答案,而是引導其培養對最高效推理路徑的直覺。
Deep Cogito 指出,此舉使推理過程更快速高效,即使在標準運作模式下也能實現全面性能提升。
邁向自我提升人工智慧之路
儘管對廣大AI社群而言相對新穎,Deep Cogito其實已研發技術逾一年。
該公司於2025年4月正式亮相,推出基於Meta Llama 3.2的開源模型。這些初始模型在2024年11月獲得Benchmark領投的1300萬美元種子輪融資後,展現出令人鼓舞的成果。Benchmark合夥人Eric Vishria隨後加入公司董事會。
如VentureBeat先前報導,Cogito v1系列最小模型(30億與80億參數)在多項基準測試中持續超越同級Llama 3模型,優勢往往相當顯著。
Deep Cogito執行長暨共同創辦人Drishan Arora(前Google大型語言模型首席工程師)闡述公司願景:打造能透過迭代精進推理能力的模型,其運作原理類似AlphaGo透過自我對弈實現的自我提升。
此方法的核心在於「迭代蒸餾與強化」(IDA),該技術以模型自身演進的洞察力取代靜態訓練提示。
理解機器直覺
Cogito v2版本大幅擴展了此自我優化迴圈。其核心理念直截了當:推理能力應融入模型核心智能,而非僅在推論階段啟動。
為實現此目標,該公司建構了一套系統:模型在訓練過程中生成推理鏈,並從自身的中間思考過程學習。
內部基準測試證實了實質性提升。旗艦級671B MoE模型在推理任務上超越DeepSeek R1,其推理鏈平均長度縮短60%,卻能匹敵甚至超越DeepSeek最新的0528模型。
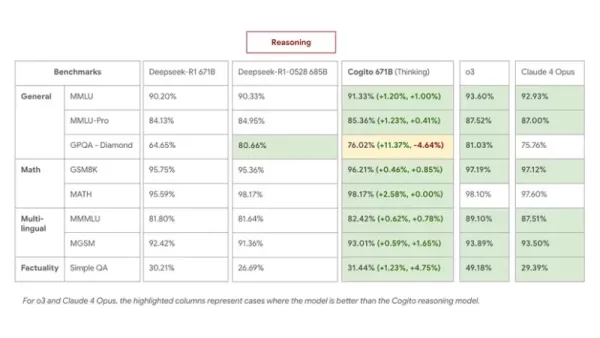
在MMLU、GSM8K及MGSM等基準測試中,Cogito 671B MoE模型與Qwen1.5-72B、DeepSeek v3等頂尖開源模型表現旗鼓相當,其效能已逼近Claude 4 Opus及o3等封閉模型水準。
關鍵發現包括:
- 在推理模式下,Cogito 671B MoE於多語言問答與常識領域與DeepSeek R1 0528持平,並在策略規劃與邏輯演繹方面表現更勝一籌。
- 在標準(非推理)模式下,其表現超越DeepSeek v3 0324,證明即使不經延伸推理步驟,蒸餾出的直覺仍能提升效能。
- 以更少步驟完成推理帶來實質效益:降低複雜查詢的推論成本與提升回應速度。
阿羅拉將此比喻為「搜尋目的地」與「已具備明確方位感」的差異。
他在X平台發文解釋:「由於Cogito模型在推理過程中能發展出更精準的搜尋軌跡直覺,其推理鏈比DeepSeek R1縮短了60%。」
Deep Cogito 模型的卓越之處:機器直覺的實踐
Cogito v2內部測試案例彰顯此能力。某數學題中,使用者詢問時速80英里的火車能否在2.5小時內行駛240英里。
多數模型需進行繁複的逐步計算且易出錯,而Cogito 671B僅經簡短內部推演,即計算出240 ÷ 80 = 3小時,正確推斷火車無法準時抵達。其內部運算符號使用量不足100個,相較之下DeepSeek R1得出相同結論時耗費逾200個符號。
在關於美國最高法院裁決適用性的法律推理範例中,Cogito的推理模式採用清晰的兩步邏輯:首先判定假設案例是否符合先例,繼而闡明結論依據。這種細膩的詮釋性推理仍是多數大型語言模型面臨的挑戰。
該模型在處理模糊性方面亦展現進步。面對多跳問題(如判定親屬關係:「愛麗絲是鮑伯的母親,鮑伯是查理的父親。愛麗絲對查理而言是誰?」),Cogito v2模型能精準識別「祖母」關係,即使表述稍作變動亦能正確判斷——此為其他開放模型常失誤之處。
實現大規模效率
值得注意的是,Deep Cogito 報告稱其八款 Cogito 模型(含 v1 系列)的總訓練成本低於 350 萬美元——僅為某些前沿模型所披露九位數預算的零頭。
此預算涵蓋了大規模數據生成、合成強化學習、基礎設施及逾千次訓練實驗。
阿羅拉將此成本效益歸因於核心原則:打造更智能的模型取決於更優異的基礎理解("先驗知識"),而非單純餵入更多數據。
透過教導模型避免冗餘或誤導性的推理路徑,Cogito v2 在不增加推論時間或成本的前提下實現穩健性能——這對以 API 為基礎的服務或邊緣裝置部署至關重要,因其延遲與成本是關鍵考量因素。
展望未來:Deep Cogito的路線圖
Cogito v2代表迭代進程而非終極產品。阿羅拉將公司方法比喻為「爬坡法」:運行模型、從推理中學習、提煉經驗、循環往復。每版模型皆在前代基礎上持續進化。
Deep Cogito 持續承諾將所有現有及未來模型開源。其研究成果已獲得 Benchmark 創投的 Eric Vishria 與 South Park Commons 的 Aditya Agarwal 等投資者支持。
基礎設施合作夥伴包括 Hugging Face、Together AI、RunPod、Baseten、Meta 的 Llama 團隊以及 Unsloth。
開發者、研究人員及企業用戶現可立即使用這些模型進行本地部署、多模態比對及領域專屬微調。
對開源人工智慧社群而言,Cogito v2不僅是基準里程碑,更提出建構智能的新範式:其核心不在於更努力思考,而在於學習如何更有效地思考。
相關文章
 前 OpenAI 研究員巴雷特·佐夫重返 Google,協助 Gemini 的開發工作
巴雷特·佐夫(Barret Zoph)先前因與 Thinking Machines Lab 執行長米里亞姆·穆拉拉蒂(Miriam Mularati)意見不合而突然離職並加入 OpenAI,如今他再次更換雇主。Alphabet 旗下的 Google 宣布,佐夫將以研究副總裁身分回歸,將他在強化學習與後訓練領域的專業知識帶入 Gemini 團隊。「旋轉門」研究人員的循環佐夫的職業生涯正是人工智慧人才
Recursive Intelligence 如何在 4 個月內以 40 億美元估值募得 3.35 億美元資金
新創公司 Ricursive Intelligence 的共同創辦人彷彿注定要成為夥伴。執行長安娜·戈迪(Anna Goldie)與技術長阿扎莉亞·米爾霍塞尼(Azalia Mirhoseini)在人工智慧界聲名遠播,戈迪向 TechCrunch 笑著透露:「我們正是那些收到祖克柏發來『奇怪電子郵件』、提出瘋狂邀約的人工智慧工程師之一。」(她們最終並未接受這些邀約。) 兩人曾一同在 Google
人工智慧競賽不會等待,這項 TechCrunch Disrupt 25% 折扣也不會
當前每位投身人工智慧領域的創辦人,都在思考同一個問題:我們的進展夠快嗎?夠有效嗎?TechCrunch Disrupt 2026 將讓您與那些正在最高層級上深思這個存亡之問的業界領袖們齊聚一堂。 10月13日至15日於舊金山舉辦的這場盛會中,來自 OpenAI、Nvidia、Anthropic、微軟等企業的領袖將分享他們的見解,同時數千名新創社群成員將齊聚一堂交流 networking。限時優惠:
相關專題推薦
設計與藝術
 頂尖 AI 插畫工具:更快地創作編輯畫面與封面插圖
2026 年最新高評分 AI 插畫工具:我們精心挑選的清單收錄了功能強大、設計出色的工具,能助您快速創作出令人驚豔的編輯場景與吸睛的封面藝術。每項選項均經過嚴格的實際測試,並提供免費版與付費版的比較,協助您找到最適合您工作流程的工具。 立即嘗試這些不可錯過的解決方案,釋放您的人工智慧優勢,並提升您的創意生產力。現在就前往 XIX.AI 探索吧。
 10 個工具
 xix.ai
教育與學習
頂尖 AI 補習老師助您備考:練習數學、科學和英語
2026 年最新、評價最高的考試備考 AI 輔導工具,盡在 XIX.AI!我們精心挑選的清單收錄了多款強大且顛覆傳統的工具,提供免費與付費版本的比較、實際測試,以及每週更新的排行榜。這些工具能幫助您提升寫作效率、簡化複雜主題的學習,並釋放您的學術潛能。 立即探索,發掘最適合您的備考工具,並從今天開始創作,釋放您的 AI 優勢!
10 個工具
xix.ai
金融
用於個人財務管理的 AI 預算規劃工具
2026 年最新最佳頂級評分 AI 預算規劃工具,專為個人財務管理打造,現已登陸 XIX.AI!本精選合集收錄了強大且具顛覆性的解決方案,助您開展實際測試、理解消費習慣,並制定個性化計劃以提升生產力。享受免費與付費版的對比及詳細排名。這些必試工具旨在簡化財務管理,助您釋放 AI 優勢。立即探索!
11 個工具
xix.ai
健康與養生
AI 睡眠追蹤助手:透過更佳的睡前習慣提升恢復效果
2026 年最新精選、評價最高的 AI 睡眠追蹤助手,助您獲得最佳恢復效果。這份全面更新的每週指南收錄了強大的工具,提供實際測試報告、免費與付費版本的比較,以及詳細排名,協助您找到必試的解決方案,以提升睡眠品質並培養更好的就寢習慣。 立即造訪 XIX.AI,解鎖您的 AI 優勢。
10 個工具
xix.ai
數據分析
用於產品與營收分析的 AI SQL 協作助手
2026 年最新最佳、評價最高的 AI SQL 輔助工具,專為產品與營收分析打造! XIX.AI 精心甄選了一系列強大且顛覆業界的必試工具,這些工具均經過實戰測試,並透過每週更新的排行榜進行評比。這些工具能透過加速資料分析、簡化複雜查詢,並產生精準洞察來推動更明智的商業決策,從而大幅提升使用者生產力。立即探索,發掘最適合您的工具,釋放您的 AI 優勢!
14 個工具
xix.ai
教育與學習
最佳的「教學型」AI 作業輔助工具:學習概念,而不僅是答案
2026 年最新最佳高評價 AI 作業輔助工具:不僅提供答案,更教授核心概念。專為學生打造的強大工具,必試精選清單,每週更新,免費與付費版本比較,實際測試,精準排名,助您充分發揮學習潛能。立即探索,發掘最適合您的工具,讓學習更聰明。
10 個工具
xix.ai

 評論 (3)
0/500
![LarryMitchell]()
Interesting move by Deep Cogito. But 'open-ish' sounds like a marketing term—how open is it really? Also, self-improving intuition sounds spooky. Are we building AI that can rewrite its own reasoning without oversight? 🤔
![JamesCarter]()
Interesting approach, but 'open-ish' sounds like a marketing gimmick. If the weights aren't fully open, how can the community truly verify their 'self-improving' claims? Feels like another startup trying to have its cake and eat it too. The intuition part is fascinating, though. 🤔
![WillieJones]()
¿Modelos auto-mejorables? Parece prometedor, pero siempre me pregunto: ¿cómo verifican que la intuición emergente no genere sesgos peligrosos o alucinaciones más sofisticadas? 🤔 Sería bueno ver más transparencia en los datos de entrenamiento.
由前谷歌工程師創立的舊金山人工智慧研究新創公司Deep Cogito,近日發布四款新型「半開放式」大型語言模型(LLMs)。這些模型致力解決關鍵挑戰:學習隨時間推移更有效地進行推理,並逐步提升自主能力。
這組被統稱為Cogito v2家族的模型,參數規模從700億至6,710億不等。開發者與企業可透過混合授權模式取得使用權,包含寬鬆授權與完全開放授權。本次發布包含:
- Cogito v2-70B (Dense)
- Cogito v2-109B(專家混合模型)
- Cogito v2-405B(密集型)
- Cogito v2-671B (混合專家模型)
密集型與專家混合模型各具特色。密集型變體(70B與405B)對每項輸入皆啟用所有參數,使其預測結果更可預測,且更易部署於各類硬體環境。
此類模型適用於低延遲任務、微調及GPU資源受限的環境。相對地,MoE模型(109B與671B)採用稀疏路由機制,每則查詢僅激活特定子集的「專家」子網路。此設計能大幅擴展模型總體積,卻無需成比例增加運算成本。
因此,MoE 模型在高效能推論與複雜推理研究領域表現卓越,以較低執行時間成本實現頂尖準確度。在 Cogito v2 產品線中,671B MoE 模型作為旗艦產品,憑藉其規模與高效路由機制,在基準測試中媲美或超越領先的開放模型——且常以更短的推理鏈達成。
企業用戶現可透過 Hugging Face 存取模型,本地部署則可使用 Unsloth。無法自行託管的用戶可透過 Together AI、Baseten 及 RunPod 取得 API 存取權限。
671B模型另提供FP8量化版本(8位元浮點)。透過將參數精度從16位元降至8位元,此版本實現更快速、經濟且易於部署的硬體解決方案,通常能維持原始效能的95%至99%。然在需高精度的任務(如特定數學或推理問題)中,準確度可能略有下降。
四款Cogito v2模型皆屬混合推理系統:既能即時回應,亦能在必要時進行內部反思後再作答。
此反思機制不僅是推論階段的功能,更是訓練過程的內在組成部分。
模型經訓練後能將推理路徑內化,其推導解法的步驟——即內部「思考過程」——會被提煉回歸至模型的基礎權重中。
隨著時間推移,它們學會區分有效的推理路徑與無關的思路。
正如 Deep Cogito 部落格所述,研究人員不鼓勵模型「多繞彎路」尋找答案,而是引導其培養對最高效推理路徑的直覺。
Deep Cogito 指出,此舉使推理過程更快速高效,即使在標準運作模式下也能實現全面性能提升。
邁向自我提升人工智慧之路
儘管對廣大AI社群而言相對新穎,Deep Cogito其實已研發技術逾一年。
該公司於2025年4月正式亮相,推出基於Meta Llama 3.2的開源模型。這些初始模型在2024年11月獲得Benchmark領投的1300萬美元種子輪融資後,展現出令人鼓舞的成果。Benchmark合夥人Eric Vishria隨後加入公司董事會。
如VentureBeat先前報導,Cogito v1系列最小模型(30億與80億參數)在多項基準測試中持續超越同級Llama 3模型,優勢往往相當顯著。
Deep Cogito執行長暨共同創辦人Drishan Arora(前Google大型語言模型首席工程師)闡述公司願景:打造能透過迭代精進推理能力的模型,其運作原理類似AlphaGo透過自我對弈實現的自我提升。
此方法的核心在於「迭代蒸餾與強化」(IDA),該技術以模型自身演進的洞察力取代靜態訓練提示。
理解機器直覺
Cogito v2版本大幅擴展了此自我優化迴圈。其核心理念直截了當:推理能力應融入模型核心智能,而非僅在推論階段啟動。
為實現此目標,該公司建構了一套系統:模型在訓練過程中生成推理鏈,並從自身的中間思考過程學習。
內部基準測試證實了實質性提升。旗艦級671B MoE模型在推理任務上超越DeepSeek R1,其推理鏈平均長度縮短60%,卻能匹敵甚至超越DeepSeek最新的0528模型。
在MMLU、GSM8K及MGSM等基準測試中,Cogito 671B MoE模型與Qwen1.5-72B、DeepSeek v3等頂尖開源模型表現旗鼓相當,其效能已逼近Claude 4 Opus及o3等封閉模型水準。
關鍵發現包括:
- 在推理模式下,Cogito 671B MoE於多語言問答與常識領域與DeepSeek R1 0528持平,並在策略規劃與邏輯演繹方面表現更勝一籌。
- 在標準(非推理)模式下,其表現超越DeepSeek v3 0324,證明即使不經延伸推理步驟,蒸餾出的直覺仍能提升效能。
- 以更少步驟完成推理帶來實質效益:降低複雜查詢的推論成本與提升回應速度。
阿羅拉將此比喻為「搜尋目的地」與「已具備明確方位感」的差異。
他在X平台發文解釋:「由於Cogito模型在推理過程中能發展出更精準的搜尋軌跡直覺,其推理鏈比DeepSeek R1縮短了60%。」
Deep Cogito 模型的卓越之處:機器直覺的實踐
Cogito v2內部測試案例彰顯此能力。某數學題中,使用者詢問時速80英里的火車能否在2.5小時內行駛240英里。
多數模型需進行繁複的逐步計算且易出錯,而Cogito 671B僅經簡短內部推演,即計算出240 ÷ 80 = 3小時,正確推斷火車無法準時抵達。其內部運算符號使用量不足100個,相較之下DeepSeek R1得出相同結論時耗費逾200個符號。
在關於美國最高法院裁決適用性的法律推理範例中,Cogito的推理模式採用清晰的兩步邏輯:首先判定假設案例是否符合先例,繼而闡明結論依據。這種細膩的詮釋性推理仍是多數大型語言模型面臨的挑戰。
該模型在處理模糊性方面亦展現進步。面對多跳問題(如判定親屬關係:「愛麗絲是鮑伯的母親,鮑伯是查理的父親。愛麗絲對查理而言是誰?」),Cogito v2模型能精準識別「祖母」關係,即使表述稍作變動亦能正確判斷——此為其他開放模型常失誤之處。
實現大規模效率
值得注意的是,Deep Cogito 報告稱其八款 Cogito 模型(含 v1 系列)的總訓練成本低於 350 萬美元——僅為某些前沿模型所披露九位數預算的零頭。
此預算涵蓋了大規模數據生成、合成強化學習、基礎設施及逾千次訓練實驗。
阿羅拉將此成本效益歸因於核心原則:打造更智能的模型取決於更優異的基礎理解("先驗知識"),而非單純餵入更多數據。
透過教導模型避免冗餘或誤導性的推理路徑,Cogito v2 在不增加推論時間或成本的前提下實現穩健性能——這對以 API 為基礎的服務或邊緣裝置部署至關重要,因其延遲與成本是關鍵考量因素。
展望未來:Deep Cogito的路線圖
Cogito v2代表迭代進程而非終極產品。阿羅拉將公司方法比喻為「爬坡法」:運行模型、從推理中學習、提煉經驗、循環往復。每版模型皆在前代基礎上持續進化。
Deep Cogito 持續承諾將所有現有及未來模型開源。其研究成果已獲得 Benchmark 創投的 Eric Vishria 與 South Park Commons 的 Aditya Agarwal 等投資者支持。
基礎設施合作夥伴包括 Hugging Face、Together AI、RunPod、Baseten、Meta 的 Llama 團隊以及 Unsloth。
開發者、研究人員及企業用戶現可立即使用這些模型進行本地部署、多模態比對及領域專屬微調。
對開源人工智慧社群而言,Cogito v2不僅是基準里程碑,更提出建構智能的新範式:其核心不在於更努力思考,而在於學習如何更有效地思考。








 前 OpenAI 研究員巴雷特·佐夫重返 Google,協助 Gemini 的開發工作
巴雷特·佐夫(Barret Zoph)先前因與 Thinking Machines Lab 執行長米里亞姆·穆拉拉蒂(Miriam Mularati)意見不合而突然離職並加入 OpenAI,如今他再次更換雇主。Alphabet 旗下的 Google 宣布,佐夫將以研究副總裁身分回歸,將他在強化學習與後訓練領域的專業知識帶入 Gemini 團隊。「旋轉門」研究人員的循環佐夫的職業生涯正是人工智慧人才
 Recursive Intelligence 如何在 4 個月內以 40 億美元估值募得 3.35 億美元資金
新創公司 Ricursive Intelligence 的共同創辦人彷彿注定要成為夥伴。執行長安娜·戈迪(Anna Goldie)與技術長阿扎莉亞·米爾霍塞尼(Azalia Mirhoseini)在人工智慧界聲名遠播,戈迪向 TechCrunch 笑著透露:「我們正是那些收到祖克柏發來『奇怪電子郵件』、提出瘋狂邀約的人工智慧工程師之一。」(她們最終並未接受這些邀約。) 兩人曾一同在 Google
 人工智慧競賽不會等待,這項 TechCrunch Disrupt 25% 折扣也不會
當前每位投身人工智慧領域的創辦人,都在思考同一個問題:我們的進展夠快嗎?夠有效嗎?TechCrunch Disrupt 2026 將讓您與那些正在最高層級上深思這個存亡之問的業界領袖們齊聚一堂。 10月13日至15日於舊金山舉辦的這場盛會中,來自 OpenAI、Nvidia、Anthropic、微軟等企業的領袖將分享他們的見解,同時數千名新創社群成員將齊聚一堂交流 networking。限時優惠:

2026 年最新高評分 AI 插畫工具:我們精心挑選的清單收錄了功能強大、設計出色的工具,能助您快速創作出令人驚豔的編輯場景與吸睛的封面藝術。每項選項均經過嚴格的實際測試,並提供免費版與付費版的比較,協助您找到最適合您工作流程的工具。 立即嘗試這些不可錯過的解決方案,釋放您的人工智慧優勢,並提升您的創意生產力。現在就前往 XIX.AI 探索吧。
10 個工具
xix.ai

2026 年最新、評價最高的考試備考 AI 輔導工具,盡在 XIX.AI!我們精心挑選的清單收錄了多款強大且顛覆傳統的工具,提供免費與付費版本的比較、實際測試,以及每週更新的排行榜。這些工具能幫助您提升寫作效率、簡化複雜主題的學習,並釋放您的學術潛能。 立即探索,發掘最適合您的備考工具,並從今天開始創作,釋放您的 AI 優勢!
10 個工具
xix.ai

2026 年最新最佳頂級評分 AI 預算規劃工具,專為個人財務管理打造,現已登陸 XIX.AI!本精選合集收錄了強大且具顛覆性的解決方案,助您開展實際測試、理解消費習慣,並制定個性化計劃以提升生產力。享受免費與付費版的對比及詳細排名。這些必試工具旨在簡化財務管理,助您釋放 AI 優勢。立即探索!
11 個工具
xix.ai

2026 年最新精選、評價最高的 AI 睡眠追蹤助手,助您獲得最佳恢復效果。這份全面更新的每週指南收錄了強大的工具,提供實際測試報告、免費與付費版本的比較,以及詳細排名,協助您找到必試的解決方案,以提升睡眠品質並培養更好的就寢習慣。 立即造訪 XIX.AI,解鎖您的 AI 優勢。
10 個工具
xix.ai

2026 年最新最佳、評價最高的 AI SQL 輔助工具,專為產品與營收分析打造! XIX.AI 精心甄選了一系列強大且顛覆業界的必試工具,這些工具均經過實戰測試,並透過每週更新的排行榜進行評比。這些工具能透過加速資料分析、簡化複雜查詢,並產生精準洞察來推動更明智的商業決策,從而大幅提升使用者生產力。立即探索,發掘最適合您的工具,釋放您的 AI 優勢!
14 個工具
xix.ai

2026 年最新最佳高評價 AI 作業輔助工具:不僅提供答案,更教授核心概念。專為學生打造的強大工具,必試精選清單,每週更新,免費與付費版本比較,實際測試,精準排名,助您充分發揮學習潛能。立即探索,發掘最適合您的工具,讓學習更聰明。
10 個工具
xix.ai

Interesting move by Deep Cogito. But 'open-ish' sounds like a marketing term—how open is it really? Also, self-improving intuition sounds spooky. Are we building AI that can rewrite its own reasoning without oversight? 🤔
Interesting approach, but 'open-ish' sounds like a marketing gimmick. If the weights aren't fully open, how can the community truly verify their 'self-improving' claims? Feels like another startup trying to have its cake and eat it too. The intuition part is fascinating, though. 🤔
¿Modelos auto-mejorables? Parece prometedor, pero siempre me pregunto: ¿cómo verifican que la intuición emergente no genere sesgos peligrosos o alucinaciones más sofisticadas? 🤔 Sería bueno ver más transparencia en los datos de entrenamiento.












