


 首页
Bria为接受许可数据培训的AI模型提供了新的资金
人工智能驱动的图像生成器目前处于众多针对人工智能公司的版权诉讼核心,主要是因为它们在从公共网站提取的大量数据集上进行训练。这些公司常以合理使用原则为保护依据,但许多版权持有者对此提出质疑。
因此,一些初创公司,包括2020年由亚伊尔·阿达托和加尔·雅各比在纽约和特拉维夫创立的Bria,采取了不同策略。Bria选择仅在授权内容上训练其图像生成器,与约20个合作伙伴(如Getty Images)合作,确保合规性和内容完整性。首席执行官亚伊尔·阿达托强调,Bria根据图像所有者在平台上的“总体影响”以“程序化”方式补偿他们。
“Bria基础模型包含十亿张视觉内容和数百万个视频,”阿达托在接受TechCrunch采访时表示。他进一步指出,通过在全球代表性数据集上训练,Bria成功减少了人工智能生成视觉内容中常见的偏见。这种方法使其模型能生成多样化和包容性的内容,适用于广泛的创意用途。
Bria通过提供与Photoshop和Figma等流行图像编辑和设计软件兼容的插件,提升用户体验。此外,他们提供了一个微调API,允许客户根据特定需求定制Bria的模型。用户可灵活地在Bria平台或外部计算环境(如公共云)上运行这些模型。阿达托保证,在所有情况下,客户保留数据和输出的所有权。
“企业客户可通过付费访问我们的源代码和[模型],”阿达托解释道。“我们提供超过30个用于视觉创建和修改的专用API,通过订阅和按使用量计费的定价模式提供。公司还可使用其品牌资产微调我们的生成式人工智能模型,创建保留其视觉身份的定制引擎。”
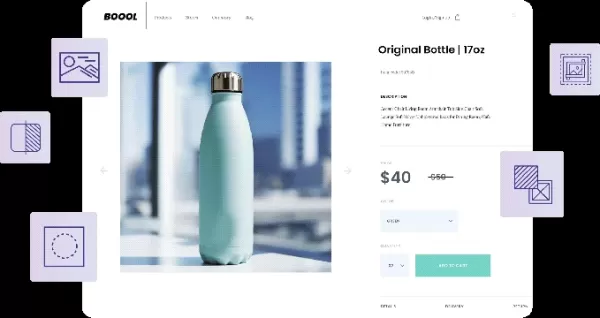
Bria的人工智能模型在授权数据上训练,可生成和编辑图像。图片来源:Bria Bria的愿景超越当前能力。阿达托向TechCrunch透露,公司拥有40名员工,旨在构建一个“知识产权生态系统”,允许企业使用来自媒体集团的授权图像进行商业用途,并具备“内置合规性”。
公司不仅限于图像;Bria计划扩展其平台,支持音乐、视频和文本等其他媒体类型,以及设备端应用。尽管科技行业面临市场成熟和宏观经济压力等挑战,阿达托认为这些因素只会增强Bria的市场地位。
虽然Adobe、Spawning AI和Shutterstock等其他企业也在探索授权媒体生成器,但Bria已在这个新兴市场中占据重要地位。周四,他们宣布成功完成B轮融资,筹集4000万美元,由Red Dot Capital领投,Maor Investments、Entrée Capital、GFT Ventures、Intel Capital和IN Venture支持。这使Bria的总融资额达到约6500万美元,新资金大部分将用于产品开发。
“我们与40个客户合作,实现了快速增长,去年年度经常性收入增长超过400%,”阿达托表示。他还提到计划通过增加生成式人工智能音乐和视频、全球销售和营销、知识产权和版权法以及人工智能咨询等领域的专家,年底前将团队规模翻倍。
更新于太平洋时间3月15日晚11:22:本文原始版本错误称Bria成立于2023年而非2020年,且未提及联合创始人加尔·雅各比。我们为这些错误表示歉意。
相关文章
 Recursive Intelligence 如何在4个月内以40亿美元估值筹集3.35亿美元
初创公司Ricursive Intelligence的联合创始人似乎注定要成为联合创始人。首席执行官安娜·戈迪(Anna Goldie)和首席技术官阿扎莉亚·米尔霍塞伊尼(Azalia Mirhoseini)在人工智能界声名显赫,戈迪向TechCrunch笑称,她们正是那些“收到扎克伯格发来的奇怪邮件、里面提出疯狂邀约”的人工智能工程师之一。(她们最终没有接受这些邀约。) 两人曾共同在谷歌大脑(G
人工智能竞赛不会等待,TechCrunch Disrupt 的 25% 折扣也不会等待
目前每一位投身人工智能领域的创始人都在思考同一个问题:我们的发展速度够快吗?效率够高吗?TechCrunch Disrupt 2026 将让您与那些正在最高层面思考这一关乎存亡问题的行业领军人物共聚一堂。 10月13日至15日,在旧金山,来自OpenAI、英伟达(Nvidia)、Anthropic、微软等公司的领军人物将分享他们的见解,届时数千名初创企业社区成员将齐聚一堂,进行交流。限时优惠:结账
“钱文AI免费版”与机构版:揭穿高价写作骗局
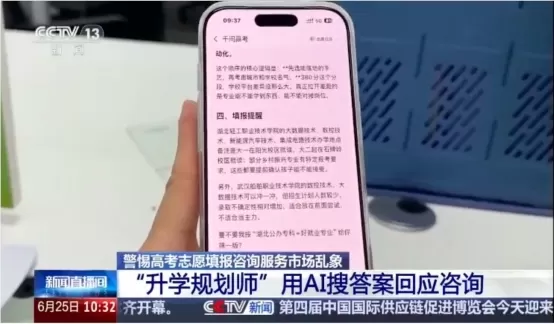
6月25日,中央电视台播出了关于混乱的高考志愿填报市场的一则调查报道,引发了广泛的公众讨论。 报道画面显示,许多高中升学中介机构打着“十年教龄教师”和“教授”等头衔的旗号,收取4,980至12,980元不等的天价费用。 实际上,这些所谓的“资深顾问”往往是入职不到两个月的新员工,甚至是兼职的大学生。他们的“专业方案”都是通过免费的Qwen AI生成的,有些机构甚至直接将Qwen生成的内容加价转卖给
相关专题推荐
设计与艺术
 顶级AI插画工具:更快地创作编辑类场景和封面插图
2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
 10 个工具
 xix.ai
教育与学习
备考首选的顶尖AI辅导老师:练习数学、科学和英语
2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai
金融
用于个人财务管理的 AI 预算规划工具
2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai
健康养生
AI睡眠追踪助手:通过养成更好的睡前习惯来促进身体恢复
2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai
数据分析
用于产品和收入分析的 AI SQL 辅助工具
2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai
教育与学习
最佳的、兼具教学功能的AI作业助手:学习概念,而不仅仅是答案
2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

 评论 (21)
0/500
![RobertSanchez]()
Finally, a company that actually pays for training data instead of scraping everything like a digital hoarder. Bria might be onto something—if they can prove licensed data models work as well, they could dodge a lot of legal headaches. But will investors care about ethics when the ROI is fuzzy? 🤔
![GregoryAdams]()
이 기사 읽고 나니 AI와 저작권 문제가 참 복잡하네요. 저작권 침해 논란에서 벗어나기 위해 합법 데이터로 훈련된 모델을 개발하는 건 현명한 전략인 것 같아요. 🤔 앞으로 다른 AI 기업들도 비슷한 방향으로 나아갈까요? 한국에서도 이런 논의가 활발히 이루어지면 좋겠어요.
![RogerSanchez]()
이 기사 보니까 기존 AI 이미지 생성기의 저작권 문제가 정말 심각하네요 🤔 공개 웹사이트 데이터를 무단 사용하니까 당연히 소송 걸리지... 브리아 같은 회사가 라이선스 받은 데이터로 모델 학습하는 건 더 윤리적인 접근처럼 보여요. 앞으로 AI 업계에서 이런 식의 합법적인 모델이 주류가 되겠죠?
![PaulKing]()
This article on Bria's funding is eye-opening! Using licensed data for AI training sounds like a smart move to dodge those messy copyright lawsuits. But I wonder, will this make their models pricier or less creative? 🤔
![DanielPerez]()
This article really highlights the messy legal side of AI image generators! It's wild how companies scrape the web for data and then cry 'fair use' when sued. Bria’s approach with licensed data sounds like a smarter move—less drama, more ethics. Curious to see if this sets a trend! 😄
![BrianBaker]()
This article on Bria's funding is super intriguing! Using licensed data for AI training feels like a smart move to dodge those messy copyright lawsuits. Curious how this’ll shift the industry—will others follow suit? 🤔
人工智能驱动的图像生成器目前处于众多针对人工智能公司的版权诉讼核心,主要是因为它们在从公共网站提取的大量数据集上进行训练。这些公司常以合理使用原则为保护依据,但许多版权持有者对此提出质疑。
因此,一些初创公司,包括2020年由亚伊尔·阿达托和加尔·雅各比在纽约和特拉维夫创立的Bria,采取了不同策略。Bria选择仅在授权内容上训练其图像生成器,与约20个合作伙伴(如Getty Images)合作,确保合规性和内容完整性。首席执行官亚伊尔·阿达托强调,Bria根据图像所有者在平台上的“总体影响”以“程序化”方式补偿他们。
“Bria基础模型包含十亿张视觉内容和数百万个视频,”阿达托在接受TechCrunch采访时表示。他进一步指出,通过在全球代表性数据集上训练,Bria成功减少了人工智能生成视觉内容中常见的偏见。这种方法使其模型能生成多样化和包容性的内容,适用于广泛的创意用途。
Bria通过提供与Photoshop和Figma等流行图像编辑和设计软件兼容的插件,提升用户体验。此外,他们提供了一个微调API,允许客户根据特定需求定制Bria的模型。用户可灵活地在Bria平台或外部计算环境(如公共云)上运行这些模型。阿达托保证,在所有情况下,客户保留数据和输出的所有权。
“企业客户可通过付费访问我们的源代码和[模型],”阿达托解释道。“我们提供超过30个用于视觉创建和修改的专用API,通过订阅和按使用量计费的定价模式提供。公司还可使用其品牌资产微调我们的生成式人工智能模型,创建保留其视觉身份的定制引擎。”
Bria的愿景超越当前能力。阿达托向TechCrunch透露,公司拥有40名员工,旨在构建一个“知识产权生态系统”,允许企业使用来自媒体集团的授权图像进行商业用途,并具备“内置合规性”。
公司不仅限于图像;Bria计划扩展其平台,支持音乐、视频和文本等其他媒体类型,以及设备端应用。尽管科技行业面临市场成熟和宏观经济压力等挑战,阿达托认为这些因素只会增强Bria的市场地位。
虽然Adobe、Spawning AI和Shutterstock等其他企业也在探索授权媒体生成器,但Bria已在这个新兴市场中占据重要地位。周四,他们宣布成功完成B轮融资,筹集4000万美元,由Red Dot Capital领投,Maor Investments、Entrée Capital、GFT Ventures、Intel Capital和IN Venture支持。这使Bria的总融资额达到约6500万美元,新资金大部分将用于产品开发。
“我们与40个客户合作,实现了快速增长,去年年度经常性收入增长超过400%,”阿达托表示。他还提到计划通过增加生成式人工智能音乐和视频、全球销售和营销、知识产权和版权法以及人工智能咨询等领域的专家,年底前将团队规模翻倍。
更新于太平洋时间3月15日晚11:22:本文原始版本错误称Bria成立于2023年而非2020年,且未提及联合创始人加尔·雅各比。我们为这些错误表示歉意。








 Recursive Intelligence 如何在4个月内以40亿美元估值筹集3.35亿美元
初创公司Ricursive Intelligence的联合创始人似乎注定要成为联合创始人。首席执行官安娜·戈迪(Anna Goldie)和首席技术官阿扎莉亚·米尔霍塞伊尼(Azalia Mirhoseini)在人工智能界声名显赫,戈迪向TechCrunch笑称,她们正是那些“收到扎克伯格发来的奇怪邮件、里面提出疯狂邀约”的人工智能工程师之一。(她们最终没有接受这些邀约。) 两人曾共同在谷歌大脑(G
 人工智能竞赛不会等待,TechCrunch Disrupt 的 25% 折扣也不会等待
目前每一位投身人工智能领域的创始人都在思考同一个问题:我们的发展速度够快吗?效率够高吗?TechCrunch Disrupt 2026 将让您与那些正在最高层面思考这一关乎存亡问题的行业领军人物共聚一堂。 10月13日至15日,在旧金山,来自OpenAI、英伟达(Nvidia)、Anthropic、微软等公司的领军人物将分享他们的见解,届时数千名初创企业社区成员将齐聚一堂,进行交流。限时优惠:结账
 “钱文AI免费版”与机构版:揭穿高价写作骗局
6月25日,中央电视台播出了关于混乱的高考志愿填报市场的一则调查报道,引发了广泛的公众讨论。 报道画面显示,许多高中升学中介机构打着“十年教龄教师”和“教授”等头衔的旗号,收取4,980至12,980元不等的天价费用。 实际上,这些所谓的“资深顾问”往往是入职不到两个月的新员工,甚至是兼职的大学生。他们的“专业方案”都是通过免费的Qwen AI生成的,有些机构甚至直接将Qwen生成的内容加价转卖给

2026年最新高评分AI插画工具:我们精心挑选的这份清单汇集了功能强大的顶级工具,助您快速创作令人惊艳的编辑场景和引人注目的封面艺术。每款工具都经过了严格的实际测试,并提供了免费版与付费版的对比,帮助您找到最适合您工作流程的工具。 立即尝试这些必试解决方案,释放您的AI优势,提升创作效率。立即访问 XIX.AI 探索更多。
10 个工具
xix.ai

2026年最新、评分最高的考试备考AI辅导工具现已登陆XIX.AI!我们精心筛选的这份清单汇集了多款功能强大、颠覆传统的工具,提供免费与付费版本的对比、实际测试以及每周更新的排行榜。它们能帮助你提升写作效率、简化复杂主题的学习,并释放你的学术潜能。 立即探索,发现最适合您的备考工具,今天就开始创作,释放您的AI优势!
10 个工具
xix.ai

2026 年最新最佳顶级评分 AI 预算规划工具,专为个人财务管理打造,现已登陆 XIX.AI!本精选合集收录了强大且具颠覆性的解决方案,助您开展实际测试、理解消费习惯,并制定个性化计划以提升生产力。享受免费与付费版的对比及详细排名。这些必试工具旨在简化财务管理,助您释放 AI 优势。立即探索!
11 个工具
xix.ai

2026年最新精选高评分AI睡眠追踪助手,助您实现最佳恢复效果。这份全面更新的每周指南汇集了强大的工具,提供实际测试结果、免费与付费版本对比以及详细排名,助您找到必试的解决方案,从而提升睡眠质量并养成更好的就寝习惯。 立即访问 XIX.AI,解锁您的AI优势。
10 个工具
xix.ai

2026年最新、最受欢迎、评分最高的AI SQL辅助工具,助力产品与营收分析! XIX.AI 精心遴选了一系列功能强大、颠覆性的必试工具,这些工具均经过每周更新的排名体系进行实战测试。它们能通过加速数据分析、简化复杂查询并生成精准洞察,帮助用户显著提升工作效率,从而推动更明智的商业决策。立即探索,发现最适合您的工具,释放您的AI优势!
14 个工具
xix.ai

2026年最新最佳高评分AI作业助手:不仅提供答案,更传授核心概念。专为学生打造的强大工具,精选必试清单,每周更新,免费与付费版本对比,真实使用测试,精准排名,助您充分释放学习潜能。立即探索,发现最适合您的工具,让学习更高效。
10 个工具
xix.ai

Finally, a company that actually pays for training data instead of scraping everything like a digital hoarder. Bria might be onto something—if they can prove licensed data models work as well, they could dodge a lot of legal headaches. But will investors care about ethics when the ROI is fuzzy? 🤔
이 기사 읽고 나니 AI와 저작권 문제가 참 복잡하네요. 저작권 침해 논란에서 벗어나기 위해 합법 데이터로 훈련된 모델을 개발하는 건 현명한 전략인 것 같아요. 🤔 앞으로 다른 AI 기업들도 비슷한 방향으로 나아갈까요? 한국에서도 이런 논의가 활발히 이루어지면 좋겠어요.
이 기사 보니까 기존 AI 이미지 생성기의 저작권 문제가 정말 심각하네요 🤔 공개 웹사이트 데이터를 무단 사용하니까 당연히 소송 걸리지... 브리아 같은 회사가 라이선스 받은 데이터로 모델 학습하는 건 더 윤리적인 접근처럼 보여요. 앞으로 AI 업계에서 이런 식의 합법적인 모델이 주류가 되겠죠?
This article on Bria's funding is eye-opening! Using licensed data for AI training sounds like a smart move to dodge those messy copyright lawsuits. But I wonder, will this make their models pricier or less creative? 🤔
This article really highlights the messy legal side of AI image generators! It's wild how companies scrape the web for data and then cry 'fair use' when sued. Bria’s approach with licensed data sounds like a smarter move—less drama, more ethics. Curious to see if this sets a trend! 😄
This article on Bria's funding is super intriguing! Using licensed data for AI training feels like a smart move to dodge those messy copyright lawsuits. Curious how this’ll shift the industry—will others follow suit? 🤔












