


 家
Briaは、ライセンスデータでトレーニングされたAIモデルの新鮮な資金を確保しています
AIを活用した画像生成ツールは現在、AI企業に対する数多くの著作権訴訟の中心にあり、主に公共のウェブサイトから取得した膨大なデータセットでトレーニングされているためです。これらの企業はしばしばフェアユースの原則に基づく保護を主張してその慣行を擁護しますが、多くの著作権保有者がこの主張に異議を唱えています。
その結果、2020年にYair AdatoとGal Jacobiによって設立されたニューヨークとテルアビブに拠点を置くBriaなどの一部のスタートアップは、異なるアプローチを取っています。Briaは、ライセンスされたコンテンツのみで画像生成ツールをトレーニングすることを選択し、Getty Imagesなど約20のパートナーと協力して、コンプライアンスとコンテンツの完全性を確保しています。CEOのYair Adatoは、Briaがプラットフォーム全体での「全体的な影響」に基づいて画像所有者に「プログラム的に」報酬を支払っていると強調しました。
「Briaの基盤モデルには10億のビジュアルと数百万のビデオが含まれています」とAdatoはTechCrunchに語りました。彼はさらに、グローバルに代表性のあるデータセットでトレーニングすることで、AI生成ビジュアルによく見られるバイアスを成功裏に軽減したと述べました。このアプローチにより、彼らのモデルは多様で包括的なコンテンツを生成でき、幅広いクリエイティブな用途に理想的です。
Briaは、PhotoshopやFigmaなどの人気の画像編集およびデザインソフトウェアと互換性のあるプラグインを提供することで、ユーザーエクスペリエンスを向上させています。さらに、顧客が特定のニーズに合わせてBriaのモデルをカスタマイズできる微調整APIも提供しています。ユーザーはBriaのプラットフォーム上またはパブリッククラウドなどの外部コンピューティング環境でこれらのモデルを操作する柔軟性があります。Adatoは、すべてのシナリオにおいて顧客がデータと出力の両方の所有権を保持することを保証しました。
「エンタープライズ顧客は、支払いを通じて私たちのソースコードと[モデル]にアクセスできます」とAdatoは説明しました。「ビジュアルの作成と修正のための30以上の専門APIを提供しており、サブスクリプションおよび使用量ベースの価格設定で利用可能です。企業はまた、ブランドアセットを使って私たちの生成AIモデルを微調整し、視覚的アイデンティティを保持するカスタムエンジンを作成できます。」
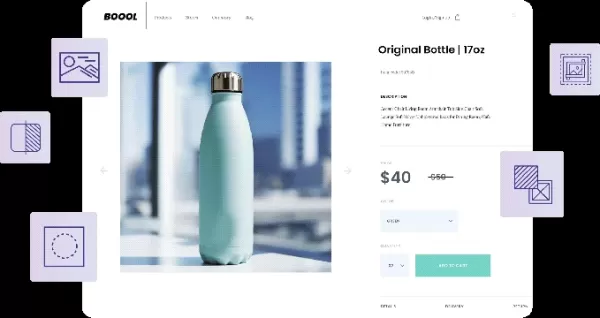
ライセンスされたデータでトレーニングされたBriaのAIモデルは、画像の生成と編集が可能です。画像クレジット:Bria Briaのビジョンは現在の能力を超えて広がっています。AdatoはTechCrunchに対し、40人の従業員を擁する同社が、メディア大手からライセンスされた画像を商業目的で企業が使用できる「IPエコシステム」を構築し、「組み込みのコンプライアンス」を備えることを目指していると語りました。
同社は画像に留まらず、音楽、ビデオ、テキストなどの他のメディアタイプや、デバイス上でのアプリケーションをサポートするプラットフォームの拡張を計画しています。市場の成熟やマクロ経済の圧力など、テクノロジー業界全体の課題にもかかわらず、Adatoはこれらの要因がBriaの市場ポジションを強化すると考えています。
Adobe、Spawning AI、Shutterstockなどの他のベンチャーもライセンスされたメディア生成ツールに進出していますが、Briaはこの新興市場で重要な地位を築いています。木曜日、彼らはRed Dot Capitalが主導し、Maor Investments、Entrée Capital、GFT Ventures、Intel Capital、IN Ventureが支援するシリーズBの資金調達ラウンドで4000万ドルを調達したと発表しました。これにより、Briaの総資金調達額は約6500万ドルとなり、新たな資金のほとんどは製品開発に充てられます。
「我々は40の顧客と共に急速な成長を遂げており、昨年は400%以上の年間経常収益の成長を記録しました」とAdatoは述べました。彼はまた、生成AIの音楽とビデオ、グローバルなセールスとマーケティング、IPおよび著作権法、AIコンサルタンシーなどの専門家を加えてチームを拡大し、年末までにチーム規模を2倍にする計画も明らかにしました。
更新 3/15 午後11:22 太平洋時間:この記事の元のバージョンでは、Briaが2023年に設立されたと誤って記載されており、共同設立者のGal Jacobiの言及が漏れていました。これらの誤りについてお詫び申し上げます。
関連記事
 DeepMindのCEOハサビス氏:1日6時間睡眠し、通常午前1時頃に活力を感じます。
フォーチュンは最近、Google DeepMindのCEOであるデミス・ハサビスへのインタビューを掲載し、彼の休息と生産性に対する非伝統的なアプローチを明らかにした。ハサビスは、睡眠時間が非常に短いことを明かし、覚醒時間を2つの明確な作業ブロックに構造化していると語った。彼の睡眠習慣について、ハサビスは「6時間の睡眠を目標としているが、私の習慣は典型的ではない。一日中効果的に機能できる」と述べた。彼は、6時間未満の睡眠は脳の健康に悪影響を及ぼすことを強調した。2010年にDeepMindを共
OpenAIとAnthropic、収益の伸び悩みにもかかわらず市場シェア争いを繰り広げる
OpenAIが収益目標を達成できなかったとする最近の報道を受け、今週火曜日にハイテク株に売り圧力が生じたにもかかわらず、AI研究機関への民間投資家は依然として堅調だ。経験豊富な出資者たちは、メディアによる否定的な報道にもかかわらず、投資額を減らすつもりはないことを明らかにしている。アナリストらは、現在のAI競争はまだ初期段階にあると見ており、「勝者総取り」という結末はあり得ないと見ている。高いコン
カリフォルニア州の自動運転車規制:違反切符、ジオフェンス、そして100万マイルという新たな時代
Guident社は南フロリダでAuveTechのシャトルを運行しており、同社の遠隔監視技術を活用して、ウェストパームビーチでの4マイルのルートとボカラトンでの1マイルのルートを管理している。 | 提供:Guidentカリフォルニア州は、自動運転車の規制環境を再定義しつつあり、テクノロジー業界の「迅速に動き、失敗を恐れない」という考え方から、厳格な説明責任と厳しい走行距離要件へと移行している。Gui
関連特集おすすめ
チャットボット
 言語練習、面接対策、そして日常の流暢さのための最高のAIロールプレイチャットアプリ
2026年最新版・最高評価のAIロールプレイチャットアプリ|語学練習、面接対策、日常会話の流暢さ向上に!XIX.AIは、無料と有料の比較、実世界でのテスト、毎週更新されるランキングを提供する革新的なコレクションを厳選しています。これらの必須ツールは、ライティングスキルの向上、流暢さの課題克服、そしてあらゆる日常シナリオにおけるコミュニケーション効率の改善をサポートします。今すぐ探索して、あなたの言語成長に最適なツールを見つけましょう!
 10 ツール
 xix.ai
作曲
リミックス制作、サンプリングの準備、カラオケマスター作成のためのAIステム分離ツール
2026年最新・最高評価のAIステム分離ツール。リミックス制作、サンプリング準備、カラオケマスター向けに厳選されました。これらの強力で画期的なツールは、実環境でのテストを経て、正確なオーディオ分離を実現し、生産性を大幅に向上させます。 XIX.AIでは、ニーズに合った「必試」のソリューションを見つけるお手伝いをするため、無料版と有料版の比較ガイドを毎週更新して提供しています。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai
データ分析
収益ダッシュボード、ファネル分析、および製品指標向けのAI SQLコピロット
2026年最新かつ最も優れたAI SQLコピロットが最高評価でランクイン!XIX.AIは、毎週更新される実際の環境でのテストに対応した、強力で革新的なツール群を厳選しています。これらの必見ツールを使えば、正確な収益ダッシュボードの作成や販売プロセスの分析、製品指標の迅速な追跡が可能となり、生産性を大幅に向上させることができます。今すぐチェックして、データに基づいた意思決定に最適なツールを見つけましょう!238文字
9 ツール
xix.ai
作曲
曲のドラフト作成に最適なAIメロディ作成ツール
2026年最新版 高評価のAIメロディ作成ツールで曲のドラフト作成!XIX.AIは、厳格な実世界テストを経て最高の作成体験を提供する、革新的な強力なコレクションを厳選しました。詳細な無料版と有料版の比較、正確なランキング、そして素晴らしい曲のドラフトを楽に作成し、創造的な生産性を大幅に向上させるためにぜひ試すべきオプションが見つかります。今すぐ探索して、あなたに最適なツールを見つけましょう!
8 ツール
xix.ai
チャットボット
面接練習用のベストなAI会話トレーニングツール
2026年最新版・最高評価のAI会話トレーニングツールが、面接練習に最適です。XIX.AIにてご提供しています!この厳選コレクションには、現実世界での厳格なテストを経て正確なフィードバックを提供する強力なツールが含まれています。無料版と有料版の比較や詳細なランキングをご覧いただき、自信とスキルを高めるための必須オプションをお選びください。今すぐ探索して、面接成功に最適なツールを見つけましょう!
12 ツール
xix.ai
デザインとアート
クリエイティブな実験に最適なAIスタイル転送ツール
2026年版 クリエイティブな実験に最適な、最新・最高評価のAIスタイル転送ツール!XIX.AIは、実地テストと厳格なランキングを通じて卓越した結果をもたらす、強力で画期的な「必試」ツールを厳選しました。これらのトップソリューションは、コンテンツ制作を加速させ、無限の創造的可能性を切り拓くことで、クリエイターの生産性を大幅に向上させます。 今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
9 ツール
xix.ai

 コメント (21)
0/500
![RobertSanchez]()
Finally, a company that actually pays for training data instead of scraping everything like a digital hoarder. Bria might be onto something—if they can prove licensed data models work as well, they could dodge a lot of legal headaches. But will investors care about ethics when the ROI is fuzzy? 🤔
![GregoryAdams]()
이 기사 읽고 나니 AI와 저작권 문제가 참 복잡하네요. 저작권 침해 논란에서 벗어나기 위해 합법 데이터로 훈련된 모델을 개발하는 건 현명한 전략인 것 같아요. 🤔 앞으로 다른 AI 기업들도 비슷한 방향으로 나아갈까요? 한국에서도 이런 논의가 활발히 이루어지면 좋겠어요.
![RogerSanchez]()
이 기사 보니까 기존 AI 이미지 생성기의 저작권 문제가 정말 심각하네요 🤔 공개 웹사이트 데이터를 무단 사용하니까 당연히 소송 걸리지... 브리아 같은 회사가 라이선스 받은 데이터로 모델 학습하는 건 더 윤리적인 접근처럼 보여요. 앞으로 AI 업계에서 이런 식의 합법적인 모델이 주류가 되겠죠?
![PaulKing]()
This article on Bria's funding is eye-opening! Using licensed data for AI training sounds like a smart move to dodge those messy copyright lawsuits. But I wonder, will this make their models pricier or less creative? 🤔
![DanielPerez]()
This article really highlights the messy legal side of AI image generators! It's wild how companies scrape the web for data and then cry 'fair use' when sued. Bria’s approach with licensed data sounds like a smarter move—less drama, more ethics. Curious to see if this sets a trend! 😄
![BrianBaker]()
This article on Bria's funding is super intriguing! Using licensed data for AI training feels like a smart move to dodge those messy copyright lawsuits. Curious how this’ll shift the industry—will others follow suit? 🤔
AIを活用した画像生成ツールは現在、AI企業に対する数多くの著作権訴訟の中心にあり、主に公共のウェブサイトから取得した膨大なデータセットでトレーニングされているためです。これらの企業はしばしばフェアユースの原則に基づく保護を主張してその慣行を擁護しますが、多くの著作権保有者がこの主張に異議を唱えています。
その結果、2020年にYair AdatoとGal Jacobiによって設立されたニューヨークとテルアビブに拠点を置くBriaなどの一部のスタートアップは、異なるアプローチを取っています。Briaは、ライセンスされたコンテンツのみで画像生成ツールをトレーニングすることを選択し、Getty Imagesなど約20のパートナーと協力して、コンプライアンスとコンテンツの完全性を確保しています。CEOのYair Adatoは、Briaがプラットフォーム全体での「全体的な影響」に基づいて画像所有者に「プログラム的に」報酬を支払っていると強調しました。
「Briaの基盤モデルには10億のビジュアルと数百万のビデオが含まれています」とAdatoはTechCrunchに語りました。彼はさらに、グローバルに代表性のあるデータセットでトレーニングすることで、AI生成ビジュアルによく見られるバイアスを成功裏に軽減したと述べました。このアプローチにより、彼らのモデルは多様で包括的なコンテンツを生成でき、幅広いクリエイティブな用途に理想的です。
Briaは、PhotoshopやFigmaなどの人気の画像編集およびデザインソフトウェアと互換性のあるプラグインを提供することで、ユーザーエクスペリエンスを向上させています。さらに、顧客が特定のニーズに合わせてBriaのモデルをカスタマイズできる微調整APIも提供しています。ユーザーはBriaのプラットフォーム上またはパブリッククラウドなどの外部コンピューティング環境でこれらのモデルを操作する柔軟性があります。Adatoは、すべてのシナリオにおいて顧客がデータと出力の両方の所有権を保持することを保証しました。
「エンタープライズ顧客は、支払いを通じて私たちのソースコードと[モデル]にアクセスできます」とAdatoは説明しました。「ビジュアルの作成と修正のための30以上の専門APIを提供しており、サブスクリプションおよび使用量ベースの価格設定で利用可能です。企業はまた、ブランドアセットを使って私たちの生成AIモデルを微調整し、視覚的アイデンティティを保持するカスタムエンジンを作成できます。」
Briaのビジョンは現在の能力を超えて広がっています。AdatoはTechCrunchに対し、40人の従業員を擁する同社が、メディア大手からライセンスされた画像を商業目的で企業が使用できる「IPエコシステム」を構築し、「組み込みのコンプライアンス」を備えることを目指していると語りました。
同社は画像に留まらず、音楽、ビデオ、テキストなどの他のメディアタイプや、デバイス上でのアプリケーションをサポートするプラットフォームの拡張を計画しています。市場の成熟やマクロ経済の圧力など、テクノロジー業界全体の課題にもかかわらず、Adatoはこれらの要因がBriaの市場ポジションを強化すると考えています。
Adobe、Spawning AI、Shutterstockなどの他のベンチャーもライセンスされたメディア生成ツールに進出していますが、Briaはこの新興市場で重要な地位を築いています。木曜日、彼らはRed Dot Capitalが主導し、Maor Investments、Entrée Capital、GFT Ventures、Intel Capital、IN Ventureが支援するシリーズBの資金調達ラウンドで4000万ドルを調達したと発表しました。これにより、Briaの総資金調達額は約6500万ドルとなり、新たな資金のほとんどは製品開発に充てられます。
「我々は40の顧客と共に急速な成長を遂げており、昨年は400%以上の年間経常収益の成長を記録しました」とAdatoは述べました。彼はまた、生成AIの音楽とビデオ、グローバルなセールスとマーケティング、IPおよび著作権法、AIコンサルタンシーなどの専門家を加えてチームを拡大し、年末までにチーム規模を2倍にする計画も明らかにしました。
更新 3/15 午後11:22 太平洋時間:この記事の元のバージョンでは、Briaが2023年に設立されたと誤って記載されており、共同設立者のGal Jacobiの言及が漏れていました。これらの誤りについてお詫び申し上げます。








 DeepMindのCEOハサビス氏:1日6時間睡眠し、通常午前1時頃に活力を感じます。
フォーチュンは最近、Google DeepMindのCEOであるデミス・ハサビスへのインタビューを掲載し、彼の休息と生産性に対する非伝統的なアプローチを明らかにした。ハサビスは、睡眠時間が非常に短いことを明かし、覚醒時間を2つの明確な作業ブロックに構造化していると語った。彼の睡眠習慣について、ハサビスは「6時間の睡眠を目標としているが、私の習慣は典型的ではない。一日中効果的に機能できる」と述べた。彼は、6時間未満の睡眠は脳の健康に悪影響を及ぼすことを強調した。2010年にDeepMindを共
 OpenAIとAnthropic、収益の伸び悩みにもかかわらず市場シェア争いを繰り広げる
OpenAIが収益目標を達成できなかったとする最近の報道を受け、今週火曜日にハイテク株に売り圧力が生じたにもかかわらず、AI研究機関への民間投資家は依然として堅調だ。経験豊富な出資者たちは、メディアによる否定的な報道にもかかわらず、投資額を減らすつもりはないことを明らかにしている。アナリストらは、現在のAI競争はまだ初期段階にあると見ており、「勝者総取り」という結末はあり得ないと見ている。高いコン
カリフォルニア州の自動運転車規制:違反切符、ジオフェンス、そして100万マイルという新たな時代
Guident社は南フロリダでAuveTechのシャトルを運行しており、同社の遠隔監視技術を活用して、ウェストパームビーチでの4マイルのルートとボカラトンでの1マイルのルートを管理している。 | 提供:Guidentカリフォルニア州は、自動運転車の規制環境を再定義しつつあり、テクノロジー業界の「迅速に動き、失敗を恐れない」という考え方から、厳格な説明責任と厳しい走行距離要件へと移行している。Gui

2026年最新版・最高評価のAIロールプレイチャットアプリ|語学練習、面接対策、日常会話の流暢さ向上に!XIX.AIは、無料と有料の比較、実世界でのテスト、毎週更新されるランキングを提供する革新的なコレクションを厳選しています。これらの必須ツールは、ライティングスキルの向上、流暢さの課題克服、そしてあらゆる日常シナリオにおけるコミュニケーション効率の改善をサポートします。今すぐ探索して、あなたの言語成長に最適なツールを見つけましょう!
10 ツール
xix.ai

2026年最新・最高評価のAIステム分離ツール。リミックス制作、サンプリング準備、カラオケマスター向けに厳選されました。これらの強力で画期的なツールは、実環境でのテストを経て、正確なオーディオ分離を実現し、生産性を大幅に向上させます。 XIX.AIでは、ニーズに合った「必試」のソリューションを見つけるお手伝いをするため、無料版と有料版の比較ガイドを毎週更新して提供しています。今すぐチェックして、AIの力を最大限に活用しましょう。
8 ツール
xix.ai

2026年最新かつ最も優れたAI SQLコピロットが最高評価でランクイン!XIX.AIは、毎週更新される実際の環境でのテストに対応した、強力で革新的なツール群を厳選しています。これらの必見ツールを使えば、正確な収益ダッシュボードの作成や販売プロセスの分析、製品指標の迅速な追跡が可能となり、生産性を大幅に向上させることができます。今すぐチェックして、データに基づいた意思決定に最適なツールを見つけましょう!238文字
9 ツール
xix.ai

2026年最新版 高評価のAIメロディ作成ツールで曲のドラフト作成!XIX.AIは、厳格な実世界テストを経て最高の作成体験を提供する、革新的な強力なコレクションを厳選しました。詳細な無料版と有料版の比較、正確なランキング、そして素晴らしい曲のドラフトを楽に作成し、創造的な生産性を大幅に向上させるためにぜひ試すべきオプションが見つかります。今すぐ探索して、あなたに最適なツールを見つけましょう!
8 ツール
xix.ai

2026年最新版・最高評価のAI会話トレーニングツールが、面接練習に最適です。XIX.AIにてご提供しています!この厳選コレクションには、現実世界での厳格なテストを経て正確なフィードバックを提供する強力なツールが含まれています。無料版と有料版の比較や詳細なランキングをご覧いただき、自信とスキルを高めるための必須オプションをお選びください。今すぐ探索して、面接成功に最適なツールを見つけましょう!
12 ツール
xix.ai

2026年版 クリエイティブな実験に最適な、最新・最高評価のAIスタイル転送ツール!XIX.AIは、実地テストと厳格なランキングを通じて卓越した結果をもたらす、強力で画期的な「必試」ツールを厳選しました。これらのトップソリューションは、コンテンツ制作を加速させ、無限の創造的可能性を切り拓くことで、クリエイターの生産性を大幅に向上させます。 今すぐチェックして、あなたにぴったりのツールを見つけ、今日から創作を始めましょう!
9 ツール
xix.ai

Finally, a company that actually pays for training data instead of scraping everything like a digital hoarder. Bria might be onto something—if they can prove licensed data models work as well, they could dodge a lot of legal headaches. But will investors care about ethics when the ROI is fuzzy? 🤔
이 기사 읽고 나니 AI와 저작권 문제가 참 복잡하네요. 저작권 침해 논란에서 벗어나기 위해 합법 데이터로 훈련된 모델을 개발하는 건 현명한 전략인 것 같아요. 🤔 앞으로 다른 AI 기업들도 비슷한 방향으로 나아갈까요? 한국에서도 이런 논의가 활발히 이루어지면 좋겠어요.
이 기사 보니까 기존 AI 이미지 생성기의 저작권 문제가 정말 심각하네요 🤔 공개 웹사이트 데이터를 무단 사용하니까 당연히 소송 걸리지... 브리아 같은 회사가 라이선스 받은 데이터로 모델 학습하는 건 더 윤리적인 접근처럼 보여요. 앞으로 AI 업계에서 이런 식의 합법적인 모델이 주류가 되겠죠?
This article on Bria's funding is eye-opening! Using licensed data for AI training sounds like a smart move to dodge those messy copyright lawsuits. But I wonder, will this make their models pricier or less creative? 🤔
This article really highlights the messy legal side of AI image generators! It's wild how companies scrape the web for data and then cry 'fair use' when sued. Bria’s approach with licensed data sounds like a smarter move—less drama, more ethics. Curious to see if this sets a trend! 😄
This article on Bria's funding is super intriguing! Using licensed data for AI training feels like a smart move to dodge those messy copyright lawsuits. Curious how this’ll shift the industry—will others follow suit? 🤔












