


 Дом
Выпущена версия Claude Opus 4.7, в которой надежность ценится выше интеллекта
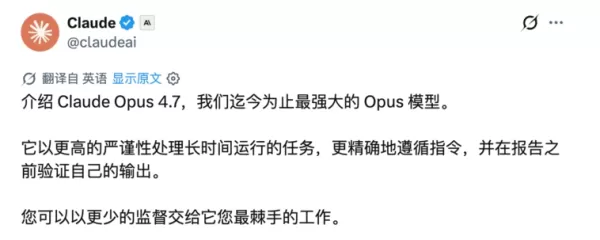
В этом году компания Anthropic сохраняет высокие темпы развития, выпуская новые функции почти каждый день. Долгожданная версия Claude Opus 4.7 только что была официально выпущена, и что интересно, в своём анонсе Anthropic сразу же заявила: «Это не наша самая мощная модель». Ходят слухи, что более мощная версия Claude Mythos Preview пока находится в режиме ожидания. Тем не менее, Opus 4.7 привлек к себе значительное внимание, поскольку решает проблему «большей надежности», а не «большей умности».
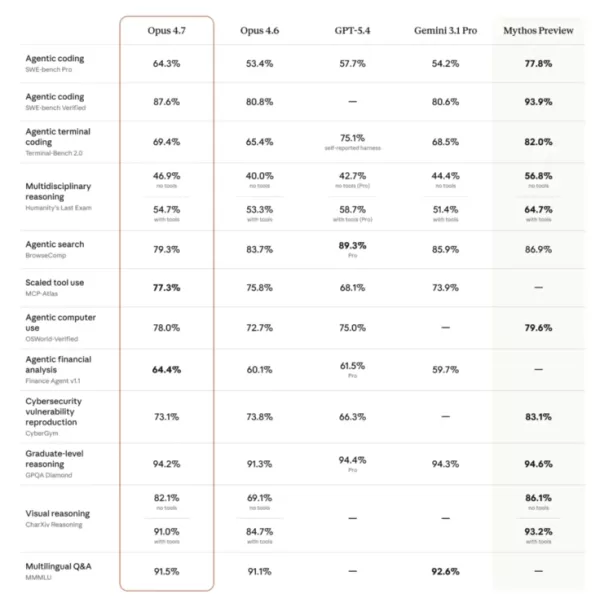
Результаты тестирования впечатляют. В строгом тесте на кодирование SWE-bench Pro результат 4.7 подскочил с 53,4% в предыдущей версии до 64,3%, что означает прирост почти на 11 процентных пунктов, превзойдя GPT-5.4 (57,7%) и Gemini 3.1 Pro (54,2%). В тесте на визуальное мышление CharXiv показатель вырос с 69,1% до 82,1% благодаря недавно добавленной функции распознавания длинной стороны с разрешением 2576 пикселей, которая обеспечивает более чем трехкратное повышение четкости по сравнению с предшественником. В тесте MCP-Atlas по оценке вызова инструментов он набрал 77,3%, а в тесте BigLaw на юридической платформе Harvey — 90,9%. Однако в тесте BrowseComp, оценивающем агентский поиск, версия 4.7 продемонстрировала небольшое снижение результата с 83,7% до 79,3%, уступив GPT-5.4 и Gemini — это объясняется ее «бесфальсификационной» личностью, предпочитающей сообщать об ошибках, а не строить догадки, когда информация неполна.
Помимо цифр, более примечателен сдвиг в характере. Руководитель Replit отметил после тестирования: «Он бросает мне вызов в технических дискуссиях, помогает принимать лучшие решения и действительно ведет себя как лучший коллега». Платформа для работы с данными Hex также заметила, что версия 4.7 напрямую сообщает об ошибках при отсутствии данных, а не предоставляет «кажущееся разумным, но совершенно неверное» альтернативное значение, как раньше. В то же время значительно улучшилась устойчивость к сбоям — тесты команды Notion показывают, что уровень ошибок инструмента снизился до одной трети от прежнего, а при сбое цепочки инструментов он может преодолевать препятствия и самостоятельно завершать задачи. Vercel даже обнаружила новое поведение: перед написанием кода системного уровня версия 4.7 сначала самостоятельно выполняет математические доказательства.
Конечно, расширение возможностей имеет свою цену. В версии 4.7 введен новый токенизатор, генерирующий в 1–1,35 раза больше токенов для одного и того же текста. Кроме того, он склонен «немного дольше думать» над сложными задачами, поэтому фактическое потребление ресурсов почти наверняка выше. Чтобы решить эту проблему, Anthropic добавила уровень xhigh — уровень сверхвысокой интенсивности мышления. Claude Code по умолчанию установила для всех пакетов этот уровень, а также запустила инструкцию Deep Review / ultrareview, расширение Auto Mode для пользователей Max и публичную бета-версию функции «бюджет задач», чтобы помочь разработчикам управлять использованием токенов.
Более мощная версия Mythos Preview недавно стала доступна для предприятий под названием «Project Glasswing» для исследований в области кибербезопасности, но из-за ее ошеломляющих возможностей и незавершенных оценок безопасности она еще не была выпущена для широкой публики.
Сегодняшняя версия 4.7 представляет собой новую веху в ритме высокочастотных релизов Anthropic. Mythos в конечном итоге появится — и когда это произойдет, и без того мощная версия 4.7 может оказаться лишь началом.
Связанная статья
 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех
Рекомендации по связанным специальным темам
Музыкальная композиция
 Инструменты разделения стемов с использованием ИИ для создания ремиксов, подготовки образцов звука и формирования финальных версий караоке.
2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
 8 инструментов
 xix.ai
Анализ данных
ИИ-копилоты для SQL, предназначенные для создания панелей управления доходами, анализа воронки продаж и отслеживания показателей продуктов.
2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai
Музыкальная композиция
Лучшие инструменты для написания мелодий с помощью ИИ для черновиков песен
2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai
чат-бот
Лучшие инструменты для тренировки разговоров с помощью ИИ для подготовки к собеседованиям
2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai
Дизайн и искусство
Лучшие инструменты для переноса стилей с помощью ИИ для творческих экспериментов
2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai
Создание комиксов
Лучшие инструменты для создания диалоговых пузырей с помощью ИИ для визуального повествования
2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai

 Комментарии (0)
В этом году компания Anthropic сохраняет высокие темпы развития, выпуская новые функции почти каждый день. Долгожданная версия Claude Opus 4.7 только что была официально выпущена, и что интересно, в своём анонсе Anthropic сразу же заявила: «Это не наша самая мощная модель». Ходят слухи, что более мощная версия Claude Mythos Preview пока находится в режиме ожидания. Тем не менее, Opus 4.7 привлек к себе значительное внимание, поскольку решает проблему «большей надежности», а не «большей умности».
Результаты тестирования впечатляют. В строгом тесте на кодирование SWE-bench Pro результат 4.7 подскочил с 53,4% в предыдущей версии до 64,3%, что означает прирост почти на 11 процентных пунктов, превзойдя GPT-5.4 (57,7%) и Gemini 3.1 Pro (54,2%). В тесте на визуальное мышление CharXiv показатель вырос с 69,1% до 82,1% благодаря недавно добавленной функции распознавания длинной стороны с разрешением 2576 пикселей, которая обеспечивает более чем трехкратное повышение четкости по сравнению с предшественником. В тесте MCP-Atlas по оценке вызова инструментов он набрал 77,3%, а в тесте BigLaw на юридической платформе Harvey — 90,9%. Однако в тесте BrowseComp, оценивающем агентский поиск, версия 4.7 продемонстрировала небольшое снижение результата с 83,7% до 79,3%, уступив GPT-5.4 и Gemini — это объясняется ее «бесфальсификационной» личностью, предпочитающей сообщать об ошибках, а не строить догадки, когда информация неполна.
Помимо цифр, более примечателен сдвиг в характере. Руководитель Replit отметил после тестирования: «Он бросает мне вызов в технических дискуссиях, помогает принимать лучшие решения и действительно ведет себя как лучший коллега». Платформа для работы с данными Hex также заметила, что версия 4.7 напрямую сообщает об ошибках при отсутствии данных, а не предоставляет «кажущееся разумным, но совершенно неверное» альтернативное значение, как раньше. В то же время значительно улучшилась устойчивость к сбоям — тесты команды Notion показывают, что уровень ошибок инструмента снизился до одной трети от прежнего, а при сбое цепочки инструментов он может преодолевать препятствия и самостоятельно завершать задачи. Vercel даже обнаружила новое поведение: перед написанием кода системного уровня версия 4.7 сначала самостоятельно выполняет математические доказательства.
Конечно, расширение возможностей имеет свою цену. В версии 4.7 введен новый токенизатор, генерирующий в 1–1,35 раза больше токенов для одного и того же текста. Кроме того, он склонен «немного дольше думать» над сложными задачами, поэтому фактическое потребление ресурсов почти наверняка выше. Чтобы решить эту проблему, Anthropic добавила уровень xhigh — уровень сверхвысокой интенсивности мышления. Claude Code по умолчанию установила для всех пакетов этот уровень, а также запустила инструкцию Deep Review / ultrareview, расширение Auto Mode для пользователей Max и публичную бета-версию функции «бюджет задач», чтобы помочь разработчикам управлять использованием токенов.
Более мощная версия Mythos Preview недавно стала доступна для предприятий под названием «Project Glasswing» для исследований в области кибербезопасности, но из-за ее ошеломляющих возможностей и незавершенных оценок безопасности она еще не была выпущена для широкой публики.
Сегодняшняя версия 4.7 представляет собой новую веху в ритме высокочастотных релизов Anthropic. Mythos в конечном итоге появится — и когда это произойдет, и без того мощная версия 4.7 может оказаться лишь началом.








 Генеральный директор DeepMind Хассабис: я сплю шесть часов в день, обычно чувствую прилив энергии около часа ночи.
В недавнем интервью журналу Fortune генеральный директор Google DeepMind Демис Хаассабис раскрыл свой нестандартный подход к отдыху и продуктивности. Хаассабис признался, что спит очень мало, распределяя свои бодрствующие часы на два отдельных рабочи
 OpenAI и Anthropic борются за долю рынка, несмотря на снижение выручки
Несмотря на недавние сообщения о том, что OpenAI не достигла целевых показателей по выручке, что во вторник оказало давление на акции технологических компаний, частные инвесторы, вкладывающие средства
Соблюдение требований к автономным транспортным средствам в Калифорнии: новая эра штрафов, геозоны и 1 млн миль
Компания Guident эксплуатирует шаттл AuveTech в Южной Флориде, обслуживая маршрут протяженностью четыре мили в Вест-Палм-Бич и маршрут протяженностью одну милю в Бока-Ратоне с использованием своей тех

2026 год: лучшие и наиболее высоко оценённые инструменты для разделения аудиосигналов с использованием ИИ, отобранные специально для работы над ремиксами, подготовки образцов звука и создания караоке-версий. Эти мощные революционные инструменты проходят реальные тесты, обеспечивая точную изоляцию аудиосигналов и значительно повышая производительность. XIX.AI предоставляет еженедельно обновляемый бесплатный справочник сравнения платных и бесплатных решений, который поможет вам найти оптимальный вариант, соответствующий вашим потребностям. Ознакомьтесь с ним прямо сейчас, чтобы раскрыть потенциал ИИ в вашей работе.
8 инструментов
xix.ai

2026 год: лучшие AI-ассистенты для SQL, занявшие верхние строчки рейтингов! XIX.AI собрал мощный набор инструментов, регулярно обновляемый на основе реальных тестов. Эти неотъемлемые инструменты помогают создавать точные дашборды с данными о доходах, анализировать каналы продаж и оперативно отслеживать показатели продуктов, значительно повышая производительность. Ознакомьтесь сейчас, чтобы найти идеальный инструмент для принятия решений на основе данных! 238 символов
9 инструментов
xix.ai

2026 год: лучшие, топовые и высокооценённые инструменты ИИ для написания мелодий для черновиков песен! XIX.AI подобрал высокоэффективную коллекцию, меняющую правила игры, которая прошла строгие реальные испытания, чтобы обеспечить лучший опыт написания. Вы можете найти подробные сравнения бесплатных и платных версий, точные рейтинги и обязательные к использованию варианты, разработанные, чтобы помочь вам создавать потрясающие черновики песен без усилий и значительно повысить вашу творческую продуктивность. Исследуйте сейчас, чтобы найти свой идеальный инструмент!
8 инструментов
xix.ai

2026 г. — новейшие, лучшие и наиболее высоко оцененные инструменты для тренировки разговорных навыков с помощью ИИ для подготовки к собеседованиям уже доступны на XIX.AI! Эта тщательно отобранная подборка включает мощные, революционные инструменты, прошедшие строгие реальные испытания и обеспечивающие точную обратную связь. Вы найдете сравнение бесплатных и платных вариантов, а также подробные рейтинги, которые помогут вам выбрать наиболее подходящий инструмент, повышающий вашу уверенность и навыки. Исследуйте сейчас, чтобы найти идеальный инструмент для успешного прохождения собеседований!
12 инструментов
xix.ai

2026: лучшие и самые популярные инструменты для переноса стиля с помощью ИИ для творческих экспериментов! XIX.AI подготовила подборку мощных, революционных инструментов, которые обязательно стоит попробовать: они демонстрируют исключительные результаты, подтвержденные реальными тестами и тщательным рейтингом. Эти ведущие решения помогают творческим людям значительно повысить продуктивность, ускоряя создание контента и открывая безграничные творческие возможности. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент и начать творить уже сегодня!
9 инструментов
xix.ai

2026 года: самые новые и лучшие инструменты с ИИ для создания диалоговых пузырей в визуальном сторителлинге представлены на XIX.AI! В этой тщательно подобранной подборке представлены мощные, революционные инструменты, которые помогут творческим людям повысить продуктивность и преодолеть творческие кризисы. Ознакомьтесь со сравнением бесплатных и платных версий, посмотрите тесты в реальных условиях и изучите последние рейтинги, чтобы найти решения, которые обязательно стоит попробовать и которые идеально подходят для создания увлекательных визуальных историй. Исследуйте коллекцию прямо сейчас, чтобы найти свой идеальный инструмент!
10 инструментов
xix.ai












