


 Heim
Claude Opus 4.7 startet mit dem Grundsatz, dass Zuverlässigkeit vor Intelligenz geht
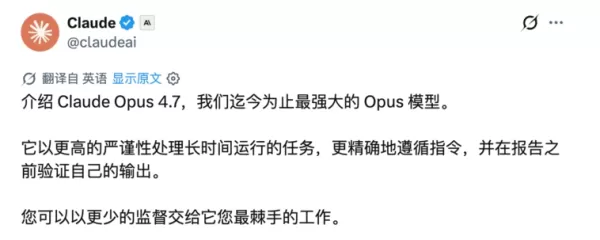
Anthropic hat in diesem Jahr ein hohes Tempo beibehalten und fast jeden zweiten Tag neue Funktionen eingeführt. Das mit Spannung erwartete Claude Opus 4.7 wurde soeben offiziell veröffentlicht, und interessanterweise hat Anthropic in der Ankündigung offen zugegeben: „Dies ist nicht unser leistungsstärkstes Modell.“ Die gemunkelte, leistungsstärkere Vorschauversion von Claude Mythos bleibt vorerst in der Warteschleife. Dennoch hat Opus 4.7 beträchtliche Aufmerksamkeit erregt, da es sich eher mit dem Thema „zuverlässiger“ als mit „intelligenter“ befasst.
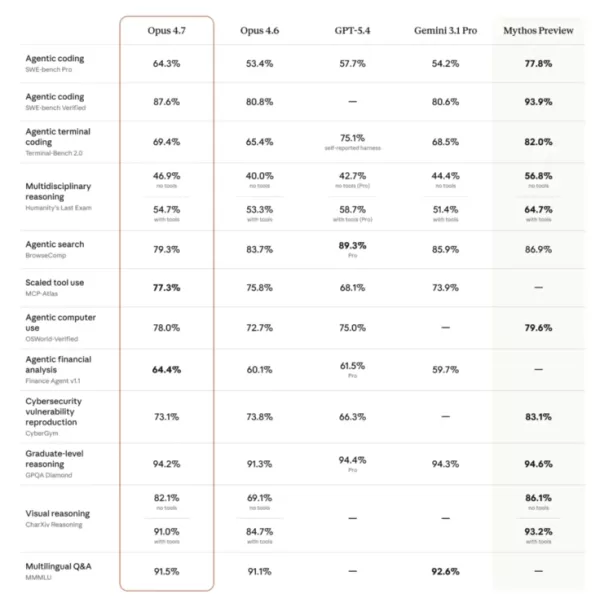
Die Benchmark-Ergebnisse sind besonders beeindruckend. Beim strengen Programmier-Benchmark SWE-bench Pro sprang 4.7 von 53,4 % in der Vorgängerversion auf 64,3 %, ein Zuwachs von fast 11 Prozentpunkten, und übertraf damit GPT-5.4 (57,7 %) und Gemini 3.1 Pro (54,2 %). Beim visuellen Schlussfolgerungs-Benchmark CharXiv stieg die Leistung von 69,1 % auf 82,1 %, angetrieben durch die neu hinzugefügte Erkennungsfunktion für die 2576-Pixel-Längsseite, die mehr als dreimal so viel Klarheit bietet wie der Vorgänger. Bei der Tool-Call-Bewertung MCP-Atlas erzielte es 77,3 %, und beim BigLaw-Benchmark der juristischen KI-Plattform Harvey erreichte es 90,9 %. Bei der agentischen Suchbewertung BrowseComp verzeichnete 4.7 jedoch einen leichten Rückgang von 83,7 % auf 79,3 % und wurde von GPT-5.4 und Gemini überholt – dies wird auf seine „keine Erfindungen“-Persönlichkeit zurückgeführt, die es vorzieht, Fehler zu melden, anstatt zu raten, wenn Informationen unvollständig sind.
Über die Zahlen hinaus ist die Veränderung im Temperament bemerkenswerter. Der Leiter von Replit bemerkte nach dem Test: „Es fordert mich in technischen Diskussionen heraus, hilft mir, bessere Entscheidungen zu treffen, und verhält sich wirklich wie ein besserer Kollege.“ Die Data-Science-Plattform Hex beobachtete zudem, dass 4.7 Fehler direkt meldet, wenn Daten fehlen, anstatt wie zuvor einen „scheinbar vernünftigen, aber völlig falschen“ Alternativwert anzugeben. Gleichzeitig hat sich die Aufgabenresilienz deutlich verbessert – Tests des Notion-Teams zeigen, dass die Fehlerquote des Tools auf ein Drittel des früheren Niveaus gesunken ist, und wenn die Toolkette ausfällt, kann es Hindernisse umgehen und Aufgaben selbstständig abschließen. Vercel entdeckte sogar ein neues Verhalten: Bevor 4.7 Code auf Systemebene schreibt, führt es zunächst selbstständig mathematische Beweise durch.
Natürlich hat die gesteigerte Leistungsfähigkeit ihren Preis. 4.7 führt einen neuen Tokenizer ein, der für denselben Text 1 bis 1,35 Mal mehr Token generiert. Zudem neigt es dazu, bei komplexen Aufgaben „etwas länger nachzudenken“, sodass der tatsächliche Verbrauch mit ziemlicher Sicherheit höher ist. Um dem entgegenzuwirken, hat Anthropic eine xhigh-Stufe für extrem hohe Denkintensität hinzugefügt. Claude Code hat alle Pakete standardmäßig auf diese Stufe eingestellt und zudem die Deep-Review-Anweisung / ultrareview, die Auto-Mode-Erweiterung für Max-Nutzer sowie eine öffentliche Beta-Version der „Task-Budget“-Funktion eingeführt, um Entwicklern bei der Verwaltung der Token-Nutzung zu helfen.
Die leistungsstärkere Mythos-Vorschau wurde kürzlich unter dem Namen „Project Glasswing“ für Unternehmen im Bereich Cybersicherheitsforschung bereitgestellt, ist jedoch aufgrund ihrer überwältigenden Leistungsfähigkeit und unvollständiger Sicherheitsbewertungen noch nicht öffentlich veröffentlicht worden.
Die heutige Version 4.7 stellt den neuesten Meilenstein im hochfrequenten Release-Rhythmus von Anthropic dar. Mythos wird irgendwann kommen – und wenn es soweit ist, könnte sich die bereits starke Version 4.7 als bloßer Anfang erweisen.
Verwandter Artikel
 Anthropic erweitert die Claude KI-Coding-Tools in Japan im Rahmen der Bemühungen um internationales Wachstum
Anthropic, ein führendes US-amerikalisches Unternehmen für künstliche Intelligenz, intensiviert seine globalen Outreach-Bemühungen. Am Mittwoch veranstaltete das Unternehmen in Tokio eine große Entwicklerkonferenz namens „Code with Claude“, an der kn
Indiens Software-Riese stellt weniger ein, verspricht aber keine Entlassungen, während KI-Agenten ausgebaut werden
Während die künstliche Intelligenz traditionelle, arbeitsintensive Geschäftsmodelle neu gestaltet, hat Tata Consultancy Services (TCS), ein führendes indisches Software-Outsourcing-Unternehmen, seine strategische Antwort vorgestellt. Während der jähr
China sperrt KI-Modelle während des Gaokam, um sofortige Hausaufgabenhilfe zu blockieren
Mit dem sich dem 2026-Gaokao schnell nähernden Termin haben Gerüchte über die Sperrung von KI-Tools während der Prüfungsphase eine intensive Online-Debatte entfacht. Als Reaktion auf die öffentlichen Bedenken haben große KI-Plattformen und Bildungs-A
Empfehlungen zu verwandten Spezialthemen
Design & Kunst
 Die besten KI-Tools für den Stiltransfer für kreative Experimente
Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
 9 Tools
 xix.ai
Comic-Erstellung
Die besten KI-Tools für Sprechblasen zum visuellen Geschichtenerzählen
Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai
Besprechungsassistent
Die besten Tools zur Zusammenfassung von KI-Meetings: Entscheidungen und Folgemaßnahmen übersichtlich nachverfolgen
Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai
Datenanalyse
Die besten Tools für die KI-gestützte Datenreinigung: Fehlende Werte und Duplikate schnell beheben
2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai
Design & Kunst
Die besten KI-gestützten Kreativwerkzeuge für Künstler: Den Durchbruch durch visuelle Blockaden
2026 Neueste Besten Top-Bewerteten KI-Kreativitäts-Tools für Künstler wurden von XIX.AI kuratiert, um Kreativen zu helfen, visuelle Blockaden zu durchbrechen und die Kreativität sofort zu steigern. Diese leistungsstarken, bahnbrechenden Tools bieten reale Tests, detaillierte kostenlose vs. kostenpflichtige Vergleiche und wöchentlich aktualisierte Rankings. Entdecken Sie Ihr perfektes Tool, um die Content-Erstellung zu beschleunigen und Ihren KI-Vorteil noch heute freizuschalten. Jetzt erkunden!
14 Tools
xix.ai
Musikkomposition
KI-Beat-Maker für TikTok-Hintergrundmusik, Reels-Audio und Werbemusik für Creator
Die besten KI-Beat-Generatoren 2026 für TikTok-Hintergrundtracks, Reels-Audio und Promo-Musik für Creator! XIX.AI hat eine Liste der besten Tools zusammengestellt, die bahnbrechende Funktionen bieten und in der Praxis getestet wurden, um makellose Musik für jeden Content-Bedarf zu liefern. Hier findest du detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Angeboten, wöchentlich aktualisierte Rankings sowie Optionen, die du unbedingt ausprobieren solltest, um deine Kreativität und Produktivität zu steigern. Entdecke jetzt das perfekte Tool für dich!
11 Tools
xix.ai

 Kommentare (0)
Anthropic hat in diesem Jahr ein hohes Tempo beibehalten und fast jeden zweiten Tag neue Funktionen eingeführt. Das mit Spannung erwartete Claude Opus 4.7 wurde soeben offiziell veröffentlicht, und interessanterweise hat Anthropic in der Ankündigung offen zugegeben: „Dies ist nicht unser leistungsstärkstes Modell.“ Die gemunkelte, leistungsstärkere Vorschauversion von Claude Mythos bleibt vorerst in der Warteschleife. Dennoch hat Opus 4.7 beträchtliche Aufmerksamkeit erregt, da es sich eher mit dem Thema „zuverlässiger“ als mit „intelligenter“ befasst.
Die Benchmark-Ergebnisse sind besonders beeindruckend. Beim strengen Programmier-Benchmark SWE-bench Pro sprang 4.7 von 53,4 % in der Vorgängerversion auf 64,3 %, ein Zuwachs von fast 11 Prozentpunkten, und übertraf damit GPT-5.4 (57,7 %) und Gemini 3.1 Pro (54,2 %). Beim visuellen Schlussfolgerungs-Benchmark CharXiv stieg die Leistung von 69,1 % auf 82,1 %, angetrieben durch die neu hinzugefügte Erkennungsfunktion für die 2576-Pixel-Längsseite, die mehr als dreimal so viel Klarheit bietet wie der Vorgänger. Bei der Tool-Call-Bewertung MCP-Atlas erzielte es 77,3 %, und beim BigLaw-Benchmark der juristischen KI-Plattform Harvey erreichte es 90,9 %. Bei der agentischen Suchbewertung BrowseComp verzeichnete 4.7 jedoch einen leichten Rückgang von 83,7 % auf 79,3 % und wurde von GPT-5.4 und Gemini überholt – dies wird auf seine „keine Erfindungen“-Persönlichkeit zurückgeführt, die es vorzieht, Fehler zu melden, anstatt zu raten, wenn Informationen unvollständig sind.
Über die Zahlen hinaus ist die Veränderung im Temperament bemerkenswerter. Der Leiter von Replit bemerkte nach dem Test: „Es fordert mich in technischen Diskussionen heraus, hilft mir, bessere Entscheidungen zu treffen, und verhält sich wirklich wie ein besserer Kollege.“ Die Data-Science-Plattform Hex beobachtete zudem, dass 4.7 Fehler direkt meldet, wenn Daten fehlen, anstatt wie zuvor einen „scheinbar vernünftigen, aber völlig falschen“ Alternativwert anzugeben. Gleichzeitig hat sich die Aufgabenresilienz deutlich verbessert – Tests des Notion-Teams zeigen, dass die Fehlerquote des Tools auf ein Drittel des früheren Niveaus gesunken ist, und wenn die Toolkette ausfällt, kann es Hindernisse umgehen und Aufgaben selbstständig abschließen. Vercel entdeckte sogar ein neues Verhalten: Bevor 4.7 Code auf Systemebene schreibt, führt es zunächst selbstständig mathematische Beweise durch.
Natürlich hat die gesteigerte Leistungsfähigkeit ihren Preis. 4.7 führt einen neuen Tokenizer ein, der für denselben Text 1 bis 1,35 Mal mehr Token generiert. Zudem neigt es dazu, bei komplexen Aufgaben „etwas länger nachzudenken“, sodass der tatsächliche Verbrauch mit ziemlicher Sicherheit höher ist. Um dem entgegenzuwirken, hat Anthropic eine xhigh-Stufe für extrem hohe Denkintensität hinzugefügt. Claude Code hat alle Pakete standardmäßig auf diese Stufe eingestellt und zudem die Deep-Review-Anweisung / ultrareview, die Auto-Mode-Erweiterung für Max-Nutzer sowie eine öffentliche Beta-Version der „Task-Budget“-Funktion eingeführt, um Entwicklern bei der Verwaltung der Token-Nutzung zu helfen.
Die leistungsstärkere Mythos-Vorschau wurde kürzlich unter dem Namen „Project Glasswing“ für Unternehmen im Bereich Cybersicherheitsforschung bereitgestellt, ist jedoch aufgrund ihrer überwältigenden Leistungsfähigkeit und unvollständiger Sicherheitsbewertungen noch nicht öffentlich veröffentlicht worden.
Die heutige Version 4.7 stellt den neuesten Meilenstein im hochfrequenten Release-Rhythmus von Anthropic dar. Mythos wird irgendwann kommen – und wenn es soweit ist, könnte sich die bereits starke Version 4.7 als bloßer Anfang erweisen.








 Anthropic erweitert die Claude KI-Coding-Tools in Japan im Rahmen der Bemühungen um internationales Wachstum
Anthropic, ein führendes US-amerikalisches Unternehmen für künstliche Intelligenz, intensiviert seine globalen Outreach-Bemühungen. Am Mittwoch veranstaltete das Unternehmen in Tokio eine große Entwicklerkonferenz namens „Code with Claude“, an der kn
 Indiens Software-Riese stellt weniger ein, verspricht aber keine Entlassungen, während KI-Agenten ausgebaut werden
Während die künstliche Intelligenz traditionelle, arbeitsintensive Geschäftsmodelle neu gestaltet, hat Tata Consultancy Services (TCS), ein führendes indisches Software-Outsourcing-Unternehmen, seine strategische Antwort vorgestellt. Während der jähr
 China sperrt KI-Modelle während des Gaokam, um sofortige Hausaufgabenhilfe zu blockieren
Mit dem sich dem 2026-Gaokao schnell nähernden Termin haben Gerüchte über die Sperrung von KI-Tools während der Prüfungsphase eine intensive Online-Debatte entfacht. Als Reaktion auf die öffentlichen Bedenken haben große KI-Plattformen und Bildungs-A

Die besten und am besten bewerteten KI-Tools für den Stiltransfer im Jahr 2026 – ideal für kreative Experimente! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die in Praxistests und strengen Bewertungen außergewöhnliche Ergebnisse liefern. Diese Top-Lösungen helfen Kreativen dabei, ihre Produktivität deutlich zu steigern, indem sie die Erstellung von Inhalten beschleunigen und unendliche kreative Möglichkeiten eröffnen. Entdecken Sie jetzt Ihr perfektes Tool und legen Sie noch heute los!
9 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools für Sprechblasen zum visuellen Storytelling des Jahres 2026 finden Sie hier auf XIX.AI! Diese sorgfältig zusammengestellte Sammlung umfasst leistungsstarke, bahnbrechende Tools, die Kreativen dabei helfen, ihre Produktivität zu steigern und kreative Blockaden zu überwinden. Holen Sie sich einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, sehen Sie sich Praxistests an und werfen Sie einen Blick auf die aktuellen Rankings, um die unverzichtbaren Lösungen zu finden, die sich perfekt für die Gestaltung fesselnder visueller Erzählungen eignen. Stöbern Sie jetzt und entdecken Sie Ihr ideales Tool!
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Tools zur Zusammenfassung von Besprechungen im Jahr 2026 für eine übersichtliche Nachverfolgung von Entscheidungen und müheloses Follow-up. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke, bahnbrechende Lösungen, die die Produktivität drastisch steigern, indem sie Besprechungsnotizen automatisieren, wichtige Aktionspunkte identifizieren und die Teamkoordination projektübergreifend optimieren. Erhalten Sie einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten sowie Praxistests und wöchentlich aktualisierte Rankings, die Ihnen helfen, das perfekte Tool zu finden. Entdecken Sie es jetzt und nutzen Sie Ihren KI-Vorteil!
9 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten Tools für die Reinigung von KI-Daten, um fehlende Werte sowie Duplikate schnell zu beheben. Diese sorgfältig zusammengestellte Liste präsentiert leistungsstarke Lösungen, die die Produktivität erheblich steigern. Jedes Tool wurde in der Praxis gründlich getestet, um seine Zuverlässigkeit zu gewährleisten. Holen Sie sich einen kostenlosen Vergleich zwischen kostenloser und kostenpflichtiger Variante und entdecken Sie das für Ihre Bedürfnisse beste Tool. Entdecken Sie es jetzt auf XIX.AI, um Ihren Vorteil in der KI-Branche zu erlangen.
11 Tools
xix.ai

2026 Neueste Besten Top-Bewerteten KI-Kreativitäts-Tools für Künstler wurden von XIX.AI kuratiert, um Kreativen zu helfen, visuelle Blockaden zu durchbrechen und die Kreativität sofort zu steigern. Diese leistungsstarken, bahnbrechenden Tools bieten reale Tests, detaillierte kostenlose vs. kostenpflichtige Vergleiche und wöchentlich aktualisierte Rankings. Entdecken Sie Ihr perfektes Tool, um die Content-Erstellung zu beschleunigen und Ihren KI-Vorteil noch heute freizuschalten. Jetzt erkunden!
14 Tools
xix.ai

Die besten KI-Beat-Generatoren 2026 für TikTok-Hintergrundtracks, Reels-Audio und Promo-Musik für Creator! XIX.AI hat eine Liste der besten Tools zusammengestellt, die bahnbrechende Funktionen bieten und in der Praxis getestet wurden, um makellose Musik für jeden Content-Bedarf zu liefern. Hier findest du detaillierte Vergleichsdaten zu kostenlosen und kostenpflichtigen Angeboten, wöchentlich aktualisierte Rankings sowie Optionen, die du unbedingt ausprobieren solltest, um deine Kreativität und Produktivität zu steigern. Entdecke jetzt das perfekte Tool für dich!
11 Tools
xix.ai












