


 Maison
Claude Opus 4.7 fait son entrée sur le marché en misant davantage sur la fiabilité que sur l'intelligence
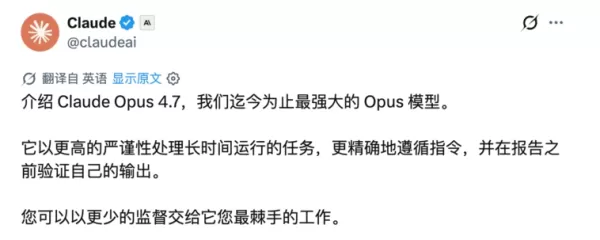
Anthropic a maintenu un rythme soutenu cette année, en déployant de nouvelles fonctionnalités presque tous les deux jours. Le très attendu Claude Opus 4.7 vient d'être officiellement lancé, et il est intéressant de noter qu'Anthropic a été franc dans son annonce : « Ce n'est pas notre modèle le plus puissant. » La version Claude Mythos Preview, dont on murmure qu’elle serait plus performante, reste en attente. Pourtant, Opus 4.7 a suscité un intérêt considérable car il s’attache à être « plus fiable » plutôt que « plus intelligent ».
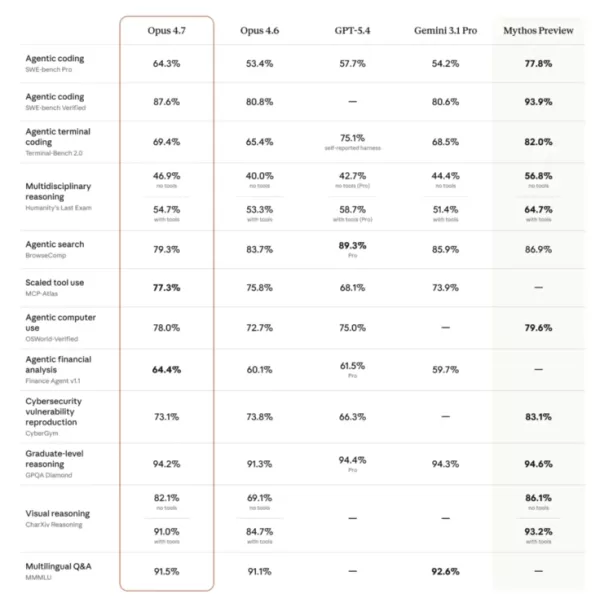
Les résultats des tests de performance sont particulièrement impressionnants. Sur le test de codage rigoureux SWE-bench Pro, la version 4.7 est passée de 53,4 % dans la version précédente à 64,3 %, soit un gain de près de 11 points de pourcentage, surpassant GPT-5.4 (57,7 %) et Gemini 3.1 Pro (54,2 %). Sur le benchmark de raisonnement visuel CharXiv, il est passé de 69,1 % à 82,1 %, grâce à la nouvelle fonctionnalité de reconnaissance des côtés longs de 2 576 pixels, offrant une clarté plus de trois fois supérieure à celle de son prédécesseur. Sur l'évaluation des appels d'outils MCP-Atlas, il a obtenu un score de 77,3 %, et sur le benchmark BigLaw de la plateforme d'IA juridique Harvey, il a atteint 90,9 %. Cependant, sur le benchmark de recherche agentique BrowseComp, la version 4.7 a connu une légère baisse, passant de 83,7 % à 79,3 %, dépassée par GPT-5.4 et Gemini — ce qui s’explique par sa personnalité « sans invention », qui préfère signaler les erreurs plutôt que de deviner lorsque les informations sont incomplètes.
Au-delà des chiffres, c'est le changement de tempérament qui est le plus remarquable. Le dirigeant de Replit a noté après les tests : « Il me met au défi lors des discussions techniques, m'aide à prendre de meilleures décisions et se comporte véritablement comme un meilleur collègue. » La plateforme de science des données Hex a également observé que la version 4.7 signale directement les erreurs lorsque des données manquent, plutôt que de fournir une valeur alternative « apparemment raisonnable mais complètement incorrecte » comme auparavant. Dans le même temps, la résilience face aux tâches s’est considérablement améliorée : les tests de l’équipe Notion indiquent que le taux d’erreur de l’outil a été réduit à un tiers de son niveau précédent, et lorsque la chaîne d’outils échoue, il est capable de contourner les obstacles et d’accomplir les tâches de manière autonome. Vercel a même découvert un nouveau comportement : avant d’écrire du code au niveau du système, la version 4.7 effectue d’abord des preuves mathématiques de son propre chef.
Bien sûr, cette capacité accrue a un coût. La version 4.7 introduit un nouveau tokenizer, générant 1 à 1,35 fois plus de tokens pour un même texte. De plus, elle a tendance à « réfléchir un peu plus longtemps » sur les tâches complexes, de sorte que la consommation réelle est presque certainement plus élevée. Pour y remédier, Anthropic a ajouté un niveau d’intensité de réflexion ultra-élevé, « xhigh ». Claude Code a réglé tous les packages sur ce niveau par défaut, et a également lancé l’instruction Deep Review / ultrareview, l’extension Auto Mode pour les utilisateurs de Max, ainsi qu’une version bêta publique de la fonctionnalité « task budget » pour aider les développeurs à gérer l’utilisation des tokens.
La version plus puissante Mythos Preview a récemment été mise à la disposition des entreprises sous le nom de « Project Glasswing » pour la recherche en cybersécurité, mais en raison de ses capacités impressionnantes et de l’incomplétude des évaluations de sécurité, elle n’a pas encore été rendue publique.
La version 4.7 d'aujourd'hui représente la dernière étape en date du rythme de livraison à haute fréquence d'Anthropic. Mythos finira par arriver — et quand ce sera le cas, la version 4.7, déjà très performante, pourrait bien n'être qu'un début.
Article connexe
 Les lunettes intelligentes d’Apple pourraient être présentées lors de la WWDC27, mettant en avant la protection de la vie privée
Mark Gurman de Bloomberg rapporte que les lunettes intelligentes d’Apple, codifiées N50, sont prévues pour une présentation lors de la WWDC27 en juin 2027, avec un lancement commercial attendu à l’automne 2027. Initialement destinées à la fin de cett
À l’intérieur des détails révélés sur le prochain Gemini : une puissance de calcul mise à rude épreuve, des équipes internes en désaccord sur les priorités de développement et l’allocation des ressources
Les rapports indiquent que le lancement du modèle Gemini de nouvelle génération, tant attendu par Google, a été repoussé. Des désaccords internes concernant les priorités de développement et l'allocation des ressources, combinés à une capacité de cal
OpenAI rejette les inquiétudes concernant un ralentissement de la croissance, affirmant que plusieurs unités commerciales accélèrent
En réponse aux critiques externes concernant la décélération de la croissance des ventes et le non-respect des objectifs internes, le leader de l'IA, OpenAI, a publié une déclaration rassurante le mardi 28 avril. L'entreprise a précisé que ses produi
Recommandations de sujets spéciaux liés
Analyse des données
 Copilotes SQL basés sur l’IA pour les tableaux de bord de chiffre d’affaires, l’analyse des funnels et les indicateurs de produits
2026 : Les meilleurs copilotes AI SQL actuels, classés parmi les plus performants ! XIX.AI a sélectionné une collection puissante et révolutionnaire, mise à jour chaque semaine grâce à des tests concrets. Ces outils indispensables vous aident à créer des tableaux de bord financiers précis, à analyser les canaux de vente et à suivre en temps réel les indicateurs produits, ce qui améliore considérablement votre productivité. Découvrez-les dès maintenant pour trouver l’outil idéal pour des décisions basées sur les données ! 238 caractères
 9 outils
 xix.ai
Composition musicale
Meilleurs outils d’écriture de mélodies par IA pour les ébauches de chansons
2026 Derniers Meilleurs Outils d’Écriture de Mélodie par IA les Mieux Notés pour des Ébauches de Chansons ! XIX.AI a sélectionné une collection hautement puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles, afin d’offrir la meilleure expérience d’écriture. Vous pouvez y trouver des comparaisons détaillées entre versions gratuites et payantes, des classements précis, ainsi que des options incontournables conçues pour vous aider à créer sans effort des ébauches de chansons remarquables et à booster significativement votre productivité créative. Explorez dès maintenant pour découvrir l’outil qui vous correspond parfaitement !
8 outils
xix.ai
chatbot
Meilleurs outils d’entraînement à la conversation par IA pour la préparation aux entretiens
Les derniers outils de formation à la conversation par IA les mieux notés pour 2026 sont disponibles sur XIX.AI ! Cette sélection rigoureuse propose des outils puissants et révolutionnaires, testés rigoureusement dans des conditions réelles pour fournir des retours précis. Vous y trouverez une comparaison entre les versions gratuites et payantes, ainsi que des classements détaillés pour vous aider à choisir l’option incontournable qui renforce votre confiance et vos compétences. Explorez dès maintenant pour découvrir l’outil parfait pour réussir vos entretiens !
12 outils
xix.ai
Conception et art
Les meilleurs outils de transfert de style basés sur l'IA pour des expériences créatives
Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai
Création de bande dessinée
Les meilleurs outils d'IA pour créer des bulles de dialogue destinés à la narration visuelle
Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai
Assistante de réunion
Les meilleurs outils de synthèse de réunions basés sur l'IA : suivez clairement les décisions et les actions à mener
2026 : les meilleurs outils d'IA pour la synthèse de réunions, les mieux notés, pour un suivi clair des décisions et des relances sans effort. Cette sélection présente des solutions puissantes et révolutionnaires qui boostent considérablement la productivité en automatisant la prise de notes lors des réunions, en identifiant les actions clés et en rationalisant la coordination des équipes sur l'ensemble des projets. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements mis à jour chaque semaine pour vous aider à trouver l'outil idéal. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
9 outils
xix.ai

 commentaires (0)
Anthropic a maintenu un rythme soutenu cette année, en déployant de nouvelles fonctionnalités presque tous les deux jours. Le très attendu Claude Opus 4.7 vient d'être officiellement lancé, et il est intéressant de noter qu'Anthropic a été franc dans son annonce : « Ce n'est pas notre modèle le plus puissant. » La version Claude Mythos Preview, dont on murmure qu’elle serait plus performante, reste en attente. Pourtant, Opus 4.7 a suscité un intérêt considérable car il s’attache à être « plus fiable » plutôt que « plus intelligent ».
Les résultats des tests de performance sont particulièrement impressionnants. Sur le test de codage rigoureux SWE-bench Pro, la version 4.7 est passée de 53,4 % dans la version précédente à 64,3 %, soit un gain de près de 11 points de pourcentage, surpassant GPT-5.4 (57,7 %) et Gemini 3.1 Pro (54,2 %). Sur le benchmark de raisonnement visuel CharXiv, il est passé de 69,1 % à 82,1 %, grâce à la nouvelle fonctionnalité de reconnaissance des côtés longs de 2 576 pixels, offrant une clarté plus de trois fois supérieure à celle de son prédécesseur. Sur l'évaluation des appels d'outils MCP-Atlas, il a obtenu un score de 77,3 %, et sur le benchmark BigLaw de la plateforme d'IA juridique Harvey, il a atteint 90,9 %. Cependant, sur le benchmark de recherche agentique BrowseComp, la version 4.7 a connu une légère baisse, passant de 83,7 % à 79,3 %, dépassée par GPT-5.4 et Gemini — ce qui s’explique par sa personnalité « sans invention », qui préfère signaler les erreurs plutôt que de deviner lorsque les informations sont incomplètes.
Au-delà des chiffres, c'est le changement de tempérament qui est le plus remarquable. Le dirigeant de Replit a noté après les tests : « Il me met au défi lors des discussions techniques, m'aide à prendre de meilleures décisions et se comporte véritablement comme un meilleur collègue. » La plateforme de science des données Hex a également observé que la version 4.7 signale directement les erreurs lorsque des données manquent, plutôt que de fournir une valeur alternative « apparemment raisonnable mais complètement incorrecte » comme auparavant. Dans le même temps, la résilience face aux tâches s’est considérablement améliorée : les tests de l’équipe Notion indiquent que le taux d’erreur de l’outil a été réduit à un tiers de son niveau précédent, et lorsque la chaîne d’outils échoue, il est capable de contourner les obstacles et d’accomplir les tâches de manière autonome. Vercel a même découvert un nouveau comportement : avant d’écrire du code au niveau du système, la version 4.7 effectue d’abord des preuves mathématiques de son propre chef.
Bien sûr, cette capacité accrue a un coût. La version 4.7 introduit un nouveau tokenizer, générant 1 à 1,35 fois plus de tokens pour un même texte. De plus, elle a tendance à « réfléchir un peu plus longtemps » sur les tâches complexes, de sorte que la consommation réelle est presque certainement plus élevée. Pour y remédier, Anthropic a ajouté un niveau d’intensité de réflexion ultra-élevé, « xhigh ». Claude Code a réglé tous les packages sur ce niveau par défaut, et a également lancé l’instruction Deep Review / ultrareview, l’extension Auto Mode pour les utilisateurs de Max, ainsi qu’une version bêta publique de la fonctionnalité « task budget » pour aider les développeurs à gérer l’utilisation des tokens.
La version plus puissante Mythos Preview a récemment été mise à la disposition des entreprises sous le nom de « Project Glasswing » pour la recherche en cybersécurité, mais en raison de ses capacités impressionnantes et de l’incomplétude des évaluations de sécurité, elle n’a pas encore été rendue publique.
La version 4.7 d'aujourd'hui représente la dernière étape en date du rythme de livraison à haute fréquence d'Anthropic. Mythos finira par arriver — et quand ce sera le cas, la version 4.7, déjà très performante, pourrait bien n'être qu'un début.








 Les lunettes intelligentes d’Apple pourraient être présentées lors de la WWDC27, mettant en avant la protection de la vie privée
Mark Gurman de Bloomberg rapporte que les lunettes intelligentes d’Apple, codifiées N50, sont prévues pour une présentation lors de la WWDC27 en juin 2027, avec un lancement commercial attendu à l’automne 2027. Initialement destinées à la fin de cett
 À l’intérieur des détails révélés sur le prochain Gemini : une puissance de calcul mise à rude épreuve, des équipes internes en désaccord sur les priorités de développement et l’allocation des ressources
Les rapports indiquent que le lancement du modèle Gemini de nouvelle génération, tant attendu par Google, a été repoussé. Des désaccords internes concernant les priorités de développement et l'allocation des ressources, combinés à une capacité de cal
 OpenAI rejette les inquiétudes concernant un ralentissement de la croissance, affirmant que plusieurs unités commerciales accélèrent
En réponse aux critiques externes concernant la décélération de la croissance des ventes et le non-respect des objectifs internes, le leader de l'IA, OpenAI, a publié une déclaration rassurante le mardi 28 avril. L'entreprise a précisé que ses produi

2026 : Les meilleurs copilotes AI SQL actuels, classés parmi les plus performants ! XIX.AI a sélectionné une collection puissante et révolutionnaire, mise à jour chaque semaine grâce à des tests concrets. Ces outils indispensables vous aident à créer des tableaux de bord financiers précis, à analyser les canaux de vente et à suivre en temps réel les indicateurs produits, ce qui améliore considérablement votre productivité. Découvrez-les dès maintenant pour trouver l’outil idéal pour des décisions basées sur les données ! 238 caractères
9 outils
xix.ai

2026 Derniers Meilleurs Outils d’Écriture de Mélodie par IA les Mieux Notés pour des Ébauches de Chansons ! XIX.AI a sélectionné une collection hautement puissante et révolutionnaire, soumise à des tests rigoureux en conditions réelles, afin d’offrir la meilleure expérience d’écriture. Vous pouvez y trouver des comparaisons détaillées entre versions gratuites et payantes, des classements précis, ainsi que des options incontournables conçues pour vous aider à créer sans effort des ébauches de chansons remarquables et à booster significativement votre productivité créative. Explorez dès maintenant pour découvrir l’outil qui vous correspond parfaitement !
8 outils
xix.ai

Les derniers outils de formation à la conversation par IA les mieux notés pour 2026 sont disponibles sur XIX.AI ! Cette sélection rigoureuse propose des outils puissants et révolutionnaires, testés rigoureusement dans des conditions réelles pour fournir des retours précis. Vous y trouverez une comparaison entre les versions gratuites et payantes, ainsi que des classements détaillés pour vous aider à choisir l’option incontournable qui renforce votre confiance et vos compétences. Explorez dès maintenant pour découvrir l’outil parfait pour réussir vos entretiens !
12 outils
xix.ai

Les meilleurs outils de transfert de style par IA de 2026, les mieux notés, pour des expériences créatives ! XIX.AI a sélectionné une collection d’outils puissants et révolutionnaires à essayer absolument, qui offrent des résultats exceptionnels grâce à des tests en conditions réelles et à un classement rigoureux. Ces solutions de pointe aident les créatifs à booster considérablement leur productivité en accélérant la création de contenu et en ouvrant la voie à des possibilités créatives infinies. Découvrez-les dès maintenant pour trouver l'outil qui vous convient le mieux et commencez à créer dès aujourd'hui !
9 outils
xix.ai

Les meilleurs outils de 2026 pour la création de bulles de dialogue IA, les mieux notés pour la narration visuelle, sont disponibles ici sur XIX.AI ! Cette sélection regroupe des outils puissants et révolutionnaires qui aident les créateurs à booster leur productivité et à surmonter les blocages créatifs. Consultez un comparatif entre les versions gratuites et payantes, découvrez des tests en conditions réelles et consultez les derniers classements pour trouver les solutions incontournables, parfaites pour créer des récits visuels captivants. Explorez dès maintenant pour découvrir l'outil qui vous convient le mieux !
10 outils
xix.ai

2026 : les meilleurs outils d'IA pour la synthèse de réunions, les mieux notés, pour un suivi clair des décisions et des relances sans effort. Cette sélection présente des solutions puissantes et révolutionnaires qui boostent considérablement la productivité en automatisant la prise de notes lors des réunions, en identifiant les actions clés et en rationalisant la coordination des équipes sur l'ensemble des projets. Profitez d'une comparaison entre les versions gratuites et payantes, ainsi que de tests en conditions réelles et de classements mis à jour chaque semaine pour vous aider à trouver l'outil idéal. Découvrez-les dès maintenant pour tirer pleinement parti de l'IA !
9 outils
xix.ai












