


 Maison
L'ESI-Bench de Li Feifei : l'IA passe du statut d'observatrice à celui d'actrice
Récemment, l’ESI-Bench (Embodied Spatial Intelligence Benchmark), publié par l’équipe de Fei-Fei Li, a suscité un vif intérêt. Considéré comme l’« ImageNet de l’intelligence incarnée », ce benchmark met en évidence les lacunes majeures des grands modèles de pointe lorsqu’ils interagissent avec l’espace physique.
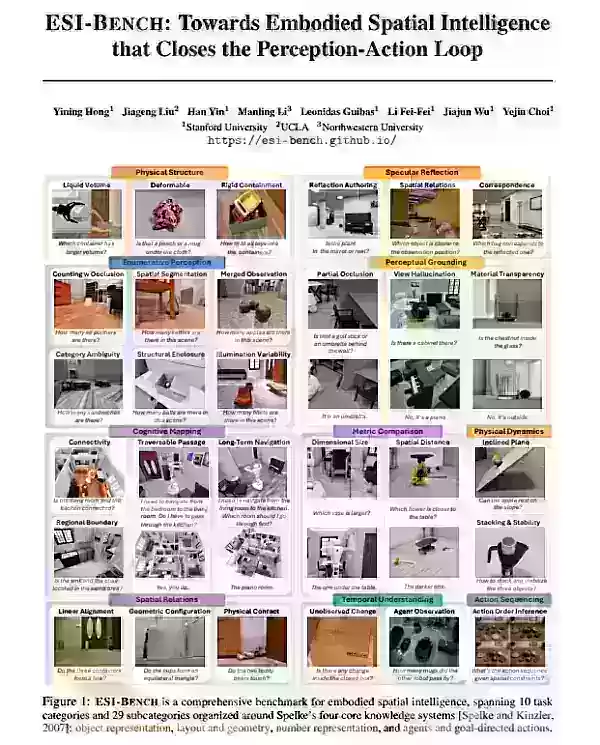
Pourquoi l’ESI-Bench établit une nouvelle norme en matière d’intelligence incarnée
Les évaluations antérieures de l’intelligence spatiale en IA reposaient en grande partie sur une « perception passive » : on fournissait au modèle quelques images présentant des vues optimales et on le laissait raisonner logiquement. Cette approche testait essentiellement la « vision » du modèle plutôt que sa « cognition spatiale ».
La principale avancée d’ESI-Bench réside dans la mise en œuvre de la boucle perception-action.
Les observateurs deviennent des acteurs : dans ESI-Bench, le modèle ne peut pas rester immobile et se contenter de juger à partir d’images fournies ; il doit décider activement où aller, quoi regarder, quels objets saisir et quelles structures mécaniques actionner, afin de révéler des informations spatiales cachées à travers une série d’actions interactives.
Fondements conceptuels : ce benchmark s’appuie sur le « système de connaissances fondamentales des nourrissons humains » de la psychologue cognitive Elizabeth Spelke, qui couvre quatre dimensions : la représentation des objets, la disposition et la géométrie, la représentation des quantités et l’action orientée vers un but.
Échelle et plateforme : il comprend 10 catégories, 29 sous-catégories et 3 081 exemples de tâches, développés sur la plateforme de simulation OmniGibson à partir de ressources issues de la bibliothèque de scènes BEHAVIOR-1K.
Trois vérités fondamentales révélées par l’évaluation
L’équipe de recherche a mené des tests approfondis sur des modèles multimodaux de pointe tels que GPT-5 et la série Gemini. Les résultats donnent à réfléchir :
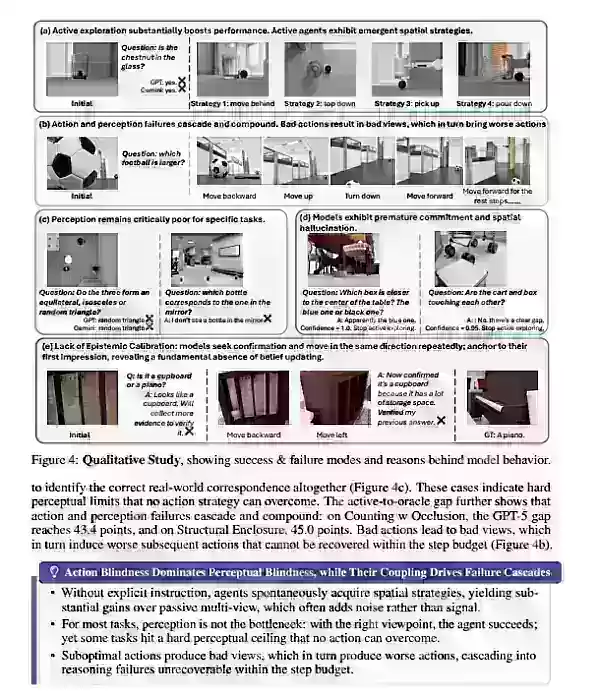
1. Ce n’est pas la perception qui constitue le goulot d’étranglement, mais la stratégie d’action
Lorsqu’on leur fournit la vue optimale, les modèles donnent souvent des réponses précises — la précision peut passer de 14,6 % à 95,1 %. Mais lorsqu’ils doivent trouver activement cette vue, la précision chute de manière spectaculaire.
Cécité d’action : les modèles manquent de stratégies de navigation et de manipulation ; des actions incorrectes conduisent à des vues de mauvaise qualité, ce qui déclenche des erreurs en cascade dans les jugements ultérieurs.
2. Une reconstruction 3D imparfaite est plus trompeuse que des images 2D
Cette étude remet en cause l’hypothèse selon laquelle « les cartes 3D constituent une solution universelle ».
Lorsqu’on leur fournit des données de référence 3D parfaites prises en vue aérienne, les performances de raisonnement sont excellentes. Cependant, l’utilisation des techniques VGGT avancées actuelles pour la reconstruction en temps réel introduit des artefacts géométriques, des erreurs d’occlusion et des écarts de profondeur — ce qui revient essentiellement à alimenter le modèle de raisonnement avec des données toxiques, ce qui donne des performances inférieures à celles obtenues en visualisant simplement des images 2D.
3. Déficit métacognitif : l’IA ne sait pas qu’elle « n’en a pas vu assez »
C’est là le plus grand fossé cognitif entre les humains et l’IA :
Différence de prudence cognitive : les humains recherchent activement des points de vue contradictoires lorsque les informations sont ambiguës et réduisent leur niveau de confiance en cas d’incertitude.
Hallucination du modèle : les modèles cessent souvent d’explorer trop tôt, même avec des informations extrêmement limitées, et fournissent avec assurance des conclusions erronées. L’équipe appelle cela le « déficit métacognitif » : le modèle ne dispose pas d’un mécanisme interne de doute et ne peut pas évaluer si les informations actuelles sont suffisantes.
Quelle est la prochaine étape pour l’intelligence incarnée ?
ESI-Bench marque un changement de paradigme, passant de la « mise en correspondance statique image-texte » à une « véritable interaction physique » dans l’évaluation de l’intelligence incarnée. Comme le souligne l’équipe de Fei-Fei Li, parvenir à une véritable intelligence spatiale nécessite davantage que de simplement empiler des encodeurs visuels ou d’augmenter la puissance de calcul.
Les futures recherches sur l’intelligence incarnée doivent se concentrer sur la capacité des modèles à :
une capacité de prise de décision active en matière de séquences d’exploration, plutôt qu’une simple reconnaissance d’images ;
une plus grande robustesse, afin de conserver un jugement logique même lorsque les observations de la scène sont imparfaites ;
une boucle métacognitive intégrée, afin que l’IA apprenne à explorer lorsqu’elle manque de réponses, au lieu de produire de fausses hallucinations.
Article connexe
 Otter.ai obtient 320 millions de dollars de financement de croissance de General Catalyst pour son outil de réunion
Mardi, Otter.ai, une plateforme de prise de notes de réunions, a annoncé un investissement de 320 millions de dollars provenant du fonds Customer Value Fund (CVF) de General Catalyst. Ce fonds soutient les startups sans exiger de dilution des parts,
Anthropic lance Claude Haiku 5.5, réduisant les coûts des petits modèles de 75 % et permettant aux utilisateurs d’ajuster l’intensité de l’inférence
Le 8 octobre, Anthropic a présenté son modèle le plus efficace et le plus performant à ce jour : Claude Haiku 5.5. Positionné comme le petit modèle le plus rapide et le plus capable de la gamme d’Anthropic, il est conçu pour des applications à haute
Claude dévoile la première carte complète du ciel en ultraviolet, cartographiant 119 millions d'étoiles
Avec l’aide puissante de Claude, le grand modèle de langage d’Anthropic, des astrophysiciens ont réussi à générer la première carte complète du ciel entier en ultraviolets de l’histoire. Cette vaste carte stellaire, comportant 119 millions d’étoiles,
Recommandations de sujets spéciaux liés
Conception et art
 Les meilleurs outils d'illustration basés sur l'IA : créez plus rapidement des scènes éditoriales et des illustrations de couverture
Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
 10 outils
 xix.ai
Éducation et apprentissage
Les meilleurs professeurs particuliers spécialisés en IA pour la préparation aux examens : entraînez-vous en maths, en sciences et en anglais
Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai
Finance
Outils de planification budgétaire par IA pour la gestion personnelle des finances
2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai
Santé et bien-être
Assistants de suivi du sommeil par l’IA : améliorez votre récupération grâce à de meilleures habitudes avant le coucher
2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai
Analyse des données
Copilotes SQL basés sur l'IA pour l'analyse des produits et du chiffre d'affaires
2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai
Éducation et apprentissage
Les meilleurs outils d'aide aux devoirs basés sur l'IA qui enseignent : apprenez les concepts, pas seulement les réponses
2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

 commentaires (1)
![BrianWalker]()
「観測者からアクターへ」という転換、確かに興味深いですね。Fei-Fei Liさんのチームが提唱するESI-Bench、単なる画像認識の限界を超えて、物理世界での行動能力を測る試みは壮大です。でも正直、今のLLMが本当に「行動」できるのか?という懐疑的な視点も持っています。ロボットの制御と大規模言語モデルの融合は容易ではないはず。このベンチマークがどの程度の実効性を持つのか、今後の展開に注目です。🤖✨
Récemment, l’ESI-Bench (Embodied Spatial Intelligence Benchmark), publié par l’équipe de Fei-Fei Li, a suscité un vif intérêt. Considéré comme l’« ImageNet de l’intelligence incarnée », ce benchmark met en évidence les lacunes majeures des grands modèles de pointe lorsqu’ils interagissent avec l’espace physique.
Pourquoi l’ESI-Bench établit une nouvelle norme en matière d’intelligence incarnée
Les évaluations antérieures de l’intelligence spatiale en IA reposaient en grande partie sur une « perception passive » : on fournissait au modèle quelques images présentant des vues optimales et on le laissait raisonner logiquement. Cette approche testait essentiellement la « vision » du modèle plutôt que sa « cognition spatiale ».
La principale avancée d’ESI-Bench réside dans la mise en œuvre de la boucle perception-action.
Les observateurs deviennent des acteurs : dans ESI-Bench, le modèle ne peut pas rester immobile et se contenter de juger à partir d’images fournies ; il doit décider activement où aller, quoi regarder, quels objets saisir et quelles structures mécaniques actionner, afin de révéler des informations spatiales cachées à travers une série d’actions interactives.
Fondements conceptuels : ce benchmark s’appuie sur le « système de connaissances fondamentales des nourrissons humains » de la psychologue cognitive Elizabeth Spelke, qui couvre quatre dimensions : la représentation des objets, la disposition et la géométrie, la représentation des quantités et l’action orientée vers un but.
Échelle et plateforme : il comprend 10 catégories, 29 sous-catégories et 3 081 exemples de tâches, développés sur la plateforme de simulation OmniGibson à partir de ressources issues de la bibliothèque de scènes BEHAVIOR-1K.
Trois vérités fondamentales révélées par l’évaluation
L’équipe de recherche a mené des tests approfondis sur des modèles multimodaux de pointe tels que GPT-5 et la série Gemini. Les résultats donnent à réfléchir :
1. Ce n’est pas la perception qui constitue le goulot d’étranglement, mais la stratégie d’action
Lorsqu’on leur fournit la vue optimale, les modèles donnent souvent des réponses précises — la précision peut passer de 14,6 % à 95,1 %. Mais lorsqu’ils doivent trouver activement cette vue, la précision chute de manière spectaculaire.
Cécité d’action : les modèles manquent de stratégies de navigation et de manipulation ; des actions incorrectes conduisent à des vues de mauvaise qualité, ce qui déclenche des erreurs en cascade dans les jugements ultérieurs.
2. Une reconstruction 3D imparfaite est plus trompeuse que des images 2D
Cette étude remet en cause l’hypothèse selon laquelle « les cartes 3D constituent une solution universelle ».
Lorsqu’on leur fournit des données de référence 3D parfaites prises en vue aérienne, les performances de raisonnement sont excellentes. Cependant, l’utilisation des techniques VGGT avancées actuelles pour la reconstruction en temps réel introduit des artefacts géométriques, des erreurs d’occlusion et des écarts de profondeur — ce qui revient essentiellement à alimenter le modèle de raisonnement avec des données toxiques, ce qui donne des performances inférieures à celles obtenues en visualisant simplement des images 2D.
3. Déficit métacognitif : l’IA ne sait pas qu’elle « n’en a pas vu assez »
C’est là le plus grand fossé cognitif entre les humains et l’IA :
Différence de prudence cognitive : les humains recherchent activement des points de vue contradictoires lorsque les informations sont ambiguës et réduisent leur niveau de confiance en cas d’incertitude.
Hallucination du modèle : les modèles cessent souvent d’explorer trop tôt, même avec des informations extrêmement limitées, et fournissent avec assurance des conclusions erronées. L’équipe appelle cela le « déficit métacognitif » : le modèle ne dispose pas d’un mécanisme interne de doute et ne peut pas évaluer si les informations actuelles sont suffisantes.
Quelle est la prochaine étape pour l’intelligence incarnée ?
ESI-Bench marque un changement de paradigme, passant de la « mise en correspondance statique image-texte » à une « véritable interaction physique » dans l’évaluation de l’intelligence incarnée. Comme le souligne l’équipe de Fei-Fei Li, parvenir à une véritable intelligence spatiale nécessite davantage que de simplement empiler des encodeurs visuels ou d’augmenter la puissance de calcul.
Les futures recherches sur l’intelligence incarnée doivent se concentrer sur la capacité des modèles à :
une capacité de prise de décision active en matière de séquences d’exploration, plutôt qu’une simple reconnaissance d’images ;
une plus grande robustesse, afin de conserver un jugement logique même lorsque les observations de la scène sont imparfaites ;
une boucle métacognitive intégrée, afin que l’IA apprenne à explorer lorsqu’elle manque de réponses, au lieu de produire de fausses hallucinations.








 Otter.ai obtient 320 millions de dollars de financement de croissance de General Catalyst pour son outil de réunion
Mardi, Otter.ai, une plateforme de prise de notes de réunions, a annoncé un investissement de 320 millions de dollars provenant du fonds Customer Value Fund (CVF) de General Catalyst. Ce fonds soutient les startups sans exiger de dilution des parts,
 Anthropic lance Claude Haiku 5.5, réduisant les coûts des petits modèles de 75 % et permettant aux utilisateurs d’ajuster l’intensité de l’inférence
Le 8 octobre, Anthropic a présenté son modèle le plus efficace et le plus performant à ce jour : Claude Haiku 5.5. Positionné comme le petit modèle le plus rapide et le plus capable de la gamme d’Anthropic, il est conçu pour des applications à haute
 Claude dévoile la première carte complète du ciel en ultraviolet, cartographiant 119 millions d'étoiles
Avec l’aide puissante de Claude, le grand modèle de langage d’Anthropic, des astrophysiciens ont réussi à générer la première carte complète du ciel entier en ultraviolets de l’histoire. Cette vaste carte stellaire, comportant 119 millions d’étoiles,

Les meilleurs outils d'illustration IA de 2026 : notre sélection regroupe les outils les plus performants pour créer rapidement de superbes scènes éditoriales et des couvertures accrocheuses. Chaque option a été soumise à des tests rigoureux en conditions réelles ; nous vous proposons une comparaison entre les versions gratuites et payantes afin de vous aider à trouver celle qui correspond le mieux à votre flux de travail. Essayez dès aujourd’hui ces solutions incontournables pour exploiter pleinement le potentiel de l’IA et booster votre productivité créative. Découvrez-les dès maintenant sur XIX.AI.
10 outils
xix.ai

Les meilleurs tuteurs IA 2026 les mieux notés pour la préparation aux examens sont disponibles ici, sur XIX.AI ! Notre sélection comprend des outils puissants et révolutionnaires qui proposent une comparaison entre les versions gratuites et payantes, des tests concrets et des classements mis à jour chaque semaine. Ils vous aident à améliorer votre efficacité à l'écrit, à simplifier l'apprentissage de sujets complexes et à libérer votre potentiel académique. Découvrez dès maintenant l'outil de préparation aux examens qui vous convient le mieux et commencez à créer dès aujourd'hui pour exploiter pleinement les avantages de l'IA !
10 outils
xix.ai

2026 Derniers Meilleurs Outils de Planification Budgétaire par IA les mieux notés pour la gestion personnelle des finances sont ici sur XIX.AI ! Cette collection soigneusement sélectionnée propose des solutions puissantes et révolutionnaires qui vous aident à réaliser des tests concrets, à comprendre vos habitudes de dépenses et à créer des plans personnalisés pour améliorer votre productivité. Profitez d’une comparaison entre versions gratuites et payantes ainsi que de classements détaillés. Des outils incontournables conçus pour simplifier la gestion financière et exploiter pleinement votre avantage grâce à l’IA. Explorez dès maintenant !
11 outils
xix.ai

2026 : Découvrez les meilleurs assistants de suivi du sommeil basés sur l’IA, hautement notés et récemment mis à jour, conçus pour une récupération optimale. Ce guide hebdomadaire entièrement actualisé présente des outils puissants qui offrent des tests en conditions réelles, des comparaisons entre versions gratuites et payantes, ainsi que des classements détaillés afin de vous aider à trouver la solution idéale pour améliorer la qualité du sommeil et favoriser de meilleures habitudes avant le coucher. Explorez-le dès maintenant sur XIX.AI pour tirer parti des avantages offerts par l’IA.
10 outils
xix.ai

2026 : les meilleurs copilotes SQL IA les mieux notés pour l'analyse des produits et du chiffre d'affaires ! XIX.AI a sélectionné une gamme d’outils puissants et révolutionnaires à essayer absolument, qui sont soumis à des tests en conditions réelles via des classements mis à jour chaque semaine. Ces outils aident les utilisateurs à booster considérablement leur productivité en accélérant l’analyse des données, en simplifiant les requêtes complexes et en générant des informations précises permettant de prendre des décisions commerciales plus éclairées. Explorez-les dès maintenant pour découvrir l’outil idéal qui vous permettra de tirer pleinement parti de l’IA !
14 outils
xix.ai

2026 : les meilleurs outils d'aide aux devoirs basés sur l'IA, les mieux notés, qui enseignent les concepts fondamentaux et ne se contentent pas de fournir des réponses. Des outils puissants pour les élèves. Une sélection incontournable à ne pas manquer. Mise à jour hebdomadaire. Comparaison entre les versions gratuites et payantes. Tests en conditions réelles. Classements précis pour vous aider à exploiter pleinement votre potentiel d'apprentissage. Explorez dès maintenant pour découvrir l'outil idéal qui vous permettra d'étudier plus efficacement.
10 outils
xix.ai

「観測者からアクターへ」という転換、確かに興味深いですね。Fei-Fei Liさんのチームが提唱するESI-Bench、単なる画像認識の限界を超えて、物理世界での行動能力を測る試みは壮大です。でも正直、今のLLMが本当に「行動」できるのか?という懐疑的な視点も持っています。ロボットの制御と大規模言語モデルの融合は容易ではないはず。このベンチマークがどの程度の実効性を持つのか、今後の展開に注目です。🤖✨












