


 Hogar
El ESI-Bench de Li Feifei: la IA pasa de ser mera observadora a convertirse en protagonista
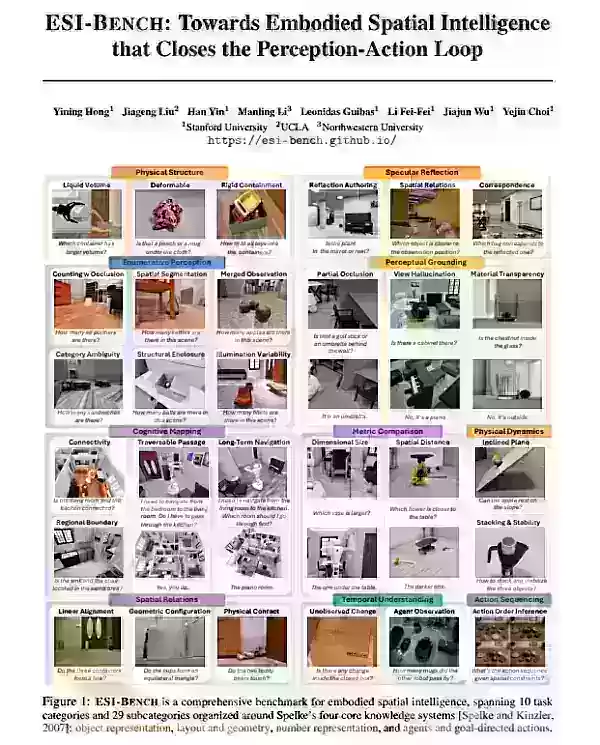
Recientemente, el ESI-Bench (Embodied Spatial Intelligence Benchmark), publicado por el equipo de Fei-Fei Li, ha suscitado un gran interés. Considerado el «ImageNet de la inteligencia incorporada», este banco de pruebas pone de manifiesto las deficiencias fundamentales de los principales modelos a gran escala a la hora de interactuar con el espacio físico.
Por qué ESI-Bench marca un nuevo estándar para la inteligencia incorporada
Las evaluaciones anteriores de la inteligencia espacial de la IA se basaban en gran medida en la «percepción pasiva»: se introducían unas pocas imágenes con una perspectiva óptima y se dejaba que el modelo razonara lógicamente. Ese enfoque pone a prueba, esencialmente, la «visión» del modelo, más que su «cognición espacial».
El avance fundamental de ESI-Bench es su aplicación del ciclo percepción-acción.
Los observadores se convierten en actores: en ESI-Bench, el modelo no puede permanecer inmóvil y juzgar a partir de imágenes dadas; debe decidir activamente adónde ir, qué mirar, qué objetos coger y qué estructuras mecánicas accionar, descubriendo información espacial oculta a través de una serie de acciones interactivas.
Fundamentos de diseño: El banco de pruebas se basa en el «sistema de conocimiento básico de los bebés humanos» de la psicóloga cognitiva Elizabeth Spelke, que abarca cuatro dimensiones: representación de objetos, disposición y geometría, representación de cantidades y acción orientada a objetivos.
Escala y plataforma: Incluye 10 categorías, 29 subcategorías y 3.081 instancias de tareas, desarrolladas en la plataforma de simulación OmniGibson con materiales de la biblioteca de escenas BEHAVIOR-1K.
Tres verdades fundamentales reveladas por la evaluación
El equipo de investigación llevó a cabo pruebas exhaustivas con modelos multimodales de vanguardia, como GPT-5 y la serie Gemini. Los resultados invitan a la reflexión:
1. La percepción no es el cuello de botella, sino la estrategia de acción
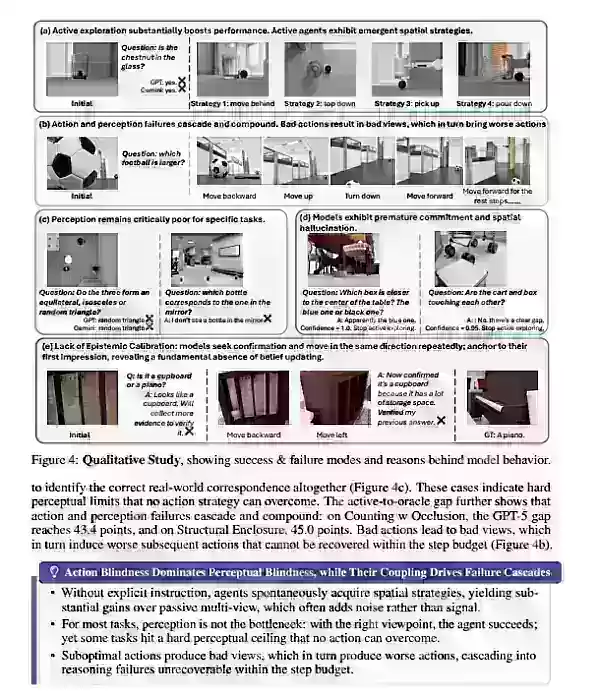
Cuando se les proporciona la vista óptima, los modelos suelen ofrecer respuestas precisas —la precisión puede pasar del 14,6 % al 95,1 %—. Sin embargo, cuando deben buscar activamente esa vista, la precisión cae drásticamente.
Ceguera de acción: los modelos carecen de estrategias de navegación y manipulación; las acciones incorrectas dan lugar a perspectivas deficientes, lo que desencadena una cascada de errores en los juicios posteriores.
2. La reconstrucción 3D imperfecta es más engañosa que las imágenes 2D
El estudio refuta la suposición de que «los mapas 3D son una solución universal».
Cuando se le proporcionan datos de referencia 3D aéreos perfectos, el rendimiento del razonamiento es excelente. Sin embargo, el uso de los actuales VGGT avanzados para la reconstrucción en tiempo real introduce artefactos geométricos, errores de oclusión y desviaciones de profundidad —lo que, en esencia, supone alimentar al modelo de razonamiento con datos tóxicos, lo que da lugar a un rendimiento peor que el de la simple visualización de imágenes 2D—.
3. Déficit metacognitivo: la IA no sabe que «no ha visto lo suficiente»
Esta es la mayor brecha cognitiva entre los seres humanos y la IA:
Diferencia en la cautela cognitiva: los seres humanos buscan activamente perspectivas que refuten la hipótesis cuando la información es ambigua y reducen su confianza ante la incertidumbre.
Alucinaciones del modelo: los modelos suelen dejar de explorar demasiado pronto, incluso con información extremadamente limitada, y ofrecen con seguridad conclusiones incorrectas. El equipo denomina a esto «déficit metacognitivo»: el modelo carece de un mecanismo interno de duda y no puede evaluar si la información actual es suficiente.
Hacia dónde se dirige la inteligencia incorporada
ESI-Bench marca un cambio de paradigma, pasando de la «correspondencia estática entre imagen y texto» a la «interacción física real» en la evaluación de la inteligencia encarnada. Tal y como señala el equipo de Fei-Fei Li, lograr una verdadera inteligencia espacial requiere algo más que apilar codificadores visuales o aumentar la potencia de cálculo.
La futura investigación sobre la inteligencia incorporada debe centrarse en dotar a los modelos de:
Capacidad de toma de decisiones en secuencias de exploración activa, en lugar del simple reconocimiento de imágenes;
una mayor robustez, para mantener el juicio lógico incluso con observaciones imperfectas de la escena;
Un bucle metacognitivo integrado, de modo que la IA aprenda a explorar cuando carezca de respuestas, en lugar de generar falsas alucinaciones.
Artículo relacionado
 Otter.ai asegura 320 millones de dólares en financiación de crecimiento de General Catalyst para su herramienta de reuniones
El martes, Otter.ai, una plataforma de toma de notas para reuniones, anunció una inversión de 320 millones de dólares del Fondo de Valor al Cliente (CVF) de General Catalyst. Este fondo apoya a las startups sin requerir dilución de capital, buscando
Anthropic lanza Claude Haiku 5.5, reduciendo los costos de los modelos pequeños en un 75% y permitiendo a los usuarios ajustar la intensidad de inferencia
El 8 de octubre, Anthropic presentó su modelo más eficiente y capaz hasta la fecha: Claude Haiku 5.5. Posicionado como el modelo pequeño más rápido y capaz de la gama de Anthropic, está diseñado para aplicaciones de alta frecuencia y sensibles al cos
Claude presenta el primer mapa completo del cielo en ultravioleta, que cartografía 119 millones de estrellas
Con la poderosa asistencia de Claude, el modelo de lenguaje grande de Anthropic, los astrofísicos han generado con éxito el primer mapa completo del cielo en ultravioleta de la historia. Este vasto catálogo estelar, que incluye 119 millones de estrel
Recomendaciones de temas especiales relacionados
Diseño y Arte
 Las mejores herramientas de ilustración con IA: crea escenas editoriales y portadas más rápido
Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
 10 herramientas
 xix.ai
Educación y aprendizaje
Los mejores profesores particulares de IA para la preparación de exámenes: practica matemáticas, ciencias e inglés
¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai
Finanzas
Herramientas de planificación presupuestaria con IA para la gestión personal del dinero
2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai
Salud y bienestar
Asistentes de seguimiento del sueño basados en IA: mejora tu recuperación con mejores hábitos a la hora de acostarte
Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai
Análisis de datos
Copilotos de IA y SQL para el análisis de productos e ingresos
¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai
Educación y aprendizaje
Las mejores herramientas de IA para los deberes que realmente enseñan: aprende conceptos, no solo respuestas
2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

 comentario (1)
0/500
![BrianWalker]()
「観測者からアクターへ」という転換、確かに興味深いですね。Fei-Fei Liさんのチームが提唱するESI-Bench、単なる画像認識の限界を超えて、物理世界での行動能力を測る試みは壮大です。でも正直、今のLLMが本当に「行動」できるのか?という懐疑的な視点も持っています。ロボットの制御と大規模言語モデルの融合は容易ではないはず。このベンチマークがどの程度の実効性を持つのか、今後の展開に注目です。🤖✨
Recientemente, el ESI-Bench (Embodied Spatial Intelligence Benchmark), publicado por el equipo de Fei-Fei Li, ha suscitado un gran interés. Considerado el «ImageNet de la inteligencia incorporada», este banco de pruebas pone de manifiesto las deficiencias fundamentales de los principales modelos a gran escala a la hora de interactuar con el espacio físico.
Por qué ESI-Bench marca un nuevo estándar para la inteligencia incorporada
Las evaluaciones anteriores de la inteligencia espacial de la IA se basaban en gran medida en la «percepción pasiva»: se introducían unas pocas imágenes con una perspectiva óptima y se dejaba que el modelo razonara lógicamente. Ese enfoque pone a prueba, esencialmente, la «visión» del modelo, más que su «cognición espacial».
El avance fundamental de ESI-Bench es su aplicación del ciclo percepción-acción.
Los observadores se convierten en actores: en ESI-Bench, el modelo no puede permanecer inmóvil y juzgar a partir de imágenes dadas; debe decidir activamente adónde ir, qué mirar, qué objetos coger y qué estructuras mecánicas accionar, descubriendo información espacial oculta a través de una serie de acciones interactivas.
Fundamentos de diseño: El banco de pruebas se basa en el «sistema de conocimiento básico de los bebés humanos» de la psicóloga cognitiva Elizabeth Spelke, que abarca cuatro dimensiones: representación de objetos, disposición y geometría, representación de cantidades y acción orientada a objetivos.
Escala y plataforma: Incluye 10 categorías, 29 subcategorías y 3.081 instancias de tareas, desarrolladas en la plataforma de simulación OmniGibson con materiales de la biblioteca de escenas BEHAVIOR-1K.
Tres verdades fundamentales reveladas por la evaluación
El equipo de investigación llevó a cabo pruebas exhaustivas con modelos multimodales de vanguardia, como GPT-5 y la serie Gemini. Los resultados invitan a la reflexión:
1. La percepción no es el cuello de botella, sino la estrategia de acción
Cuando se les proporciona la vista óptima, los modelos suelen ofrecer respuestas precisas —la precisión puede pasar del 14,6 % al 95,1 %—. Sin embargo, cuando deben buscar activamente esa vista, la precisión cae drásticamente.
Ceguera de acción: los modelos carecen de estrategias de navegación y manipulación; las acciones incorrectas dan lugar a perspectivas deficientes, lo que desencadena una cascada de errores en los juicios posteriores.
2. La reconstrucción 3D imperfecta es más engañosa que las imágenes 2D
El estudio refuta la suposición de que «los mapas 3D son una solución universal».
Cuando se le proporcionan datos de referencia 3D aéreos perfectos, el rendimiento del razonamiento es excelente. Sin embargo, el uso de los actuales VGGT avanzados para la reconstrucción en tiempo real introduce artefactos geométricos, errores de oclusión y desviaciones de profundidad —lo que, en esencia, supone alimentar al modelo de razonamiento con datos tóxicos, lo que da lugar a un rendimiento peor que el de la simple visualización de imágenes 2D—.
3. Déficit metacognitivo: la IA no sabe que «no ha visto lo suficiente»
Esta es la mayor brecha cognitiva entre los seres humanos y la IA:
Diferencia en la cautela cognitiva: los seres humanos buscan activamente perspectivas que refuten la hipótesis cuando la información es ambigua y reducen su confianza ante la incertidumbre.
Alucinaciones del modelo: los modelos suelen dejar de explorar demasiado pronto, incluso con información extremadamente limitada, y ofrecen con seguridad conclusiones incorrectas. El equipo denomina a esto «déficit metacognitivo»: el modelo carece de un mecanismo interno de duda y no puede evaluar si la información actual es suficiente.
Hacia dónde se dirige la inteligencia incorporada
ESI-Bench marca un cambio de paradigma, pasando de la «correspondencia estática entre imagen y texto» a la «interacción física real» en la evaluación de la inteligencia encarnada. Tal y como señala el equipo de Fei-Fei Li, lograr una verdadera inteligencia espacial requiere algo más que apilar codificadores visuales o aumentar la potencia de cálculo.
La futura investigación sobre la inteligencia incorporada debe centrarse en dotar a los modelos de:
Capacidad de toma de decisiones en secuencias de exploración activa, en lugar del simple reconocimiento de imágenes;
una mayor robustez, para mantener el juicio lógico incluso con observaciones imperfectas de la escena;
Un bucle metacognitivo integrado, de modo que la IA aprenda a explorar cuando carezca de respuestas, en lugar de generar falsas alucinaciones.








 Otter.ai asegura 320 millones de dólares en financiación de crecimiento de General Catalyst para su herramienta de reuniones
El martes, Otter.ai, una plataforma de toma de notas para reuniones, anunció una inversión de 320 millones de dólares del Fondo de Valor al Cliente (CVF) de General Catalyst. Este fondo apoya a las startups sin requerir dilución de capital, buscando
 Anthropic lanza Claude Haiku 5.5, reduciendo los costos de los modelos pequeños en un 75% y permitiendo a los usuarios ajustar la intensidad de inferencia
El 8 de octubre, Anthropic presentó su modelo más eficiente y capaz hasta la fecha: Claude Haiku 5.5. Posicionado como el modelo pequeño más rápido y capaz de la gama de Anthropic, está diseñado para aplicaciones de alta frecuencia y sensibles al cos
 Claude presenta el primer mapa completo del cielo en ultravioleta, que cartografía 119 millones de estrellas
Con la poderosa asistencia de Claude, el modelo de lenguaje grande de Anthropic, los astrofísicos han generado con éxito el primer mapa completo del cielo en ultravioleta de la historia. Este vasto catálogo estelar, que incluye 119 millones de estrel

Las mejores herramientas de ilustración con IA de 2026: nuestra lista seleccionada incluye las mejores herramientas, diseñadas con gran potencia, para crear rápidamente impresionantes escenas editoriales y llamativas portadas. Cada opción ha sido sometida a rigurosas pruebas en condiciones reales y ofrece una comparación entre las versiones gratuitas y de pago para ayudarte a encontrar la que mejor se adapte a tu flujo de trabajo. Prueba hoy mismo estas soluciones imprescindibles para sacar el máximo partido a la IA y potenciar tu productividad creativa. Descúbrelas ahora en XIX.AI.
10 herramientas
xix.ai

¡Ya están aquí, en XIX.AI, los mejores tutores de IA para la preparación de exámenes de 2026, con las mejores valoraciones! Nuestra lista seleccionada incluye potentes herramientas revolucionarias que ofrecen comparativas entre versiones gratuitas y de pago, pruebas reales y clasificaciones actualizadas semanalmente. Te ayudan a mejorar tu eficiencia a la hora de escribir, a simplificar el aprendizaje de temas complejos y a desarrollar todo tu potencial académico. ¡Explora ahora mismo para descubrir tu herramienta perfecta de preparación de exámenes y empieza a crear hoy mismo para sacar partido a tu ventaja con la IA!
10 herramientas
xix.ai

2026 Últimas Mejores Herramientas de Planificación Presupuestaria con IA Mejor Valoradas para la Gestión Personal del Dinero están aquí en XIX.AI. Esta colección seleccionada presenta soluciones poderosas y transformadoras que te ayudan a realizar pruebas en el mundo real, comprender tus hábitos de gasto y crear planes personalizados para aumentar la productividad. Disfruta de una comparación entre versiones gratuitas y de pago junto con clasificaciones detalladas. Herramientas imprescindibles diseñadas para simplificar la gestión del dinero y desbloquear tu ventaja con IA. ¡Explóralas ahora!
11 herramientas
xix.ai

Los mejores asistentes de seguimiento del sueño con IA de 2026, seleccionados para una recuperación óptima. Esta guía semanal totalmente actualizada incluye potentes herramientas que ofrecen pruebas en condiciones reales, comparativas entre opciones gratuitas y de pago, y clasificaciones detalladas para ayudarte a encontrar la solución imprescindible que mejora la calidad del sueño y fomenta mejores hábitos a la hora de acostarse. Descúbrelo ahora en XIX.AI y aprovecha todas las ventajas de la IA.
10 herramientas
xix.ai

¡Los mejores copilotos de IA para SQL mejor valorados de 2026 para el análisis de productos e ingresos! XIX.AI ha seleccionado una potente colección de herramientas revolucionarias que no te puedes perder y que se someten a pruebas en el mundo real a través de clasificaciones que se actualizan semanalmente. Estas herramientas ayudan a los usuarios a aumentar significativamente su productividad al acelerar el análisis de datos, simplificar consultas complejas y generar información precisa para tomar decisiones empresariales más inteligentes. ¡Explora ahora mismo y descubre la herramienta perfecta para sacar el máximo partido a tu ventaja en IA!
14 herramientas
xix.ai

2026: los mejores y más valorados asistentes de deberes con IA que enseñan conceptos básicos, no solo respuestas. Potentes herramientas para estudiantes. Una selección imprescindible que debes probar. Actualización semanal. Comparativa entre opciones gratuitas y de pago. Pruebas en el mundo real. Clasificaciones precisas para ayudarte a desarrollar todo tu potencial de aprendizaje. Explora ahora y descubre la herramienta perfecta para estudiar de forma más inteligente.
10 herramientas
xix.ai

「観測者からアクターへ」という転換、確かに興味深いですね。Fei-Fei Liさんのチームが提唱するESI-Bench、単なる画像認識の限界を超えて、物理世界での行動能力を測る試みは壮大です。でも正直、今のLLMが本当に「行動」できるのか?という懐疑的な視点も持っています。ロボットの制御と大規模言語モデルの融合は容易ではないはず。このベンチマークがどの程度の実効性を持つのか、今後の展開に注目です。🤖✨












