


 Дом
ESI-Bench Ли Фэйфэй: ИИ эволюционирует от наблюдателя к участнику
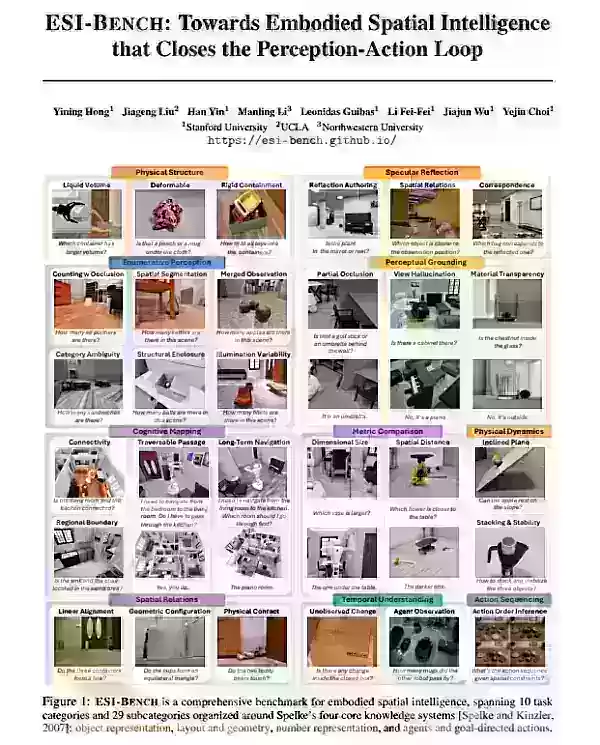
В последнее время значительное внимание привлек тестовый набор ESI-Bench (Embodied Spatial Intelligence Benchmark), выпущенный командой Фэй-Фэй Ли. Этот тестовый набор, который называют «ImageNet воплощённого интеллекта», выявляет серьёзные недостатки ведущих крупных моделей при взаимодействии с физическим пространством.
Почему ESI-Bench устанавливает новый стандарт для воплощённого интеллекта
Ранее оценки пространственного интеллекта ИИ в основном опирались на «пассивное восприятие»: модели подавали несколько изображений с оптимальным ракурсом, и она должна была логически выводить выводы. Такой подход по сути проверяет «зрение» модели, а не её «пространственное познание».
Основной прорыв ESI-Bench заключается в обеспечении цикла «восприятие-действие».
Наблюдатели становятся действующими лицами: в ESI-Bench модель не может оставаться неподвижной и выносить суждения на основе предоставленных изображений; она должна активно решать, куда идти, на что смотреть, какие объекты поднимать и какие механические конструкции приводить в действие, раскрывая скрытую пространственную информацию посредством серии интерактивных действий.
Основа проектирования: тестовый набор основан на «системе базовых знаний человеческих младенцев», разработанной когнитивным психологом Элизабет Спелке, которая охватывает четыре измерения: представление объектов, расположение и геометрия, представление количества и целенаправленное действие.
Масштаб и платформа: он включает 10 категорий, 29 подкатегорий и 3 081 экземпляр задачи, построенных на симуляционной платформе OmniGibson с использованием материалов из библиотеки сцен BEHAVIOR-1K.
Три основные выводы, сделанные в ходе оценки
Исследовательская группа провела углублённые тесты передовых мультимодальных моделей, таких как GPT-5 и серия Gemini. Результаты заставляют задуматься:
1. Узким местом является не восприятие, а стратегия действий
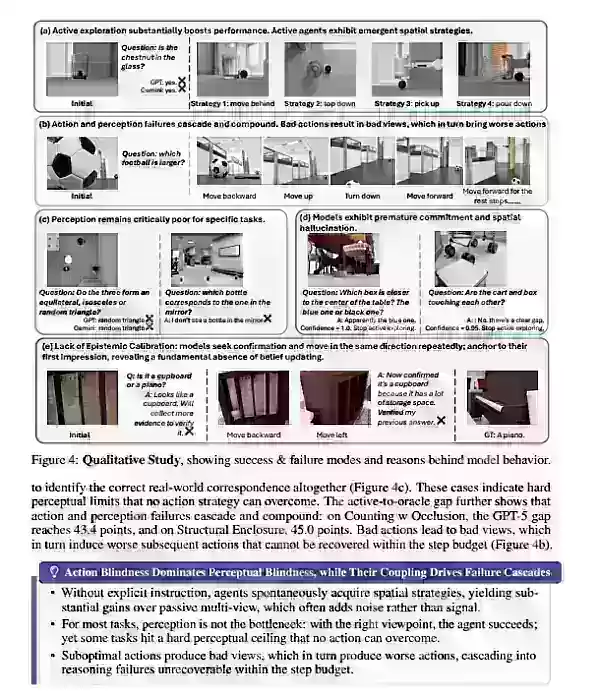
При наличии оптимального ракурса модели часто дают точные ответы — точность может подскочить с 14,6 % до 95,1 %. Но когда им приходится активно искать нужный ракурс, точность резко падает.
«Слепота действий»: моделям не хватает стратегий навигации и манипуляции; неверные действия приводят к некачественным представлениям, что вызывает цепную реакцию ошибок в последующих суждениях.
2. Несовершенная 3D-реконструкция вводит в заблуждение больше, чем 2D-изображения
Исследование опровергает предположение о том, что «3D-карты являются универсальным решением».
При подаче идеальных 3D-данных с видом сверху, эффективность вывода превосходна. Однако использование современных передовых методов VGGT для реконструкции в реальном времени приводит к появлению геометрических артефактов, ошибок окклюзии и отклонений по глубине — по сути, в модель вывода подаются «токсичные» данные, что приводит к худшей производительности, чем при простом просмотре 2D-изображений.
3. Метакогнитивный дефицит: ИИ не осознает, что «не видел достаточно»
Это самый большой когнитивный разрыв между людьми и ИИ:
Разница в когнитивной осторожности: люди активно ищут опровергающие точки зрения, когда информация неоднозначна, и снижают степень уверенности в условиях неопределённости.
Галлюцинации модели: модели часто слишком рано прекращают поиск, даже при крайне ограниченной информации, и с уверенностью выдают неверные выводы. Команда называет это «метакогнитивным дефицитом» — модели не хватает внутреннего механизма сомнения, и она не может оценить, достаточна ли имеющаяся информация.
Куда движется воплощённый интеллект
ESI-Bench сигнализирует о смене парадигмы в оценке воплощенного интеллекта — от «статического сопоставления изображений и текста» к «реальному физическому взаимодействию». Как отмечает команда Фэй-Фэй Ли, для достижения подлинного пространственного интеллекта требуется нечто большее, чем просто наслоение визуальных кодировщиков или увеличение вычислительной мощности.
Будущие исследования в области воплощённого интеллекта должны сосредоточиться на наделении моделей:
способности принимать решения о последовательности активного исследования, а не простого распознавания изображений;
большей устойчивости, позволяющей сохранять логическое суждение даже при неполных наблюдениях за сценой;
встроенный метакогнитивный цикл, благодаря которому ИИ будет учиться исследовать ситуацию при отсутствии ответов, а не генерировать ложные галлюцинации.
Связанная статья
 Otter.ai привлекла $320 млн на развитие от General Catalyst для инструмента проведения встреч
Во вторник платформа для ведения заметок на встречах Otter.ai объявила о привлечении инвестиций в размере 320 миллионов долларов от фонда Customer Value Fund (CVF) компании General Catalyst. Этот фонд поддерживает стартапы без требования размытия дол
Anthropic запускает Claude Haiku 5.5, снижая стоимость малых моделей на 75% и позволяя пользователям регулировать интенсивность вывода
8 октября Anthropic представила свою самую эффективную и мощную на сегодняшний день модель: Claude Haiku 5.5. Позиционируемая как самая быстрая и наиболее функциональная малая модель в линейке Anthropic, она разработана для высокочастотных приложений
Клод представил первую полную карту неба в ультрафиолетовом диапазоне, охватывающую 119 миллионов звёзд
При мощной поддержке Claude, большой языковой модели от Anthropic, астрофизики успешно создали первую в истории полную ультрафиолетовую карту всего неба. Эта обширная звёздная карта, включающая 119 миллионов звёзд, была в значительной степени заверше
Рекомендации по связанным специальным темам
Дизайн и искусство
 Лучшие инструменты для создания иллюстраций с помощью ИИ: быстрее создавайте редакционные сцены и обложки
2026: Новейшие и самые популярные инструменты для создания иллюстраций с помощью ИИ: в нашем тщательно подобранном списке представлены лучшие инструменты с мощными функциональными возможностями, позволяющие быстро создавать потрясающие редакционные сцены и привлекательные обложки. Каждый вариант прошел тщательные практические испытания; мы предлагаем сравнение бесплатных и платных версий, чтобы помочь вам найти идеальный вариант для вашего рабочего процесса. Попробуйте эти незаменимые решения уже сегодня, чтобы раскрыть потенциал искусственного интеллекта и повысить свою творческую продуктивность. Узнайте больше на сайте XIX.AI.
 10 инструментов
 xix.ai
Образование и обучение
Лучшие репетиторы по искусственному интеллекту для подготовки к экзаменам: практикуйтесь по математике, естественным наукам и английскому языку
2026 года: лучшие и самые популярные ИИ-репетиторы для подготовки к экзаменам представлены на XIX.AI! В нашем тщательно подобранном списке представлены мощные инструменты, которые кардинально изменят ваш подход к обучению: здесь вы найдете сравнение бесплатных и платных версий, тесты на практике и еженедельно обновляемые рейтинги. Они помогут повысить эффективность вашего письма, упростить изучение сложных тем и раскрыть ваш академический потенциал. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для подготовки к экзаменам, и начните творить уже сегодня, чтобы раскрыть свои преимущества благодаря ИИ!
10 инструментов
xix.ai
Финансы
Инструменты планирования бюджета на основе ИИ для управления личными финансами
В 2026 году на XIX.AI представлены новейшие, лучшие и наиболее рейтинговые инструменты ИИ для бюджетного планирования по личным финансам! Эта тщательно отобранная коллекция включает мощные, революционные решения, которые помогают проводить реальные тесты, понимать привычки расходов и создавать персонализированные планы для повышения продуктивности. Наслаждайтесь бесплатным сравнением с платными версиями вместе с подробными рейтингами. Инструменты, которые обязательно стоит попробовать, разработаны для упрощения управления деньгами и раскрытия вашего преимущества ИИ. Исследуйте сейчас!
11 инструментов
xix.ai
Здоровье и благополучие
Помощники для отслеживания сна с ИИ: улучшите восстановление за счёт более правильных привычек перед сном
2026 год: лучшие и наиболее высоко оценённые помощники для отслеживания сна на основе ИИ, отобранные для максимального восстановления организма. В этом полностью обновлённом еженедельном руководстве представлены мощные инструменты с результатами реальных тестов, сравнением бесплатных и платных версий, а также подробными рейтингами, которые помогут вам найти оптимальное решение для улучшения качества сна и формирования лучших привычек перед сном. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть потенциал ИИ в вашей жизни.
10 инструментов
xix.ai
Анализ данных
AI-копилоты SQL для аналитики продуктов и выручки
2026: лучшие и самые популярные ИИ-помощники для работы с SQL в сфере аналитики продуктов и доходов! XIX.AI подготовила мощную, революционную подборку инструментов, которые обязательно стоит попробовать. Они проходят проверку в реальных условиях и включаются в еженедельно обновляемый рейтинг. Эти инструменты помогают пользователям значительно повысить продуктивность за счет ускорения анализа данных, оптимизации сложных запросов и получения точных аналитических выводов, которые позволяют принимать более обоснованные бизнес-решения. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент, который поможет вам раскрыть весь потенциал искусственного интеллекта!
14 инструментов
xix.ai
Образование и обучение
Лучшие помощники по домашним заданиям с ИИ, которые учат: изучайте концепции, а не просто ответы
2026: лучшие и самые популярные помощники по домашним заданиям с ИИ, которые обучают основным концепциям, а не просто дают готовые ответы. Мощные инструменты для студентов. Обязательный к пробованию тщательно отобранный список. Еженедельное обновление. Сравнение бесплатных и платных версий. Тестирование в реальных условиях. Точные рейтинги, которые помогут вам раскрыть весь свой учебный потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для более эффективного обучения.
10 инструментов
xix.ai

 Комментарии (1)
![BrianWalker]()
「観測者からアクターへ」という転換、確かに興味深いですね。Fei-Fei Liさんのチームが提唱するESI-Bench、単なる画像認識の限界を超えて、物理世界での行動能力を測る試みは壮大です。でも正直、今のLLMが本当に「行動」できるのか?という懐疑的な視点も持っています。ロボットの制御と大規模言語モデルの融合は容易ではないはず。このベンチマークがどの程度の実効性を持つのか、今後の展開に注目です。🤖✨
В последнее время значительное внимание привлек тестовый набор ESI-Bench (Embodied Spatial Intelligence Benchmark), выпущенный командой Фэй-Фэй Ли. Этот тестовый набор, который называют «ImageNet воплощённого интеллекта», выявляет серьёзные недостатки ведущих крупных моделей при взаимодействии с физическим пространством.
Почему ESI-Bench устанавливает новый стандарт для воплощённого интеллекта
Ранее оценки пространственного интеллекта ИИ в основном опирались на «пассивное восприятие»: модели подавали несколько изображений с оптимальным ракурсом, и она должна была логически выводить выводы. Такой подход по сути проверяет «зрение» модели, а не её «пространственное познание».
Основной прорыв ESI-Bench заключается в обеспечении цикла «восприятие-действие».
Наблюдатели становятся действующими лицами: в ESI-Bench модель не может оставаться неподвижной и выносить суждения на основе предоставленных изображений; она должна активно решать, куда идти, на что смотреть, какие объекты поднимать и какие механические конструкции приводить в действие, раскрывая скрытую пространственную информацию посредством серии интерактивных действий.
Основа проектирования: тестовый набор основан на «системе базовых знаний человеческих младенцев», разработанной когнитивным психологом Элизабет Спелке, которая охватывает четыре измерения: представление объектов, расположение и геометрия, представление количества и целенаправленное действие.
Масштаб и платформа: он включает 10 категорий, 29 подкатегорий и 3 081 экземпляр задачи, построенных на симуляционной платформе OmniGibson с использованием материалов из библиотеки сцен BEHAVIOR-1K.
Три основные выводы, сделанные в ходе оценки
Исследовательская группа провела углублённые тесты передовых мультимодальных моделей, таких как GPT-5 и серия Gemini. Результаты заставляют задуматься:
1. Узким местом является не восприятие, а стратегия действий
При наличии оптимального ракурса модели часто дают точные ответы — точность может подскочить с 14,6 % до 95,1 %. Но когда им приходится активно искать нужный ракурс, точность резко падает.
«Слепота действий»: моделям не хватает стратегий навигации и манипуляции; неверные действия приводят к некачественным представлениям, что вызывает цепную реакцию ошибок в последующих суждениях.
2. Несовершенная 3D-реконструкция вводит в заблуждение больше, чем 2D-изображения
Исследование опровергает предположение о том, что «3D-карты являются универсальным решением».
При подаче идеальных 3D-данных с видом сверху, эффективность вывода превосходна. Однако использование современных передовых методов VGGT для реконструкции в реальном времени приводит к появлению геометрических артефактов, ошибок окклюзии и отклонений по глубине — по сути, в модель вывода подаются «токсичные» данные, что приводит к худшей производительности, чем при простом просмотре 2D-изображений.
3. Метакогнитивный дефицит: ИИ не осознает, что «не видел достаточно»
Это самый большой когнитивный разрыв между людьми и ИИ:
Разница в когнитивной осторожности: люди активно ищут опровергающие точки зрения, когда информация неоднозначна, и снижают степень уверенности в условиях неопределённости.
Галлюцинации модели: модели часто слишком рано прекращают поиск, даже при крайне ограниченной информации, и с уверенностью выдают неверные выводы. Команда называет это «метакогнитивным дефицитом» — модели не хватает внутреннего механизма сомнения, и она не может оценить, достаточна ли имеющаяся информация.
Куда движется воплощённый интеллект
ESI-Bench сигнализирует о смене парадигмы в оценке воплощенного интеллекта — от «статического сопоставления изображений и текста» к «реальному физическому взаимодействию». Как отмечает команда Фэй-Фэй Ли, для достижения подлинного пространственного интеллекта требуется нечто большее, чем просто наслоение визуальных кодировщиков или увеличение вычислительной мощности.
Будущие исследования в области воплощённого интеллекта должны сосредоточиться на наделении моделей:
способности принимать решения о последовательности активного исследования, а не простого распознавания изображений;
большей устойчивости, позволяющей сохранять логическое суждение даже при неполных наблюдениях за сценой;
встроенный метакогнитивный цикл, благодаря которому ИИ будет учиться исследовать ситуацию при отсутствии ответов, а не генерировать ложные галлюцинации.








 Otter.ai привлекла $320 млн на развитие от General Catalyst для инструмента проведения встреч
Во вторник платформа для ведения заметок на встречах Otter.ai объявила о привлечении инвестиций в размере 320 миллионов долларов от фонда Customer Value Fund (CVF) компании General Catalyst. Этот фонд поддерживает стартапы без требования размытия дол
 Anthropic запускает Claude Haiku 5.5, снижая стоимость малых моделей на 75% и позволяя пользователям регулировать интенсивность вывода
8 октября Anthropic представила свою самую эффективную и мощную на сегодняшний день модель: Claude Haiku 5.5. Позиционируемая как самая быстрая и наиболее функциональная малая модель в линейке Anthropic, она разработана для высокочастотных приложений
 Клод представил первую полную карту неба в ультрафиолетовом диапазоне, охватывающую 119 миллионов звёзд
При мощной поддержке Claude, большой языковой модели от Anthropic, астрофизики успешно создали первую в истории полную ультрафиолетовую карту всего неба. Эта обширная звёздная карта, включающая 119 миллионов звёзд, была в значительной степени заверше

2026: Новейшие и самые популярные инструменты для создания иллюстраций с помощью ИИ: в нашем тщательно подобранном списке представлены лучшие инструменты с мощными функциональными возможностями, позволяющие быстро создавать потрясающие редакционные сцены и привлекательные обложки. Каждый вариант прошел тщательные практические испытания; мы предлагаем сравнение бесплатных и платных версий, чтобы помочь вам найти идеальный вариант для вашего рабочего процесса. Попробуйте эти незаменимые решения уже сегодня, чтобы раскрыть потенциал искусственного интеллекта и повысить свою творческую продуктивность. Узнайте больше на сайте XIX.AI.
10 инструментов
xix.ai

2026 года: лучшие и самые популярные ИИ-репетиторы для подготовки к экзаменам представлены на XIX.AI! В нашем тщательно подобранном списке представлены мощные инструменты, которые кардинально изменят ваш подход к обучению: здесь вы найдете сравнение бесплатных и платных версий, тесты на практике и еженедельно обновляемые рейтинги. Они помогут повысить эффективность вашего письма, упростить изучение сложных тем и раскрыть ваш академический потенциал. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент для подготовки к экзаменам, и начните творить уже сегодня, чтобы раскрыть свои преимущества благодаря ИИ!
10 инструментов
xix.ai

В 2026 году на XIX.AI представлены новейшие, лучшие и наиболее рейтинговые инструменты ИИ для бюджетного планирования по личным финансам! Эта тщательно отобранная коллекция включает мощные, революционные решения, которые помогают проводить реальные тесты, понимать привычки расходов и создавать персонализированные планы для повышения продуктивности. Наслаждайтесь бесплатным сравнением с платными версиями вместе с подробными рейтингами. Инструменты, которые обязательно стоит попробовать, разработаны для упрощения управления деньгами и раскрытия вашего преимущества ИИ. Исследуйте сейчас!
11 инструментов
xix.ai

2026 год: лучшие и наиболее высоко оценённые помощники для отслеживания сна на основе ИИ, отобранные для максимального восстановления организма. В этом полностью обновлённом еженедельном руководстве представлены мощные инструменты с результатами реальных тестов, сравнением бесплатных и платных версий, а также подробными рейтингами, которые помогут вам найти оптимальное решение для улучшения качества сна и формирования лучших привычек перед сном. Ознакомьтесь с ним прямо сейчас на сайте XIX.AI, чтобы раскрыть потенциал ИИ в вашей жизни.
10 инструментов
xix.ai

2026: лучшие и самые популярные ИИ-помощники для работы с SQL в сфере аналитики продуктов и доходов! XIX.AI подготовила мощную, революционную подборку инструментов, которые обязательно стоит попробовать. Они проходят проверку в реальных условиях и включаются в еженедельно обновляемый рейтинг. Эти инструменты помогают пользователям значительно повысить продуктивность за счет ускорения анализа данных, оптимизации сложных запросов и получения точных аналитических выводов, которые позволяют принимать более обоснованные бизнес-решения. Ознакомьтесь с ними прямо сейчас, чтобы найти идеальный инструмент, который поможет вам раскрыть весь потенциал искусственного интеллекта!
14 инструментов
xix.ai

2026: лучшие и самые популярные помощники по домашним заданиям с ИИ, которые обучают основным концепциям, а не просто дают готовые ответы. Мощные инструменты для студентов. Обязательный к пробованию тщательно отобранный список. Еженедельное обновление. Сравнение бесплатных и платных версий. Тестирование в реальных условиях. Точные рейтинги, которые помогут вам раскрыть весь свой учебный потенциал. Исследуйте сейчас, чтобы найти идеальный инструмент для более эффективного обучения.
10 инструментов
xix.ai

「観測者からアクターへ」という転換、確かに興味深いですね。Fei-Fei Liさんのチームが提唱するESI-Bench、単なる画像認識の限界を超えて、物理世界での行動能力を測る試みは壮大です。でも正直、今のLLMが本当に「行動」できるのか?という懐疑的な視点も持っています。ロボットの制御と大規模言語モデルの融合は容易ではないはず。このベンチマークがどの程度の実効性を持つのか、今後の展開に注目です。🤖✨












