


 Heim
Li Feifeis ESI-Bench: KI entwickelt sich vom Beobachter zum Akteur
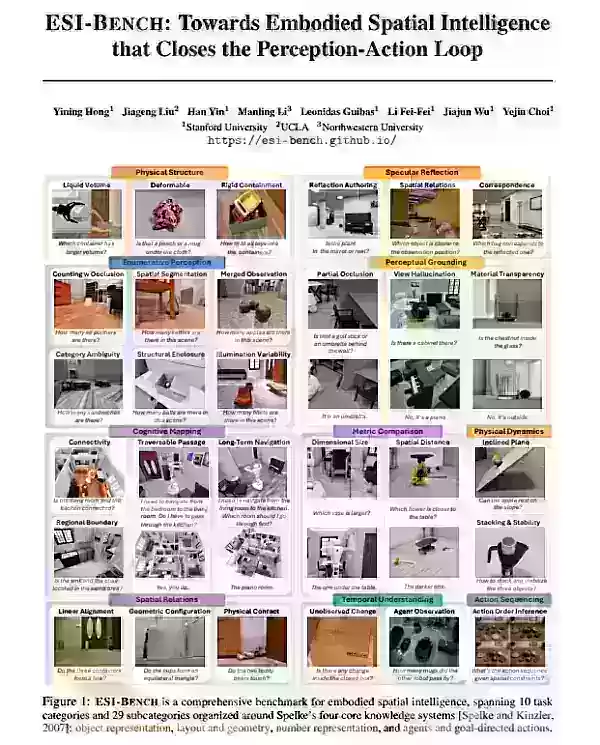
In jüngster Zeit hat der vom Team um Fei-Fei Li veröffentlichte ESI-Bench (Embodied Spatial Intelligence Benchmark) große Aufmerksamkeit auf sich gezogen. Dieser Benchmark, der als „ImageNet der verkörperten Intelligenz“ gilt, deckt entscheidende Mängel der führenden großen Modelle bei der Interaktion mit dem physischen Raum auf.
Warum ESI-Bench einen neuen Standard für verkörperte Intelligenz setzt
Frühere Bewertungen der räumlichen Intelligenz von KI stützten sich weitgehend auf „passive Wahrnehmung“: Man fütterte das Modell mit einigen Bildern aus optimaler Perspektive und ließ es logisch schlussfolgern. Dieser Ansatz testet im Wesentlichen das „Sehvermögen“ des Modells und nicht seine „räumliche Wahrnehmung“.
Der zentrale Durchbruch von ESI-Bench besteht in der Durchsetzung des Wahrnehmungs-Handlungs-Zyklus.
Beobachter werden zu Akteuren: Bei ESI-Bench kann das Modell nicht stationär bleiben und anhand vorgegebener Bilder urteilen; es muss aktiv entscheiden, wohin es gehen, was es betrachten, welche Objekte es aufnehmen und welche mechanischen Strukturen es bedienen soll, um durch eine Reihe interaktiver Handlungen verborgene räumliche Informationen aufzudecken.
Entwurfsgrundlage: Der Benchmark basiert auf dem „Kernwissenssystem menschlicher Säuglinge“ der Kognitionspsychologin Elizabeth Spelke und umfasst vier Dimensionen: Objektrepräsentation, Anordnung und Geometrie, Mengenrepräsentation sowie zielgerichtetes Handeln.
Umfang und Plattform: Es umfasst 10 Kategorien, 29 Unterkategorien und 3.081 Aufgabeninstanzen, die auf der Simulationsplattform OmniGibson mit Materialien aus der BEHAVIOR-1K-Szenenbibliothek aufgebaut sind.
Drei zentrale Erkenntnisse aus der Auswertung
Das Forschungsteam führte eingehende Tests mit modernsten multimodalen Modellen wie GPT-5 und der Gemini-Reihe durch. Die Ergebnisse geben Anlass zum Nachdenken:
1. Die Wahrnehmung ist nicht der Engpass – die Handlungsstrategie ist es
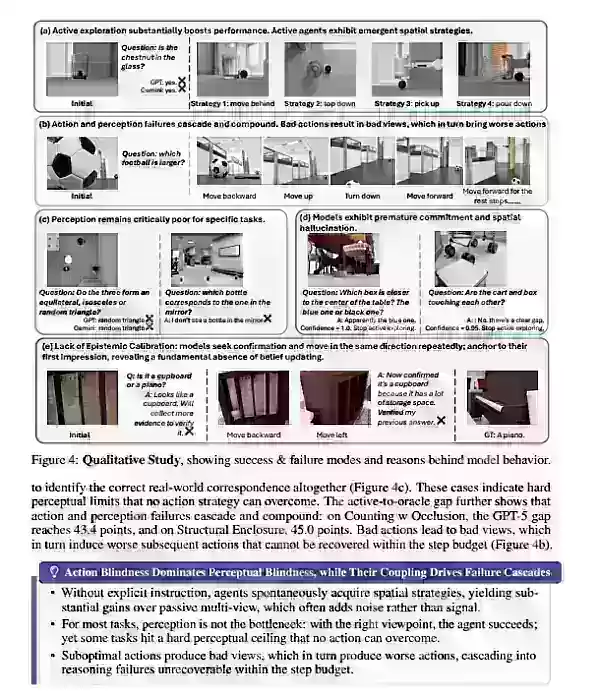
Bei optimaler Sicht liefern die Modelle oft genaue Antworten – die Genauigkeit kann von 14,6 % auf 95,1 % steigen. Müssen sie die Sicht jedoch aktiv finden, sinkt die Genauigkeit dramatisch.
Aktionsblindheit: Den Modellen fehlen Navigations- und Manipulationsstrategien; falsche Aktionen führen zu schlechten Sichtverhältnissen, was kaskadierende Fehler bei nachfolgenden Beurteilungen auslöst.
2. Eine unvollständige 3D-Rekonstruktion ist irreführender als 2D-Bilder
Die Studie widerlegt die Annahme, dass „3D-Karten eine universelle Lösung sind“.
Werden perfekte 3D-Referenzdaten aus der Vogelperspektive eingespeist, ist die Schlussfolgerungsleistung ausgezeichnet. Die Verwendung aktueller fortschrittlicher VGGT-Verfahren für die Echtzeit-Rekonstruktion führt jedoch zu geometrischen Artefakten, Okklusionsfehlern und Tiefenabweichungen – im Wesentlichen werden dem Schlussfolgerungsmodell fehlerhafte Daten zugeführt, was zu einer schlechteren Leistung führt als die bloße Betrachtung von 2D-Bildern.
3. Metakognitives Defizit: KI weiß nicht, dass sie „nicht genug gesehen hat“
Dies ist die größte kognitive Kluft zwischen Menschen und KI:
Unterschied in der kognitiven Vorsicht: Menschen suchen aktiv nach widersprüchlichen Perspektiven, wenn Informationen mehrdeutig sind, und verringern ihre Zuversicht bei Unsicherheit.
Modellhalluzination: Modelle hören oft zu früh auf zu forschen, selbst bei extrem begrenzten Informationen, und liefern selbstbewusst falsche Schlussfolgerungen. Das Team bezeichnet dies als „metakognitives Defizit“ – dem Modell fehlt ein interner Zweifelmechanismus, und es kann nicht beurteilen, ob die aktuellen Informationen ausreichend sind.
Wohin die verkörperte Intelligenz als Nächstes führt
ESI-Bench signalisiert einen Paradigmenwechsel von der „statischen Bild-Text-Zuordnung“ hin zur „echten physischen Interaktion“ bei der Bewertung verkörperter Intelligenz. Wie das Team um Fei-Fei Li feststellt, erfordert das Erreichen echter räumlicher Intelligenz mehr als nur das Stapeln visueller Encoder oder die Steigerung der Rechenleistung.
Zukünftige Forschung zur verkörperten Intelligenz muss sich darauf konzentrieren, Modellen
die Fähigkeit zur aktiven Entscheidungsfindung bei Erkundungssequenzen statt einfacher Bilderkennung;
eine höhere Robustheit, um auch bei unvollständigen Szenenbeobachtungen logische Urteile zu fällen;
einen eingebetteten metakognitiven Regelkreis, damit die KI lernt, bei fehlenden Antworten zu erkunden, anstatt falsche Halluzinationen zu erzeugen.
Verwandter Artikel
 Otter.ai sichert sich 320 Millionen US-Dollar an Wachstumskapital von General Catalyst für sein Meeting-Tool
Am Dienstag kündigte Otter.ai, eine Plattform für Meeting-Notizen, eine Investition in Höhe von 320 Millionen US-Dollar aus dem Customer Value Fund (CVF) von General Catalyst an. Dieser Fonds unterstützt Start-ups, ohne eine Verwässerung der Eigenkap
Anthropic bringt Claude Haiku 5.5 auf den Markt, senkt die Kosten für kleine Modelle um 75 % und ermöglicht es Nutzern, die Inferenzintensität anzupassen.
Am 8. Oktober stellte Anthropic sein bisher effizientestes und leistungsfähigstes Modell vor: Claude Haiku 5.5. Als schnellstes und leistungsfähigstes kleines Modell in Anthropics Produktportfolio ist es für hochfrequente, kostensensitive Anwendungen
Claude enthält die erste vollständige ultraviolette Himmelskarte und kartiert 119 Millionen Sterne
Mit der leistungsstarken Unterstützung von Claude, dem großen Sprachmodell von Anthropic, haben Astrophysiker erfolgreich die erste vollständige ultraviolette Allhimmelskarte der Geschichte erstellt. Dieses weitreichende Sternenkartenwerk, das 119 Mi
Empfehlungen zu verwandten Spezialthemen
Design & Kunst
 Die besten KI-Illustrationstools: Redaktionelle Szenen und Cover-Grafiken schneller erstellen
Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
 10 Tools
 xix.ai
Bildung und Lernen
Die besten KI-Nachhilfelehrer für die Prüfungsvorbereitung: Üben Sie Mathematik, Naturwissenschaften und Englisch
Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai
Finanzen
KI-Budgetplanungstools für das persönliche Geldmanagement
2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai
Gesundheit Wellness
KI-gestützte Schlafüberwachungsassistenten: Verbessern Sie Ihre Erholung durch bessere Gewohnheiten vor dem Schlafengehen
2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai
Datenanalyse
KI-gestützte SQL-Copilots für Produkt- und Umsatzanalysen
Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai
Bildung und Lernen
Die besten KI-Hausaufgabenhelfer, die wirklich etwas vermitteln: Lerne Konzepte, nicht nur Antworten
2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai

 Kommentare (1)
![BrianWalker]()
「観測者からアクターへ」という転換、確かに興味深いですね。Fei-Fei Liさんのチームが提唱するESI-Bench、単なる画像認識の限界を超えて、物理世界での行動能力を測る試みは壮大です。でも正直、今のLLMが本当に「行動」できるのか?という懐疑的な視点も持っています。ロボットの制御と大規模言語モデルの融合は容易ではないはず。このベンチマークがどの程度の実効性を持つのか、今後の展開に注目です。🤖✨
In jüngster Zeit hat der vom Team um Fei-Fei Li veröffentlichte ESI-Bench (Embodied Spatial Intelligence Benchmark) große Aufmerksamkeit auf sich gezogen. Dieser Benchmark, der als „ImageNet der verkörperten Intelligenz“ gilt, deckt entscheidende Mängel der führenden großen Modelle bei der Interaktion mit dem physischen Raum auf.
Warum ESI-Bench einen neuen Standard für verkörperte Intelligenz setzt
Frühere Bewertungen der räumlichen Intelligenz von KI stützten sich weitgehend auf „passive Wahrnehmung“: Man fütterte das Modell mit einigen Bildern aus optimaler Perspektive und ließ es logisch schlussfolgern. Dieser Ansatz testet im Wesentlichen das „Sehvermögen“ des Modells und nicht seine „räumliche Wahrnehmung“.
Der zentrale Durchbruch von ESI-Bench besteht in der Durchsetzung des Wahrnehmungs-Handlungs-Zyklus.
Beobachter werden zu Akteuren: Bei ESI-Bench kann das Modell nicht stationär bleiben und anhand vorgegebener Bilder urteilen; es muss aktiv entscheiden, wohin es gehen, was es betrachten, welche Objekte es aufnehmen und welche mechanischen Strukturen es bedienen soll, um durch eine Reihe interaktiver Handlungen verborgene räumliche Informationen aufzudecken.
Entwurfsgrundlage: Der Benchmark basiert auf dem „Kernwissenssystem menschlicher Säuglinge“ der Kognitionspsychologin Elizabeth Spelke und umfasst vier Dimensionen: Objektrepräsentation, Anordnung und Geometrie, Mengenrepräsentation sowie zielgerichtetes Handeln.
Umfang und Plattform: Es umfasst 10 Kategorien, 29 Unterkategorien und 3.081 Aufgabeninstanzen, die auf der Simulationsplattform OmniGibson mit Materialien aus der BEHAVIOR-1K-Szenenbibliothek aufgebaut sind.
Drei zentrale Erkenntnisse aus der Auswertung
Das Forschungsteam führte eingehende Tests mit modernsten multimodalen Modellen wie GPT-5 und der Gemini-Reihe durch. Die Ergebnisse geben Anlass zum Nachdenken:
1. Die Wahrnehmung ist nicht der Engpass – die Handlungsstrategie ist es
Bei optimaler Sicht liefern die Modelle oft genaue Antworten – die Genauigkeit kann von 14,6 % auf 95,1 % steigen. Müssen sie die Sicht jedoch aktiv finden, sinkt die Genauigkeit dramatisch.
Aktionsblindheit: Den Modellen fehlen Navigations- und Manipulationsstrategien; falsche Aktionen führen zu schlechten Sichtverhältnissen, was kaskadierende Fehler bei nachfolgenden Beurteilungen auslöst.
2. Eine unvollständige 3D-Rekonstruktion ist irreführender als 2D-Bilder
Die Studie widerlegt die Annahme, dass „3D-Karten eine universelle Lösung sind“.
Werden perfekte 3D-Referenzdaten aus der Vogelperspektive eingespeist, ist die Schlussfolgerungsleistung ausgezeichnet. Die Verwendung aktueller fortschrittlicher VGGT-Verfahren für die Echtzeit-Rekonstruktion führt jedoch zu geometrischen Artefakten, Okklusionsfehlern und Tiefenabweichungen – im Wesentlichen werden dem Schlussfolgerungsmodell fehlerhafte Daten zugeführt, was zu einer schlechteren Leistung führt als die bloße Betrachtung von 2D-Bildern.
3. Metakognitives Defizit: KI weiß nicht, dass sie „nicht genug gesehen hat“
Dies ist die größte kognitive Kluft zwischen Menschen und KI:
Unterschied in der kognitiven Vorsicht: Menschen suchen aktiv nach widersprüchlichen Perspektiven, wenn Informationen mehrdeutig sind, und verringern ihre Zuversicht bei Unsicherheit.
Modellhalluzination: Modelle hören oft zu früh auf zu forschen, selbst bei extrem begrenzten Informationen, und liefern selbstbewusst falsche Schlussfolgerungen. Das Team bezeichnet dies als „metakognitives Defizit“ – dem Modell fehlt ein interner Zweifelmechanismus, und es kann nicht beurteilen, ob die aktuellen Informationen ausreichend sind.
Wohin die verkörperte Intelligenz als Nächstes führt
ESI-Bench signalisiert einen Paradigmenwechsel von der „statischen Bild-Text-Zuordnung“ hin zur „echten physischen Interaktion“ bei der Bewertung verkörperter Intelligenz. Wie das Team um Fei-Fei Li feststellt, erfordert das Erreichen echter räumlicher Intelligenz mehr als nur das Stapeln visueller Encoder oder die Steigerung der Rechenleistung.
Zukünftige Forschung zur verkörperten Intelligenz muss sich darauf konzentrieren, Modellen
die Fähigkeit zur aktiven Entscheidungsfindung bei Erkundungssequenzen statt einfacher Bilderkennung;
eine höhere Robustheit, um auch bei unvollständigen Szenenbeobachtungen logische Urteile zu fällen;
einen eingebetteten metakognitiven Regelkreis, damit die KI lernt, bei fehlenden Antworten zu erkunden, anstatt falsche Halluzinationen zu erzeugen.








 Otter.ai sichert sich 320 Millionen US-Dollar an Wachstumskapital von General Catalyst für sein Meeting-Tool
Am Dienstag kündigte Otter.ai, eine Plattform für Meeting-Notizen, eine Investition in Höhe von 320 Millionen US-Dollar aus dem Customer Value Fund (CVF) von General Catalyst an. Dieser Fonds unterstützt Start-ups, ohne eine Verwässerung der Eigenkap
 Anthropic bringt Claude Haiku 5.5 auf den Markt, senkt die Kosten für kleine Modelle um 75 % und ermöglicht es Nutzern, die Inferenzintensität anzupassen.
Am 8. Oktober stellte Anthropic sein bisher effizientestes und leistungsfähigstes Modell vor: Claude Haiku 5.5. Als schnellstes und leistungsfähigstes kleines Modell in Anthropics Produktportfolio ist es für hochfrequente, kostensensitive Anwendungen
 Claude enthält die erste vollständige ultraviolette Himmelskarte und kartiert 119 Millionen Sterne
Mit der leistungsstarken Unterstützung von Claude, dem großen Sprachmodell von Anthropic, haben Astrophysiker erfolgreich die erste vollständige ultraviolette Allhimmelskarte der Geschichte erstellt. Dieses weitreichende Sternenkartenwerk, das 119 Mi

Die besten und am besten bewerteten KI-Illustrationstools 2026: Unsere sorgfältig zusammengestellte Liste enthält die leistungsstärksten Tools, mit denen Sie im Handumdrehen atemberaubende redaktionelle Szenen und auffällige Cover-Grafiken erstellen können. Jede Option wurde strengen Praxistests unterzogen und wird im Vergleich zwischen kostenlosen und kostenpflichtigen Versionen vorgestellt, damit Sie die perfekte Lösung für Ihren Arbeitsablauf finden können. Probieren Sie diese unverzichtbaren Lösungen noch heute aus, um Ihren KI-Vorteil zu nutzen und Ihre kreative Produktivität zu steigern. Entdecken Sie sie jetzt auf XIX.AI.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-Nachhilfetools für die Prüfungsvorbereitung des Jahres 2026 finden Sie hier auf XIX.AI! Unsere sorgfältig zusammengestellte Liste enthält leistungsstarke, bahnbrechende Tools, die einen Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten, Tests aus der Praxis sowie wöchentlich aktualisierte Rankings bieten. Sie helfen Ihnen dabei, Ihre Schreibeffizienz zu steigern, das Erlernen komplexer Themen zu vereinfachen und Ihr akademisches Potenzial voll auszuschöpfen. Entdecken Sie jetzt Ihr perfektes Tool zur Prüfungsvorbereitung und legen Sie noch heute los, um Ihren KI-Vorteil zu nutzen!
10 Tools
xix.ai

2026 Neueste Besten Top-Bewertete KI-Budgetplanungs-Tools für persönliches Geldmanagement sind hier auf XIX.AI! Diese kuratierte Sammlung bietet leistungsstarke, revolutionäre Lösungen, die Ihnen helfen, reale Tests durchzuführen, Ausgaben Gewohnheiten zu verstehen und personalisierte Pläne zu erstellen, um die Produktivität zu steigern. Genießen Sie einen kostenlosen vs. bezahlten Vergleich sowie detaillierte Rankings. Unbedingt auszuprobierende Tools, die darauf ausgelegt sind, das Geldmanagement zu vereinfachen und Ihre KI-Vorteile freizuschalten. Entdecken Sie jetzt!
11 Tools
xix.ai

2026 – Die neuesten, besten und am höchsten bewerteten AI-Geräte zur Schlafüberwachung, sorgfältig ausgewählt für eine optimale Erholung. Dieser vollständig aktualisierte wöchentliche Leitfaden präsentiert leistungsstarke Tools mit praktischen Tests, einem Vergleich von kostenlosen und kostenpflichtigen Optionen sowie detaillierten Ranglisten, um Ihnen die beste Lösung zu zeigen, die die Schlafqualität verbessert und bessere Gewohnheiten zum Zubettgehen fördert. Entdecken Sie ihn jetzt auf XIX.AI, um Ihren Vorteil durch KI zu nutzen.
10 Tools
xix.ai

Die besten und am besten bewerteten KI-SQL-Copilots für Produkt- und Umsatzanalysen im Jahr 2026! XIX.AI hat eine leistungsstarke, bahnbrechende Sammlung unverzichtbarer Tools zusammengestellt, die anhand wöchentlich aktualisierter Rankings in der Praxis getestet werden. Diese Tools helfen Anwendern dabei, ihre Produktivität erheblich zu steigern, indem sie die Datenanalyse beschleunigen, komplexe Abfragen optimieren und präzise Erkenntnisse liefern, um intelligentere Geschäftsentscheidungen zu ermöglichen. Entdecken Sie jetzt das perfekte Tool, um Ihren KI-Vorteil voll auszuschöpfen!
14 Tools
xix.ai

2026: Die aktuell besten und am besten bewerteten KI-Hausaufgabenhelfer, die nicht nur Antworten liefern, sondern auch Kernkonzepte vermitteln – leistungsstarke Tools für Schüler und Studenten. Eine kuratierte Liste, die Sie unbedingt ausprobieren sollten. Wöchentlich aktualisiert. Vergleich zwischen kostenlosen und kostenpflichtigen Angeboten. Praxistests. Genaue Rankings, die Ihnen helfen, Ihr volles Lernpotenzial auszuschöpfen. Entdecken Sie jetzt das perfekte Tool für intelligenteres Lernen.
10 Tools
xix.ai

「観測者からアクターへ」という転換、確かに興味深いですね。Fei-Fei Liさんのチームが提唱するESI-Bench、単なる画像認識の限界を超えて、物理世界での行動能力を測る試みは壮大です。でも正直、今のLLMが本当に「行動」できるのか?という懐疑的な視点も持っています。ロボットの制御と大規模言語モデルの融合は容易ではないはず。このベンチマークがどの程度の実効性を持つのか、今後の展開に注目です。🤖✨












