


 家
李飛飛のESI-Bench:AIは「観察者」から「実行者」へと進化する
最近、Fei-Fei Li氏のチームが発表した「ESI-Bench(Embodied Spatial Intelligence Benchmark)」が大きな注目を集めている。「体現知能のImageNet」とも称されるこのベンチマークは、物理空間と相互作用する際、トップクラスの大規模モデルが抱える重大な欠点を浮き彫りにしている。
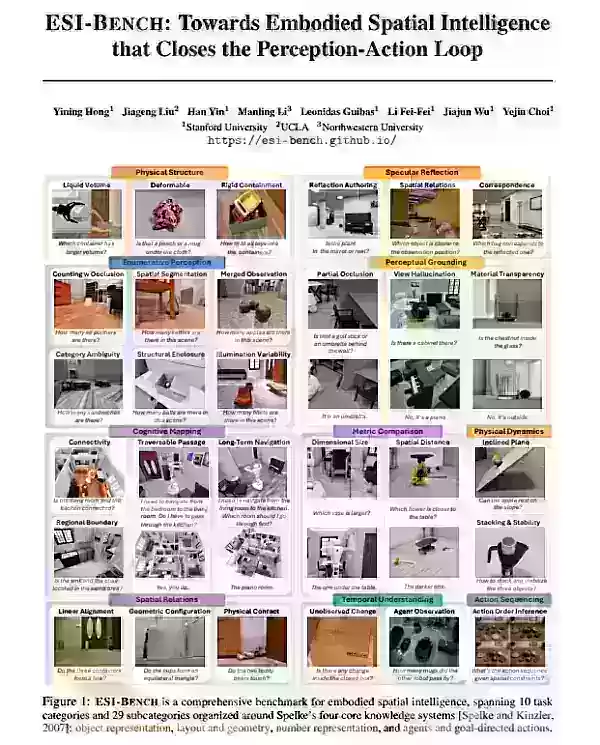
ESI-Benchが具現化知能の新たな基準となる理由
これまでのAIの空間知能評価は、主に「受動的な知覚」に依存していました。つまり、最適な視点からの画像を数枚与え、モデルに論理的に推論させるというものです。このアプローチは、本質的にモデルの「空間認知」ではなく、「視覚」をテストするものに過ぎませんでした。
ESI-Benchの核心となる画期的な点は、知覚と行動のループを強制していることにある。
「観察者」から「行動者」へ:ESI-Benchでは、モデルは静止したまま与えられた画像から判断することはできず、どこへ移動するか、何を見るか、どの物体を拾うか、どの機械構造を操作するかを能動的に決定し、一連の対話的な行動を通じて隠された空間情報を解明しなければなりません。
設計の基盤:このベンチマークは、認知心理学者エリザベス・スペルケの「ヒト乳児のコア知識システム」に基づいており、物体表象、配置と幾何学、数量表象、目標指向行動という4つの次元を網羅している。
規模とプラットフォーム:10のカテゴリ、29のサブカテゴリ、3,081のタスクインスタンスを含み、BEHAVIOR-1Kシーンライブラリの素材を用いてOmniGibsonシミュレーションプラットフォーム上に構築されている。
評価によって明らかになった3つの核心的な真実
研究チームは、GPT-5やGeminiシリーズといった最先端のマルチモーダルモデルに対して詳細なテストを実施した。その結果は、考えさせられるものである:
1. ボトルネックは知覚ではなく、行動戦略にある
最適な視点が与えられると、モデルはしばしば正確な回答を返す——精度は14.6%から95.1%へと跳ね上がることもある。しかし、自ら積極的に視点を見つけなければならない場合、精度は劇的に低下する。
「アクション・ブラインドネス(行動盲点)」:モデルにはナビゲーションや操作の戦略が欠如しており、誤った行動が不適切な視点を生み出し、それがその後の判断において連鎖的な誤りを引き起こす。
2. 不完全な3D再構成は、2D画像よりも誤解を招きやすい
この研究は、「3Dマップは万能の解決策である」という前提を覆すものである。
完璧な上空からの3Dグラウンドトゥルースを入力すると、推論性能は極めて優れている。しかし、現在の高度なVGGTを用いてリアルタイム再構成を行うと、幾何学的アーティファクト、オクルージョンエラー、深度のずれが生じる。これは実質的に推論モデルに有害なデータを供給することになり、単に2D画像を見るよりも性能が低下してしまう。
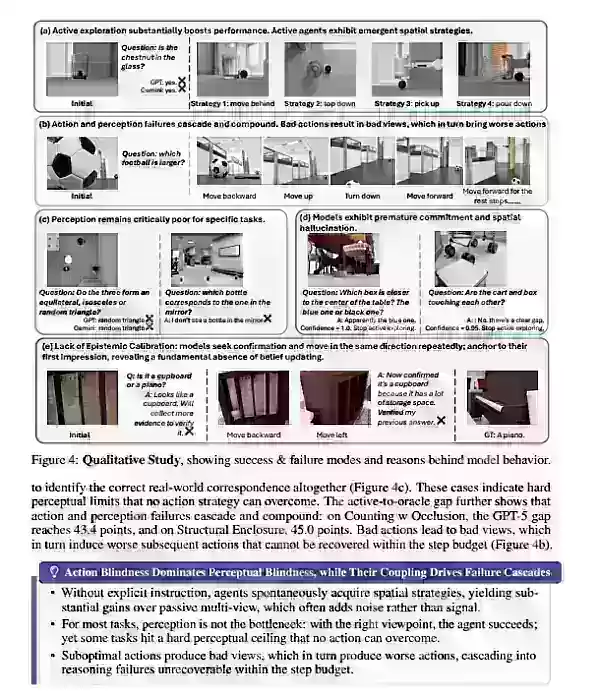
3. メタ認知の欠如:AIは「十分なデータを見ていない」ことを認識できない
これが、人間とAIの間の最大の認知的ギャップである:
認知上の慎重さの違い:人間は、情報が曖昧な場合、反証となる視点を積極的に探し求め、不確実性の下では確信度を下げます。
モデルの幻覚:モデルは、情報が極めて限られている場合でも、探索を早々に打ち切り、自信を持って誤った結論を提示することが多い。研究チームはこれを「メタ認知的欠如」と呼んでいる。つまり、モデルには内部的な疑念メカニズムが欠如しており、現在の情報が十分かどうかを評価できないのだ。
体現知能の今後の展望
ESI-Benchは、具現化知能の評価において、「静的な画像とテキストの照合」から「実際の物理的相互作用」へのパラダイムシフトを示唆している。Fei-Fei Li氏のチームが指摘するように、真の空間知能を実現するには、視覚エンコーダーを積み重ねたり、計算能力を高めたりするだけでは不十分である。
今後のエンボディッド・インテリジェンス研究では、モデルに以下の能力を与えることに焦点を当てる必要がある:
単純な画像認識ではなく、能動的な探索シーケンスの意思決定能力;
不完全なシーンの観察であっても論理的な判断を維持できる、より強力な頑健性;
組み込まれたメタ認知ループ。これにより、AIは答えが見つからない場合に、誤った幻覚を生成するのではなく、探索を行うことを学ぶ。
関連記事
 Otter.ai、会議ツール向けに一般触媒から3億2000万ドルの成長資金を調達
火曜日に、会議メモ作成プラットフォームのOtter.aiは、General CatalystのCustomer Value Fund(CVF)から3億2000万ドルの投資を受けると発表した。この基金は、株式の希薄化を要求せずにスタートアップをサポートし、代わりにマーケティングパフォーマンスに基づくリターンを求めている。Otter.aiは、これらの資金を企業成長の加速、市場投入戦略の精緻化、国際的な展開、および製品革新の推進に充てる計画である。PitchBookのデータによると、ほぼ10年の歴
Anthropic、Claude Haiku 5.5をリリース、小規模モデルのコストを75%削減し、ユーザーが推論強度を調整可能に
10月8日、Anthropicはこれまでで最も効率的かつ高性能なモデルを発表しました:Claude Haiku 5.5。Anthropicのラインナップにおいて最速かつ最も高性能な小型モデルとして位置づけられ、記事の要約、コンテンツのカテゴリ分け、データベースクエリ、カスタマーサポートの回答、ブラウザ自動化、および大規模なAIエージェントから委任されたサブタスクなど、高頻度かつコスト敏感なアプリケーション向けに設計されています。Haiku 5.5は非常に競争力のある戦略を採用し、前世代のHai
Claude、初の完全な紫外線全天マップを公開、1億1900万個の星をマッピング
Claude、Anthropicの大規模言語モデルの強力な支援により、天体物理学者たちは史上初となる完全な紫外線全天マップの生成に成功した。この1億1900万個の星を特徴とする広大な星図は、Claudeによって過去のマルチ波長天文データを用いて主に作成され、天空の約3分の1をカバーしている。この画期的な成果は、紫外線観測望遠鏡が意図的に天の川銀河の明るい領域を避けたために50年間も存在し続いた歴史的な空白を埋めるものである。全天マップの作成は、天文学研究において要求が高く複雑な体系的プロジェク
関連特集おすすめ
デザインとアート
 おすすめのAIイラスト作成ツール:編集用シーンや表紙アートを素早く作成
2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
 10 ツール
 xix.ai
教育と学習
試験対策に最適なAIチューター:数学、理科、英語の練習
2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai
ファイナンス
個人のお金管理のためのAI予算計画ツール
2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai
健康とウェルネス
AI睡眠追跡アシスタント:より良い就寝習慣で回復力を高める
2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai
データ分析
製品および収益分析のためのAI SQLコパイロット
2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai
教育と学習
学びを促進する最高のAI宿題支援ツール:答えだけでなく、概念を学べる
2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

 コメント (1)
0/500
![BrianWalker]()
「観測者からアクターへ」という転換、確かに興味深いですね。Fei-Fei Liさんのチームが提唱するESI-Bench、単なる画像認識の限界を超えて、物理世界での行動能力を測る試みは壮大です。でも正直、今のLLMが本当に「行動」できるのか?という懐疑的な視点も持っています。ロボットの制御と大規模言語モデルの融合は容易ではないはず。このベンチマークがどの程度の実効性を持つのか、今後の展開に注目です。🤖✨
最近、Fei-Fei Li氏のチームが発表した「ESI-Bench(Embodied Spatial Intelligence Benchmark)」が大きな注目を集めている。「体現知能のImageNet」とも称されるこのベンチマークは、物理空間と相互作用する際、トップクラスの大規模モデルが抱える重大な欠点を浮き彫りにしている。
ESI-Benchが具現化知能の新たな基準となる理由
これまでのAIの空間知能評価は、主に「受動的な知覚」に依存していました。つまり、最適な視点からの画像を数枚与え、モデルに論理的に推論させるというものです。このアプローチは、本質的にモデルの「空間認知」ではなく、「視覚」をテストするものに過ぎませんでした。
ESI-Benchの核心となる画期的な点は、知覚と行動のループを強制していることにある。
「観察者」から「行動者」へ:ESI-Benchでは、モデルは静止したまま与えられた画像から判断することはできず、どこへ移動するか、何を見るか、どの物体を拾うか、どの機械構造を操作するかを能動的に決定し、一連の対話的な行動を通じて隠された空間情報を解明しなければなりません。
設計の基盤:このベンチマークは、認知心理学者エリザベス・スペルケの「ヒト乳児のコア知識システム」に基づいており、物体表象、配置と幾何学、数量表象、目標指向行動という4つの次元を網羅している。
規模とプラットフォーム:10のカテゴリ、29のサブカテゴリ、3,081のタスクインスタンスを含み、BEHAVIOR-1Kシーンライブラリの素材を用いてOmniGibsonシミュレーションプラットフォーム上に構築されている。
評価によって明らかになった3つの核心的な真実
研究チームは、GPT-5やGeminiシリーズといった最先端のマルチモーダルモデルに対して詳細なテストを実施した。その結果は、考えさせられるものである:
1. ボトルネックは知覚ではなく、行動戦略にある
最適な視点が与えられると、モデルはしばしば正確な回答を返す——精度は14.6%から95.1%へと跳ね上がることもある。しかし、自ら積極的に視点を見つけなければならない場合、精度は劇的に低下する。
「アクション・ブラインドネス(行動盲点)」:モデルにはナビゲーションや操作の戦略が欠如しており、誤った行動が不適切な視点を生み出し、それがその後の判断において連鎖的な誤りを引き起こす。
2. 不完全な3D再構成は、2D画像よりも誤解を招きやすい
この研究は、「3Dマップは万能の解決策である」という前提を覆すものである。
完璧な上空からの3Dグラウンドトゥルースを入力すると、推論性能は極めて優れている。しかし、現在の高度なVGGTを用いてリアルタイム再構成を行うと、幾何学的アーティファクト、オクルージョンエラー、深度のずれが生じる。これは実質的に推論モデルに有害なデータを供給することになり、単に2D画像を見るよりも性能が低下してしまう。
3. メタ認知の欠如:AIは「十分なデータを見ていない」ことを認識できない
これが、人間とAIの間の最大の認知的ギャップである:
認知上の慎重さの違い:人間は、情報が曖昧な場合、反証となる視点を積極的に探し求め、不確実性の下では確信度を下げます。
モデルの幻覚:モデルは、情報が極めて限られている場合でも、探索を早々に打ち切り、自信を持って誤った結論を提示することが多い。研究チームはこれを「メタ認知的欠如」と呼んでいる。つまり、モデルには内部的な疑念メカニズムが欠如しており、現在の情報が十分かどうかを評価できないのだ。
体現知能の今後の展望
ESI-Benchは、具現化知能の評価において、「静的な画像とテキストの照合」から「実際の物理的相互作用」へのパラダイムシフトを示唆している。Fei-Fei Li氏のチームが指摘するように、真の空間知能を実現するには、視覚エンコーダーを積み重ねたり、計算能力を高めたりするだけでは不十分である。
今後のエンボディッド・インテリジェンス研究では、モデルに以下の能力を与えることに焦点を当てる必要がある:
単純な画像認識ではなく、能動的な探索シーケンスの意思決定能力;
不完全なシーンの観察であっても論理的な判断を維持できる、より強力な頑健性;
組み込まれたメタ認知ループ。これにより、AIは答えが見つからない場合に、誤った幻覚を生成するのではなく、探索を行うことを学ぶ。








 Otter.ai、会議ツール向けに一般触媒から3億2000万ドルの成長資金を調達
火曜日に、会議メモ作成プラットフォームのOtter.aiは、General CatalystのCustomer Value Fund(CVF)から3億2000万ドルの投資を受けると発表した。この基金は、株式の希薄化を要求せずにスタートアップをサポートし、代わりにマーケティングパフォーマンスに基づくリターンを求めている。Otter.aiは、これらの資金を企業成長の加速、市場投入戦略の精緻化、国際的な展開、および製品革新の推進に充てる計画である。PitchBookのデータによると、ほぼ10年の歴
 Anthropic、Claude Haiku 5.5をリリース、小規模モデルのコストを75%削減し、ユーザーが推論強度を調整可能に
10月8日、Anthropicはこれまでで最も効率的かつ高性能なモデルを発表しました:Claude Haiku 5.5。Anthropicのラインナップにおいて最速かつ最も高性能な小型モデルとして位置づけられ、記事の要約、コンテンツのカテゴリ分け、データベースクエリ、カスタマーサポートの回答、ブラウザ自動化、および大規模なAIエージェントから委任されたサブタスクなど、高頻度かつコスト敏感なアプリケーション向けに設計されています。Haiku 5.5は非常に競争力のある戦略を採用し、前世代のHai
 Claude、初の完全な紫外線全天マップを公開、1億1900万個の星をマッピング
Claude、Anthropicの大規模言語モデルの強力な支援により、天体物理学者たちは史上初となる完全な紫外線全天マップの生成に成功した。この1億1900万個の星を特徴とする広大な星図は、Claudeによって過去のマルチ波長天文データを用いて主に作成され、天空の約3分の1をカバーしている。この画期的な成果は、紫外線観測望遠鏡が意図的に天の川銀河の明るい領域を避けたために50年間も存在し続いた歴史的な空白を埋めるものである。全天マップの作成は、天文学研究において要求が高く複雑な体系的プロジェク

2026年最新・高評価のAIイラストレーションツール:当サイトが厳選したこのリストには、見事な編集用シーンや人目を引く表紙アートを素早く作成できる、高性能なツールが掲載されています。各ツールは実環境での厳格なテストを経ており、無料版と有料版の比較も掲載されているため、ご自身のワークフローに最適なツールを見つけるのに役立ちます。 今すぐこれらの「必見」ソリューションを試して、AIの力を最大限に活用し、クリエイティブな生産性を高めましょう。XIX.AIで今すぐチェックしてください。
10 ツール
xix.ai

2026年最新の、試験対策で高評価を得ている最高のAIチューターがXIX.AIに登場!厳選されたこのリストには、無料版と有料版の比較、実戦的なテスト、毎週更新されるランキングなどを提供する、画期的なツールが勢ぞろいしています。これらは、ライティングの効率を高め、複雑なトピックの学習を簡素化し、あなたの学業的な可能性を引き出すのに役立ちます。 今すぐチェックして、あなたにぴったりの試験対策ツールを見つけ、今日から作成を始めて、AIの力を最大限に活用しましょう!
10 ツール
xix.ai

2026年の最新・最高評価のAI予算管理ツールがXIX.AIで登場!この厳選コレクションは、現実的なテストを行い、支出習慣を理解し、生産性を高めるためのパーソナライズされた計画を作成するのに役立つ革新的なソリューションを提供しています。無料版と有料版の比較や詳細なランキングもご用意しています。お金の管理を簡素化し、AIの優位性を引き出すためにぜひ試してほしいツールです。今すぐチェックしましょう!
11 ツール
xix.ai

2026年最新かつ最高評価を受けているAI睡眠追跡アシスタントを厳選し、最適な回復を実現できるようご紹介します。完全に更新されたこの週間ガイドには、実際のテスト結果や無料版と有料版の比較、詳細なランキングなど、睡眠の質を向上させてより良い就寝習慣をサポートする最適なソリューションを見つけるのに役立つ強力なツールが掲載されています。今すぐXIX.AIでご覧ください。
10 ツール
xix.ai

2026年版 製品・収益分析に最適な、高評価のAI SQLコパイロット最新ランキング! XIX.AIは、毎週更新されるランキングを通じて実環境でのテストを経た、強力で画期的な「ぜひ試すべきツール」を厳選しました。これらのツールは、データ分析を加速させ、複雑なクエリを効率化し、正確なインサイトを生成することで、ユーザーの生産性を大幅に向上させ、より賢明なビジネス意思決定を後押しします。今すぐチェックして、AIの真価を引き出すあなたにぴったりのツールを見つけましょう!
14 ツール
xix.ai

2026年最新・最高評価のAI宿題サポートツール。単なる答えだけでなく、核心となる概念を教える、学生にとって強力なツール。ぜひ試してほしい厳選リスト。毎週更新。無料版と有料版の比較、実地テストによる正確なランキングで、あなたの学習能力を最大限に引き出します。今すぐチェックして、よりスマートな学習を実現するあなたにぴったりのツールを見つけましょう。
10 ツール
xix.ai

「観測者からアクターへ」という転換、確かに興味深いですね。Fei-Fei Liさんのチームが提唱するESI-Bench、単なる画像認識の限界を超えて、物理世界での行動能力を測る試みは壮大です。でも正直、今のLLMが本当に「行動」できるのか?という懐疑的な視点も持っています。ロボットの制御と大規模言語モデルの融合は容易ではないはず。このベンチマークがどの程度の実効性を持つのか、今後の展開に注目です。🤖✨












